
本地部署还是 API?一份按用量、隐私和预算做决定的清单
说明:这篇文章不推销任何一方。成本部分我们不给具体的 API 单价,因为价格随时变化;文中的算例都是“假设数字”,只用来演示算法,请代入你自己查到的真实价格。论文和第三方文章里的结论只作为参考,来源见文末。法律与合规部分不构成法律意见,请咨询专业人士。
“我是该自己部署模型,还是直接调 API?”这是社区里除了选显卡之外最常见的问题。答案并不是“本地一定更好”,也不是“API 一定更省”。本地部署还是 API,要看你的用量、数据敏感度、需要的模型能力、预算,以及愿不愿意自己运维。这篇文章给你一份可以直接填的决策清单,也坦率讲出本地部署不划算的情形。需要了解基本概念,先读《本地大模型是什么》。
先说结论:多数人最终会走向“混合”
我们读到的几份分析在大方向上很一致:
- 学术上有一篇关于本地部署成本的论文(arXiv:2509.18101)指出,本地部署的回本周期取决于模型大小:小模型可能几个月,中等模型约 2 年,更大的模型可能 5 年,主要适合用量极高(论文给出的量级是每月 5000 万 token 以上)或者有严格数据驻留要求的组织。它同时认为中等规模的组织适合混合策略:敏感工作负载放在本地,突发流量交给云端。
- PromptQuorum 的硬件指南(2026-10-17)给出一个面向个人的经验法则:每月不到 10 万 token 的轻度用户,云端 API 每月只要几美元,而且无需买硬件;每月超过 1000 万 token 的重度用户,本地大约 6 到 12 个月回本。这是第三方的粗略说法,不是通用结论。
- 需要提醒的是,不同来源给出的“盈亏平衡点”相差很大,因为它们假设的模型大小、利用率和对比的 API 价格不同。所以我们不建议你直接套某个数字,而是自己算。
本地部署还是 API:五个维度逐项打分
| 维度 | 偏向本地的情形 | 偏向 API 的情形 |
|---|---|---|
| 用量 | 每天稳定、大量调用,设备能长时间保持忙碌 | 用量小、忽多忽少,设备大部分时间闲置 |
| 隐私与合规 | 数据不能出本地,如客户资料、内部文档 | 内容不敏感,或服务商能满足你的合规要求 |
| 模型能力 | 开源模型已能满足任务 | 需要最强的闭源模型或最新模型 |
| 预算形态 | 能接受一次性投入,想要可预期成本 | 不想有前期投入,按用量付费 |
| 运维 | 愿意自己维护驱动、更新、备份 | 没人手,也不想管 |
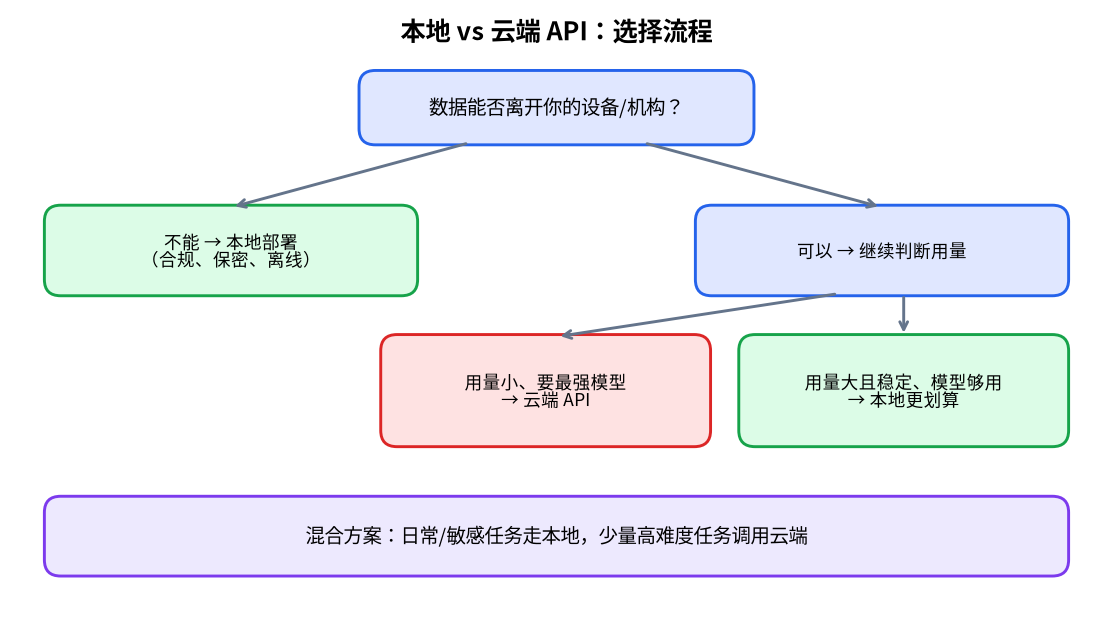
怎么用这张表:每一行选一个更接近你的情形,只要“隐私”这一行选了本地,其他维度往往就退居其次;如果“模型能力”这一行选了 API,那就不要为了省钱硬上本地。
用量:自己算一笔账
成本的核心是“固定成本分摊”。API 按用量付费,设备则不管用不用都在折旧。可以这样算:
- 本地月成本 = 设备价格 ÷ 预计使用月数 + 每月电费 + 你的维护时间折算。
- API 月成本 = 每月 token 数 ÷ 1000 × 每千 token 单价(输入和输出价格不同,要分开算)。
- 比较两者;还要问自己:设备的利用率有多高?
假设数字示例(仅演示算法):假设一台本地机器 20,000 元,预计用 36 个月,折合每月约 556 元,再加每月电费 50 元,合计约 606 元。如果你用 API 一个月只花 100 元,那么每月本地约 606 元,远高于 API 的 100 元,这种用量下 API 更划算;如果你每月 API 花费 1,500 元,本地每月 606 元就明显占优(前提是设备能满足你的任务,也没有算上你的维护时间)。请把这些数字替换成你的真实价格,中国市场的参考整机价(按 2026-10 市场中位价估算,以实际报价为准):入门约 7,900 元,主流 16GB 约 10,900 元,24GB(二手 RTX 3090)约 14,300 元,32GB(RTX 5090)约 65,700 元,详见《本地大模型装机配置》;API 单价请以服务商官网为准。
需要注意的几件事:
- 利用率:只要设备大部分时间闲着,本地的“每 token 成本”就会很高。
- 隐形成本:电费、散热、你的时间、故障和备份都要算进去。
- 能力差距:如果本地模型完成不了你的任务,再便宜也没意义。
隐私与合规:不要把它神化,也不要忽视
本地部署最硬的理由是数据不出本地。如果你处理的是客户资料、内部文档、医疗或金融数据,并且规定不能发给第三方,本地基本是唯一选项。但也要注意两点:
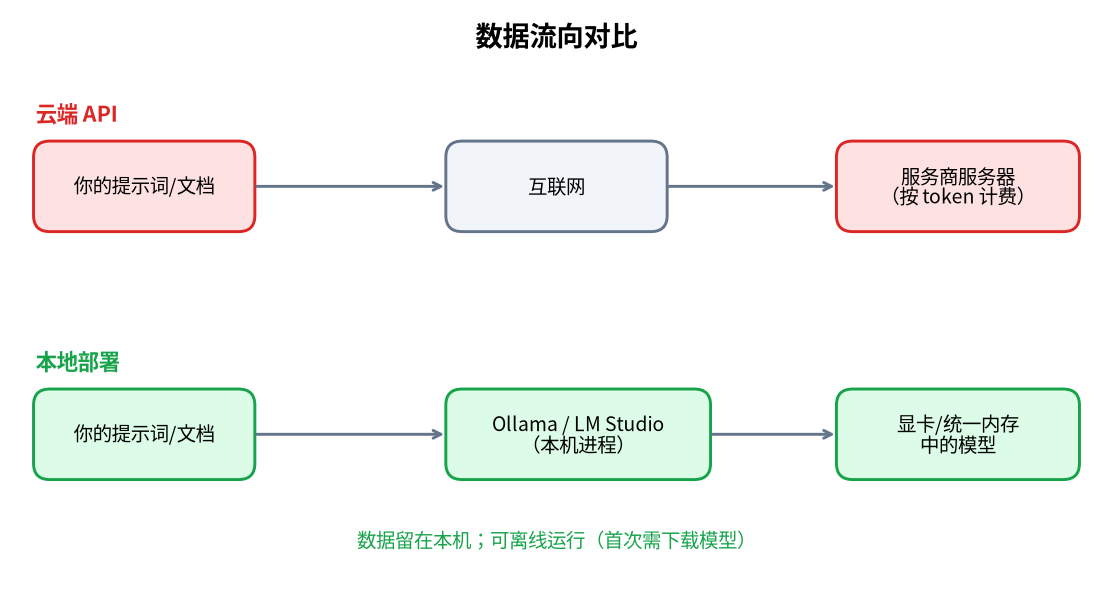
- “本地”不等于“整条链路都本地”。Open WebUI 的官方文档特别提醒:本地推理并不会让你另外配置的云端工具、提取或嵌入服务也变成本地;选择云端模型,会把提示词和包含的上下文发送给该服务商。
- Ollama 的云端标签:Ollama 模型库里有带
-cloud后缀的标签(例如 gpt-oss 的 20b-cloud、120b-cloud),它们跑在云端,而不是你的机器上。如果你有隐私要求,请检查你实际调用的是不是本地标签。
关于合规,PromptQuorum 的指南提到中国自 2025 年 9 月 1 日起实施 AI 生成内容标识办法和国家标准 GB 45438-2025,并认为使用开源权重模型在本地运行可以避免“基于 API”的合规暴露(针对企业内部使用)。这只是一家第三方的说法,具体到你的业务是否合规,请咨询法务或主管部门,我们不提供法律意见。
模型能力:开源模型够用吗
本地部署只能用你能下载并且显存放得下的开源权重模型,具体选择见《本地大模型推荐》。API 则可以使用服务商提供的最新、最强的模型,但这也意味着模型随时可能改版,你对版本没有控制权。对多数日常问答、写作、摘要、代码补全来说,一个放得下显存的开源模型已经够用;对最难的推理、长链条任务,可能还是要借助更强的云端模型。我们没有自己的对比评测,所以最可靠的办法还是用你自己的 10 个真实任务去比。
本地与云端的混合方案
实际中,很多人最终采用混合:
- 敏感、重复、量大的任务放本地,比如内部文档问答、批量摘要。
- 最难的任务升级到云端,比如复杂推理。
- 用同一个界面统一入口:Open WebUI 支持同时连接 Ollama、兼容 OpenAI 的接口等多种后端,本地和云端模型可以放在同一个下拉框里,见《Open WebUI 搭建教程》。
这样做的好处是不必二选一,可以先用 API 验证需求,再把稳定的重复任务逐步迁到本地。
一条务实的路线
| 阶段 | 做什么 | 判断标准 |
|---|---|---|
| 第 1 阶段:试用 | 用 API 或现有电脑跑小模型,验证你到底需要什么 | 你是否真有持续的需求? |
| 第 2 阶段:记录 | 记录一两个月的 token 量、任务类型和对隐私的要求 | 用量是否稳定?哪些任务不能出本地? |
| 第 3 阶段:估算 | 用上面的算法,代入真实价格 | 回本周期是否能接受? |
| 第 4 阶段:采购 | 按任务选显存档位,见《大模型显存需求怎么算》和《本地大模型装机配置》 | 先买够用的,不要一步到位 |
| 第 5 阶段:混合 | 本地跑稳定任务,云端处理难题 | 持续检视,必要时调整 |
如果你不想自己装机,也可以看《大模型一体机选购指南》了解成品方案的优缺点。
常见的误区
- “本地一定省钱”:设备闲置时本地很不划算,轻度用户尤其如此。
- “API 不安全,所以必须本地”:这取决于你的数据和合规要求,以及你和服务商之间的协议。别忘了本地也要做备份、权限和更新。
- “买了高端显卡就不用再花钱”:电费、散热、你的时间都是成本,模型更新还会让你想要更大的显存。
- “开源模型和闭源模型差距可以忽略”:在你的任务上有没有差距,要自己测。
常见问题(FAQ)
本地部署一定比 API 便宜吗?
不一定。用量小、设备闲置时 API 更划算;用量大而稳定时本地才可能更省。请用上面的算法代入真实价格自己算。
每月用多少 token 才值得本地部署?
不同来源给出的数字差别很大。PromptQuorum 提到个人用户每月超过 1000 万 token 时本地约 6 到 12 个月回本,arXiv 论文则把经济上的有利区间放在每月数千万 token 以上的组织规模。请当作粗略参考。
本地部署的数据真的不会外传吗?
模型推理本身在你的机器上,但只要你同时配置了云端模型、云端搜索或云端嵌入服务,对应的数据就会发给这些服务。请检查实际调用路径。
本地模型能替代最新的闭源模型吗?
对多数日常任务可能够用,对最难的推理任务可能不够。最好用你自己的任务做对比。
可以先用 API 再换本地吗?
可以,这也是我们推荐的路线。用 API 验证需求并记录用量,再决定是否投入硬件。
中小企业应该怎么选?
先问数据能不能出本地,再看用量和运维能力。多数中小企业适合混合方案:敏感任务本地,其他走 API。
下一步与社区
如果你正在纠结,可以把每月大致的使用场景、数据敏感程度和预算范围发到社区(加入社区),我们和其他成员会帮你一起算这笔账。我们在深圳做本地大模型机器的选型、采购、组装与实测,如果算下来本地适合你,也可以帮你配一台;如果算下来 API 更合适,我们也会直说。先聊需求,不强制购买。