模型泄露核查 7 步法:怎么判断“权重泄露”“破解版”消息是真是假(以 numbat、GSQ-RCO 为例)
每隔几周,社区就会冒出一条类似的消息:“某闭源模型的权重泄露了”“某模型被破解、拒答清零、显存只要 12GB”。这类消息传播很快,真假却往往很难一眼看出。这篇文章把我们在核查 numbat 与 GSQ-RCO 两条消息时用的方法整理成可复用的 7 步法,专门做模型泄露核查:从来源、元数据、算术自洽、自述矛盾、数字口径、独立复现,到安全处置。文中只写核查方法与证据,不提供任何下载链接,也不教如何绕过模型的安全限制。案例数据取自我们此前的两篇核查文章,那两篇的读取日期是 2026-11-01 与 2026-11-02;本文更新于 2026-11-04。
要点速览(更新于 2026-11-04)
- 7 步依次是:找第一手来源、查元数据、做算术自洽检查、找自述内部矛盾、辨别口径与术语、找独立复现与官方声明、做安全处置并分级下结论。
“数字对得上”不等于真:numbat 的 14T 参数与 7.72TB 体积完全自洽,但自洽只说明作者算得仔细。
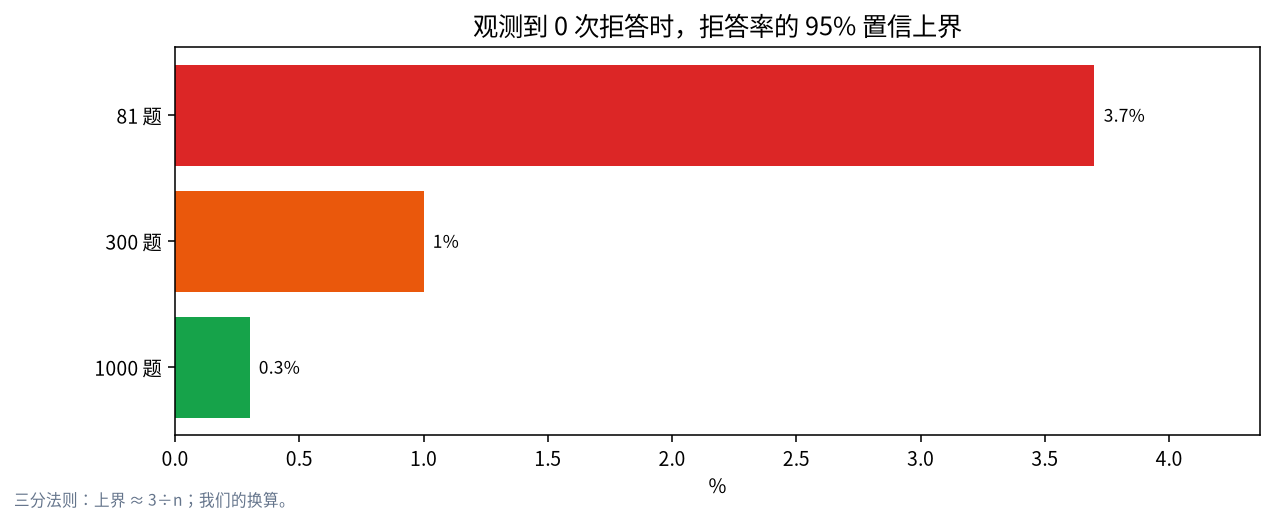
“拒答清零”要看样本量:在 81 道题上观测到 0 次拒答,真实拒答率的 95% 置信上界仍约 3.7%(三分法则,我们的换算)。
“解除限制”类消息还要核对术语:GSQ-RCO 是量化方法的名字,不是去审查方法。
核查结论要分级:已证实、倾向于假、无法判断;并写清“我们做了什么、没做什么”。
模型泄露核查的 7 个步骤
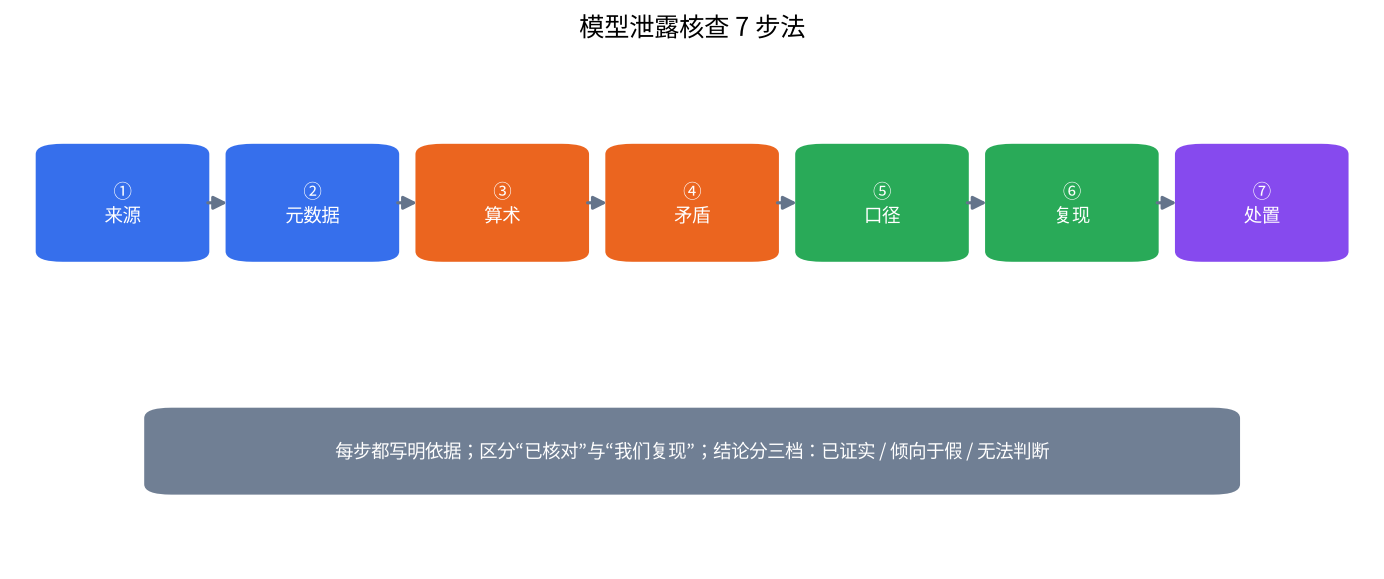
先说框架:每一步都回答一个问题,并产出一条“可以被别人检查”的依据。
| 步骤 | 要回答的问题 | 典型证据 | 常见陷阱 |
|---|---|---|---|
| 1 找第一手来源 | 谁说的?官方有没有声明? | 官方博客、模型卡、论文、官方账号 | 把“多人转发”当成来源 |
| 2 查元数据 | 仓库何时创建、谁上传、提交记录如何 | 平台公开接口、提交历史、存储用量 | 只看标题与简介 |
| 3 算术自洽 | 参数量、位宽、体积、显存能否互相验证 | 手算与配置文件对照 | 以为对得上就是真的 |
| 4 找自述矛盾 | 作者自己的说法前后是否一致 | 配置、日志、README 的互相对照 | 只读 README 开头 |
| 5 辨别口径 | 指标相对谁、样本多大、术语是否用对 | 模型卡的评测说明与方法名 | 把下界当作整体、把量化方法当作编辑方法 |
| 6 独立复现与官方声明 | 有没有第三方能复现?官方怎么说 | 社区审计、同行评审、官方回应 | 把“有人说”写成“已证实” |
| 7 安全处置与分级 | 能不能下载?结论是什么级别 | 风险评估、置信度分级 | 为了验证而冒险执行代码 |
第 1 步:找第一手来源,不要停在转发
任何“泄露”或“破解”的消息,先问两个问题:发布者是谁,官方是否说过什么。在 numbat 事件里,仓库自称是 Anthropic 下一代模型的检查点,但我们此前的核查没有找到任何能把仓库与 Anthropic 联系起来的来源,也没有找到 Anthropic 对该仓库的声明;已知的官方表态只是:此前的 Claude Code 源码泄露没有涉及模型权重,Mythos Preview 不计划普遍开放。仓库 README 里的“为什么应该相信”清单——代号在泄露源码里出现过、架构符合预期——都不是来历证据,代号是公开信息,任何人读了新闻都能拿来命名自己的仓库。详情见Mythos 权重泄露核查。
第 2 步:查元数据,让平台告诉你事实
很多平台的公开接口会提供创建时间、提交历史和存储用量,不必下载任何大文件。比如 Hugging Face 的仓库页面和接口能显示文件列表、总大小和提交记录。核对时重点看:创建时间与消息出现的时间是否一致;提交是否分批、一次性上传;存储用量与声称的体积是否对得上;上传者账号是新建的还是有历史的。元数据本身不能证明真假,但能帮你排除一类“说的和文件根本不是一回事”的情况。
第 3 步:做算术自洽检查,但别把“自洽”当证据
算例:numbat 的体积。 仓库声称约 14T 参数、7.72TB。按我们此前的核查:NVFP4 把两个 4 位数值打包进一个字节,HF 页面按字节计数得到 6.85T,折算后 4 位权重约 13.67T 个;NVFP4 每 16 个权重共用一个 8 位缩放,所以每个权重约 4.5 位,即 0.5625 字节。体积 ≈ 13.67×10¹² × 0.5625 + BF16 部分(约 168.5 亿个 × 2 字节 ≈ 34GB)≈ 7.69TB + 0.03TB ≈ 7.72TB,与 HF 记录的 7.72064TB 一致。
这说明两件事:第一,“HF 显示 6.85T,和 14T 对不上,所以是假的”是误读;第二,所有数字都对得上,也不能说明模型是真的,因为伪造者同样可以让数字自洽。算术检查的价值,是排除错误的批评与低级的造假,而不是证明真实。
第 4 步:找自述内部的矛盾
不需要任何复现,就能看出的矛盾最有说服力。numbat 的 README 说检查点来自“训练中期”,但元数据写它位于约 196 万步训练运行的第 183 万步,约 93%,训练日志里学习率处于衰减阶段,更像训练接近尾声;自述在 Trainium2 上做 NVFP4 评测,而我们核对的 AWS Neuron 文档里,Trainium2 列出的数据类型没有 FP4。单条矛盾可能只是措辞问题,多条矛盾叠加,可信度就会下降。读 README 时,把配置文件、日志和评测说明拿出来对照,别只读开头的宣传部分。
第 5 步:辨别口径与术语
“解除限制”类消息最常见的问题不是造假,而是口径不清。以 GSQ-RCO DeepSeek V4.1 Flash 为例(详见GSQ-RCO 核查):
- 术语:GSQ-RCO 是奥地利 ISTA-DASLab 的量化方法,不是去审查方法;转发里的“abliteration 2.0”也是措辞错误。
- 基线:KL 0.02 是编辑版相对未编辑的量化档的偏移,不是相对原版模型,而且是 top-64 下界。
- 样本量:作者自己的英文有害提示测试集只有 81 条(据我们此前的核查,与 XSTest 等是不同的测试集),“拒答清零”是从 85.2%–88.9% 降到 0.0%。
算例:样本量。 81 题上观测到 0 次拒答,真实拒答率能确定在多低?统计学里的“三分法则”给了一个近似:n 次试验观测到 0 次事件,95% 置信上界约为 3÷n。n = 81 时约 3.7%;n = 300 时约 1.0%;n = 1000 时约 0.3%。也就是说,“拒答清零”只能读成“这 81 题里没观察到拒答”,不能读成“任何情况下都不拒答”。这是我们的换算,不是原作者的结论。更多评测方法见拒答率评测怎么看与基准测试怎么看。
第 6 步:找独立复现与官方声明
最强的证据是别人能独立复现。在 numbat 事件里,社区成员在讨论区报告:43 个完整张量可以只靠“张量名做种子的随机数”逐位重现,并且在读取之前记录了预测值;另一名成员称 NVFP4 大矩阵也是如此。我们的做法是把它们写成“某某报告”,因为我们没有自己复现。读者可以按公开的方法,用 HTTP 范围请求读取几个很小的字节段验证,而不是下载整个仓库。同时,要检索官方有没有回应;没找到不代表不存在,只能写“我们没有找到”。
第 7 步:安全处置并给结论分级
核查的目的不是“亲手下载验证”。对来路不明的模型仓库,不要下载大文件,更不要用 trust_remote_code=True 加载:它会在加载时执行仓库提供的 Python 代码,等于信任陌生人。我们读过 numbat 的两个 Python 文件,只看到对 torch、transformers 和标准库的引用,没有发现网络、子进程或写文件调用,但这是抽查而非审计。另一方面,“泄露”的权重如果是真的,还可能涉及商业秘密与版权问题,见无审查模型的合规与法律风险。
最后,结论分级建议用三档:已证实(有第一手来源或独立复现)、倾向于假(多项证据指向同一方向,但没有决定性证明)、无法判断(证据不足)。numbat 我们判断为“倾向于伪造”,并且写明了仍然无法排除的三件事:没读完全部数据、“伪造”只是基于公开证据的判断、即使是伪造也不代表没有真实泄露的可能。
两个案例对照
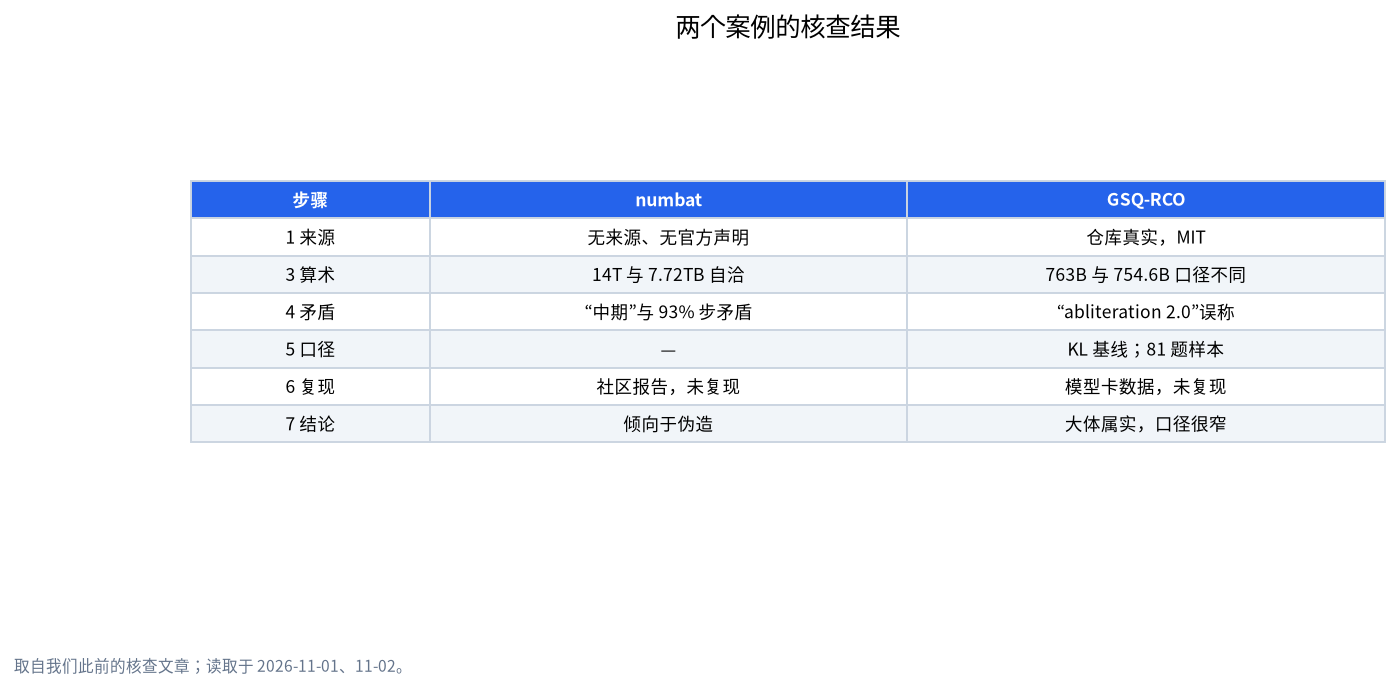
| 步骤 | numbat(Mythos 权重传闻) | GSQ-RCO DeepSeek V4.1 Flash |
|---|---|---|
| 1 来源 | 没有找到来源与官方声明 | 仓库真实存在,MIT 许可,3 档 GGUF |
| 2 元数据 | 仓库公开,772 个分片,7.72TB | 厂商模型卡与量化文件可查 |
| 3 算术 | 14T、7.72TB 自洽 | 763B 与 754.6B 口径不同,两个数字都对 |
| 4 矛盾 | “训练中期”与第 93% 步矛盾;FP4 与 Trainium2 不符 | 转发里“abliteration 2.0”与实际方法不符 |
| 5 口径 | 不涉及 | KL 是相对未编辑量化档;拒答清零样本只有 81 题 |
| 6 复现 | 社区报告权重可由名字重算,我们未复现 | 数据来自模型卡与指标文件,我们未复现 |
| 7 结论 | 倾向于伪造 | 大体属实,但口径很窄 |
一份可以直接用的核查模板
遇到下一条“泄露”或“破解”消息,可以按下面的格式记笔记:
- 消息原文与出处,读取日期(含时区)。
- 第一手来源是什么?官方有无声明?
- 平台元数据:创建、提交、体积、上传者。
- 手算:参数量、位宽、体积、显存。
- 自述内部矛盾清单。
- 指标的基线、样本量、方法名是否准确。
- 独立复现与官方回应;标注“我们复现”或“某某报告”。
- 安全处置;结论分级;“我们做了什么、没做什么”。
我们怎么核对,没做什么
本文的方法来自我们此前对 numbat 与 GSQ-RCO 的核查;案例数据取自那两篇文章,并已按原文标注来源。三分法则是一个通用的统计近似,我们用它做了换算。我们这次没有重新下载任何权重、没有运行仓库代码,也没有联系任何官方机构;案例的结论仍是当时的判断,后续如有新证据会更新。
常见问题
模型泄露核查最先该看什么?
先看第一手来源:谁发布、官方有没有声明。多人转发不算来源。
“数字对得上”能说明是真的吗?
不能。自洽只说明制作者算得仔细,伪造品同样能做到。它的作用是排除错误的批评和低级造假。
“拒答清零”可信吗?
要看样本量和口径。81 道题上观测到 0 次拒答,真实拒答率的 95% 置信上界约为 3.7%,所以只能读成“这批题里没有观察到”。
可以下载来路不明的模型试试吗?
不建议。尤其不要用 trust_remote_code=True,它会执行仓库里的代码。能通过元数据和小片段读取判断的,就不要下载。
我没有技术基础,怎么判断一条消息?
看有没有官方来源、有没有独立复现、自述是否前后矛盾。没有这三样时,把它当作“未证实”。
核查结论应该怎么写?
分成已证实、倾向于假、无法判断三档,并写明“我们做了什么、没做什么”,注明读取日期。
想让我们核查一条消息?
欢迎到社区留言,或发邮件到 admin@microaione.com,附上你看到的链接和问题,我们会按这套方法来核对。
同专题阅读:大模型越狱简史、越狱、破甲与破解的区别;全部文章见大模型越狱与安全专题。
参考资料:Hugging Face Hub 安全文档、Transformers:自定义代码与 trust_remote_code、三分法则(Wikipedia)、Anthropic:Project Glasswing,以及本站此前的 numbat 与 GSQ-RCO 核查文章。读取日期 2026-11-04。