大模型越狱、破甲、破解是什么?一文讲清区别、原理与风险
打开中文社区,你会同时看到“大模型越狱”“破甲”“破解”“无审查版”“解除限制”这些说法,它们经常被混着用,但指的其实是几件不同的事。想搞清楚一个“破甲模型”到底改了什么、一条“越狱提示词”为什么偶尔有效、为什么有些做法会让你踩到法律和安全的坑,先要把概念分清。这篇文章是本站“大模型越狱与安全”专题的总览:我们解释大模型越狱的含义、几类常见攻击的原理、防守方怎么应对、本地模型的特殊性,以及风险与合规。需要先说明一条本站的做法:我们不发布能直接使用的越狱提示词,也不写绕过安全限制的操作步骤,只讲原理、历史、防御、红队和风险。这样既能回答你的问题,也不会给别人提供伤害他人的工具。文中的数字全部来自公开论文和官方页面,我们没有自己实测任何越狱手法。
要点速览(更新于 2026-11-04)
- “越狱”(jailbreak)指通过输入让模型违背其安全训练;“破甲”是中文社区对它的口语化叫法;“破解”在大模型语境里常被借用,但它和破解软件授权不是一回事。
越狱改的是“输入”,不改模型;“无审查版”“abliteration(拒绝方向消融)”改的是“权重”,是另一条路线,见我们的拒绝方向消融原理详解。
研究表明越狱并非靠运气:2023 年的论文把原因归为“目标冲突”和“泛化不匹配”,2024 到 2025 年又出现了长上下文、多轮渐进和随机增强等系统化方法。
防守方也在进步:Anthropic 的自测里,加上分类器后越狱成功率从 86% 降到 4.4%,代价是约 23.7% 的额外推理开销。
风险是真实的:法律上要遵守《生成式人工智能服务管理暂行办法》等规定;技术上,来路不明的“破甲权重”还可能带恶意代码。本文是一般信息,不是法律意见。
大模型越狱到底指什么:六个常被混用的词
先看一张对照表,把几个词分开:
| 词 | 通常指什么 | 动的是什么 | 是否改动模型权重 | 典型出现场景 |
|---|---|---|---|---|
| 越狱(jailbreak) | 用特殊输入让模型违背安全训练,输出本应拒绝的内容 | 输入(提示词) | 否 | 在线聊天产品、API、本地模型都可能 |
| 破甲 | 中文社区对“越狱”的口语说法,也被用来指“去掉模型的拒答” | 视语境而定 | 视语境而定 | 论坛、短视频标题 |
| 破解 | 借用自“破解软件”,在大模型里常指解除限制;与破解授权、破解加密不是一回事 | 视语境而定 | 视语境而定 | 搜索关键词、教程标题 |
| 无审查模型(uncensored) | 经微调或编辑,几乎不再拒答的模型版本 | 权重 | 是 | Hugging Face 上的社区改版 |
| Abliteration(拒绝方向消融) | 一种直接编辑权重、削弱“拒绝”倾向的技术 | 权重 | 是 | 开源社区的“去拒答”模型 |
| 提示词注入(prompt injection) | 攻击者把恶意指令藏进模型会读取的内容里,让应用被劫持 | 应用的数据通道 | 否 | 带检索、带工具的应用 |
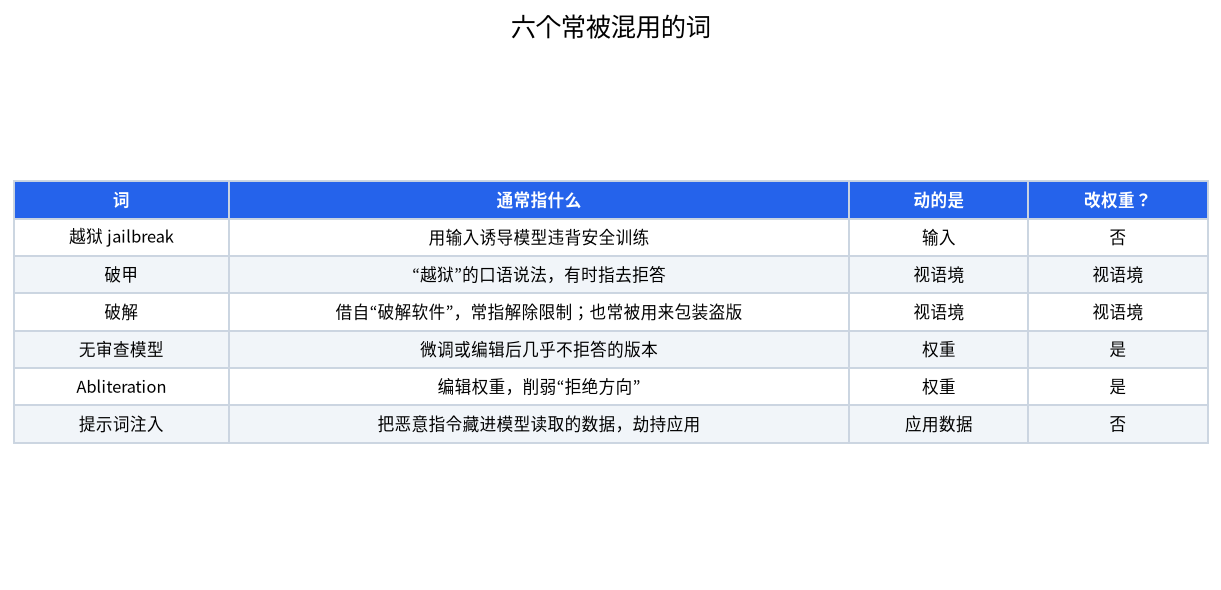
这里最容易混淆的是“越狱”和“提示词注入”。OWASP 在它的大模型应用风险清单里把提示词注入列为第一项(LLM01),并说明两者相关但不同:越狱是想让模型无视自己的安全规则,注入是想让模型执行攻击者混进数据里的指令。前者的受害面常常是“模型说了不该说的话”,后者的受害面常常是“应用做了不该做的事”,比如泄露数据、乱调用工具。
另外,“破解”这个词要小心。如果你在搜索“大模型破解版”,很可能遇到的是盗版安装包或带木马的“整合包”。本站对盗版、破解授权、磁力链接一律不提供,这和讨论模型安全是两件事。
一个模型为什么会“不回答”:五个层次
很多人以为模型的“限制”是一个可以关掉的开关,其实不是。一个模型拒绝回答,原因可能来自五个层次:
- 预训练数据:数据清洗时去掉了一部分有害内容,影响有限。
- 指令微调:用大量“问题—合适回答”的样本教模型怎么答,其中包含拒答样本。
- 对齐训练:例如基于人类反馈的强化学习或偏好优化,让模型倾向于无害、诚实、有帮助。
- 系统提示与产品规则:厂商在对话之前塞给模型的规则。
- 输入输出过滤:模型之外的分类器或规则,在输入进入前、输出返回前把关。
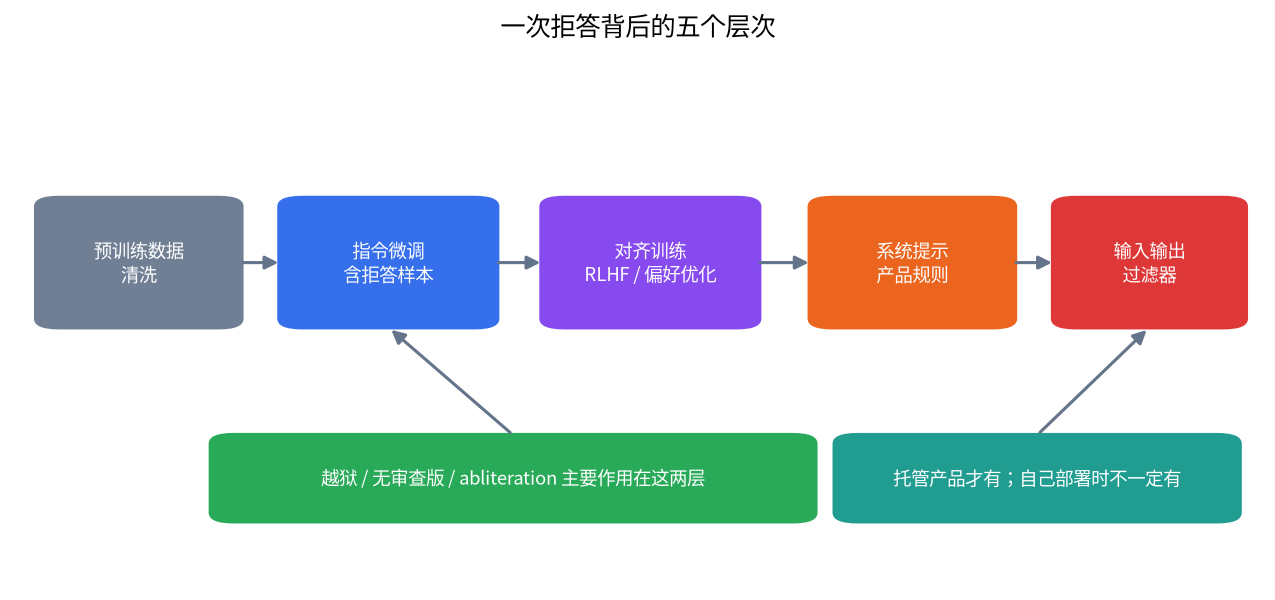
这个分层很重要,因为不同做法针对的层次不同:越狱主要在对抗第 2、3 层(靠输入诱导),“无审查版”和 abliteration 直接改第 2、3 层(改权重),而在线产品还有第 4、5 层,是你在本地部署时不一定拥有的。也正因为如此,本地部署的开源模型和网页聊天产品“表现出来的限制”常常不一样,这一点我们在 Qwen 本地部署需要破甲吗里会专门讲。
为什么越狱会有效:两个失效模式
2023 年,Wei 等人在论文《Jailbroken: How Does LLM Safety Training Fail?》里提出,安全训练失效有两个主要模式:目标冲突和泛化不匹配。论文的意思是:模型同时被要求“有帮助”和“无害”,当请求被包装成让“有帮助”压倒“无害”时,就可能出问题;另外,模型的能力覆盖面很广,而安全训练覆盖的输入分布较窄,换成训练里很少见的表达形式时,安全行为可能没有同步泛化。
理解这两点,你就明白为什么越狱不是“有一句神奇咒语”,而是一个攻防博弈:防守方补一类漏洞,攻击方换一种包装。公开研究里常见的几类攻击,我们只在类别层面列出:
| 类别 | 大意(不含可用内容) | 公开研究的代表 | 论文或官方给出的结果 |
|---|---|---|---|
| 手工角色扮演与包装 | 用虚构身份、场景转移模型的注意力 | 2022 至 2023 年社区流传,Wei 等做了归纳 | 属于“目标冲突”的典型 |
| 自动优化的后缀 | 用算法自动搜索让模型顺从的字符串 | GCG(Zou 等,2023) | 论文称生成的后缀可迁移到多个商用与开源模型 |
| 让一个模型去攻击另一个 | 用攻击者模型反复改写请求 | PAIR(Chao 等,2023) | 论文题目称约二十次查询内即可成功 |
| 长上下文示例堆叠 | 用大量虚构问答填满上下文 | Anthropic 的 many-shot jailbreaking(2024) | Anthropic 称长上下文窗口扩大了这一攻击面 |
| 多轮渐进 | 从无害话题一点点升级 | Crescendo(Microsoft,2024) | 论文称常在不到五轮内奏效 |
| 随机增强再抽样 | 对输入做大量随机扰动并反复尝试 | Best-of-N(2024) | 论文摘要称在 10,000 个增强样本下,GPT-4o 成功率 89%、Claude 3.5 Sonnet 为 78% |
这些成绩都是各论文在自己的测试集、自己的设置下得到的,不同表之间不能直接比大小,也不代表今天的最新模型还是同样表现。更完整的时间脉络见我们的大模型越狱简史。
本地模型有什么不同:越狱之外,还能改权重
在线产品里,用户只能改输入;本地部署的开源模型,权重就在你的硬盘上,于是出现了第二条路线:直接改权重。2024 年 Arditi 等人的论文《Refusal in Language Models Is Mediated by a Single Direction》报告:在他们测试的多个开源聊天模型里,“拒绝”行为可以对应到激活空间中的一个方向,抹掉它就能显著减少拒答。这就是“abliteration”一类做法的研究基础。我们已经分别写过它的原理和相关事件:拒绝方向消融原理详解、DeepSeek V4.1 Flash 1017 Obliterated 解读,以及对流传说法的核查GSQ-RCO 事实核查。
需要强调的是:改权重得到的“无审查版”并不是“更强”的模型。它通常只是“更少拒绝”,有时会连带损失质量,而且它去掉的是模型自己的一层保护,并不会替你判断一个请求是否合法、安全。
防守方怎么应对
防守不是靠一个办法,而是多层叠加:对齐训练、系统提示、输入输出分类器、对工具权限的限制、日志监控和持续的红队测试。Anthropic 在 2025 年发布的 Constitutional Classifiers 研究是一个有数字的例子:他们用 10,000 条合成的越狱提示做自动评测,没有分类器时越狱成功率是 86%,加上分类器后降到 4.4%;同时在 5,000 条真实对话上拒答率只上升约 0.38%,推理开销增加约 23.7%。另外,183 名参与者在约两个月里花了估计超过 3,000 小时尝试越狱原型系统,当时没有人找到能一次回答全部十个禁问题的通用越狱(以上均为Anthropic 自测与公布的结果)。
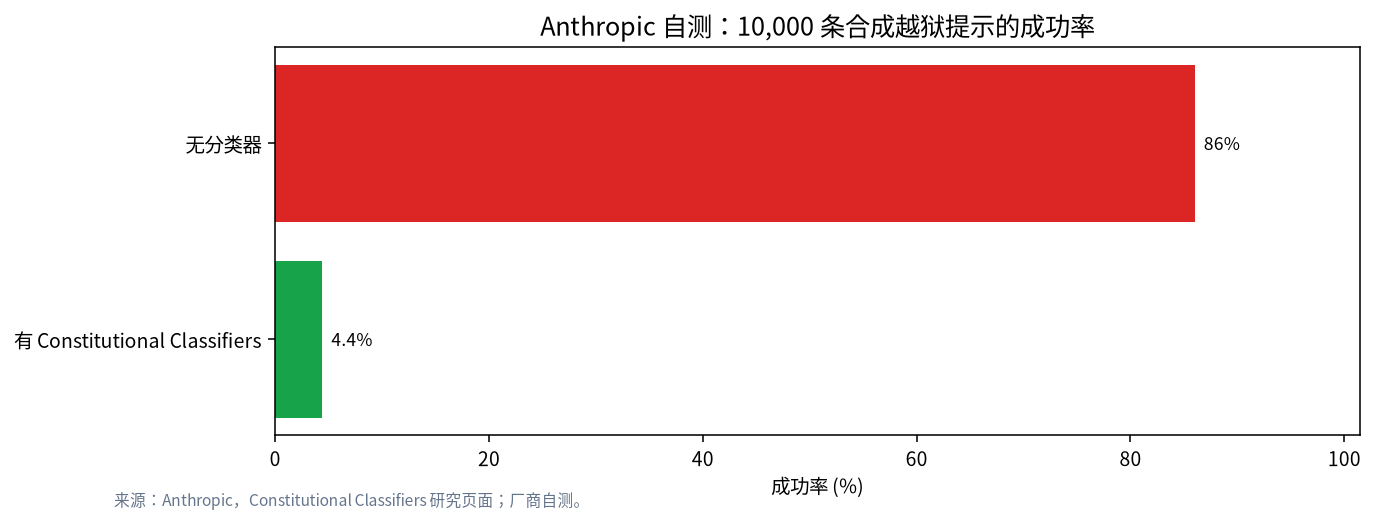
这些数字说明两件事:一是分层防御确实有效;二是它有成本,而且结论只对这个特定测试成立,不等于“越狱已被解决”。防御的详细拆解见 越狱防御是怎么工作的,如果你想给自己部署的模型加一层护栏,可以直接看 Llama Guard 与 Qwen3Guard 本地部署。
风险与合规:你要提前想清楚的几件事
法律层面。 在中国大陆,《生成式人工智能服务管理暂行办法》自 2023 年 8 月 15 日起施行。办法第四条要求提供和使用生成式人工智能服务应当遵守法律法规,不得生成危害国家安全、含有暴力、淫秽色情、虚假有害信息等法律禁止的内容;第十四条规定提供者发现违法内容要及时处置。这里的要点是:谁把模型作为服务提供给别人,谁就要承担相应义务。个人在自己电脑上研究是一回事,把一个“去掉拒答”的模型做成对外服务是另一回事。其他国家和地区也有各自的规则,例如欧盟的人工智能法规。以上是一般信息,不是法律意见,涉及具体业务请咨询律师。
平台与许可层面。 在线产品的服务条款通常禁止规避安全措施;开源模型的许可证和使用政策也可能限制用途。
安全层面。 来路不明的“破甲版”权重本身就是风险:pickle 格式可以在加载时执行任意代码,Hugging Face 对此有专门的安全说明;要求开启 trust_remote_code 的仓库也要格外小心。我们在 14T 参数 MoE 要什么硬件里列过识别可疑仓库的清单。
质量层面。 少拒绝不等于更好用。无审查改版可能更容易产生幻觉或不合适的内容,用于业务前必须自己评估。
正当的需求,应该怎么处理
绝大多数人搜“破甲”,其实遇到的是下面几种正常问题:
- 模型“过度拒答”:把无害问题当成了危险问题。常见的正当解决办法是换一个更合适的模型、把任务背景交代清楚,或者在自己合法的产品里调整系统提示的角色设定。
- 想研究模型安全:应该走红队测试的路径,在隔离环境里用公开基准评估,见 红队测试入门。
- 想要不过滤的创作或研究助手:需要先确认用途合法,并遵守所在地区的规则与模型许可。
本站的做法
我们的原则很简单:写原理、历史、防御、红队、新闻核查和合规风险;不发布能直接复制使用的越狱提示词;不提供规避安全限制的步骤;不提供盗版与磁力链接。我们没有自己测试任何越狱手法,文中引用的数字都标明了来源,并说明这些是论文或厂商在特定测试下的结果。
常见问题 FAQ
大模型越狱和“破甲”是一回事吗?
在中文社区里,“破甲”通常是“越狱”的口语化说法,有时也被用来指“去掉模型的拒答”。严格来说,越狱指通过输入诱导模型违背安全训练,不改权重;而“无审查版”是改了权重的另一个版本。
“大模型破解”是破解软件授权的意思吗?
不是。大模型语境里的“破解”多半指解除限制,但这个词也常被用来包装盗版和带木马的安装包,遇到“破解版”要格外小心。
越狱提示词真的有效吗?
公开论文显示,在特定模型和特定测试集上,一些攻击能取得较高成功率;但厂商会持续修补,所以今天有效的写法很快会失效,而且这些结果不能外推到所有模型。本站不提供具体提示词。
本地部署的模型一定比在线产品更容易被越狱吗?
不一定。本地模型通常没有产品层的输入输出过滤,所以表现出的限制来自权重本身;但它同样经过对齐训练。更关键的差别是:本地模型的权重可以被修改。
无审查模型合法吗?
下载和研究本身的法律风险取决于所在地区、用途和内容;把它作为对外服务运营则需要承担相应的合规义务。具体请咨询律师。
怎么给自己的本地模型加防护?
可以在模型前后各加一道安全分类器,例如 Llama Guard 或 Qwen3Guard,再配合权限控制和日志,见我们的 本地护栏部署教程。
和我们聊聊
如果你在部署本地模型时遇到“过度拒答”、想给团队的模型加安全护栏,或者想让我们解读某条新出现的“破甲”消息,欢迎到社区留言,或发邮件到 admin@microaione.com。想系统阅读这个主题,可以从我们的大模型越狱与安全专题开始。
参考资料:Wei 等,Jailbroken(2023)、Zou 等,GCG(2023)、Arditi 等,拒绝方向(2024)、Anthropic,Constitutional Classifiers、OWASP LLM01、生成式人工智能服务管理暂行办法。数据读取于 2026-11-04,北京时间。