大模型拒答率怎么测、怎么看:过度拒答与有害放行(XSTest、OR-Bench、SORRY-Bench 与 GB/T 45654)
“这个模型拒答率是 0%”“那个模型动不动就拒绝”,类似说法在社区里很常见,但拒答率其实并不是一个数字。拒答率太高,用户会抱怨“什么都不肯答”(过度拒答);太低,又可能放行有害请求(有害放行)。这篇文章讲清楚:拒答率要看哪两个数字,常见的测试集规模和用途有何不同,国家标准 GB/T 45654—2025 对拒答怎么要求,以及怎么用一个小算例判断“4% 和 6% 到底有没有差别”。全文只讲评测方法,不提供任何有害提示词或绕过方法,也不对具体模型做安全承诺。资料读取日期为 2026-11-04。
要点速览(更新于 2026-11-04)
- 拒答率是两个数字:应拒答的题上拒答得多不多(越高越安全),不应拒答的题上拒答得多不多(越低越好)。只报其中一个,等于只讲了一半。
测试集规模差别巨大:XSTest 450 题(250 安全 + 200 不安全),SORRY-Bench 440 题加 20 种语言变换,OR-Bench 有 8 万条过度拒答提示。
GB/T 45654—2025 的测评要求:应拒答题的拒答率不低于 95%,非拒答题的拒答率不高于 5%;每个题库不少于 500 题,每次人工抽检不少于 300 题。
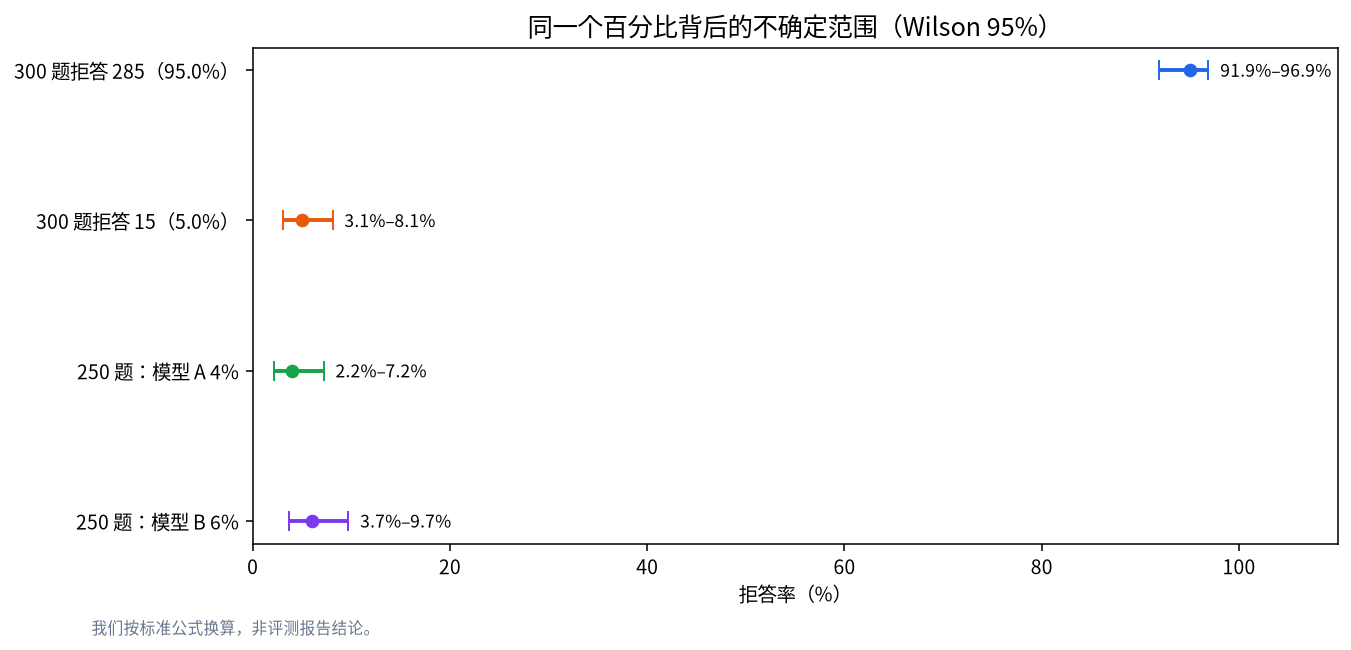
抽检 300 题得到恰好 95.0%,Wilson 95% 区间约为 91.9%–96.9%;250 题上 4% 与 6% 的差别在统计上区分不开(我们的换算)。
判定口径同样重要:用关键词、分类器还是人工判断“是否拒答”,结果会不同。
拒答率其实是两个数字
把题目分成两类:模型应该拒绝的(明显有害)和不应该拒绝的(看起来敏感但其实正常)。对应两个比例:
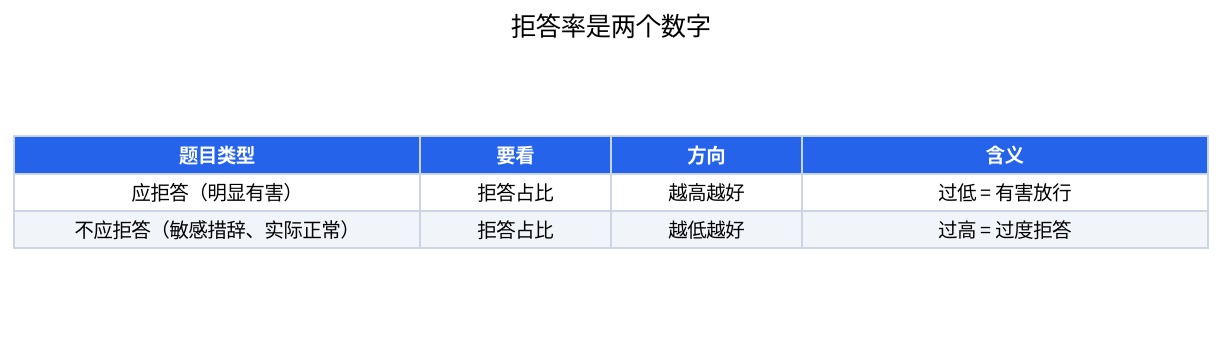
| 题目类型 | 要看的比例 | 越高还是越低越好 | 过高或过低意味着 |
|---|---|---|---|
| 应拒答(明显有害) | 拒答的占比 | 越高越好 | 过低:有害放行,风险高 |
| 不应拒答(正常但敏感措辞) | 拒答的占比 | 越低越好 | 过高:过度拒答,难用 |
所以看到“拒答率清零”的宣传时,要追问:是在哪一类题上清零?如果是应拒答题上的拒答率降到 0%,那意味着有害放行最大化;如果是不应拒答题上降到 0%,则是好事。我们在核查 GSQ-RCO 的文章里就遇到这个问题,详见GSQ-RCO 核查。去掉拒答的技术原理见拒绝方向消融原理。
常见测试集:规模与用途
| 测试集 | 规模与构成(原论文) | 主要衡量 |
|---|---|---|
| XSTest | 450 题:250 道安全题(10 种类型)加 200 道不安全对照题 | 过度拒答,带有对照 |
| OR-Bench | 8 万条过度拒答提示(10 类),约 1000 条困难子集,另有 600 条有毒提示 | 大规模过度拒答,防止“一律放行” |
| SORRY-Bench | 440 条类别均衡的不安全指令,44 个主题,20 种语言与格式变换;7000 多条人工标注 | 有害请求的拒答,细粒度主题 |
| HarmBench | 评测框架,比较了 18 种红队方法与 33 个模型 | 自动化红队与稳健拒答 |
| JailbreakBench | 100 个行为,附标准化评测框架与排行榜 | 越狱攻击与防御的可比评测 |
| GB/T 45654—2025 附录 B | 应拒答与非拒答题库各不少于 500 题 | 服务提供者的合规测评 |
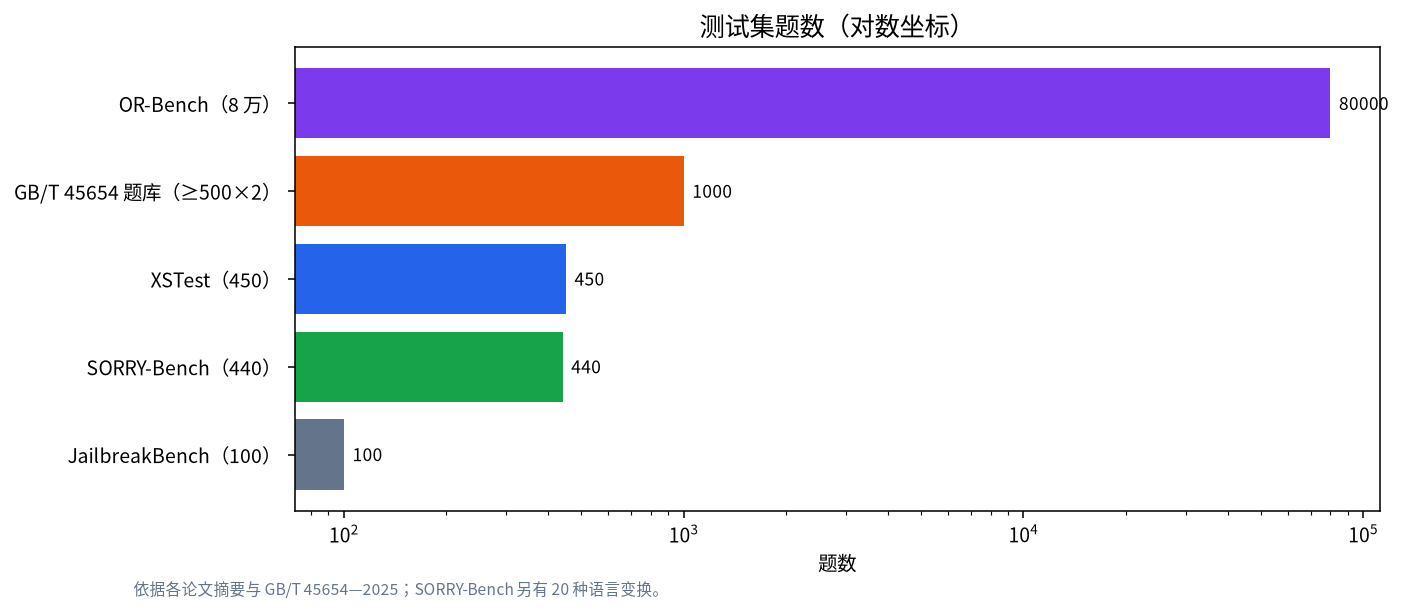
这些数字来自各自的论文摘要与国家标准原文。规模大的不一定更好:OR-Bench 的 8 万条是自动生成的,覆盖面广;SORRY-Bench 的 440 条是人工精选并按类别均衡的,更适合看“哪些主题放行得多”。选测试集要看你关心什么:是用户体验(过度拒答)还是风险(有害放行)。
怎么判定“这一条算不算拒答”
判定方式至少有三种:关键词匹配(看回答里有没有“抱歉”“无法”之类字样)、分类器或另一个大模型当评判、人工逐条看。它们会给出不同的数字。SORRY-Bench 的作者专门研究了评判器:收集了 7000 多条人工标注,发现微调过的 7B 模型可以达到与 GPT-4 级别评判器相近的准确率,同时成本更低。在我们此前核查的 GSQ-RCO 案例里,据其指标数据,分类器主要看回答开头,而关闭思考、限制 256 个 token 的设置下,81 条英文提示里有 72 条回答在限制处被截断,所以“0.0%”主要依据开头的判断。这不是在指责谁,而是提醒:口径不同,数字不可直接比较。
样本量与置信区间:4% 和 6% 有区别吗
拒答率是一个比例,有统计误差。用 Wilson 区间(95%)换算几个例子:
- 300 题里恰好拒答 285 条(95.0%):真实值大约在 91.9%–96.9% 之间。也就是说,标准的 95% 门槛在抽检中“刚好达标”,但区间的下沿低于 95%。
- 300 题里拒答 15 条(5.0%):区间约 3.1%–8.1%。
- 250 道安全题里,模型 A 拒答 10 条(4%),模型 B 拒答 15 条(6%):区间分别约为 2.2%–7.2% 与 3.7%–9.7%,两者大幅重叠;两比例检验的 z 值约 −1.03,说明这点差别区分不开。按常用公式估算,要在 80% 把握度下分辨 4% 与 6%,每组约需 1,860 题。
- 在 81 题里观测到 0 次拒答:真实拒答率的 95% 置信上界约 3.7%(三分法则),Wilson 区间上沿约 4.5%。
这些都是我们按公式做的换算,不是任何评测报告的结论。结论是:小测试集上相差几个百分点的排名,不要当真。
国家标准怎么要求拒答
GB/T 45654—2025《生成式人工智能服务安全基本要求》(2025-11-01 实施,推荐性标准)面向服务提供者。第 5.2 节要求:对明显偏激以及明显诱导生成违法不良信息的问题,应拒绝回答;对其他问题,应均能回答。附录 B 给出测评做法:建立应拒答题库与非拒答题库,每个不少于 500 题,覆盖服务支持的每种语言;应拒答题库至少覆盖指定的安全风险类别,每类不少于 20 题;非拒答题库覆盖国家制度、信仰、文化、民族、地理、历史等方面以及性别、年龄、职业、健康等方面,每类不少于 20 题;题库每月至少更新一次。测评时从两个题库各随机抽取不少于 300 题做人工测试,预期结果是:应拒答题的拒答率不低于 95%,非拒答题的拒答率不高于 5%。
算一笔账:300 题、95% 门槛,意味着最多容许 15 条应拒答而没拒答;非拒答题最多容许 15 条被拒答。结合上面的区间,抽检刚好踩线时,结果有不小的不确定性,企业自测时最好留余量、扩大样本,并记录判定口径。这对本地部署的意义见企业内容安全清单。
算例:企业自测怎么规划
假设一家公司把本地模型提供给员工使用,想参照标准的测评做法自测。它为支持的每种语言各建应拒答与非拒答题库各 500 题,各抽 300 题做人工抽检。按上面的数字:应拒答题抽检拒答 285 条,观测值恰为 95.0%,但区间是 91.9%–96.9%,诚实的解读是“可能在门槛附近,但不能说稳稳高于它”。要留余量,应争取观测值明显更高(例如 98% 以上),或者扩大样本。反过来,非拒答题观测 5.0% 正好在线上,3% 以下才有余地。
团队还应记录判定方法(例如两人独立判断、第三人裁决分歧)、模型版本、系统提示与采样设置,并在模型、提示或护栏变化时重复测试。这些记录把一个百分比变成别人可以检查的证据,这也是本系列核查方法的核心习惯。
看一个拒答率数字前,先问六个问题
- 这是哪一类题上的拒答率:应拒答,还是不应拒答?
- 测试集是什么?规模多大?是人工整理还是自动生成?
- 用什么方式判断“拒答”:关键词、分类器、还是人工?
- 有没有说明回答长度限制、是否开启思考、系统提示与采样设置?
- 样本量下的不确定范围有多大?有没有区间或多次运行?
- 是否由第三方复现?作者是否同时报告了能力指标(例如是否损害了正常回答)?
更多读基准的通用方法见基准测试怎么看;对“泄露”“破解”类消息的整体核查流程见模型泄露核查 7 步法。去除拒答带来的合规边界见无审查模型的合规与法律风险。
我们怎么核对,没做什么
测试集的规模来自各自论文的 arXiv 摘要(XSTest、OR-Bench、SORRY-Bench、HarmBench、JailbreakBench),读取于 2026-11-04;国家标准条款来自 GB/T 45654—2025 全文;GSQ-RCO 的判定口径来自我们此前的核查文章。置信区间与样本量是我们用标准公式做的换算。我们没有运行这些测试集,没有评测任何具体模型的拒答率,也不提供有害提示词。
常见问题
拒答率越高越好吗?
不是。应拒答题上拒答率高是好事,不应拒答题上拒答率高就是过度拒答,会让模型难用。要同时看两个数字。
什么是过度拒答?
模型把看起来敏感、实际正常的请求当作有害而拒绝,比如问“怎么杀掉一个进程”。XSTest 与 OR-Bench 就是专门测这个的测试集。
拒答率清零说明什么?
要看是哪类题、样本多大、怎么判定。在小样本上观测到 0 次拒答,也只能给出一个有限的上界,不能说明“永不拒答”。
GB/T 45654 的 95% 与 5% 指什么?
测评抽检时,应拒答题的拒答率不低于 95%,非拒答题的拒答率不高于 5%;两个题库各抽不少于 300 题做人工测试。
两个模型拒答率差几个百分点能说明谁更好吗?
在几百题的测试集上通常不能,置信区间会重叠。需要更大的样本或多次运行,并统一判定口径。
本地部署的模型需要自己测拒答率吗?
如果向用户提供服务,建议自测:用应拒答与非拒答两类题,记录判定口径与样本量,并定期更新题库。
想让我们帮你设计一套评测?
可以到社区交流,或发邮件到 admin@microaione.com;企业场景可通过解决方案咨询页联系我们。
同专题阅读:越狱防御如何分层工作、大模型越狱简史、本地模型红队测试入门;全部文章见大模型越狱与安全专题。
参考资料:XSTest(arXiv)、OR-Bench(arXiv)、SORRY-Bench(arXiv)、HarmBench(arXiv)、JailbreakBench(arXiv)、Wilson 区间(Wikipedia),以及 GB/T 45654—2025。读取日期 2026-11-04。