KV cache 显存占用:上下文长度怎么吃显存,公式、算例与排查(2026)
你下载了一个 5GB 的模型文件,显卡有 12GB,一切正常,直到你把上下文长度调大,模型突然慢得像爬,或者直接报显存不足。缺失的那一块就是 KV 缓存。这篇文章讲清楚 KV cache 显存占用 是怎么回事:KV 缓存是什么,怎么用公式计算,7B 到 70B 模型的算例,缓存量化怎样省内存,Ollama 的默认值是什么,以及怎么解决问题。读完之后,你可以在下载任何东西之前就估算出内存。如果想先了解权重那一侧,请读《显存计算器指南》。
核对说明:模型参数(层数、注意力头数、键值头数、隐藏维度)来自 Hugging Face 上 Qwen2.5 与 Llama 3.1 模型公开的 config.json,大小由我们按文中公式以 GiB 为单位对 f16 缓存计算得出。Ollama 的默认上下文随显存大小变化、OLLAMA_CONTEXT_LENGTH、OLLAMA_KV_CACHE_TYPE 和 flash attention 的说明来自 Ollama 文档,2026-10-30 核对。我们没有实测内存占用,实际运行时还会在这些数字之上增加开销。
要点速览(更新于 2026-10-30)
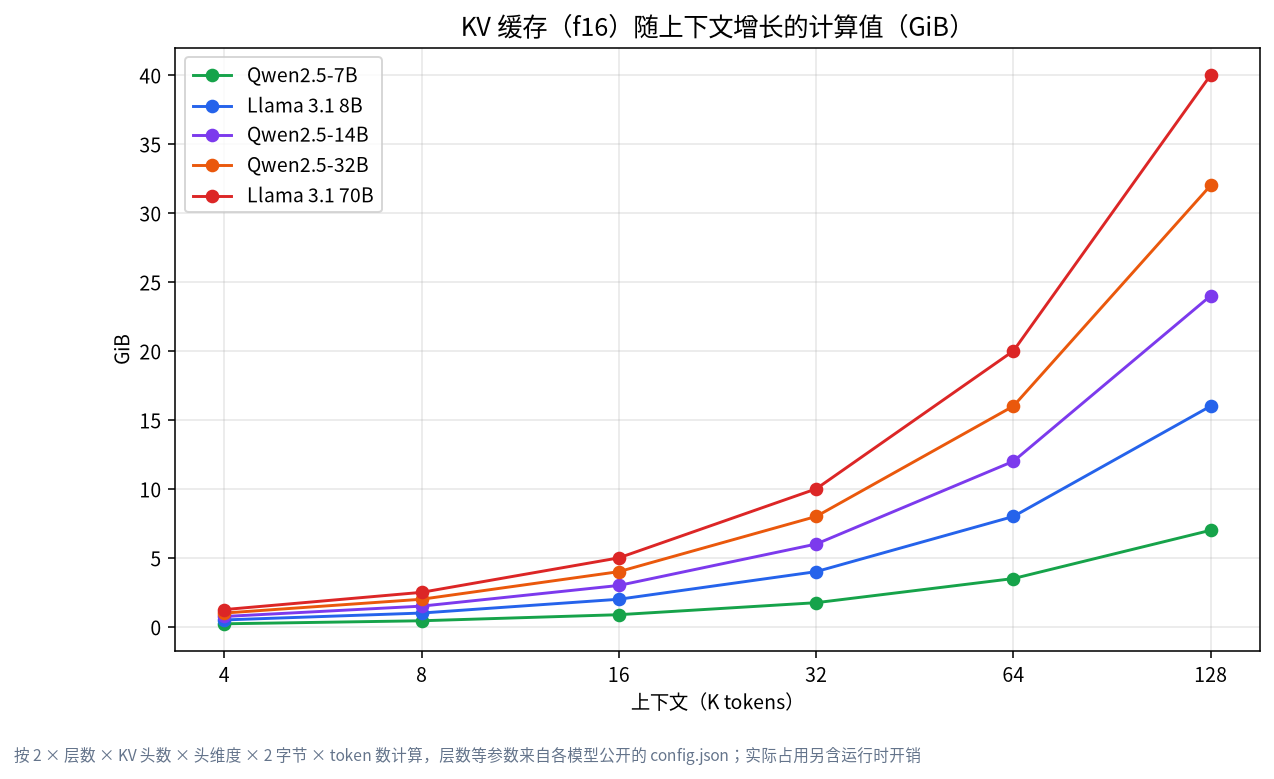
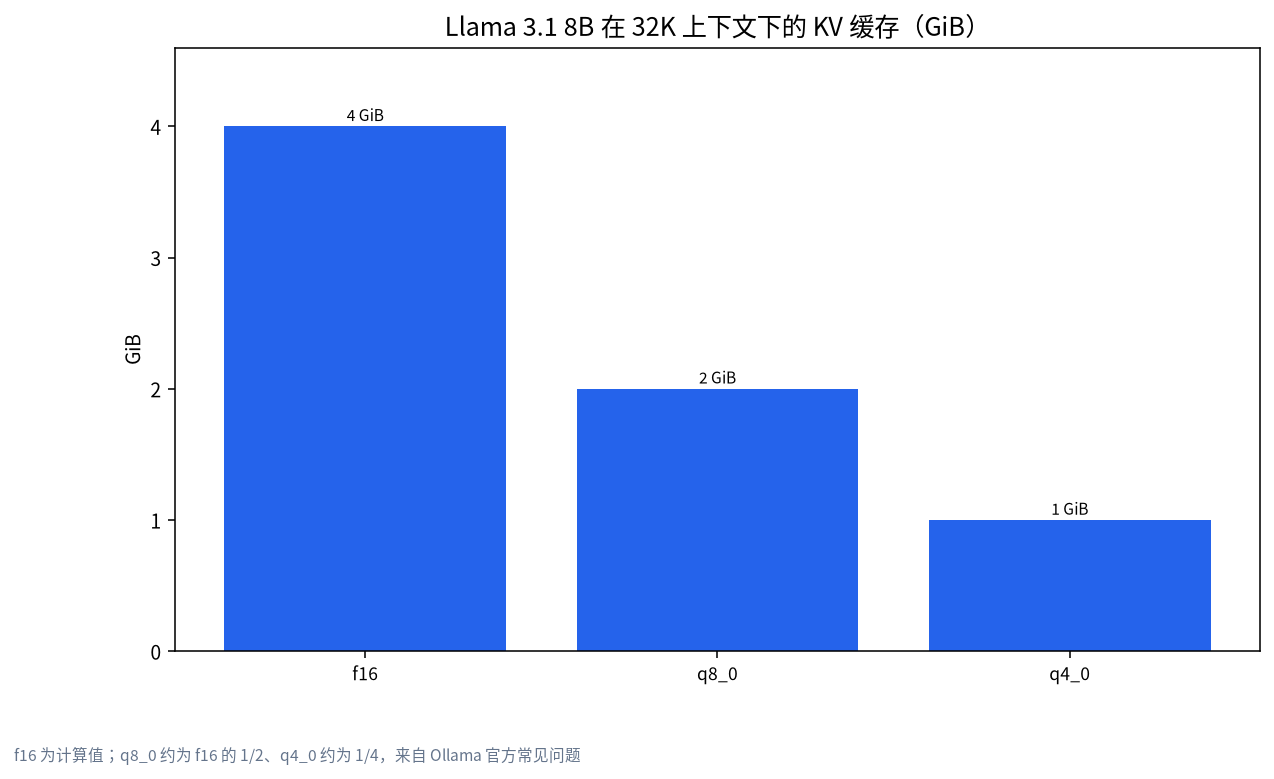
- KV 缓存随上下文线性增长:Llama 3.1 8B 的 f16 缓存是每 token 128KiB,32K 时为 4GiB,128K 时为 16GiB。
权重是固定的,但缓存是你的选择:更小的上下文或量化缓存(q8_0 约一半,q4_0 约四分之一)可能决定能放下还是溢出到 CPU。
Ollama 的默认上下文取决于显存:低于 24GiB 为 4K,24GiB 到 48GiB 为 32K,48GiB 及以上为 256K;做编程和智能体任务时要主动设置。
KV 缓存是什么
Transformer 模型生成文字时,要回看之前的每一个 token。为了避免每一步都重新计算这些 token 的键和值,模型把它们存起来,这就是 KV 缓存。缓存对每一层、每一个已有 token、每个键值头各存一个键向量和一个值向量。对话或文档越长,缓存里的 token 越多,所以它的大小与上下文长度成正比。权重是固定的文件,而缓存是按你要求的上下文分配的,通常与权重位于同样的高速内存中。
公式
对于有 L 层、H_kv 个键值头、头维度为 D 的模型,使用 f16(每个数 2 字节):
每 token 的 KV 字节数 = 2(键和值)× L × H_kv × D × 2 字节
再乘以上下文中的 token 数,就得到缓存大小。头维度通常等于隐藏维度除以注意力头数。现代模型使用分组查询注意力,H_kv 远小于注意力头数,所以缓存比同样大小的旧模型要小。
| 模型 | 层数 | KV 头数 | 头维度 | 每 token KV(f16) | 8K | 32K | 128K |
|---|---|---|---|---|---|---|---|
| Qwen2.5-7B | 28 | 4 | 128 | 56KiB | 0.44GiB | 1.75GiB | 7GiB |
| Llama 3.1 8B | 32 | 8 | 128 | 128KiB | 1GiB | 4GiB | 16GiB |
| Qwen2.5-14B | 48 | 8 | 128 | 192KiB | 1.5GiB | 6GiB | 24GiB |
| Qwen2.5-32B | 64 | 8 | 128 | 256KiB | 2GiB | 8GiB | 32GiB |
| Llama 3.1 70B | 80 | 8 | 128 | 320KiB | 2.5GiB | 10GiB | 40GiB |
这张表里的 Qwen2.5 模型发布时的原生上下文是 32K,所以 128K 一列只是用来说明公式,请查看各模型文档给出的上限。Llama 3.1 列出的位置数是 131,072。
KV cache 显存占用的算例:放得下吗
以 Llama 3.1 8B 为例,Q4_K_M 文件约 4.9GB(llama.cpp 文档列出的数字),上下文 32K。f16 缓存是 4GiB,所以权重加缓存约 8.9GB,还没算运行时自身的缓冲区和桌面占用。这在 12GB 显卡上放得下,还有一点余量。到 128K 时,仅缓存就是 16GiB,总量超过 20GB,同一个模型就放不进 16GB 的显卡,除非量化缓存或缩短上下文。
再看一个 32B 模型。按 Q4_K_M 约每十亿参数 0.61GB,文件接近 19.7GB,而 Qwen2.5-32B 在 8K 时缓存是 2GiB,合计约 21.7GB。这在 24GB 显卡上很紧但可行;到 32K 时缓存是 8GiB,总量约 27.7GB,就放不下了。这些算式解释了一个常见的经历:一个在 4K 上下文时加载正常的模型,到 32K 就失败。硬件选择请看《24GB 显存方案》和《12GB 与 16GB 显存方案》。
缩小缓存:量化与 Flash Attention
Ollama 文档说明,启用 Flash Attention 时可以量化 K/V 缓存以减少内存。环境变量 OLLAMA_KV_CACHE_TYPE 对所有模型全局生效,默认是 f16。q8_0 使用约一半的内存,精度损失很小,如果不用 f16,文档推荐它;q4_0 使用约四分之一,有小到中等的损失,在较大的上下文下可能更明显。文档还指出,GQA 比例高的模型(如 Qwen2)受缓存量化的影响可能更大。
| 缓存类型 | 相对 f16 的内存 | 质量说明 | 何时使用 |
|---|---|---|---|
| f16 | 1 倍 | 精度最高 | 内存够用时 |
| q8_0 | 约 1/2 | 损失很小 | 内存紧张时的首选 |
| q4_0 | 约 1/4 | 小到中等损失,长上下文更明显 | 超长上下文的最后手段 |
Ollama 的默认值与设置
Ollama 的上下文长度页面说明默认值取决于你的显存:低于 24GiB 默认 4K,24GiB 到 48GiB 为 32K,48GiB 及以上为 256K。文档还提到,需要大上下文的任务,如网页搜索、智能体和编程工具,应设置到至少 64,000 个 token。你可以用环境变量 OLLAMA_CONTEXT_LENGTH、在 ollama run 里用 /set parameter num_ctx,或在 API 里用 num_ctx 参数来改变默认值。常见问题还警告并行请求会成倍占用内存:所需内存随并行请求数乘以上下文长度而增长,所以 2K 上下文加 4 个并行请求,在内存里相当于 8K 的上下文。
判断是否溢出到了 CPU
当权重加缓存超过显存,模型的一部分就在 CPU 上运行,速度急剧下降。运行 ollama ps 看处理器一列:完全在 GPU 上的模型显示 100% GPU,拆分时显示百分比。如果调大上下文后看到拆分,就减小上下文、量化缓存、选更小的模型或更小的量化,或者减少并行请求。《Ollama 用不上 GPU 怎么排查》列出了更多检查项,《本地大模型编程助手》说明了为什么编程工具是上下文的大用户。
缓存为什么比想象中更重要
人们比较模型时报的是参数量和文件大小,所以很自然地认为内存使用在下载时就决定了。实际上你需要的内存是权重加上一个缓存,而缓存的大小是你每次加载模型时选择的。这是你能控制的杠杆。两个人用同样的 16GB 显卡和同样的模型,体验可能差别很大:一个用 4K 上下文,全部在 GPU 上,速度快;另一个用 64K,一部分模型在 CPU 上,速度慢。两者都没错,只是向机器要求的东西不同。实际的教训是把上下文长度当作预算:先确定权重占多少,用显存减去权重和安全余量,剩下的才是能花在上下文上的。明智地花掉它,并选择符合质量需求的缓存类型,能让一张普通显卡处理出人意料长的文档。
你到底需要多少上下文
很多任务需要的远低于模型宣传的最大值。随意聊天很少超过几千个 token。总结长文档需要文档加答案,一篇长文章大概 8K 到 32K。检索系统只发送检索到的片段,所以 8K 往往就够,我们的知识库文章里有说明。读取多个文件的智能体和编程助手需要更多,但往往可以分块工作。选择能满足任务的最小上下文,需要时再增加。更长的上下文还会减慢提示处理,因为在第一个字出现之前要处理更多 token。
一个简短的规划步骤
- 找出模型的文件大小,以及层数、KV 头数和头维度。
- 选择你真正需要的上下文长度。
- 用公式计算 f16 缓存,如果要用 q8_0 就减半。
- 加上文件大小、缓存和大约一到两 GB 的缓冲区与桌面占用。
- 与显存比较;超出时先减小上下文,再试缓存类型,最后换更小的模型。
- 加载后用
ollama ps验证。
常见错误
- 只算文件大小:缓存是额外的,可能有好几个 GB。
- 把上下文调到模型最大值:128K 的设置可能需要几十 GB。
- 忘记并行请求:它们会成倍占用上下文内存。
- 不检查质量就量化缓存:请用自己的提示测试,尤其是长上下文。
- 忽略默认值:不同工具不同,有些默认使用更大的上下文。
- 混淆 GB 和 GiB:文件大小常以 GB 计,而这里的缓存以 GiB 计,请留出余量。
多模型与多用户的注意事项
如果你同时运行多个模型或服务多个用户,请记住每个已加载的模型和每个并行请求都有自己的缓存。Ollama 常见问题描述了同时加载模型数量的上限和并行请求的设置,并说明所需内存随并行请求数乘以上下文长度而增长。对于共享服务器,要按最坏情况而不是平均情况规划内存,或限制并行度。让一个请求排队几秒,比让整个服务器溢出到 CPU、让所有人都变慢要好。
常见问题
KV 缓存是什么?
它存放每个已有 token 的键和值向量,让模型不必为每个新 token 重新计算。它的大小与上下文长度成线性关系。
KV 缓存大小怎么算?
用 2 × 层数 × KV 头数 × 头维度 × 每个数的字节数 × token 数。f16 时每个数 2 字节。
32K 上下文需要多少显存?
取决于模型。在权重之外,f16 下 Qwen2.5-7B 约 1.75GiB,Llama 3.1 8B 为 4GiB,Qwen2.5-32B 为 8GiB,Llama 3.1 70B 为 10GiB。
量化 KV 缓存会影响质量吗?
Ollama 文档说 q8_0 通常没有明显影响,q4_0 有小到中等的损失,在较大上下文下可能更明显。请在自己的任务上测试。
Ollama 的默认上下文是多少?
根据文档,显存低于 24GiB 为 4K,24GiB 到 48GiB 为 32K,48GiB 及以上为 256K,可用 OLLAMA_CONTEXT_LENGTH 修改。
为什么增大上下文后模型变慢?
缓存增长,可能把一部分模型挤到 CPU。检查 ollama ps,然后减小上下文、量化缓存或换更小的模型。
分享你的数字
如果你实测的内存与这些估算不同,欢迎告诉我们。把你的模型、上下文和显卡发到社区,或发邮件到 admin@microaione.com。
参考:Ollama 上下文长度、Ollama 常见问题(KV 缓存类型、并行请求)、Qwen2.5-32B-Instruct 配置、llama.cpp 量化说明。