树莓派 跑大模型:小板子在 2026 年到底能跑什么,Jetson 值不值得买
树莓派比一张显卡便宜,耗电低,还能塞进抽屉里,所以很多人会想:能不能用 树莓派 跑大模型,从此不用再为硬件发愁?实话实说:可以,但只能跑小模型,速度也只能算勉强。这篇文章不靠猜测,而是用内存带宽和模型文件大小来解释原因,把树莓派 5 和英伟达的 Jetson Orin Nano Super 放在一起比较,并告诉你小板子什么时候是合适的工具,什么时候二手显卡或迷你主机更划算。如果你刚入门,建议先读本地部署大模型入门。
核对说明:树莓派 5 的规格和官方标价来自树莓派官方产品简介;Jetson Orin Nano Super 的规格和价格来自英伟达产品页和技术博客;模型文件大小来自 Ollama 模型库;带宽规则基于“生成每个 token 都要把整个模型读一遍”的原理。以上均于 2026-10-30 核对。本文的速度数字都是我们推算的理论上限,不是实测结果,我们没有为这篇文章实测任何一块板子。
要点速览(更新于 2026-10-30)
- 树莓派 5 能跑 1.5B 到 3B 的量化小模型,适合学习和轻量任务;7B 模型能装进 8GB,但内存带宽只有十几 GB/s,生成很慢。
Jetson Orin Nano Super 有 8GB 内存、102 GB/s 带宽和 67 TOPS,标价 249 美元,是更适合生成的小板子,但 8GB 仍把你限制在约 7B 到 8B 的 4 位模型。
想要一个通用助手,二手 12GB 显卡或大内存迷你主机,每一块钱买到的速度和空间都比这两块板子多。
树莓派 跑大模型:先看它有什么
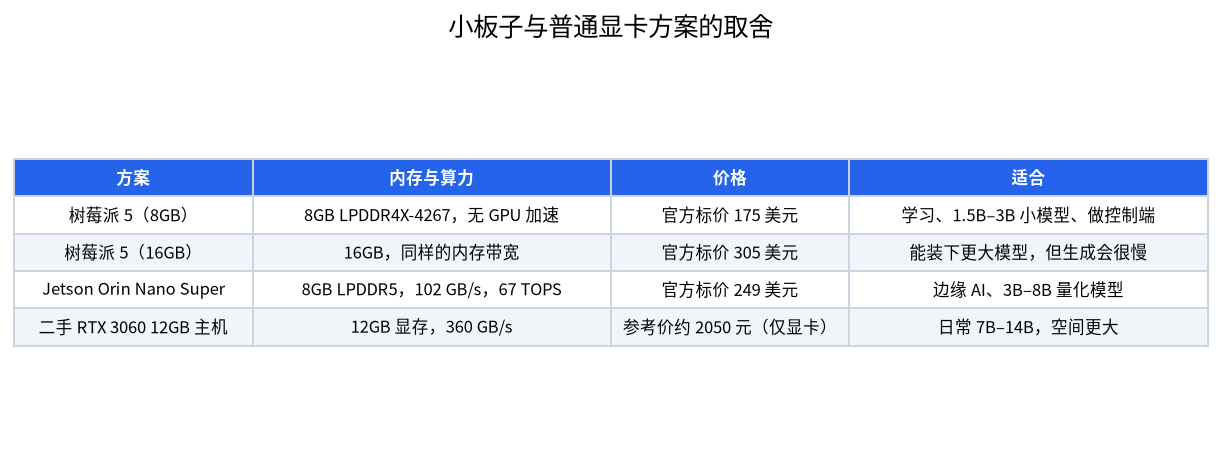
树莓派 5 使用博通 BCM2712,四个 2.4GHz 的 Arm Cortex-A76 核心,内存是 LPDDR4X-4267,有 1GB、2GB、4GB、8GB 和 16GB 几个版本,产品简介里的标价分别是 45、77.5、110、175 和 305 美元。它没有被主流大模型运行时用来加速的 GPU,所以推理全部落在四个 CPU 核心上。跑小模型是可行的:Ollama 模型库里 1.5B 参数的 4 位模型(deepseek-r1:1.5b)约 1.1GB,7B 模型约 4.7GB,都能装进 8GB 内存,这就是网上常说“能跑”的原因。
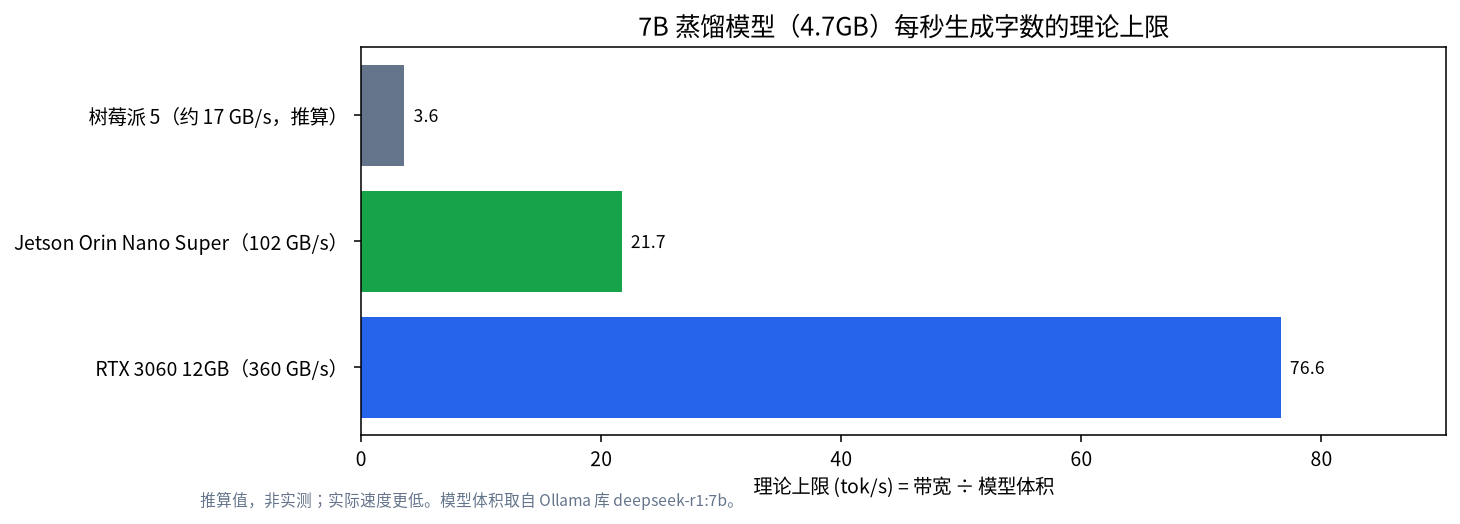
但“能跑”和“跑得好”是两回事。文字生成的速度主要取决于处理器每生成一个 token 要把整个模型从内存读一遍的速度。假设树莓派 5 是单个 32 位的 LPDDR4X-4267 通道,它的峰值带宽约为每秒 4267 兆次传输乘以 4 字节,大约 17 GB/s。这是我们根据公开的内存类型推算的数字,32 位位宽是假设,所以请把它当作数量级参考。用 17 GB/s 除以 4.7GB 的模型,上限约为每秒 3.6 个 token,实际会更低;对 1.1GB 的模型,上限约每秒 15 个 token。这解释了常见的体验:很小的模型还算顺手,7B 模型则像在等一个打字很慢的人。
树莓派 5 与 Jetson Orin Nano Super 的差别
英伟达的 Jetson Orin Nano Super 开发套件是小板子里的明显升级。英伟达标价 249 美元,配 8GB 128 位 LPDDR5 内存,带宽 102 GB/s,1024 个 CUDA 核心的 Ampere GPU(含 32 个张量核心),六核 Arm Cortex-A78AE CPU,AI 性能 67 TOPS(稀疏 INT8),功耗范围 7W 到 25W。英伟达的技术博客说明,“Super”升级通过软件功耗模式把内存带宽从 68 GB/s 提高到 102 GB/s,旧套件升级 JetPack 也能获得。
对语言模型来说,关键差别是带宽加上真正的 GPU。同样 4.7GB 的模型,在 102 GB/s 下上限约每秒 22 个 token,大约是树莓派上限的六倍,而且 GPU 处理提示词阶段也比四个 CPU 核心强得多。代价是软件栈不同:Jetson 运行英伟达的 JetPack Linux 和面向 Arm 的 CUDA,一些桌面工具需要额外步骤或专用构建。如果你只想要一个聊天窗口,这比在电脑上装 Ollama 麻烦,所以请先读 Ollama 安装指南,并在购买前确认你的运行时支持 Jetson。
| 项目 | 树莓派 5(8GB) | Jetson Orin Nano Super | 二手 12GB 显卡主机 |
|---|---|---|---|
| 模型占用的内存 | 8GB 共享内存 | 8GB 共享内存 | 12GB 显存加系统内存 |
| 内存带宽 | 约 17 GB/s(推算) | 102 GB/s | 360 GB/s(RTX 3060 12GB) |
| 4.7GB 模型的上限 | 约 3.6 tok/s | 约 22 tok/s | 约 77 tok/s |
| 功耗范围 | 5V/5A 供电 | 模组 7W 到 25W | 台式机级,显卡约 170W 级 |
| 价格参考 | 官方标价 175 美元 | 官方标价 249 美元 | 显卡参考价约 2050 元 |
| 软件难度 | 低(Arm Linux) | 中(JetPack) | 低(Windows 或 Linux) |
主机一列的价格来自我们的价格参考表(2026-10-30 检查的挂牌价中位数),仅供参考;速度上限由带宽除以文件大小推算,不是基准测试结果。
哪些模型装得下
看文件大小,而不是只看参数量。llama.cpp 的量化说明里,Llama 3.1 8B 的 Q4_K_M 约 4.9GB,大约每十亿参数 0.61GB。8GB 的板子还要给操作系统、上下文缓存和运行时留空间,所以实用的上限是约 5GB 的文件。也就是说,1B 到 3B 模型很从容,7B 到 8B 能装进去但长上下文余量很小,4 位的 14B(约 9GB)则完全装不下。16GB 的树莓派 5 能装下 14B,但在 17 GB/s 下上限只有每秒两个 token 左右,体验很少令人愉快。
| 模型规模 | 4 位文件大小(约) | 8GB 板子装得下吗 | 预期体验 |
|---|---|---|---|
| 1.5B | 约 1.1GB | 可以,余量充足 | 简短回答、简单抽取 |
| 3B 到 4B | 约 2GB 到 2.5GB | 可以 | 日常聊天、短文总结 |
| 7B 到 8B | 约 4.7GB 到 5.2GB | 勉强,上下文要短 | 回答更好,树莓派上很慢 |
| 14B | 约 9GB | 不行(需要 16GB 板子) | 在树莓派上非常慢 |
| 32B | 约 20GB | 不行 | 不是小板子的活 |
1.5B、7B、8B、14B、32B 几行的文件大小参照 Ollama 库里 deepseek-r1 各标签的列示(1.1GB、4.7GB、5.2GB、9.0GB、20GB);3B 到 4B 一行是我们按每十亿参数 0.61GB 估算的。
请把这张表当作预算,而不是承诺。操作系统、运行时和上下文缓存都占用同一块内存,所以刚好等于内存大小的模型是加载不进去的。一个好习惯是:从板子的内存里先减去约 2GB 留给系统和缓存,再选放得进剩余空间的文件,然后用你自己的真实提示词测试,再在上面搭建东西。
上下文长度同样要花内存。正如上下文长度与 KV 缓存的文章所说,7B 级模型每个 token 的缓存需要几十 KB,长对话轻易就吃掉 1GB 以上。小板子上请把上下文控制在 2K 到 4K token,并优先选择专为小尺寸设计的模型。新的小模型往往比旧的大模型更划算,这也是买更大的硬件之前先测试近期 1B 到 4B 模型的最好理由。
小板子适合做什么
小板子的强项是低功耗、常开,或者做一个实体项目,而不是通用聊天助手。下面这些场景它们值得:
- 学习和教学:用很少的钱让学生在真实硬件上看到分词、量化和内存限制。
- 离线小工具:用 1B 到 3B 模型做文本分类、从短消息中抽取字段,或解析语音助手的意图。
- 大机器的控制端:树莓派托管网页界面或调度器,把请求转给局域网里更强的模型。
- 边缘视觉与机器人:Jetson 有 GPU 和摄像头接口,本来就是为读取传感器的模型设计的,语言模型只是附加功能。
- 必须保密的小亭子:数据不能出房间时,即使很慢的本地模型,用来回答短问题也可以接受。
如果你想要电池供电的手机级方案,可以看手机端本地大模型指南。
在树莓派上跑一个小模型的步骤
步骤很短。使用 64 位操作系统,先更新系统,并加上主动散热,因为持续推理会让所有核心长时间满载。模型文件放在通过 M.2 转接板连接的 NVMe 或一块好的 USB 3 硬盘上,不要用慢速的 microSD 卡,因为从卡里加载几个 GB 的文件很痛苦。安装支持 Arm 的运行时:Ollama 和 llama.cpp 都提供 Linux Arm64 版本,llama.cpp 也可以用默认的 CPU 后端从源码编译。拉取一个小的量化模型,例如 1.5B 或 3B 的指令模型,把上下文设为 2048 token,问一个简短的问题,用运行时自带的计时输出测量速度,并记下你自己的数字;我们推算的上限只是上界。
有两个设置有帮助。线程数设为物理核心数(四个),因为在受内存限制的负载下,更多线程只会增加争抢;如果可以,关闭桌面环境,因为图形界面占用的内存你更愿意留给模型。想了解模型文件本身的格式,可以读 GGUF 与 llama.cpp 入门。
比买一台电脑便宜吗
同样的体验并不便宜。16GB 的树莓派 5 标价 305 美元,还不含电源、散热器、外壳和硬盘;8GB 的 Jetson 套件是 249 美元,也不含配件。在我们的参考价表中,二手 RTX 3060 12GB 约 2050 元,新卡约 3475 元,带宽是树莓派的二十多倍。小板子的优势在于功耗和体积,而不是每个 token 的价格。如果你每周只用几个小时,用现有电脑加一块便宜显卡往往更合适。如果你想要一台常开的小机器,不妨对比大内存迷你主机,它在仍然很小的机身里提供更多内存和带宽。
常见错误
- 为了速度买 16GB 版本:更多内存让你装得下更大的模型,而不是跑得更快,带宽并没有变。
- 把模型放在 microSD 卡上:加载慢,还容易磨损,请用 NVMe 或快速外置硬盘。
- 不做散热:推理是持续负载,没有风扇 CPU 会降频。
- 指望 7B 模型有交互感:最多只能预期每秒几个 token。
- 忽略 Jetson 的软件支持:下单前先确认你的工具有 Jetson 版本。
常见问题
树莓派 5 能跑 7B 模型吗?
有 8GB 或更多内存,并使用约 4.7GB 的 4 位文件就可以,但内存带宽是瓶颈,只能预期每秒几个 token。
树莓派 5 上该用多大的模型?
从 1B 到 3B 的量化模型开始,它们装得轻松,给上下文留了空间,速度也够用。
Jetson Orin Nano Super 比树莓派更适合大模型吗?
做生成的话是的:它有 102 GB/s 带宽、GPU 和 67 TOPS,而树莓派对这些运行时没有 GPU 加速。它更贵,也需要英伟达的软件栈。
16GB 的树莓派 5 会让模型更快吗?
不会。它能加载更大的模型,但内存带宽相同,同一个模型的每个 token 速度大致不变。
需要风扇或散热片吗?
需要。持续推理会让四个核心长时间满载,主动散热可以避免降频。
小板子适合做私人助手吗?
对简单的短任务和小模型来说可以。处理长文档、写代码或复杂推理,二手显卡或更大的迷你主机要舒服得多。
和我们聊聊
在规划小板子项目,或者想和电脑装机方案对比?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:树莓派 5 产品简介、英伟达 Jetson Orin Nano Super 开发套件、英伟达关于 Super 升级的技术博客、Ollama 模型库:deepseek-r1。