
24GB 显存跑大模型:RTX 3090 / 4090 级能跑什么模型
核对说明:Ollama 文件大小于 2026-10-30 读取;“显存需求”与“能否放下”的数据取自 CanRun 的公开估算(Q4_K_M、f16 KV 缓存,已逐项标注)。我们没有在 24GB 显卡上逐一实测速度和占用。第三方估算与
ollama ps的实测可能有出入,以实测为准。
如果你手里是 RTX 3090、RTX 4090 这类 24GB 显卡,或者正在考虑买一张,这篇文章回答最关键的问题:24GB 显存跑大模型,到底能放下哪些模型? 先给结论:24GB 是个人用户的“甜点档位”——27B–32B 的稠密模型和 30B 级 MoE 模型都能完整放进显卡;70B 放不下;长上下文是需要精打细算的地方。
24GB 显存跑大模型:到底有多少可用
CanRun 估算,RTX 3090 和 RTX 4090 各自可用约 23.4GB(标称 24GB)。把模型权重、KV 缓存和缓冲区加起来,用可用值去比较,就能知道余量。下表是 CanRun 在 8k 上下文、Q4_K_M、f16 KV 缓存下的估算:
| 模型 | 权重 | KV 缓存(8k) | 合计 | 对 23.4GB 的余量 | 判断 |
|---|---|---|---|---|---|
| Qwen3.6 27B | 16.1GB | 0.5GB | 17.2GB | 约 6.2GB | 宽裕 |
| Qwen3.8 27B | 16.5GB | 0.5GB | 17.6GB | 约 5.8GB | 宽裕 |
| Gemma 4 26B-A4B(MoE) | 16.9GB | 0.2GB | 17.7GB | 约 5.7GB | 宽裕 |
| Gemma 4 31B | 18.3GB | 0.7GB | 19.5GB | 约 3.9GB | 余量充足 |
| Qwen3 30B-A3B(2507,MoE) | 18.4GB | 0.8GB | 19.8GB | 约 3.6GB | 余量充足 |
| Qwen3.6 35B-A3B(MoE) | 21.1GB | 0.2GB | 21.8GB | 约 1.6GB | 偏紧 |
| Qwen3 32B | 19.3GB | 2.1GB | 22.0GB | 约 1.4GB | 很紧 |
| Llama 3.3 70B | 41.9GB | 2.7GB | 45.2GB | 约 −21.8GB | 放不下 |
注意:表中的“余量”是我们用 23.4GB 减去 CanRun 估算合计得出的粗算。Ollama 页面上的文件大小与 CanRun 的权重估算略有不同(例如 qwen3.6:35b-a3b 在 Ollama 页面的 q4_K_M 变体标注 24GB(默认标签 23GB),而 CanRun 估算权重为 21.1GB,其说明提到 llama.cpp 会把输入嵌入表放在系统内存中),所以最终请以加载后的 ollama ps 为准。
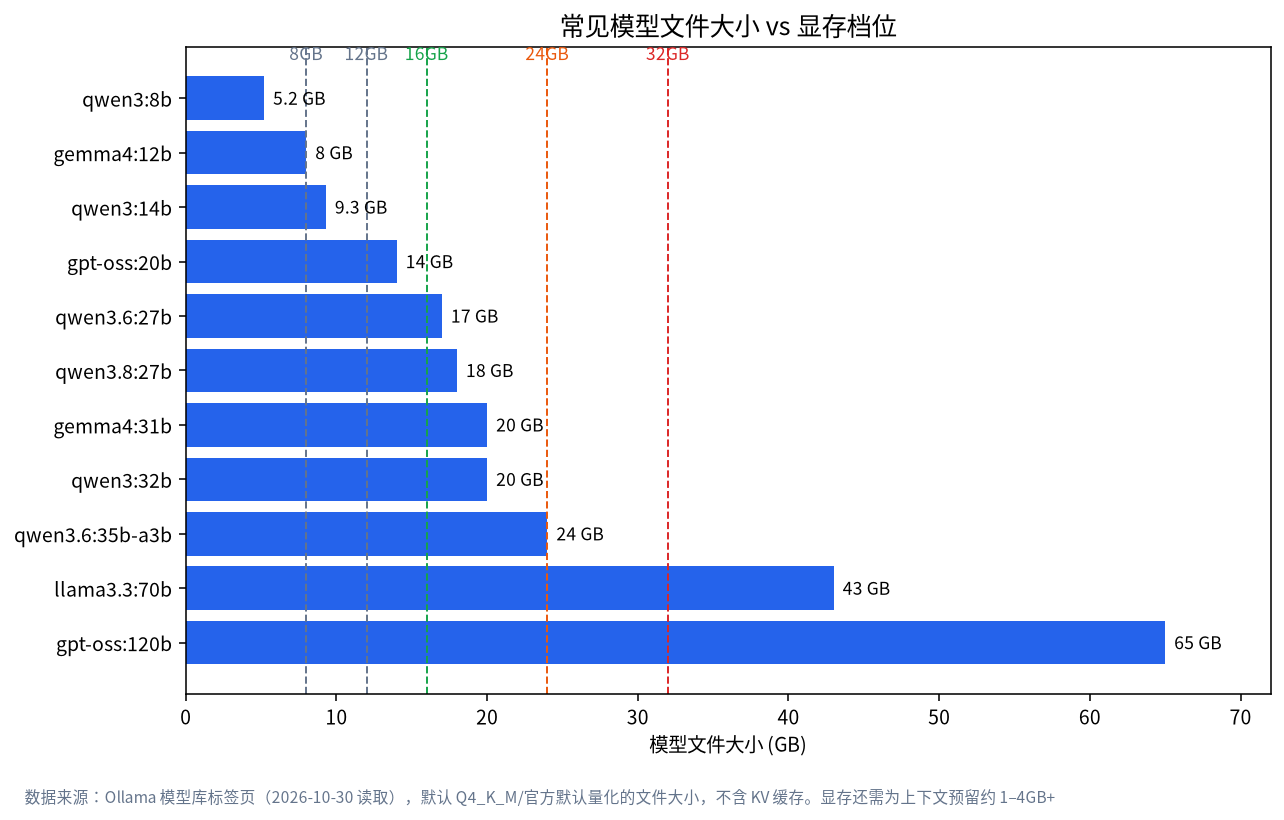
24GB 显卡的推荐模型清单
| 用途 | 推荐标签 | Ollama 文件大小 | 备注 |
|---|---|---|---|
| 通用主力(稠密) | qwen3.6:27b |
18GB(默认标签;q4_K_M 变体 17GB) |
余量最宽裕,可开较长上下文 |
| 通用主力(稠密) | qwen3.8:27b-q4_K_M |
18GB | 同级别,较新 |
| 通用主力(稠密) | gemma4:31b |
19GB(默认标签;it-q4_K_M 变体 20GB) |
31B 稠密模型 |
| 速度优先(MoE) | qwen3:30b-a3b |
19GB | 每次只激活约 3B 参数,生成速度快 |
| 速度优先(MoE) | gemma4:26b-a4b |
16GB(默认标签;it-q4_K_M 变体 18GB) |
约 4B 激活参数 |
| 编程 | qwen3-coder:30b |
19GB | 30B 级 MoE 编程模型,页面标注 256K 上下文 |
| 推理 | deepseek-r1:32b |
20GB | 思考过程占上下文,见《DeepSeek 本地部署》 |
| 稠密 32B | qwen3:32b |
20GB | CanRun 估算 8k 需要 22.0GB,只在短上下文下舒服 |
模型选择更细的比较见《本地大模型推荐》,Qwen 系列的尺寸选择见《Qwen 本地部署》。
长上下文:24GB 的真正瓶颈
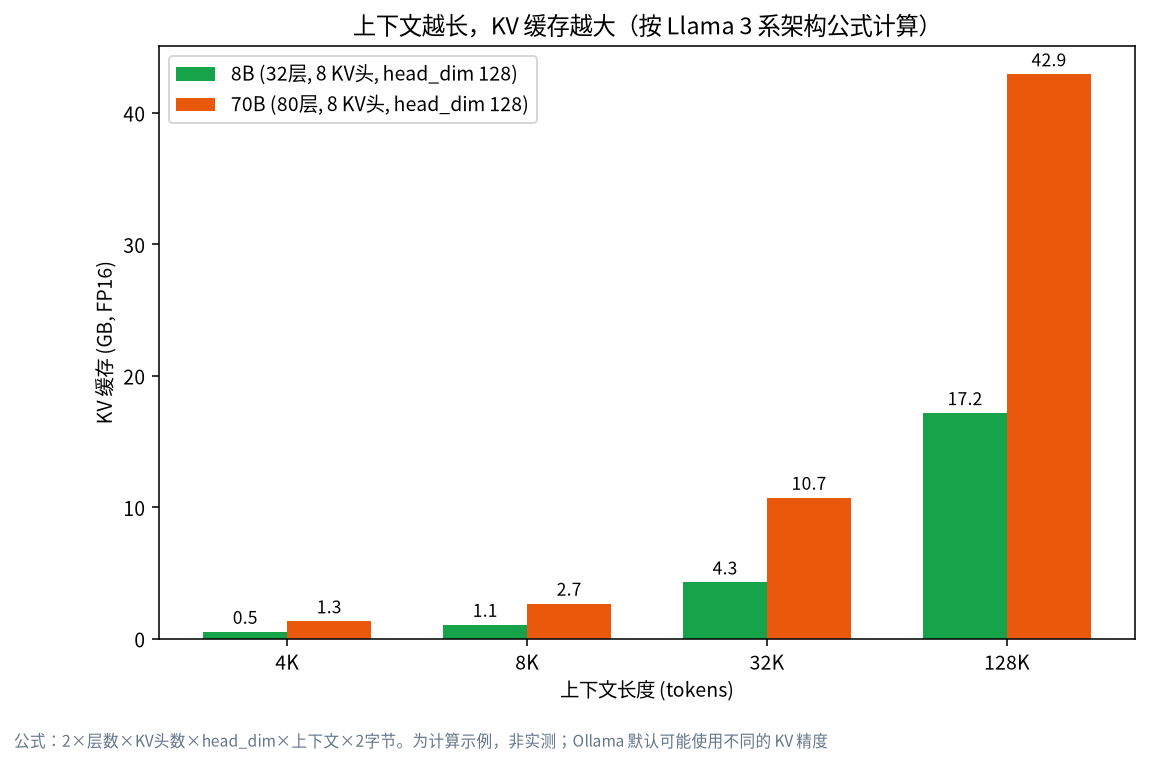
CanRun 估算,在 32k 上下文、f16 KV 缓存时:Gemma 4 31B 需要 21.8GB,Qwen3.6 27B 需要 19.0GB,Qwen3.6 35B-A3B 需要 22.6GB(余量很小)。Ollama 官方文档指出,24–48GiB 显存的默认上下文是 32k,所以 24GB 的显卡默认就可能把缓存拉得很大,这与《大模型显存需求怎么算》里讲的 KV 缓存规律一致。
如果你需要更长的上下文,有三个办法:选更小的模型(如 27B 而不是 32B);把 KV 缓存量化到 q8_0(OLLAMA_FLASH_ATTENTION=1 与 OLLAMA_KV_CACHE_TYPE=q8_0,官方说明约占 f16 一半的内存);直接缩短上下文(OLLAMA_CONTEXT_LENGTH)。
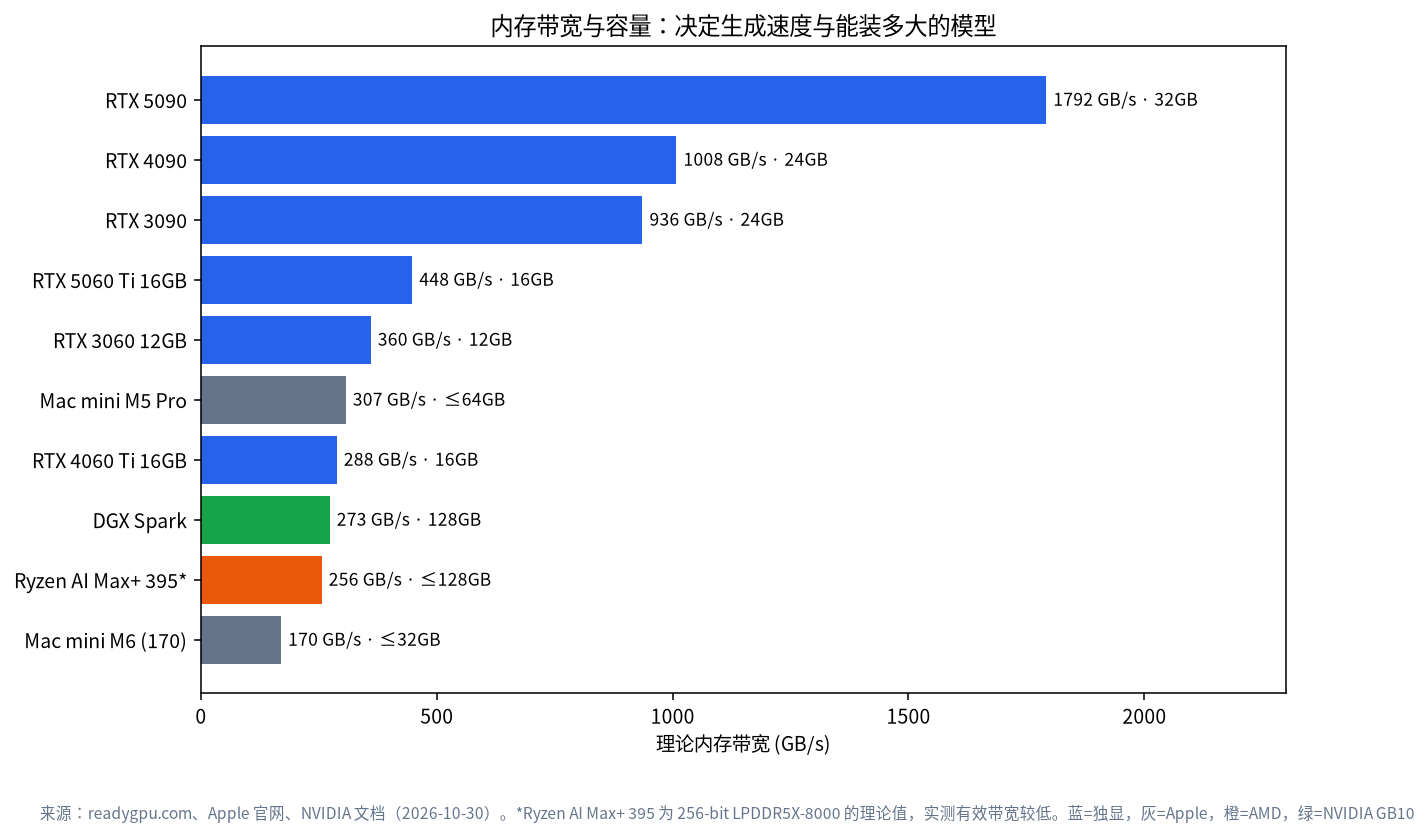
RTX 3090、RTX 4090 与同级显卡对比
| 显卡 | 显存 | 带宽 | 功耗/电源建议 | 价格快照(2026-10-30,美国标价,readygpu.com) |
|---|---|---|---|---|
| RTX 3090 | 24GB | 936GB/s | 建议电源 750W | 新品约 $1,698,二手约 $1,599 起 |
| RTX 3090 Ti | 24GB | 1008GB/s(CanRun) | — | 暂无可靠报价,请联系我们询价 |
| RTX 4090 | 24GB | 1008GB/s | 450W,建议电源 850W | 新品约 $2,073,二手约 $3,300 起 |
| Radeon RX 7900 XTX | 24GB | 960GB/s(CanRun) | — | 暂无可靠报价,请联系我们询价 |
说明:价格为带日期的美国市场标价快照,波动极大,二手价格有时高于新品标价。参考价(按 2026-10 市场中位价估算,以实际报价为准):二手 RTX 3090 约 7,550 元,RTX 4090 约 26,465 元(闲鱼、淘宝与行情报道的中位数;二手 3090 的闲鱼挂牌中位价约 9,350 元,社区实际成交多在 5,500–8,000 元)。CanRun 的估算显示:这几张 24GB 卡可用显存相同(23.4GB),能放下的模型一样;速度由带宽等因素决定。例如它对 Qwen3 32B 与 DeepSeek R1 蒸馏 32B 的速度判定是:RTX 3090 为“较好”,RTX 4090 为“很好”,原因是这两个模型有思考模式,速度门槛更严,只有更快的 4090 过线。这是第三方估算,我们没有实测。
选购的取舍很简单:只要“放得下”,3090 的容量已经够用,价格也通常更友好;追求生成速度再看 4090。AMD 的 RX 7900 XTX 容量相同,但需要先确认你用的软件对 ROCm 或 Vulkan 的支持,见《Ollama 常见报错》。整机配置与预算见《本地大模型装机配置单》,显卡全档位见《本地大模型显卡推荐》。
量化档位在 24GB 上的取舍
同一个模型有不同量化档位,24GB 的甜点是 Q4_K_M。下表的文件大小取自 Ollama 标签页(2026-10-30):
| 模型 | Q4_K_M | Q8_0 | BF16/FP16 | 24GB 卡的结论 |
|---|---|---|---|---|
qwen3.6:27b |
17GB | 30GB | 56GB | 只有 Q4_K_M 放得下 |
qwen3.8:27b |
18GB | 30GB | 56GB | 只有 Q4_K_M 放得下 |
qwen3:32b |
20GB | 35GB | 66GB | 只有 Q4_K_M,且余量很小 |
qwen3:30b-a3b |
19GB | 33GB | 61GB | 只有 Q4_K_M 放得下 |
也就是说,在 24GB 上追求“更高精度”基本无路可走:Q8_0 需要 30GB 以上,那是 32GB 显卡的领域。想了解 Q4_K_M 为什么是默认选择,见《大模型量化与 Q4_K_M》。
按使用场景选模型
| 场景 | 建议 | 理由 |
|---|---|---|
| 日常问答、写作、翻译 | 27B 稠密,4k–8k 上下文 | 余量最大,质量与稳定性兼顾 |
| 长文档总结、资料问答 | 27B 加 q8_0 KV 缓存,上下文 16k–32k |
缓存是主要开销,量化缓存能腾出空间 |
| 写代码、工具调用 | 30B 级 MoE 编程模型 | 生成快,适合反复迭代;智能体工具通常建议至少 64000 token 上下文,需用更小模型或量化缓存配合 |
| 数学与逻辑推理 | deepseek-r1:32b,短上下文 |
思考过程会占用大量上下文,别开太长 |
| 想要最快响应 | MoE 的 qwen3:30b-a3b |
每个 token 只激活约 3B 参数 |
一次完整的 24GB 上手流程
下面是在 24GB 卡上加载并核对一个 27B 模型的最短流程,具体安装步骤见《Ollama 安装教程》:
ollama pull qwen3.6:27b
ollama run qwen3.6:27b "用三句话介绍你自己"
ollama ps
nvidia-smi
第一步下载模型(约 18GB,视网速需要几分钟到几十分钟),第二步测试是否能回答,第三步查看 ollama ps 的 PROCESSOR 一列是否是 100% GPU,第四步用 nvidia-smi 看显存占用。如果显存占用接近 24GB 边缘,就把上下文降到 8k 或启用 q8_0 KV 缓存。如果 PROCESSOR 显示 CPU 占比,说明模型溢出到了内存,请换小一档的模型。
功耗、电费与机箱
24GB 级显卡通常是整机的“耗电大户”。NVIDIA 对 RTX 4090 标注 450W、建议电源 850W;3090 建议 750W。电费可以这样估算:功率(千瓦)× 每天使用小时数 × 电价。例如(纯属假设)按 0.4kW 平均负载、每天 4 小时、每度 0.6 元计算,一天约 0.96 元,一个月约 29 元。实际负载和电价因人而异,请换成你自己的数字。机箱方面,旗舰显卡体积大、需要足够的风道和供电接口,买之前量好空间。
24GB 与相邻档位:值不值得升级
| 档位 | CanRun 可用显存估算 | 能舒服运行的典型模型 | 升到 24GB 能多得到什么 |
|---|---|---|---|
| 8GB | 约 7.4GB | 8B 级 | 27B–32B 级模型、更长上下文 |
| 12GB | 约 11.4GB | 12B–14B 级 | 27B 级与 30B MoE 完整放进显卡 |
| 16GB | 以显卡为准 | 14B–20B 级 | 27B 级的宽裕余量 |
| 24GB | 约 23.4GB | 27B–32B、30B MoE | — |
| 32GB(RTX 5090) | 约 31.4GB | 同上,加上更长上下文与 Q8_0 的 27B | 更长上下文、更高精度 |
如果你现在是 8GB 或 12GB,感觉“模型总差一点”,升级到 24GB 通常是性价比最高的一步;如果你已经是 24GB,再往上就要花大价钱,更合理的做法是先把上下文、KV 缓存和模型选择调到最优。8GB 档位的玩法见《8GB 显存跑大模型》。
买之前的三个提醒
- 先确认用途:只做日常问答的话,16GB 级显卡配 14B 模型也许就够了,不必为了“以后可能用”硬上 24GB。
- 价格要现查:本文的价格是美国市场标价快照,国内渠道价格、保修和成色差别很大,购买前请当日核对。
- 整机一起算:电源、机箱、内存和散热会让总预算比显卡价格高出一截,整机清单见《本地大模型装机配置单》。
24GB 跑不了什么
- 70B 级稠密模型:
llama3.3:70bOllama 文件 43GB,CanRun 估算合计 45.2GB,24GB 卡放不下,CanRun 对 RTX 4090 的判定是“跑不动”(部分卸载太慢)。 - gpt-oss-120b:在 24GB 卡上同样被判定为跑不动。
- 同时常驻多个大模型:每个大模型都占十几 GB,24GB 只能放一个。
- 32GB 才有的余量:CanRun 提到,RTX 5090(可用约 31.4GB)可以在 32k 上下文下运行 Qwen3 32B(28.7GB),并能放下 Q8_0 的 27B 模型(约 28.4GB);这是 24GB 卡做不到的。
如果你一定要 70B,请看《本地大模型显卡推荐》里的 48GB 以上方案,或者考虑大内存的统一内存设备。
24GB 卡的使用技巧
- 优先选 27B 而不是 32B:余量宽裕得多,上下文可以开更长。
- MoE 模型做主力:
qwen3:30b-a3b的 Ollama 文件 19GB 能放进显存,速度比同体积的稠密模型快。 - 量化 KV 缓存:
q8_0是官方推荐的折中。 - 用
ollama ps核对:加载后确认100% GPU。 - 控制并发:
OLLAMA_NUM_PARALLEL默认会按并发数预留缓存,个人使用建议设为 1。 - 注意散热和电源:4090 官方建议 850W 电源,旗舰卡体积大,装机前量机箱。
常见问题(FAQ)
24GB 显存最好用的模型是哪个?
综合余量和能力,27B 级稠密模型(如 qwen3.6:27b,Ollama 默认标签 18GB)是比较稳妥的主力;想要速度可选 qwen3:30b-a3b。更多比较见《本地大模型推荐》。
24GB 能跑 70B 吗?
不能舒适地跑。70B Q4 文件 43GB,24GB 卡放不下,大部分会落到内存,速度很慢。
3090 还是 4090?
容量一样。4090 带宽更高、功耗也更高,价格差距取决于当时行情;如果你只是需要“放得下”,3090 往往足够。
24GB 能同时跑两个模型吗?
两个小模型可以,两个大模型不行。可通过 OLLAMA_MAX_LOADED_MODELS 控制同时加载的数量,但要留意显存总量。
二手 3090 安全吗?
有风险,要验货,见《本地大模型显卡推荐》里的二手验货流程。
24GB 的 Mac 和 24GB 显卡一样吗?
不一样。Mac 的统一内存 GPU 只能用约 70%,24GB 的 Mac 约 16.8GB 可用,见《Mac 跑大模型怎么选》。
下一步与社区
24GB 配置已经是很不错的个人主力档位,但具体该选 3090 还是 4090、整机怎么搭,取决于你的预算和用途。欢迎到社区发出你的需求(加入社区)。我们在深圳做本地大模型机器的选型、采购、组装与实测,也可以按你的预算给出配置建议;先聊需求,不强制购买。