本地知识库搭建(RAG):Ollama + Open WebUI / AnythingLLM 实战
把公司的制度文档、产品手册、个人的论文和笔记交给大模型,让它“照着资料回答”,是本地大模型最实用的用法之一。技术上这叫检索增强生成(RAG)。这篇文章讲本地知识库搭建:先弄清楚 RAG 的几个部件,再用 Ollama 加 Open WebUI 一步步配置,并介绍另一条路线 AnythingLLM。全程模型和向量都留在你的机器上,不需要把资料上传给在线服务。Open WebUI 的基础安装请先看《Open WebUI 搭建教程》,Ollama 的安装见《Ollama 安装教程》。
核对说明:Open WebUI 的嵌入模型设置、重新索引要求和上下文长度提示来自 Open WebUI 官方文档(docs.openwebui.com,2026-10-30 读取);AnythingLLM 的内置向量库和嵌入器来自其官方文档;Ollama 默认上下文来自 Ollama 官方文档。界面文字会随版本变化,截图和菜单名称以你的版本为准。我们没有对检索质量做评测,也不提供“准确率”数字。
要点速览(更新于 2026-10-30)
- RAG 需要两个模型:嵌入模型负责找,聊天模型负责答。
换嵌入模型后必须重新索引;Open WebUI 填 nomic-embed-text,不加 ollama/ 前缀。
显存低于 24GiB 时 Ollama 默认上下文只有 4096,做 RAG 请调到 8192 以上。
本地知识库搭建:先搞懂 RAG 的四个部件
大模型的训练数据里没有你的内部资料,直接问它只会得到泛泛的回答,甚至编造。RAG 的做法是:先把资料检索出来,再连同问题一起交给模型。一个本地 RAG 系统由四个部分组成:
| 部件 | 作用 | 常见选择 |
|---|---|---|
| 文档解析与切块 | 把 PDF、Word、网页拆成小段 | Open WebUI、AnythingLLM 内置 |
| 嵌入模型 | 把每段文字变成一串数字(向量) | nomic-embed-text、mxbai-embed-large、内置小模型 |
| 向量库 | 存向量,并按相似度检索 | AnythingLLM 内置 LanceDB,Open WebUI 内置库 |
| 生成模型 | 读检索结果后写回答 | 本地聊天模型,如 Qwen、Gemma、gpt-oss |
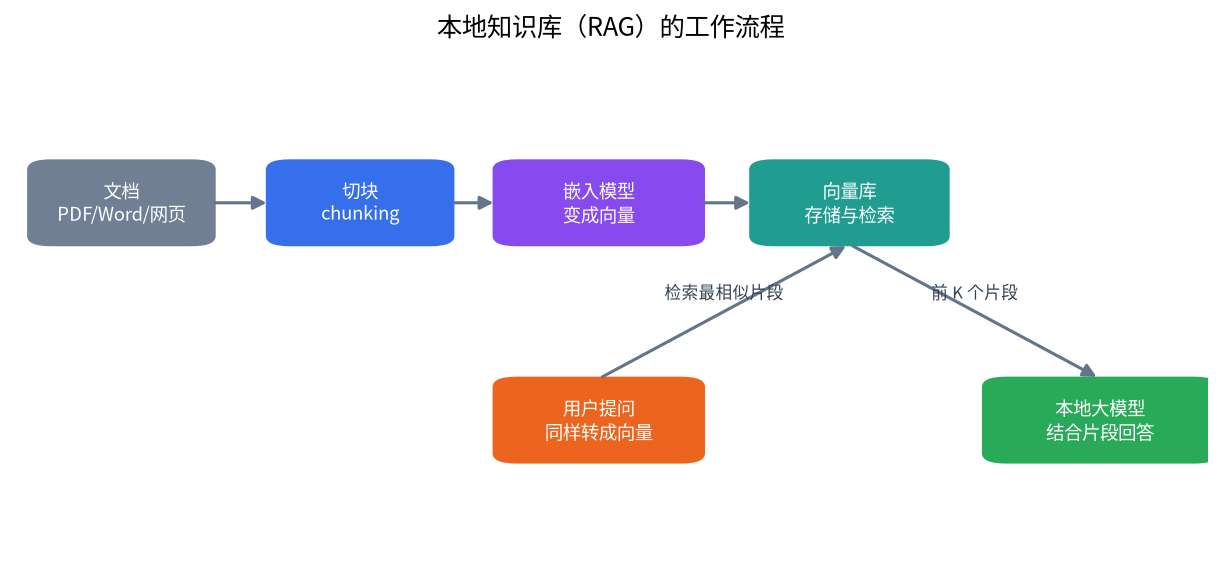
关键要理解两点。第一,嵌入模型和生成模型是两个不同的模型:前者负责“找”,后者负责“说”,所以你要同时准备两个模型。第二,向量只和生成它的嵌入模型匹配,换了嵌入模型就必须重新索引,否则检索结果会变得没有意义。
方案一:Ollama + Open WebUI
这是最常见的组合,适合已经在用 Ollama 的人。
第 1 步:拉取嵌入模型和聊天模型
ollama pull nomic-embed-text
ollama pull qwen3:8b      # 聊天模型,按你的显存换成合适的
选聊天模型时,参考《本地大模型怎么选》里按显存分档的建议。嵌入模型很小,社区教程里提到 nomic-embed-text 约 274MB,对显存几乎没有压力。
第 2 步:在 Open WebUI 里设置嵌入模型
按 Open WebUI 官方文档和社区教程,进入“管理员面板 → 设置 → 文档”:
- 把“嵌入模型引擎”设为 Ollama。
- 嵌入模型一栏填
nomic-embed-text,不要加ollama/前缀,否则会报找不到模型。 - 如果 Open WebUI 跑在 Docker 里,Ollama 地址通常要写成
http://host.docker.internal:11434,具体见《Open WebUI 搭建教程》里的连接排查。 - 保存。
官方的嵌入模型建议表里,个人入门可以用默认的 all-MiniLM-L6-v2(本地运行、无需额外设置);多用户并且有 Ollama 时,可以用 Ollama 里的 nomic-embed-text,把嵌入计算交给 Ollama,减轻 Open WebUI 的内存压力;完全离线的环境可以选 nomic-embed-text 或 mxbai-embed-large,这样不需要任何外部接口。
第 3 步:创建知识库并上传文档
- 进入“工作空间 → 知识库”,点“创建”,写名称和简介,选择访问权限。
- 点“+”上传文件,或者添加文本内容。
- 回到新对话,点“+”选“附加知识库”,或者在输入框输入
#选择知识库。 - 问一个只有你的资料里才有的问题,看回答是否引用了片段。
第 4 步:改大上下文长度,这是最容易漏的一步
Open WebUI 官方文档专门提醒:Ollama 会按显存给模型选默认上下文,显存低于 24GiB 时默认只有 4096 tokens,这会严重限制 RAG 的效果,因为检索到的内容可能根本放不进去,或者只有一部分被读到。官方建议在“管理员面板 → 模型”里编辑你的 Ollama 模型,在高级参数里把上下文长度调到 8192 以上,最好超过 16000。
可以用一个简单的算式感受一下:假设每个检索片段 600 tokens,取前 8 个片段就要 4800 tokens,已经超过 4096,还没算问题、系统提示词和回答。
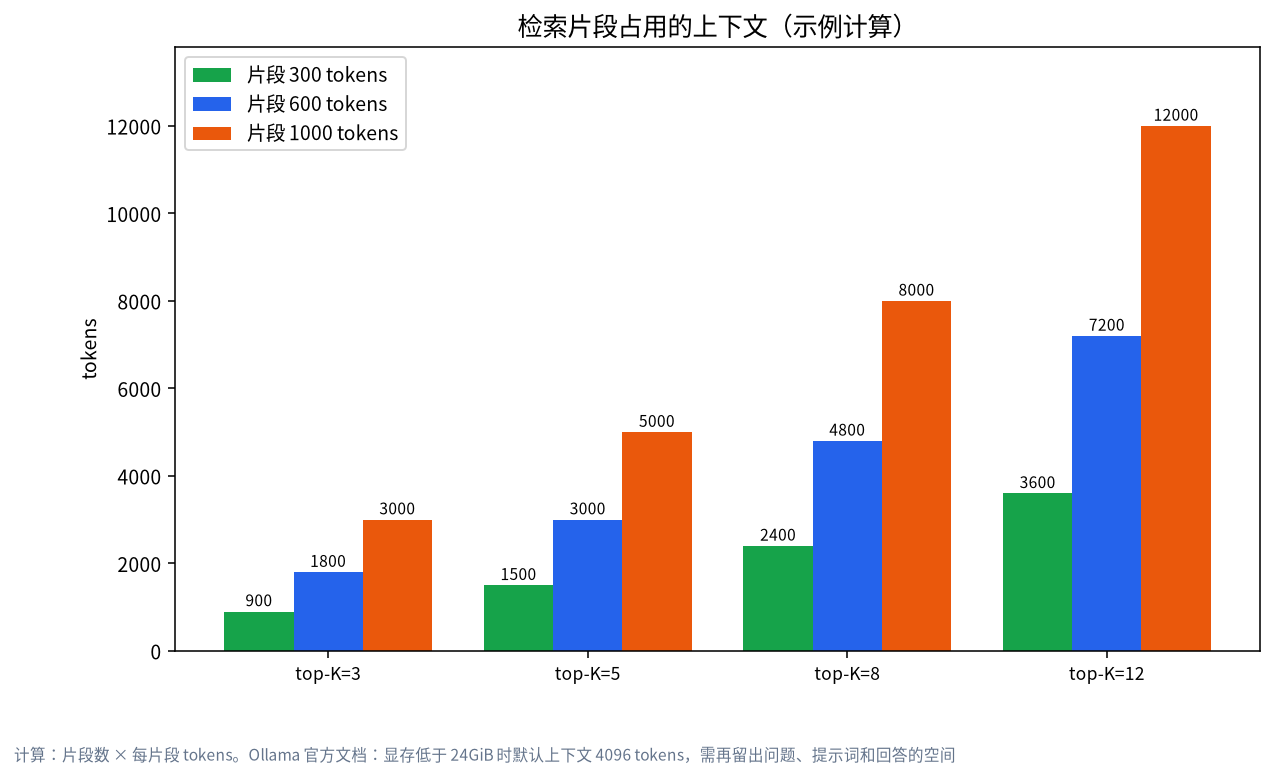
上下文越大,KV 缓存占用的显存越多。关于这笔账怎么算,请看《大模型显存需求怎么算》。如果你的显卡是 24GB,可以参考《24GB 显存跑大模型》里的余量建议。
方案二:AnythingLLM
如果你不想折腾 Docker,AnythingLLM 的桌面版是更省事的选择。按其官方文档:
- 它自带私有的向量数据库,基于 LanceDB,使用默认选项时向量不会离开 AnythingLLM。
- 嵌入模型有内置的默认选项,也可以改为 Ollama、LM Studio 等本地来源,或者 OpenAI 等云端来源。
- 向量库除了内置的 LanceDB,还支持 PGVector、Chroma、Milvus 等本地选项,以及 Pinecone 等云端选项。
用法上,它以“工作区”为单位组织文档:新建工作区、上传文档、把文档“嵌入”到工作区,然后在工作区聊天里提问。语言模型一栏可以选择 Ollama 或 LM Studio。想完全离线,就保持内置向量库和本地嵌入器,并把语言模型指向本机的 Ollama。
| 对比项 | Open WebUI | AnythingLLM |
|---|---|---|
| 安装方式 | 常用 Docker 部署 | 桌面应用或 Docker |
| 多用户与权限 | 支持,适合团队 | 桌面版偏个人,Docker 版支持多用户 |
| 组织方式 | 知识库,聊天中附加 | 工作区,文档绑定到工作区 |
| 嵌入模型 | 默认本地小模型,可换 Ollama | 内置默认,可换 Ollama 等 |
| 适合谁 | 已经在用 Open WebUI 的人 | 想要开箱即用的个人用户 |
切块与检索:影响效果最大的几个参数
很多人以为换个更大的模型就能提升效果,其实对 RAG 来说,检索质量影响更大:
- 片段大小与重叠:太小会丢上下文,太大会让每次检索占掉过多 tokens。社区教程里有人把块大小调到 3000、重叠调到 100 来适配长文档,但没有放之四海而皆准的数字,需要在你的文档上试。
- 返回片段数(top-K):Open WebUI 社区教程提到默认取最相关的前几个片段,可以按需增大,但要与上下文长度匹配。
- 文档质量:扫描版 PDF 需要 OCR;表格和公式经常被解析得很乱。建议先把重要文档转成干净的文本或 Markdown。
- 提示词模板:让模型“只根据提供的资料回答,资料里没有就说不知道”,能明显减少编造。
- 更换嵌入模型后重新索引:官方文档反复强调这一点。
隐私:哪些数据留在本机
用本地模型、本地嵌入和本地向量库,你的文档、向量和提问都在本机处理。但要检查两处:一是 Open WebUI 或 AnythingLLM 里是否启用了联网搜索、云端嵌入或云端模型;二是你有没有把嵌入模型设成 OpenAI 等云端接口。只要保持本地选项,就不需要把资料发给外部服务。更详细的数据流向分析,我们会在隐私专题里说明。
报错与排查速查表
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 上传文件失败,提示 embed 404 | 嵌入模型名带了 ollama/ 前缀,或模型没拉取 |
填 nomic-embed-text,并先 ollama pull |
| 回答里没有引用资料 | 知识库没附加到对话,或上下文太小 | 用 # 附加知识库,调大上下文 |
| 换了嵌入模型后答非所问 | 旧向量与新模型不兼容 | 在设置里重新索引全部文档 |
| 检索到的内容不相关 | 切块不合适,或文档解析混乱 | 调整块大小,先清洗文档 |
| 回答很慢 | 上下文很大,或模型放不进显存 | 换小一档的模型,见 Ollama GPU 排查文章 |
模型跑到 CPU 上导致变慢,是常见情况,可以参考《Ollama 不使用 GPU 怎么办》。
常见问题
本地知识库需要多大的显卡?
嵌入模型很小,主要压力来自聊天模型和上下文。8GB 显存可以用 8B 左右的模型做小规模问答,但上下文要克制;资料多、片段长时,更大的显存会舒服很多。具体档位见《本地大模型怎么选》。
RAG 和微调有什么区别?
RAG 在回答时检索资料并交给模型,资料更新后重新索引即可;微调是改变模型参数,成本和门槛更高。要让模型“查资料回答”,RAG 通常是首选。
换了嵌入模型必须重新索引吗?
必须。不同嵌入模型生成的向量不兼容,官方文档明确提醒,更换后要在设置里重新索引全部文档。
文档放在本地知识库里,会被上传到云端吗?
只要嵌入、向量库和语言模型都选本地选项,处理都在本机完成。使用前请检查是否启用了联网搜索或云端接口。
Open WebUI 和 AnythingLLM 选哪个?
团队共享、需要权限管理,选 Open WebUI;个人想要开箱即用,选 AnythingLLM 桌面版。两者都能连 Ollama,可以各试一下。
回答还是会编造怎么办?
RAG 能减少编造,但不能杜绝。可以在提示词里要求“只依据资料回答”,并检查引用的片段。重要内容请人工复核。
需要落地帮助
如果你想把知识库用在团队里,或者不确定自己的资料量该配多大的显卡,欢迎加入社区讨论,或发邮件到 admin@microaione.com,说明资料类型和使用人数。入门路线见《本地部署大模型入门》。
参考与延伸阅读:Open WebUI:RAG 文档、AnythingLLM 官方文档:向量数据库、Ollama:上下文长度。