如何在本地训练部署私有化AI大模型:企业要做哪几步、花多少钱(含训练算力算例)
“我们想在自己公司内部训练一个大模型,数据不能出去。”这是我们收到最多的咨询之一,而答案往往让人意外:如何在本地训练部署私有化AI大模型,绝大多数企业真正需要的不是“从零训练”,而是“选一个开放权重模型,接上自己的知识库,必要时做一次轻量微调,再安全地部署在内网”。这篇文章把“训练”拆成四级,用公式算清每一级需要多少显存、多少算力,再给出部署步骤、预算分层和一份避坑清单,帮你在花钱之前先判断自己该站在哪一级。
核对说明:显存与算力数字都是按公开公式和论文结论推算的理论值,不是我们的实测;硬件参考价来自我们 2026-10-30 整理的中位价表(以实际报价为准);GPU 租用价来自 RunPod 价格页(更新于 2026-10-28);流程部分参考中国信通院的一体机报告。训练算例里的有效算力和 token 数量是假设值,已逐项标注。我们没有为企业做过训练项目,也没有可公开的客户案例。
要点速览(更新于 2026-11-04)
- 企业定制分四级:提示词与规则 → 检索增强(RAG)→ 微调(LoRA/QLoRA)→ 从零预训练。先从最低一级验证,再决定是否升级。
同一个 7B 模型:Q4 推理约 4.3GB;全参数训练按“每参数 16 字节”估算约 112GB,还没算激活;QLoRA 论文称 65B 模型可以在单张 48GB 显卡上微调。
从零预训练 7B 模型,按“6×参数×token、每参数 20 token”的常用近似和 160 TFLOPS 有效算力的假设,约需 1 万 GPU 小时;按 RunPod H100 PCIe 社区价 1.99 美元/小时只算租金就约 2 万美元,这还不含数据、失败重跑和人力。
- 部署侧的关键不是模型,而是权限、审计和评测:见我们的企业私有化部署指南。
如何在本地训练部署私有化AI大模型:先分清四级
很多讨论把“训练”当成一件事,其实它是四种投入完全不同的做法:
| 级别 | 做什么 | 数据需求 | 算力需求 | 适合的问题 |
|---|---|---|---|---|
| 1. 提示词与规则 | 写系统提示词、输出格式、禁用词 | 几十条示例 | 只需推理 | 统一口径、固定格式 |
| 2. 检索增强(RAG) | 把文档切块、向量化,提问时检索后交给模型 | 你的文档,几百到几十万页 | 推理 + 向量化 | 知识库问答、制度查询(参见本地知识库搭建) |
| 3. 微调(LoRA/QLoRA) | 用几千到几万条高质量问答调整模型行为 | 精心整理的指令数据 | 单卡到几卡 | 固定风格、行业话术、结构化输出 |
| 4. 从零预训练 | 从随机初始化开始训练基础模型 | 万亿级 token | 成百上千卡 | 基础模型厂商的事 |
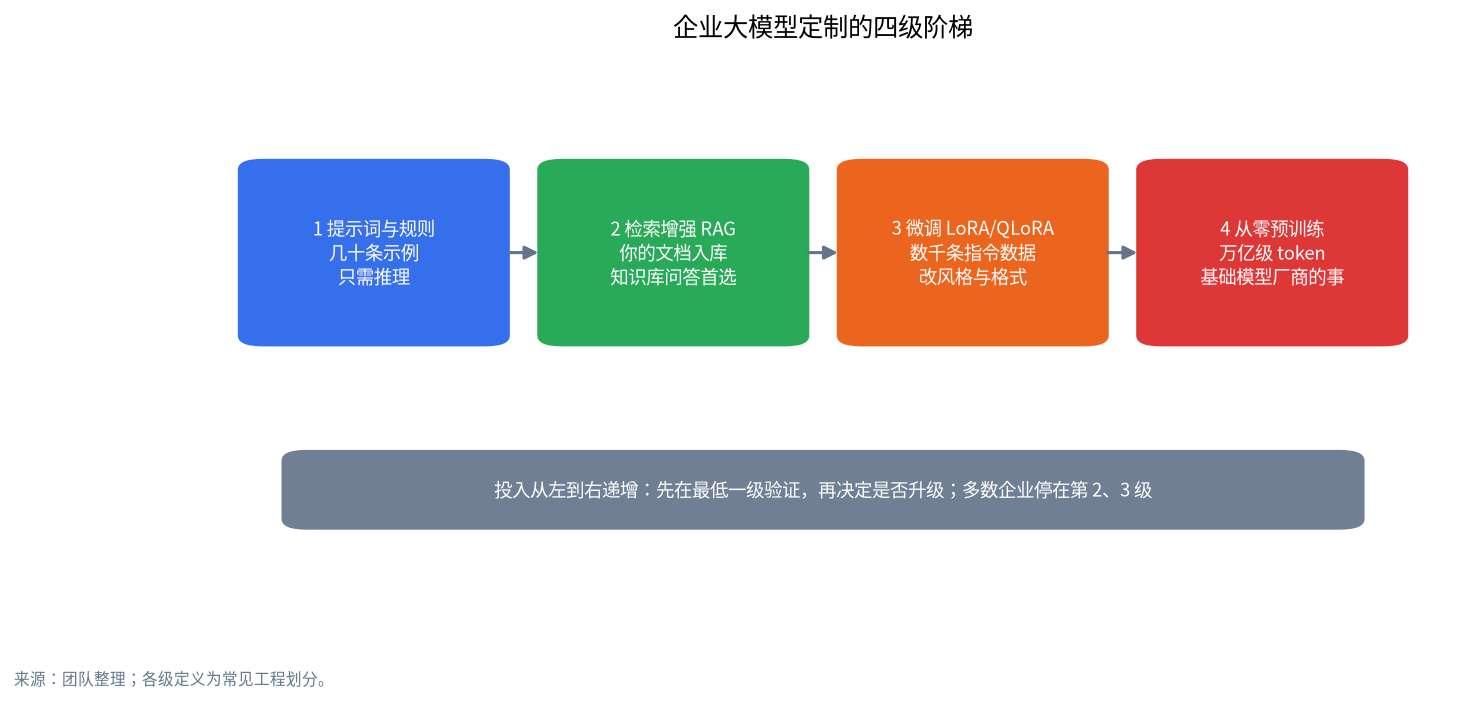
经验上,企业的“私有知识”问题绝大多数用第 2 级就能解决:知识更新时只需要重新入库,不需要重新训练;而微调更适合改变“怎么说话”,而不是“记住新事实”。QLoRA 论文的一个观察也值得记住:数据质量比数据量重要得多,论文里 9000 条的 OASST1 子集在聊天表现上超过了 45 万条的 FLAN v2 子集。
显存算账:推理、微调和全参数训练差多少
先看三种用法对显存的基本要求。推理时权重是主体:Q4_K_M 约每十亿参数 0.6GB,FP16 为 2GB。全参数训练用 Adam 优化器做混合精度训练时,ZeRO 论文给出的模型状态开销是每个参数 16 字节(参数 2、梯度 2、优化器状态 12),还没算激活值。
| 模型规模 | Q4 推理(约 0.61GB/十亿参数) | FP16 推理 | 全参数训练(16 字节/参数,不含激活) |
|---|---|---|---|
| 7B | 约 4.3GB | 14GB | 约 112GB |
| 14B | 约 8.5GB | 28GB | 约 224GB |
| 32B | 约 19.5GB | 64GB | 约 512GB |
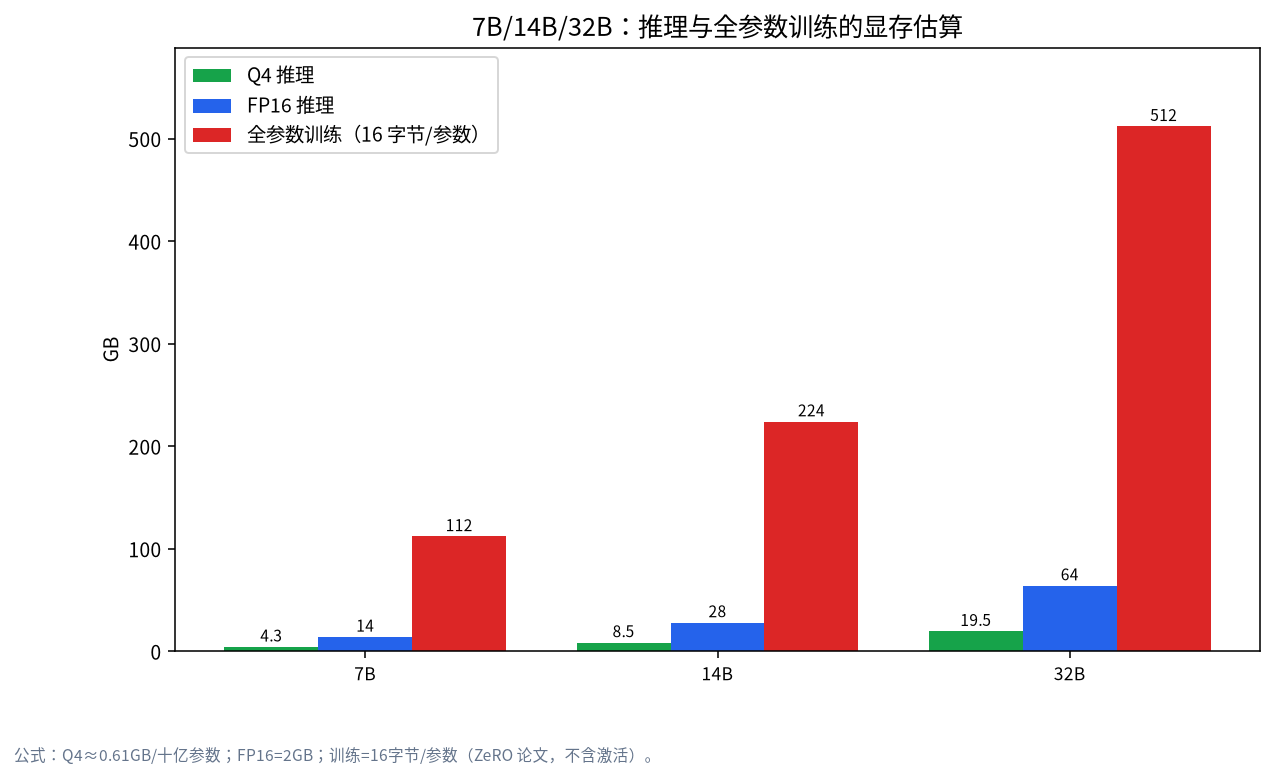
这就是为什么单台工作站做全参数训练几乎不现实,而 QLoRA 能改变局面:QLoRA 论文称,它把 65B 模型微调的显存需求从常规 16 位微调的超过 780GB 降到 48GB 以内,可以在单张 48GB 显卡上完成。小模型(7B 到 14B)的 QLoRA 微调在 24GB 显卡上是可行的方向,具体数字和步骤见《本地 LoRA 微调要多少显存》和《AI 大模型训练电脑配置》。注意论文结论是在学术基准上得出的,你的业务数据上效果要自己评测。
从零训练要多少算力:一个量级算例
如果有人跟你说“我们帮你从零训练一个专属大模型”,可以用两个常用近似估算成本:
- 训练计算量 ≈ 6 × 参数量 × 训练 token 数(常用近似)。
- 数据量经验值约为每个参数 20 个 token(源自 Chinchilla 研究的常被引用的结论,这里作为量级假设)。
假设每张 GPU 的有效算力为 160 TFLOPS(假设值,约为理想峰值的一部分),租金取 RunPod 价格页(更新于 2026-10-28)H100 PCIe 社区云 1.99 美元/小时:
| 模型规模 | 训练 token(假设) | 计算量(FLOPs) | GPU 小时 | 仅租金(美元) |
|---|---|---|---|---|
| 1B | 200 亿 | 约 1.2×10²⁰ | 约 208 | 约 415 |
| 7B | 1400 亿 | 约 5.9×10²¹ | 约 10208 | 约 20315 |
| 70B | 1.4 万亿 | 约 5.9×10²³ | 约 1020833 | 约 203 万 |
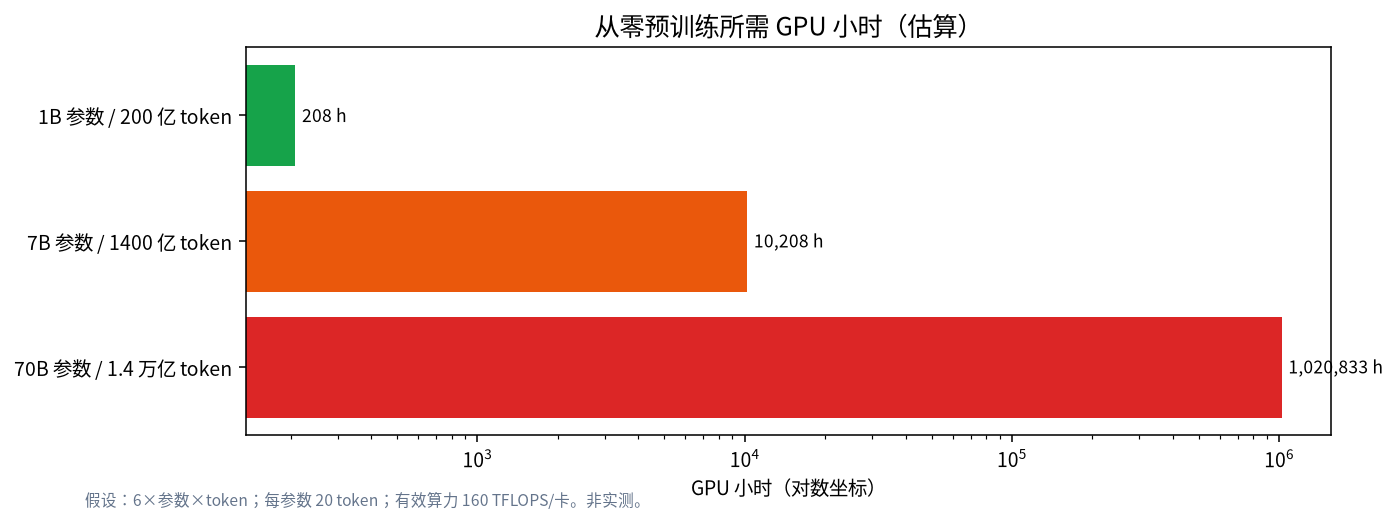
这张表的意义不是报价,而是量级:从 1B 到 70B,成本相差几千倍。而且它只算了一次理想的训练,没有算数据清洗、实验失败重跑、评测、存储和人力。同样规模的开放权重模型已经有大量免费可用的版本,所以除非你有独特的数据优势和长期预算,否则“从零预训练”很少是企业的正确选择。
企业私有化落地六步
- 定义问题与成功标准:写下三个具体业务问题和验收标准(例如“合同条款问答的正确率达到多少由业务方抽检”),不要写“用上大模型”。
- 选基础模型与规格:在开放权重模型里按许可证、语言能力和体量选,规格从模型大小选择器和显存计算倒推。
- 先做 RAG 试点:一台工作站、一个部门、4 到 6 周。指标看回答是否有出处、是否越权。
- 评估是否需要微调:只有当 RAG 解决不了“风格、格式、行业话术”时才做;准备高质量指令数据,先用 QLoRA 在小模型上试。
- 安全与合规评审:权限过滤、日志审计、提示注入防护(见企业内容安全清单与提示注入与越狱);合规问题由企业法务判断。
- 规模化与运维:并发与扩容、版本管理、备份和评测回归。中国信通院的选型流程也强调要预留峰值并发和扩容余量,并用自己的数据做 PoC,见一体机选型六步。
预算分层:每一级大概是什么量级
| 层级 | 典型配置思路 | 参考价格量级(以实际报价为准) | 谁来维护 |
|---|---|---|---|
| RAG 试点 | 128GB 统一内存小主机或 24GB 到 32GB 显存工作站 | 硬件约 2.5 万到 6.6 万元(我们整理的参考价:AI Max+ 395 迷你主机约 24566 元,RTX 5090 工作站约 65737 元) | 兼职运维即可 |
| 微调实验 | 单张 24GB 到 48GB 显卡,或按小时租 GPU | 租用示例:RTX 4090 社区云约 0.34 美元/小时(RunPod,2026-10-28) | 需要懂训练的人员 |
| 部门级服务 | 多卡服务器 + 网关与权限 | 按方案报价,不能一概而论 | 需要专职或外包运维 |
| 从零预训练 | 数百到数千张加速卡集群 | 见上表,百万美元量级起 | 专业训练团队 |
租还是买的细算见《租 GPU 还是自己买》。
常见误区与隐性成本
- 把“训练”当成“让模型记住我们的文档”:记住事实靠检索,不靠微调。微调容易让模型“学会说法却编造事实”。
- 忽视数据整理:高质量指令数据的整理往往比跑训练更耗时,QLoRA 论文也强调数据质量胜过数量。
- 没有评测集就开始训练:没有业务方打分的样本,就无法判断变好还是变坏。
- 忽视许可证:开放权重不等于随便商用,要读模型卡上的许可证条款,涉及合规请法务确认。
- 只算训练不算部署:权限、日志、并发、监控和更新是长期成本。
- 忘记迭代成本:每次基础模型换代,微调可能要重做,RAG 则通常只需要换模型。
我们怎么核对,没做什么
QLoRA 的显存结论来自论文摘要与正文;每参数 16 字节来自 ZeRO 论文对混合精度 Adam 的分析;训练计算量与每参数 token 数是常用的近似,作为量级假设使用;GPU 租金来自 RunPod 价格页;硬件参考价来自我们 2026-10-30 的整理。训练 GPU 小时是公式推算,不是我们的训练记录,有效算力 160 TFLOPS 是假设值。我们没有做过企业训练项目,不提供客户案例。
常见问题
企业私有化部署大模型一定要自己训练吗?
不需要。多数场景用开放权重模型加检索增强就能解决,只有在风格或格式需要定制时才考虑微调。
本地微调大模型需要多少显存?
按 16 字节/参数估算,7B 全参数训练约 112GB;QLoRA 把基础模型量化到 4 位,论文称 65B 可在 48GB 显卡上微调。具体以你的序列长度和批大小为准。
从零训练一个 7B 模型要花多少钱?
按本文的假设,约 1 万 GPU 小时,仅租金约 2 万美元量级,不含数据和人力。这是量级估算,不是报价。
微调和 RAG 哪个更适合企业知识库?
知识库问答首选 RAG,因为更新方便且可给出处;微调适合改变回答风格与格式。
私有化部署需要什么安全措施?
至少要做权限过滤、日志审计、限流和提示注入防护,并让企业法务判断合规要求。
数据不出内网,能用云 GPU 训练吗?
把数据放到云上就不再满足“不出内网”。如果合规要求严格,应在自有或专属环境中训练,具体请合规团队判断。
想判断你该站在哪一级?
欢迎到社区交流,或发邮件到 admin@microaione.com,说明业务问题、数据量、敏感程度和预算。我们的深圳团队可以帮你判断是否需要微调、怎样配置试点硬件,先试点再扩大,不做没有核实的性能承诺。
参考资料:QLoRA:Efficient Finetuning of Quantized LLMs(arXiv)、ZeRO:Memory Optimizations Toward Training Trillion Parameter Models(arXiv)、Chinchilla:Training Compute-Optimal LLMs(arXiv)、RunPod 价格页、中国信通院:大模型一体机应用研究报告(2025 年)。