AI 大模型训练电脑配置:从 QLoRA 微调到预训练,每一档需要什么显卡、内存和硬盘
搜索 AI 大模型训练电脑配置,你会同时看到“8GB 显卡就能训练”和“要几百张 GPU”两种说法,两者都对,因为“训练”其实是三件量级完全不同的事:预训练(从零训练)、全量微调(更新所有权重)和 LoRA / QLoRA 微调(只训练小适配器)。这篇文章把三者各自需要的显存和算力算清楚,给出五档整机的参考价和能做什么,再讲内存、硬盘、电源和散热怎么配,最后用一个具体例子算出一次微调要几个小时。结论先说:个人电脑适合 QLoRA 和 LoRA 微调,不适合预训练;全量微调只在 1B 到 3B 的小模型上才现实。微调的显存细节另见 本地微调显存需求,整机方案见 本地大模型电脑配置清单。
要点速览(更新于 2026-11-04)
- 全量微调按混合精度 Adam 估算约每参数 16 字节:1B 约 16GB,7B 约 112GB,还没算激活值;个人电脑基本做不了 7B 以上。
QLoRA 是个人训练的主力:按 Unsloth 文档的下限,7B 约 5GB、14B 约 8.5GB、32B 约 26GB、70B 约 41GB;16 位 LoRA 则是 19GB、33GB、76GB、164GB。
预训练按 6ND 估算:1B 模型喂 200 亿 token,在假设持续 100 TFLOPS 的单卡上约 14 天,7B 模型约 681 天,个人不现实。
训练配置的优先级是:显存 > 内存与硬盘容量 > 显卡算力 > CPU;先买能放下模型的显存,再谈速度。
价格为 2026-10-30 的参考价,近期显卡价格波动大,下单前请重新核对。
AI 大模型训练电脑配置:先分清三种“训练”
| 类型 | 做什么 | 显存数量级 | 算力数量级 | 个人电脑可行吗 |
|---|---|---|---|---|
| 预训练 | 从随机权重开始,用海量文本训练 | 数十 GB 到数 TB(含优化器) | 极高(1B 模型约 10^20 次浮点运算) | 仅限几百万到十亿参数的玩具模型 |
| 全量微调 | 在已有模型上更新全部权重 | 约每参数 16 字节 | 与 token 数成正比,较高 | 1B 到 3B 可行,7B 起需要多卡或租用 |
| LoRA | 冻结原权重,只训练低秩适配器 | 模型 16 位权重加少量训练状态 | 中 | 3B 到 14B 在 24GB 以内可行 |
| QLoRA | 基座以 4 位加载,再训练 LoRA | 约为 16 位 LoRA 的四分之一到一半 | 中,略有反量化开销 | 最适合个人,8GB 起步 |
其中 LoRA 论文提出冻结原权重加低秩适配器,QLoRA 论文进一步把基座量化到 4 位。如果你只是想让模型学会某种格式或语气,先试写好提示词和检索(见 本地知识库 RAG),多数情况不需要训练。
全量微调的显存怎么算
混合精度训练使用 Adam 优化器时,每个参数需要的内存大致是:16 位权重 2 字节,16 位梯度 2 字节,32 位主权重 4 字节,Adam 的一阶和二阶动量各 4 字节,合计约 16 字节(这是 ZeRO 论文中的经典统计)。所以:
| 模型 | 每参数 16 字节 | 能放进的显存 |
|---|---|---|
| 1B | 16GB | 单张 16GB 显卡勉强,激活值要靠检查点省 |
| 3B | 48GB | 需要 48GB 级专业卡或多卡 |
| 7B | 112GB | 多卡或 128GB 统一内存 |
| 14B | 224GB | 多卡服务器 |
| 32B | 512GB | 多机 |
| 70B | 1,120GB | 数据中心 |
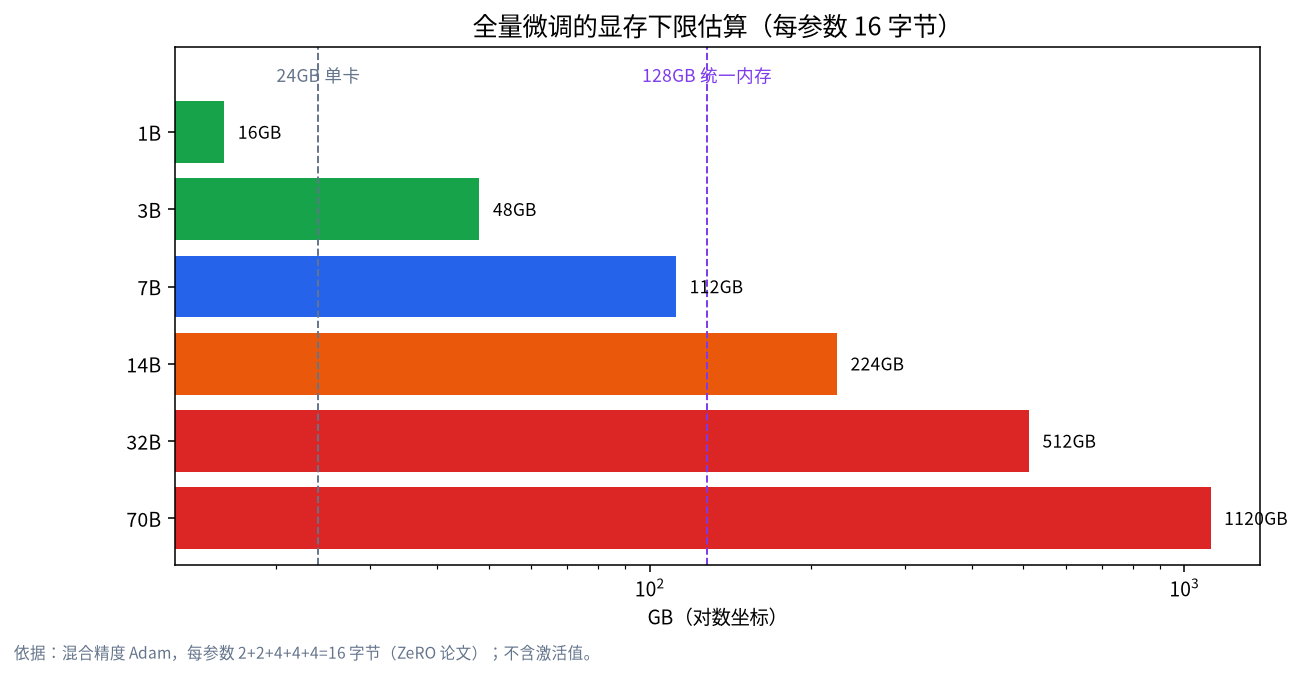
这个数字还不含激活值:批大小和序列越长,激活占用越大,可以用梯度检查点用算力换显存。另外每个检查点文件也大:7B 模型保存含优化器状态的检查点约 112GB,保留 5 份就要 560GB 硬盘,而 LoRA 适配器通常只有几十到几百 MB。这就是为什么个人用户几乎都选 LoRA 或 QLoRA。
QLoRA 与 LoRA 的显存下限
Unsloth 文档给出的最低显存是目前最清晰的公开参考(官方说明这些是下限,部分模型需要更多):
| 参数量 | QLoRA(4 位)下限 | LoRA(16 位)下限 |
|---|---|---|
| 3B | 3.5GB | 8GB |
| 7B | 5GB | 19GB |
| 8B | 6GB | 22GB |
| 14B | 8.5GB | 33GB |
| 27B | 22GB | 64GB |
| 32B | 26GB | 76GB |
| 70B | 41GB | 164GB |
它们是下限而不是预算:批大小、样本长度都会推高占用,建议留 20% 到 30% 余量(这是我们的经验规则,请按实际任务调整)。数据来源与更多细节见 Unsloth 要求页和我们的 微调显存文章。
五档整机:能训练什么
下面五档来自我们 2026-10-30 的整机参考方案,价格不含显示器、外设、系统授权、运费与组装测试服务费,只是参考,实际以报价为准。能训练的范围根据上表的显存下限判断,没有逐一实测。
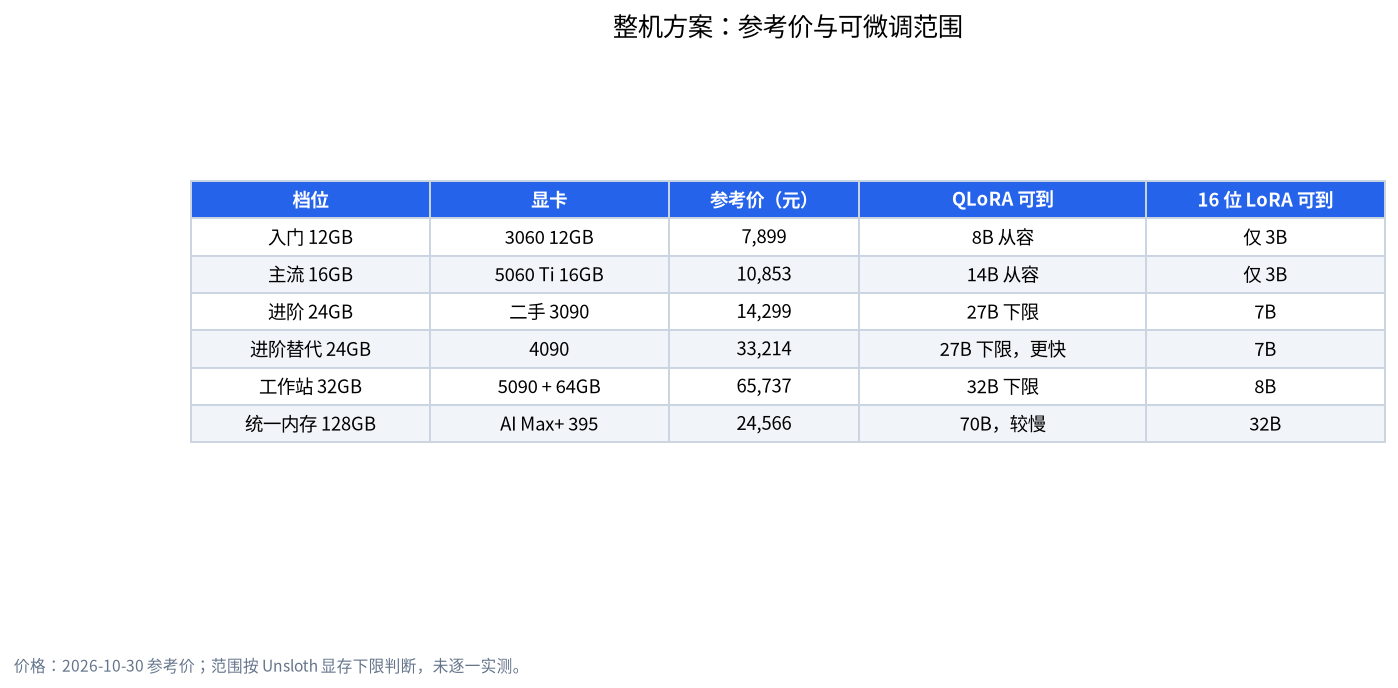
| 档位 | 核心配置 | 参考价 | QLoRA 可到 | 16 位 LoRA 可到 |
|---|---|---|---|---|
| 入门 12GB | RTX 3060 12GB + 32GB 内存 | 约 7,899 元 | 8B 从容,14B 可行但要克制序列长度 | 仅 3B(7B 需要 19GB) |
| 主流 16GB | RTX 5060 Ti 16GB + 32GB 内存 | 约 10,853 元 | 14B 较从容 | 仅 3B(7B 需要 19GB) |
| 进阶 24GB | 二手 RTX 3090 + 32GB 内存 | 约 14,299 元 | 27B 在下限边缘,14B 从容 | 7B 可行,8B 在下限边缘 |
| 进阶替代 24GB | RTX 4090 + 32GB 内存 | 约 33,214 元 | 同上,速度更快 | 同上 |
| 工作站 32GB | RTX 5090 + 64GB DDR5 | 约 65,737 元 | 32B 在下限边缘 | 8B 可行,14B 放不下(需 33GB) |
| 统一内存 128GB | Ryzen AI Max+ 395 迷你主机 | 约 24,566 元 | 70B(41GB)可行,速度较慢 | 32B(76GB)可行,70B 放不下 |
几点解读。第一,同样的钱,显存容量比算力更值钱:二手 3090 的 24GB 与 4090 相同,参考价不到三分之一,训练时容量决定“能不能做”,速度只决定“多久做完”(二手风险见 二手显卡选购,三者对比见 5090、4090 与 3090)。第二,大容量统一内存机器能放下更大的模型,但内存带宽较低,训练会慢,适合偶尔训练而不是高频迭代(见 大内存迷你主机)。第三,想要 48GB 以上单卡的专业路线见 RTX PRO 6000 工作站。第四,双卡能叠加显存,但消费级卡的通信走 PCIe,训练效率有损耗,且 4090 没有 NVLink;方案见 双显卡方案。
算力:一次微调要几个小时
显存决定能不能放下,算力决定要多久。训练的总计算量常用 6ND 估算(N 是参数量,D 是训练 token 数,这个近似来自规模定律研究);LoRA 不需要为全部权重算梯度,实际计算量更低,所以 6ND 可以当作上限。
算例:用 8B 模型,5,000 条样本、每条平均 1,000 个 token,训练 3 个轮次:
- 训练 token 数 D = 5,000 × 1,000 × 3 = 1,500 万
- 计算量 ≈ 6 × 8×10^9 × 1.5×10^7 = 7.2×10^17 次浮点运算
- 假设有效算力 30 TFLOPS(这是我们对消费级显卡持续训练的保守假设,实际取决于卡、批大小和框架):7.2×10^17 ÷ 3×10^13 = 24,000 秒,约 6.7 小时
也就是说,一个晚上到一天内可以完成一个 8B 的 QLoRA 微调;数据量增大十倍,时间也近似增大十倍。QLoRA 的反量化会带来额外开销,所以请以实测为准。
预训练为什么不适合个人电脑
预训练需要的 token 数按“约每参数 20 个 token”的经验规律估算(来自 Chinchilla 论文的结论,这只是计算最优的一个参考)。用 6ND 和假设的持续 100 TFLOPS(这对单张旗舰消费卡已经偏乐观)计算:
| 模型 | token 数(20 倍参数) | 计算量 | 耗时(单卡,100 TFLOPS) |
|---|---|---|---|
| 1B | 200 亿 | 1.2×10^20 | 约 13.9 天 |
| 3B | 600 亿 | 1.08×10^21 | 约 125 天 |
| 7B | 1,400 亿 | 5.88×10^21 | 约 681 天 |
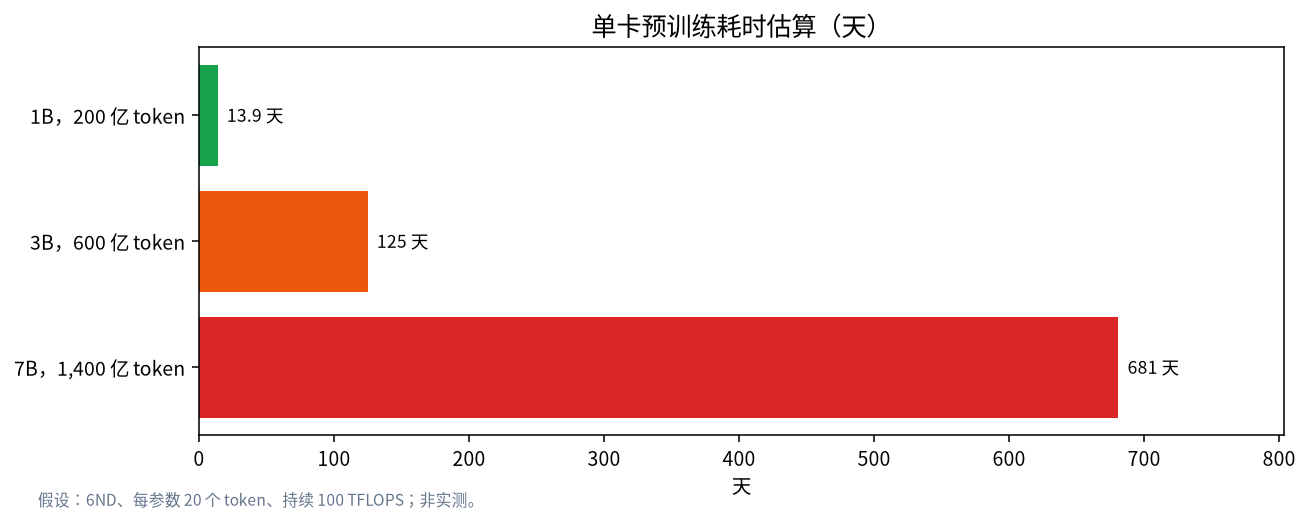
而且这还没算显存:预训练 7B 需要至少 112GB 的训练状态,加激活值,单卡根本放不下,必须多卡并行,通信带宽成为瓶颈。因此,个人和小团队想要“自己的模型”,现实路径是挑一个好基座,用 QLoRA 做领域微调,而不是从头训练。
内存、硬盘、电源与散热怎么配
- 内存: 建议至少与显存相当,起步 32GB,加载大模型和做数据处理时 64GB 更稳(我们的经验规则);内存不足会让训练卡在加载阶段。
- 硬盘: NVMe SSD 1TB 起步,2TB 更从容。算一笔账:保存几个基座模型(8B 的 16 位权重约 16GB,32B 约 64GB)、数据集和多个检查点,很快就会占几百 GB;如果做全量微调,单个检查点含优化器状态就是每参数 16 字节。
- CPU: 不是瓶颈,主要负责数据加载和分词;一颗中端的 6 到 8 核即可,不必在 CPU 上多花钱。
- 电源: 训练是长时间满载,不像聊天是间歇负载。单卡 24GB 级建议 850W 起,5090 一类建议 1000W 起,并留余量(见 整机功耗与散热)。
- 散热: 机箱风道要好,显存温度也要看,长时间训练时降低功耗上限常常只损失很少速度,却显著降温(这是常见做法,具体效果因卡而异)。
- 系统: 训练框架在 Linux 上最省事;Windows 用户可以走 WSL2,见 WSL2 与 Docker 部署。Mac 可以用 MLX 做 LoRA,但生态与 CUDA 不同。
选购的三条原则
- 先定目标模型,再定显存: 想微调 14B,就找 16GB 起步;想微调 27B 到 32B,就找 24GB 到 32GB;不要先买卡再找用途。
- 优先 NVIDIA 与大显存: 多数训练工具对 CUDA 支持最好;同价位下优先选显存更大的型号。
- 租用也是选项: 偶尔训练一次大模型,租用云 GPU 往往比买整机更划算;高频、长期、数据敏感时才值得自建(隐私角度见 本地大模型与隐私)。我们没有在这里给出云价格,因为价格随时变化,请自行核对当时报价。
如何确认你的配置够用
- 先用目标模型和你的真实样本长度,跑一个只有几十条样本的小任务;
- 观察峰值显存(nvidia-smi 或训练日志),把它当作真实下限;
- 逐步提高批大小,找到不爆显存的最大值;
- 记录每百步用时,推算全程耗时,与上面的算式对比;
- 爆显存时按顺序处理:降批大小、缩短样本、改用 QLoRA、开梯度检查点(见 显存不足排查)。
常见误区
- “显存够就能训练”:激活值和长序列会让占用远高于权重本身。
- “多张小卡等于一张大卡”:叠加显存需要并行框架,通信有损耗。
- “训练越久越好”:过多轮次会过拟合,小数据集一般 1 到 3 个轮次就够。
- “微调能教模型新知识”:它更擅长改变风格和格式,新增事实更适合检索。
常见问题 FAQ
训练大模型需要什么配置?
训练大模型需要什么配置,取决于是全量预训练、全量微调还是 QLoRA 等参数高效微调:后者消费级显卡也可能起步,前者通常需要多卡与大量显存。先分清训练目标,再谈装机,见正文分层建议。
个人电脑能训练大模型吗?
能做 LoRA 或 QLoRA 微调,不能做预训练。全量微调只适合 1B 到 3B 的小模型。
训练大模型最低需要多少显存?
按 Unsloth 文档,QLoRA 微调 3B 模型最低约 3.5GB,7B 约 5GB;实际建议留出余量,从 12GB 起步更从容。
4090 和 3090 训练差多少?
两者都是 24GB,容量决定能训练什么;4090 算力更强,训练更快,但价格高很多。我们没有做同条件对比测试,请参考实测。
内存要多大?
建议至少与显存相当,起步 32GB;处理大数据集和加载大模型时 64GB 更稳。
训练和推理的配置要求一样吗?
不一样。训练还要为梯度、优化器状态和激活值留显存,同一模型的训练显存通常是推理的数倍。
租云 GPU 和自己买哪个划算?
偶尔训练时租用更划算,高频长期使用才值得自建;请按当时报价自己算。
和我们聊聊
告诉我们你想微调的模型、数据量和预算,我们帮你估算显存与时间。欢迎到社区留言,或邮件 admin@microaione.com。更多相关内容见 DIY 实验室文章。
参考资料:LoRA(arXiv 2106.09685)、QLoRA(arXiv 2305.14314)、ZeRO(arXiv 1910.02054)、Chinchilla(arXiv 2203.15556)、Unsloth 要求页。整机价格来自本站 2026-10-30 参考方案。数据读取于 2026-11-04,北京时间。