
Ollama 安装教程(Windows / Mac / Linux):从下载到跑通第一个模型
核对说明:本文的系统要求、安装命令和目录路径,于 2026 年 10 月 30 日对照 Ollama 官方文档与 ollama.com 下载页核对(GitHub 最新发布版本为 v0.40.13,2026-10-28 发布)。我们没有在实机上逐系统重装验证,也没有做速度测试。Ollama 更新频繁,界面和默认设置可能与本文略有出入,以官方文档为准。
Ollama 是目前最常见的本地大模型运行工具之一:安装后用一条命令就能下载并运行模型,同时在本机提供一个接口,方便其他软件调用。这篇 Ollama 安装教程按 Windows、macOS、Linux 分别讲安装,然后统一讲怎么验证、怎么改模型存放位置、怎么调上下文,以及出问题时先看哪里。
还没决定买什么配置、选多大模型?先看《本地部署大模型入门》。
Ollama 安装教程第一步:先确认系统要求
| 系统 | 官方要求 | 显卡相关 |
|---|---|---|
| Windows | Windows 10 22H2 或更新(家庭版或专业版),安装包本身至少约需 4GB 空间 | NVIDIA 需 551.61 或更新驱动;AMD 需支持 ROCm v7 的驱动栈,或支持 Vulkan 的驱动 |
| macOS | macOS Sonoma(14)或更新 | Apple M 系列芯片可用 GPU 加速;Intel 机型只能用 CPU |
| Linux | 官方提供一键脚本和手动安装包 | NVIDIA 需驱动 550 及以上;AMD 需 ROCm v7 |
模型文件另外占用空间,从几 GB 到几十 GB 不等(例如 qwen3:8b 约 5.2GB,gpt-oss:20b 约 14GB,llama3.3:70b 约 43GB,Ollama 模型库 2026-10-30 读取),请提前给硬盘留位置。显卡是否在支持范围,可对照官方硬件文档:计算能力 5.0 以上的 NVIDIA 显卡才在范围内。
Windows 上安装 Ollama
方法一:图形安装包(推荐)
- 打开 ollama.com/download,选择 Windows,下载
OllamaSetup.exe。 - 双击安装。官方说明安装不需要管理员权限,默认装到用户目录;换位置可在命令行用
OllamaSetup.exe /DIR="d:\some\location"。 - 安装完成后 Ollama 在后台运行,任务栏托盘里能看到图标;
ollama命令可在 cmd、PowerShell 等终端里直接用。 - 本机接口地址是
http://localhost:11434。
方法二:PowerShell 一条命令
下载页还给出 PowerShell 安装命令:
irm https://ollama.com/install.ps1 | iex
用之前请养成习惯:先打开链接看一眼脚本内容再执行。从网络直接执行脚本,风险自负。
Windows 注意事项
- 终端进度条显示成方块,是旧终端字体问题,换个字体即可。
- 日志目录在
%LOCALAPPDATA%\Ollama,里面有app.log和server.log,排错优先看后者。
macOS 上安装 Ollama
- 在下载页选 macOS,下载
Ollama.dmg。 - 打开 dmg,把 Ollama 拖进“应用程序”文件夹(官方推荐方式)。
- 首次启动时,如果系统路径里没有
ollama命令,App 会请求权限,在/usr/local/bin创建链接,同意即可。 - 打开终端就能使用
ollama命令。
模型和配置默认放在 ~/.ollama,日志在 ~/.ollama/logs。Mac 选购和内存规划见《Mac 跑大模型怎么选》。
Linux 上安装 Ollama
一键脚本
curl -fsSL https://ollama.com/install.sh | sh
这是官方文档给出的标准方式。同样建议先用浏览器看一遍脚本再执行。
手动安装
适合需要自己控制路径的人:
curl -fsSL https://ollama.com/download/ollama-linux-amd64.tar.zst | sudo tar x -C /usr
ollama serve
在另一个终端运行 ollama -v 能看到版本号,说明服务已起来。AMD 显卡需另外下载 ollama-linux-amd64-rocm.tar.zst 解压到同一位置;ARM64 使用 ollama-linux-arm64.tar.zst。
做成开机服务
官方文档把“添加为开机服务”列为手动安装的推荐做法:先新建 ollama 用户和用户组,再编写 /etc/systemd/system/ollama.service(内容见官方 Linux 文档),然后:
sudo systemctl daemon-reload
sudo systemctl enable ollama
sudo systemctl start ollama
sudo systemctl status ollama
NVIDIA / AMD 驱动
NVIDIA 用户先运行 nvidia-smi,能正常打印显卡信息说明驱动正常。AMD 用户需安装 ROCm v7。
验证安装:跑通第一个模型
三个系统通用。先看版本:
ollama -v
然后运行官方快速入门里的示例模型:
ollama run gemma4:e2b
官方注明这个示例模型下载约 7.2GB,建议有 8GB 可用显存或统一内存;显存不足时 Ollama 会用系统内存,但回答会变慢。配置较低时可以换更小的模型。第一次运行 Ollama 可能引导你完成设置并提示登录以使用云端模型;只用本地模型的话选本地模型即可。进入对话后输入 /bye 退出。
想确认模型是否跑在显卡上,另开终端运行:
ollama ps
PROCESSOR 列显示 100% GPU 表示完全在显卡,100% CPU 表示完全在内存,两者混合说明部分放进了内存,速度会受影响。
用接口测试
官方示例:
curl http://localhost:11434/api/chat -H "Content-Type: application/json" -d '{"model": "gemma4:e2b", "messages": [{"role": "user", "content": "Say hello in one sentence."}], "stream": false}'
能返回内容,说明本地服务正常。想接上网页界面,见《Open WebUI 连接 Ollama》。
第一个模型选哪个
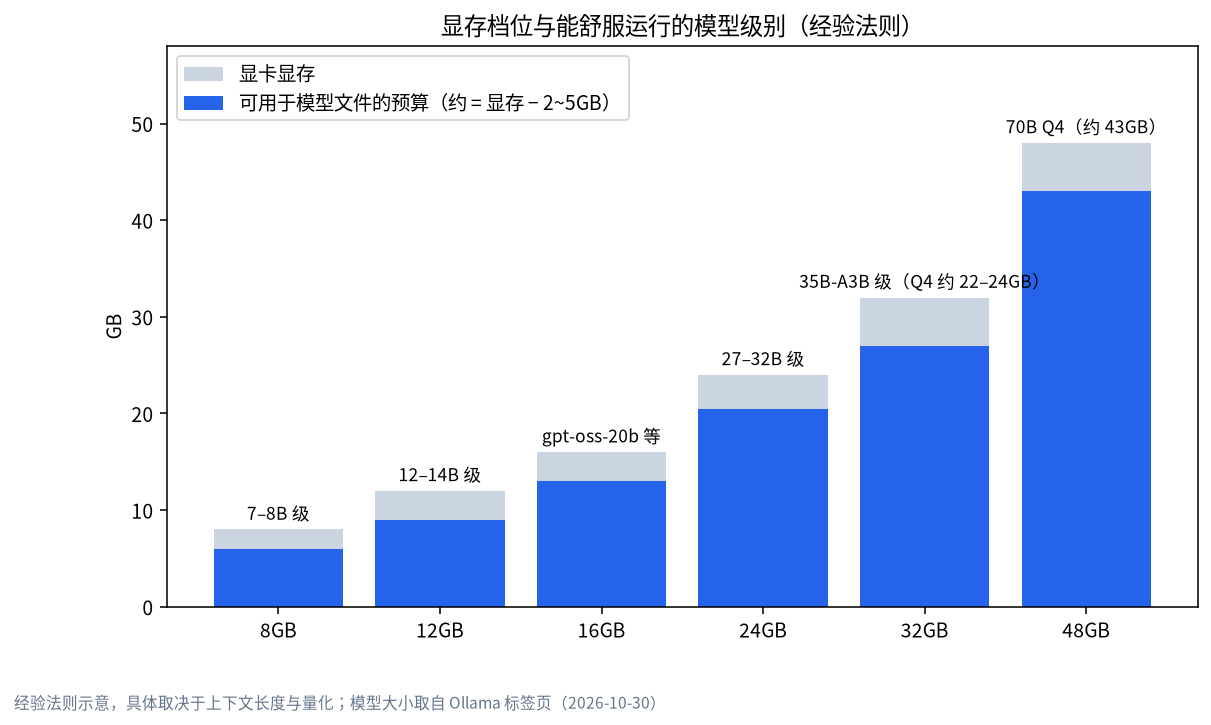
| 你的可用显存 / 内存 | 建议先试 | 文件大小(Ollama 2026-10-30) |
|---|---|---|
| 无独显 / 4GB 以内 | qwen3:1.7b 或 gemma4:e2b |
1.4GB / 4.6GB(q4_K_M 标签) |
| 8GB | qwen3:8b |
5.2GB |
| 12GB | qwen3:14b |
9.3GB |
| 16GB | gpt-oss:20b |
14GB |
| 24GB | qwen3.6:27b 或 qwen3:32b |
17GB / 20GB |
Ollama 常用命令速查
| 命令 | 作用 |
|---|---|
ollama run 模型名 |
下载(如未下载)并运行模型 |
ollama pull 模型名 |
只下载模型 |
ollama ls |
列出已下载的模型 |
ollama ps |
查看正在运行的模型和所在位置 |
ollama stop 模型名 |
停止并卸载模型 |
ollama rm 模型名 |
删除模型 |
ollama serve |
手动启动服务 |
默认情况下,模型会在内存中保留 5 分钟再卸载。想立即释放,用 ollama stop。
修改 Ollama 模型存放位置
默认路径来自官方 FAQ:
| 系统 | 默认模型路径 |
|---|---|
| macOS | ~/.ollama/models |
| Linux | /usr/share/ollama/.ollama/models |
| Windows | C:\Users\%username%\.ollama\models |
C 盘空间紧张时,设置环境变量 OLLAMA_MODELS 指向其他目录:
- Windows:先退出托盘里的 Ollama,在“编辑账户的环境变量”中新建
OLLAMA_MODELS,保存后重新从开始菜单启动。已有模型不会自动搬家,需要自己复制。 - macOS:用
launchctl setenv OLLAMA_MODELS "目录"设置,再重启 Ollama 应用。 - Linux:执行
sudo systemctl edit ollama.service,在[Service]下添加Environment="OLLAMA_MODELS=目录",然后systemctl daemon-reload并重启服务。官方特别提醒,使用标准安装方式时ollama用户必须对该目录有读写权限,可用sudo chown -R ollama:ollama 目录授权。
其他常用设置
下载慢或需要代理
官方 FAQ 说明,Ollama 从互联网拉取模型,必要时通过 HTTPS_PROXY 走代理,并把代理证书装为系统证书。官方明确提醒不要设置 HTTP_PROXY,因为拉取模型只用 HTTPS,设置它可能打断客户端与本地服务的连接。
让局域网访问
Ollama 默认只监听 127.0.0.1:11434。需要局域网访问时设置 OLLAMA_HOST,例如 0.0.0.0:11434。这会把接口暴露给同网络里的所有设备,请先配置好防火墙,不要直接放到公网。
调整上下文长度
这一点与旧教程不同:按官方文档,默认上下文长度现在随显存而定——显存小于 24GiB 为 4k,24–48GiB 为 32k,48GiB 及以上为 256k。网页搜索、智能体和编程工具类任务建议设置到至少 64000 tokens。用环境变量 OLLAMA_CONTEXT_LENGTH,或对话中 /set parameter num_ctx 8192,也可以在 Ollama 应用设置里拖滑块。上下文越长占用显存越多。
Ollama 环境变量速查表
安装完成后,大部分行为调整都靠环境变量。下表整理自官方 FAQ 与硬件文档(2026-10-30 读取),设置方法因系统而异(见上文“修改模型存放位置”中的 Windows、macOS、Linux 三种方式):
| 环境变量 | 作用 | 备注 |
|---|---|---|
OLLAMA_HOST |
监听地址 | 默认 127.0.0.1:11434;改成 0.0.0.0 会暴露给局域网 |
OLLAMA_MODELS |
模型存放目录 | Linux 需保证 ollama 用户有读写权限 |
OLLAMA_CONTEXT_LENGTH |
默认上下文长度 | 默认值随显存而定,见上文 |
OLLAMA_KEEP_ALIVE |
模型在内存中保留多久 | 默认 5 分钟;API 的 keep_alive 参数优先级更高 |
OLLAMA_MAX_LOADED_MODELS |
同时加载的模型数 | 多模型同时在线时需要关注显存 |
OLLAMA_NUM_PARALLEL |
并发请求数 | 并发越多,占用显存越多 |
OLLAMA_FLASH_ATTENTION |
强制开/关 Flash Attention | 支持的后端会自动启用,能降低长上下文的内存占用 |
OLLAMA_KV_CACHE_TYPE |
KV 缓存量化类型 | 默认 f16;需启用 Flash Attention |
OLLAMA_NO_CLOUD |
关闭云功能 | 设为 1 以确保只用本地模型 |
CUDA_VISIBLE_DEVICES |
指定使用哪些 NVIDIA 显卡 | 逗号分隔列表 |
HTTPS_PROXY |
下载模型走代理 | 不要设置 HTTP_PROXY |
修改前先记下旧值;一次只改一个,改完用 ollama ps 和一次对话验证效果,出问题更容易定位。
装好之后的第一周:一份务实的清单
很多人装完就停在“能聊天”。下面是一份我们建议的最小清单,帮你把环境从“能用”推进到“放心用”:
- 固定一个主力模型:先选一个与显存匹配的模型用一周,再比较其他的,不要同时下载十几个,磁盘很快会被占满。
- 记录你的上下文需求:日常聊天保持默认即可;做长文档、智能体或写代码时,再按需提高并观察
ollama ps里模型大小的变化。 - 养成看
ollama ps的习惯:它是判断“是否真的在显卡上”的最直接方式。 - 决定要不要开放局域网访问:不需要就保持默认的本机监听,更安全。
- 给模型目录留余量:把
OLLAMA_MODELS指向容量大的盘,并定期用ollama ls和ollama rm清理不用的模型。 - 再接图形界面:确认命令行没问题之后,再装 Open WebUI 或 LM Studio,出现问题时更容易判断是哪一层的原因。
升级与卸载
- 升级:Windows 和 macOS 会自动下载更新,点击托盘或菜单栏图标里的“Restart to update”;Linux 重新运行安装脚本。
- 卸载:Windows 在“应用和功能”里卸载(如改过
OLLAMA_MODELS,模型不会被一并删除);Linux 和 macOS 的步骤见官方文档。
Ollama 安装后的故障排查
GPU 没用上,速度很慢
按顺序检查:
- 运行
ollama ps,看 PROCESSOR 列。 - NVIDIA 用户运行
nvidia-smi,确认驱动版本符合要求。 - 查看日志:Windows 看
%LOCALAPPDATA%\Ollama\server.log,macOS 看~/.ollama/logs/server.log,Linux 运行journalctl -e -u ollama。 - Linux 笔记本休眠唤醒后掉到 CPU,官方文档给出针对驱动问题的处理:
sudo rmmod nvidia_uvm && sudo modprobe nvidia_uvm。
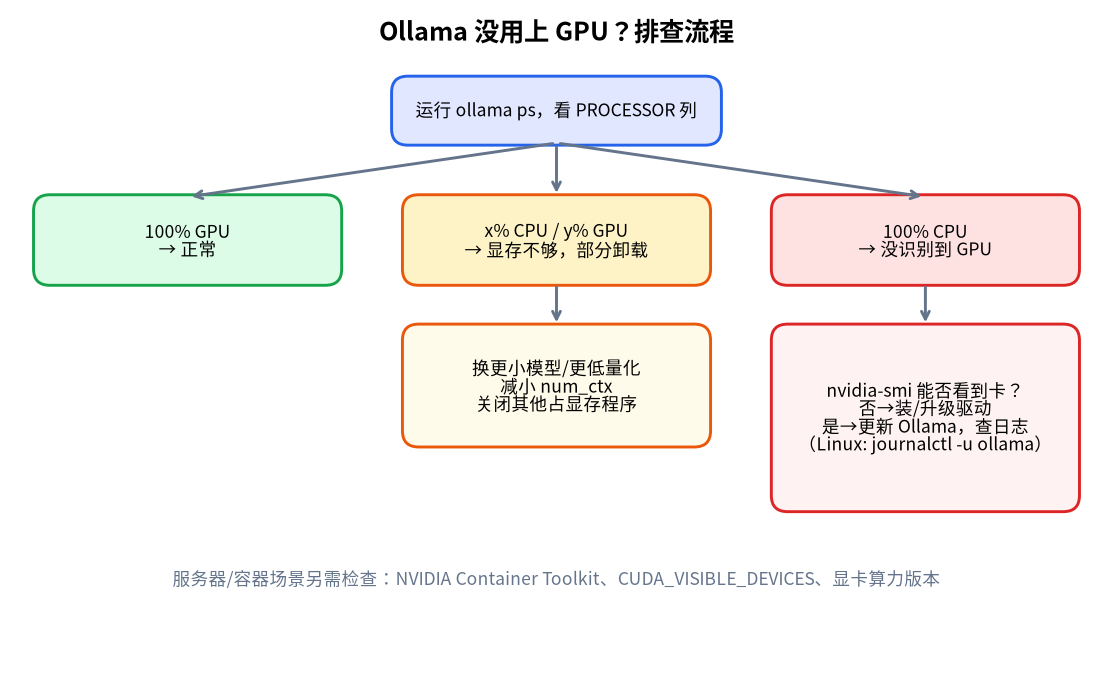
更系统的排错见《Ollama 常见报错与 GPU 没用上怎么办》。
显存放不下模型
换小一档的模型,或降低上下文长度。选模型的方法见《显卡与显存怎么选》。
常见问题(FAQ)
Ollama 安装需要联网吗?
安装和下载模型需要联网。下载完成后本地运行不依赖网络;使用云端模型或联网搜索则需要网络。需要完全本地使用时,可按官方文档关闭云功能(设置 OLLAMA_NO_CLOUD=1)。
Ollama 和 LM Studio 选哪个?
Ollama 偏命令行和接口,便于被其他程序调用;LM Studio 提供图形界面,适合不想敲命令的用户。两者都可以用,见《LM Studio 使用教程》。
我的显卡 Ollama 支持吗?
NVIDIA 需计算能力 5.0 及以上;AMD 和 Intel 等显卡的支持情况请看官方硬件支持页面,购买前建议逐项核对。
Ollama 会把我的对话发到网上吗?
官方 FAQ 说明:本地运行时 Ollama 看不到你的提示词和数据;使用云端托管模型时,提示词和回答会由其服务器处理。
装好后下一步做什么?
可以尝试 DeepSeek,见《DeepSeek 本地部署》,或搭一个网页界面。
Ollama 默认上下文是多少?
不再是固定的 4096。随显存而定:小于 24GiB 为 4k,24–48GiB 为 32k,48GiB 及以上为 256k,详见上文“调整上下文长度”。
下一步与社区
装好后遇到卡在显卡识别、驱动或下载上的问题,可以带着 ollama ps 和日志去社区求助(加入社区)。如果你不想自己折腾环境,我们也提供按预算的整机方案咨询(在深圳选型、装配、实测),先沟通需求,不强制购买。