
DeepSeek 本地部署:蒸馏版与满血版的区别,按显存选版本
核对说明:本文的版本对应关系、文件大小和运行命令,于 2026 年 10 月 30 日对照 Ollama 模型库、DeepSeek 官方 GitHub 与 Hugging Face 模型卡核对。我们没有在实机上测试各版本的速度和质量,文中的评测数字全部来自 DeepSeek 官方自报并已标注来源。DeepSeek 模型更新很快,请以官方页面为准。
很多人说“DeepSeek 本地部署”,实际跑的往往不是网页上那个完整的模型,而是它的蒸馏小模型。名字相似,规模和能力却差得很远。这篇文章讲清楚两者的区别,补充 2026 年新出的 V4 系列能不能在家里跑,并按显存告诉你该下载哪个版本。
先说结论
- 普通电脑和单张消费级显卡,跑的都是 R1 蒸馏版,参数量从 1.5B 到 70B。
- 完整的 DeepSeek-R1 有 6710 亿参数,Ollama 上
deepseek-r1:671b文件为 404GB,个人电脑基本不现实。 - 更新的 DeepSeek-V4(Flash 2840 亿 / Pro 1.6 万亿参数)同样是超大 MoE 模型,Hugging Face 仓库文件合计约 160GB(Flash)和约 865GB(Pro),属于服务器或超大内存机器的范围;而且 Ollama 上的
deepseek-v4-flash页面已标注停用(2026-09-25),目前没有一键ollama run的家用路径。 - 新手想快速体验:显存 8GB 左右选
deepseek-r1:8b;24GB 选deepseek-r1:32b。 - 还没装好 Ollama?先看《Ollama 安装教程》。
DeepSeek 本地部署前先分清:蒸馏版和满血版有什么区别
满血版:671B 的混合专家模型
按 DeepSeek 官方 GitHub 说明,DeepSeek-R1 总参数 671B,每次推理激活 37B,上下文长度 128K,基于 DeepSeek-V3-Base 训练。它是混合专家(MoE)结构:运行时只调用一部分参数,但所有参数都要加载进内存,所以显存和内存需求按总参数算,不是按激活参数算。
蒸馏版:用 R1 数据教出来的小模型
官方说明里,蒸馏版是用 DeepSeek-R1 生成的推理数据,对 Qwen 和 Llama 系列的开源模型做微调得到的。它们不是缩小后的 R1,而是“被教过推理”的 Qwen 或 Llama。官方开源了 1.5B、7B、8B、14B、32B 和 70B 六种规格。
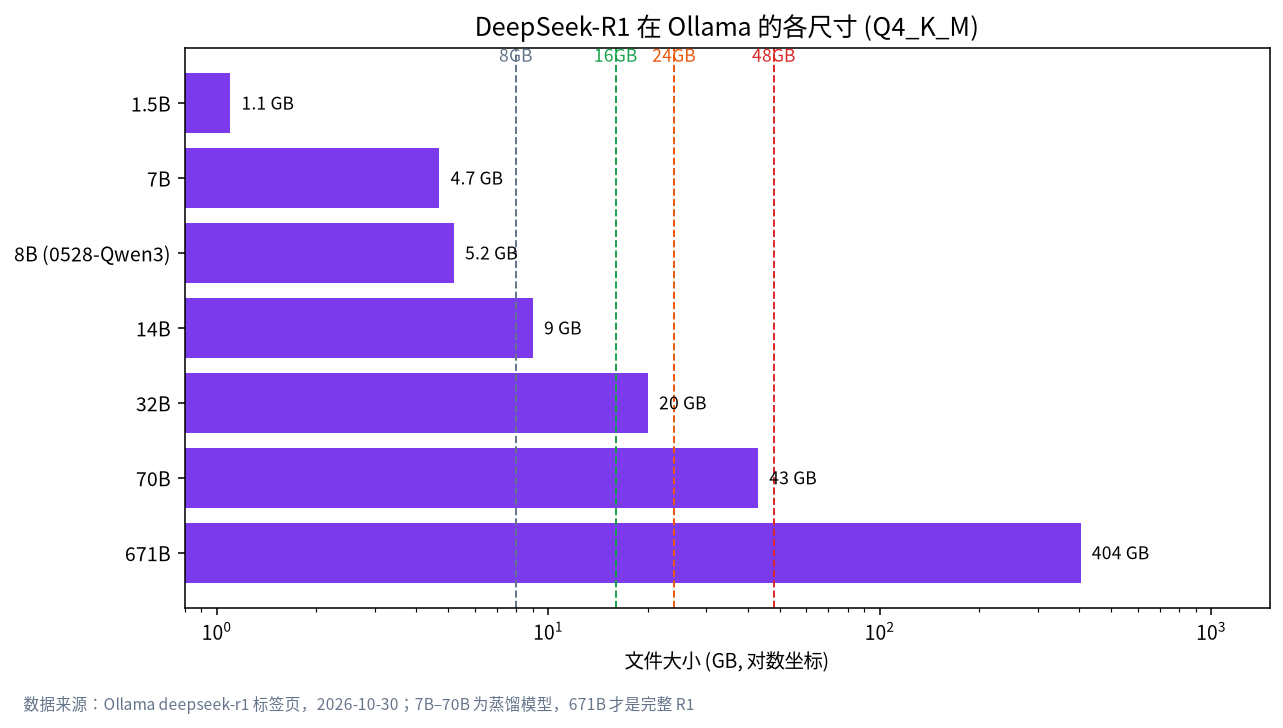
Ollama 上的对应关系
Ollama 的 deepseek-r1 标签和官方 GitHub 的列表有一处不同,要特别注意:
| Ollama 标签 | 对应模型 | 基座 | 文件大小(Q4_K_M) |
|---|---|---|---|
deepseek-r1:1.5b |
DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5 | 1.1GB |
deepseek-r1:7b |
DeepSeek-R1-Distill-Qwen-7B | Qwen2.5 | 4.7GB |
deepseek-r1:8b(默认) |
DeepSeek-R1-0528-Qwen3-8B | Qwen3 | 5.2GB |
deepseek-r1:14b |
DeepSeek-R1-Distill-Qwen-14B | Qwen2.5 | 9.0GB |
deepseek-r1:32b |
DeepSeek-R1-Distill-Qwen-32B | Qwen2.5 | 20GB |
deepseek-r1:70b |
DeepSeek-R1-Distill-Llama-70B | Llama 3.3 | 43GB |
deepseek-r1:671b |
DeepSeek-R1(满血版) | DeepSeek-V3-Base | 404GB |
Ollama 页面说明,8b 已更新为 R1-0528 蒸馏到 Qwen3-8B 的模型,不是官方 GitHub 列表里的 Llama-8B。直接运行 ollama run deepseek-r1 不带标签时,下载的就是这个 8b。以前下载过旧版的话,可以用 ollama pull deepseek-r1 更新。以上文件大小为 Ollama 页面 2026-10-30 的数据,是下载体积,不是运行时的总显存。
DeepSeek-V4 能在本地跑吗
DeepSeek 在 2026 年发布了 V4 系列。按 Hugging Face 模型卡(MIT 许可证):
| 模型 | 总参数 | 激活参数 | 上下文 | 精度 | HF 仓库总大小(2026-10-30) |
|---|---|---|---|---|---|
| DeepSeek-R1(671B) | 671B | 37B | 128K | FP8 | 对比参考:Ollama Q4_K_M 为 404GB |
| DeepSeek-V4-Flash | 284B | 13B | 1M | FP4+FP8 混合 | 约 160GB |
| DeepSeek-V4-Pro | 1.6T | 49B | 1M | FP4+FP8 混合 | 约 865GB |
怎么理解这张表:
- V4 也是 MoE,激活参数少只代表每个 token 算得快,权重仍要全部放进内存。160GB 的 Flash 仍然远超任何消费级显卡,属于 128GB 以上统一内存(并加上量化)、多卡服务器的范畴,我们不建议把它当作个人电脑的目标。
- 模型卡写明 V4 支持 100 万 token 上下文,并建议本地部署时采样参数用
temperature = 1.0, top_p = 1.0;使用 Think Max 推理模式时,上下文窗口建议至少 384K tokens。长上下文同样吃内存,规划时要留出余量。 - 截至 2026-10-30,Ollama 上
deepseek-v4-flash页面标注“已于 2026 年 9 月 25 日停用,没有推送模型”,所以本文不给出 Ollama 命令。想了解最新的运行方式,请看 DeepSeek-V4-Flash 的 Hugging Face 模型卡。 - 对大多数个人用户,更现实的选择仍然是 R1 蒸馏版,或同级别的 Qwen、Gemma、gpt-oss 系列,对比见《本地大模型推荐》和《Qwen 本地部署》。
按显存选版本:DeepSeek 显存要求对照
档位综合了 Ollama 文件大小和两个第三方硬件指南(PromptQuorum、CanRun)的估算,是参考而不是保证:
| 可用显存 / 统一内存 | 建议版本 | 说明 |
|---|---|---|
| 4GB 以内或无独显 | 1.5B | 能跑通流程,推理能力有限,适合体验 |
| 8GB | 7B 或 8B | 最常见的入门选择;8B 文件约 5.2GB,加上下文后仍有余量 |
| 12GB | 8B,或勉强 14B | 14B 文件 9.0GB,加上下文后余量较小,上下文别开太大 |
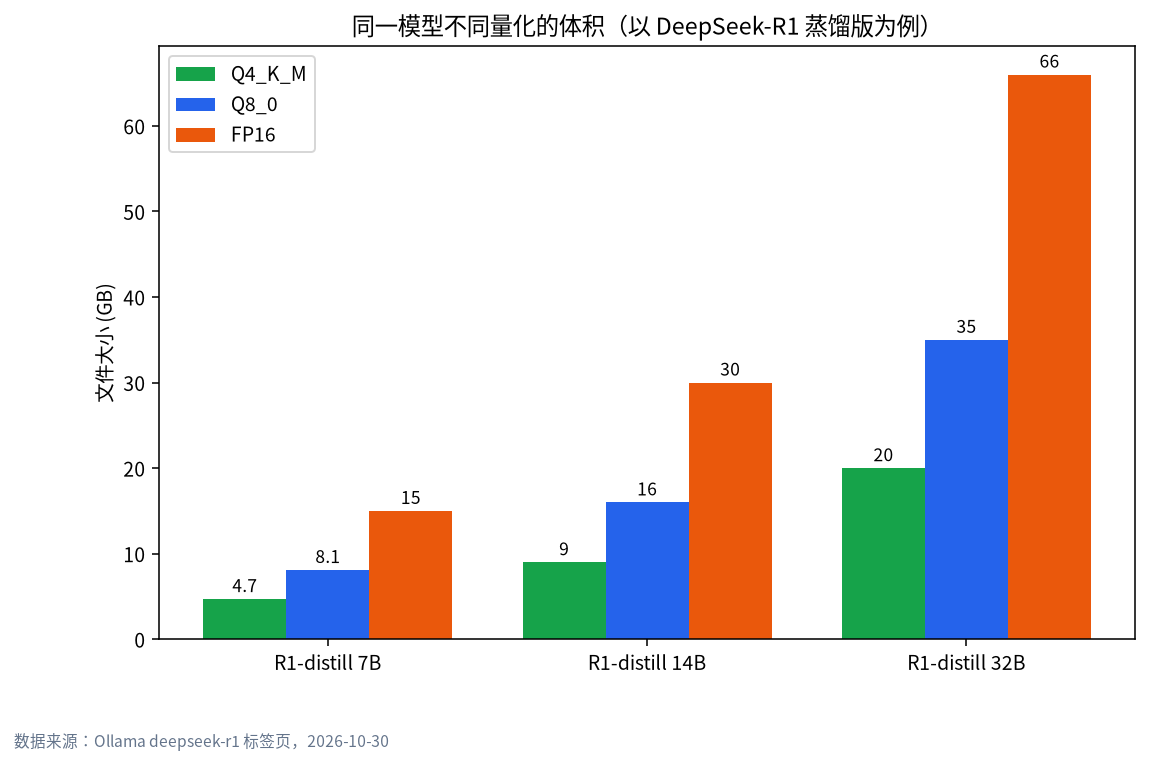
| 16GB | 14B | 14B 标准版余量充裕;PromptQuorum 估算 14B 的 Q8_0 约 15GB,也能放进 16GB 卡(Ollama 标注 16GB,较紧) |
| 24GB | 32B | PromptQuorum 估算 32B 的 Q4_K_M 约 19GB(Ollama 标注 20GB),适合 24GB 显卡 |
| 48GB 以上 | 70B | 文件 43GB,单张 24GB 卡放不下,需要多卡、大内存 Mac 或专业卡 |
| 数百 GB 内存的服务器 | 671B | 个人用户不建议考虑 |
Mac 用户按统一内存计算,16GB 是比较舒适的起点,更多细节见《Mac 跑大模型怎么选》。如果显存刚好卡在两档之间,建议优先选小一档、上下文开得宽裕的方案。具体显卡对照见《显卡与显存怎么选》。
动手部署:四步跑起 DeepSeek 蒸馏版
第一步:安装 Ollama
按《Ollama 安装教程》完成安装,并用 ollama -v 确认服务正常。
第二步:运行对应版本
ollama run deepseek-r1:8b
把 8b 换成上表其他标签即可,例如 ollama run deepseek-r1:14b。首次运行会自动下载,完成后直接进入对话,输入 /bye 退出。
第三步:确认运行位置
另开一个终端运行 ollama ps。PROCESSOR 列显示 100% GPU 最理想;出现 CPU 比例说明有一部分放进了内存,速度会明显下降,这时应换小一档的版本或降低上下文。排查方法见《Ollama 常见报错与 GPU 没用上怎么办》。
第四步:调整上下文
按 Ollama 官方文档,默认上下文长度随显存而定:小于 24GiB 为 4k,24–48GiB 为 32k,48GiB 及以上为 256k。推理模型的“思考过程”会消耗很多 token,所以 4k 上下文经常不够,可在对话里输入:
/set parameter num_ctx 16384
或在启动服务时设置环境变量 OLLAMA_CONTEXT_LENGTH。上下文越长,显存占用越大,设置前请对照显存余量;智能体和编程类用途建议至少 64000 tokens。
推理模型为什么“慢”、为什么吃上下文
R1 系列是推理(reasoning)模型:回答之前会先输出一大段“思考过程”,再给最终答案。这带来两个本地部署时必须知道的现象:
- 同样的问题,生成的 token 更多,所以体感上比普通对话模型更慢,也更消耗上下文。思考内容占用 KV 缓存,长对话里更明显。
- 默认的 4k 上下文常常不够。Ollama 在显存小于 24GiB 时默认 4k,复杂数学或代码题容易被截断,建议按上文调到 8k–16k,并先确认显存是否放得下。
如果你的任务只是改写、翻译、简单问答,不需要推理链,选一个同等大小的通用模型通常更快更省显存;只有数学、代码、逻辑推理类任务才更值得上推理模型。
DeepSeek 蒸馏版和同级别模型对比
选 DeepSeek 之前,不妨与同一显存档的其他开放模型放在一起看。下表只比较 Ollama 页面上可核对的事实(2026-10-30),不包含我们自测的质量或速度结论:
| 显存档 | 模型标签 | 文件大小 | Ollama 页标注的上下文 | 许可证(Hugging Face 标注) |
|---|---|---|---|---|
| 8GB | deepseek-r1:8b |
5.2GB | 128K | MIT(蒸馏继承基座许可) |
| 8GB | qwen3:8b |
5.2GB | 40K | Apache-2.0(Qwen3 系列) |
| 12–16GB | deepseek-r1:14b |
9.0GB | 128K | MIT(基座 Qwen2.5) |
| 16GB | gpt-oss:20b |
14GB | 128K | Apache-2.0 |
| 24GB | deepseek-r1:32b |
20GB | 128K | MIT(基座 Qwen2.5) |
| 24GB | qwen3.6:27b |
17GB | 256K | Apache-2.0 |
| 24GB | gemma4:31b |
20GB | 256K | Apache-2.0 |
表里的“上下文”是模型支持的上限,不是 Ollama 默认值,真正能开多大要看显存。同级别模型各有擅长,具体怎么选见《本地大模型推荐:按显存和用途》。
使用建议:官方的几条提醒
DeepSeek 官方 GitHub 在“使用建议”里写了几条适用于 R1 系列的配置:
- 温度设在 0.5 到 0.7 之间,推荐 0.6,避免无休止的重复或不连贯的输出。
- 避免添加系统提示词,所有指令放进用户提示词。
- 数学题可在提示词中加上“请逐步推理,并把最终答案放在 \boxed{} 中”之类的指令。
- 评估效果时多测几次再取平均。
在 Ollama 中,这类参数可用对话里的 /set parameter 设置,也可写进 Modelfile。
蒸馏版到底有多强:官方自报数据
DeepSeek 官方 GitHub 公布了蒸馏版的评测结果。下面是其中三项,数字为各模型自己的 pass@1 分数,生成长度上限 32,768 token,温度 0.6:
| 模型 | AIME 2024 | MATH-500 | LiveCodeBench |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | 55.5 | 92.8 | 37.6 |
| DeepSeek-R1-Distill-Qwen-14B | 69.7 | 93.9 | 53.1 |
| DeepSeek-R1-Distill-Qwen-32B | 72.6 | 94.3 | 57.2 |
| DeepSeek-R1-Distill-Llama-70B | 70.0 | 94.5 | 57.5 |
阅读这张表请注意三点:这是 DeepSeek 自己公布的数据,不是我们测的;测试集中在数学、编程和推理,不代表日常聊天和中文写作的体验;Ollama 上的 8b 已是更新后的 Qwen3 基座版本,不在这张表里。从这张表也能看到(仅限这三项):7B 到 14B 提升明显,14B 到 32B 提升变小,32B 与 70B 的分数很接近。对大多数个人用户,14B 或 32B 通常是性价比更合理的区间。
许可证与商用
官方说明里,模型权重采用 MIT 许可证,DeepSeek-R1 系列支持商用,允许修改和衍生;V4 的 Hugging Face 模型卡同样标注 MIT。但蒸馏模型继承了基座模型的许可:Qwen 系列蒸馏版源自 Qwen2.5(Apache 2.0);Llama 蒸馏版遵循对应 Llama 许可证。商用前请阅读原文。
常见问题(FAQ)
本地部署的 DeepSeek 和官网的一样强吗?
不一样。官网对话背后的模型由 DeepSeek 自行决定并持续更新,本地普通电脑跑的是蒸馏小模型,规模和能力都不同。蒸馏版的价值在于隐私、离线和可控,而不是复刻官网效果。
8GB 显存跑哪个 DeepSeek 版本?
选 deepseek-r1:7b 或 deepseek-r1:8b。更多 8GB 显卡的选择见《8GB 显存能跑什么模型》。
24GB 显存能跑 70B 吗?
不推荐。70B 的文件有 43GB,24GB 显卡放不下,大部分会落在内存里,速度很慢。24GB 显卡更适合 32B,见《24GB 显存能跑什么模型》。
DeepSeek-V4 能用 Ollama 本地跑吗?
截至 2026-10-30,Ollama 上的 V4-Flash 页面已停用且没有推送模型,且 V4 的权重体积(Flash 约 160GB)远超消费级设备,所以不建议作为个人电脑的目标。
没有显卡可以运行 DeepSeek 吗?
可以,Ollama 在显存不足时使用系统内存,但会慢很多,建议从 1.5B 或 7B 开始。
下载很慢怎么办?
Ollama 官方 FAQ 建议在需要时用 HTTPS_PROXY 配置代理,并避免设置 HTTP_PROXY。
下一步与社区
DeepSeek 选哪个尺寸、要不要上 32B,常常取决于你的具体显卡与预算,欢迎带着配置来社区一起看(加入社区)。如果你不想自己折腾安装,我们在深圳做本地大模型机器的选型、组装与实测,也可以按你想跑的模型倒推配置,先聊需求,不强制购买。