
LM Studio 教程:免命令行下载和运行模型,新手完整上手指南
核对说明:本文依据 LM Studio 官方文档与下载页(2026-10-30 读取,下载页显示当前版本 0.4.27)编写。软件界面更新较快,截图与菜单位置可能与你看到的略有不同,请以官方文档为准。我们没有对速度做自测,不给出跑分。
如果你不想碰命令行,又想在自己电脑上运行大模型,这篇 LM Studio 教程就是为你写的。LM Studio 是一款图形化桌面软件:能搜索并下载模型、像网页聊天一样对话、直接和文档聊天,还能一键开启兼容 OpenAI 格式的本地接口。下面按“安装 → 下载模型 → 聊天 → 调参数 → 文档对话 → 本地服务器”的顺序一步步讲。
LM Studio 是什么,和 Ollama 有什么区别
LM Studio 官方文档把它描述为能下载并运行本地 LLM(如 gpt-oss、Llama、Qwen)的应用,提供简洁的聊天界面、模型搜索下载(来自 Hugging Face)、MCP 支持,以及兼容 OpenAI 的本地接口。它用 llama.cpp 运行 GGUF 模型,在 Apple 芯片的 Mac 上还支持 Apple 的 MLX。
和 Ollama 比,两者定位不同:
| 对比项 | LM Studio | Ollama |
|---|---|---|
| 主要界面 | 图形化桌面应用 | 命令行 + 简单桌面应用 |
| 找模型 | 内置搜索,直接下载 Hugging Face 上的模型 | 用 ollama run 模型名 拉取自己的模型库 |
| 选量化版本 | 界面中直接列出多个量化版本 | 通过模型标签选择 |
| 本地接口 | OpenAI 兼容接口,默认端口 1234(文档示例) | 自带 API,端口 11434 |
| 无界面运行 | 有无界面版本 llmster | 本身适合服务器 |
| 适合 | 新手、想挑选量化版本、想要界面 | 脚本化、服务器部署、搭配其他工具 |
两者可以同时安装,互不冲突。命令行更熟悉的读者可以直接看《Ollama 安装教程》。
LM Studio 教程第一步:系统要求与安装
按官方系统要求页面:
| 系统 | 要求 |
|---|---|
| macOS | 需要 Apple 芯片(M1/M2/M3/M4 等),macOS 14.0 及以上,建议 16GB 以上内存;8GB 也可以尝试,但要选小模型并控制上下文;暂不支持 Intel Mac |
| Windows | 支持 x64 和 ARM(Snapdragon X Elite);x64 需要 AVX2 指令集;建议至少 16GB 内存,建议至少 4GB 独立显存 |
| Linux | 支持 x64 和 ARM64,以 AppImage 分发;需要 Ubuntu 20.04 或更新版本(较新版本测试较少) |
安装步骤:
- 打开 LM Studio 下载页,选择你的系统版本下载安装包。
- 按提示安装并打开软件。首次启动时它会引导你下载一个模型,可以先跳过,之后再选。
- 模型文件会很大,安装前确认磁盘空间;如果系统盘空间不足,可以在“My Models”页修改模型保存目录。
下载你的第一个模型
搜索模型
在左侧进入 Discover(发现)页,可以按关键词搜索,例如 qwen、gemma、llama,也可以直接输入 用户名/模型名,甚至粘贴完整的 Hugging Face 链接。官方小技巧:Mac 上按 ⌘+2,Windows 和 Linux 按 Ctrl+2,可以从任何界面跳到 Discover 页。
怎么选量化版本
同一个模型会有 Q3_K_S、Q8_0 等多个版本,它们是同一个模型的不同压缩程度。官方文档的建议是:如果机器能跑,选择 4-bit 或更高的版本。我们的补充:
| 量化版本 | 文件大小 | 质量 | 适合 |
|---|---|---|---|
| Q3 及以下 | 最小 | 下降明显 | 内存极度紧张时的无奈之选 |
| Q4_K_M | 小(约为 FP16 的三成) | 日常足够 | 大多数人的默认选择 |
| Q5/Q6 | 中等 | 更接近原模型 | 显存或内存有余量时 |
| Q8_0 | 较大 | 非常接近原模型 | 显存充裕、追求质量 |
更详细的比较见《大模型量化是什么:Q4_K_M、Q8 怎么选》。
按内存挑模型大小
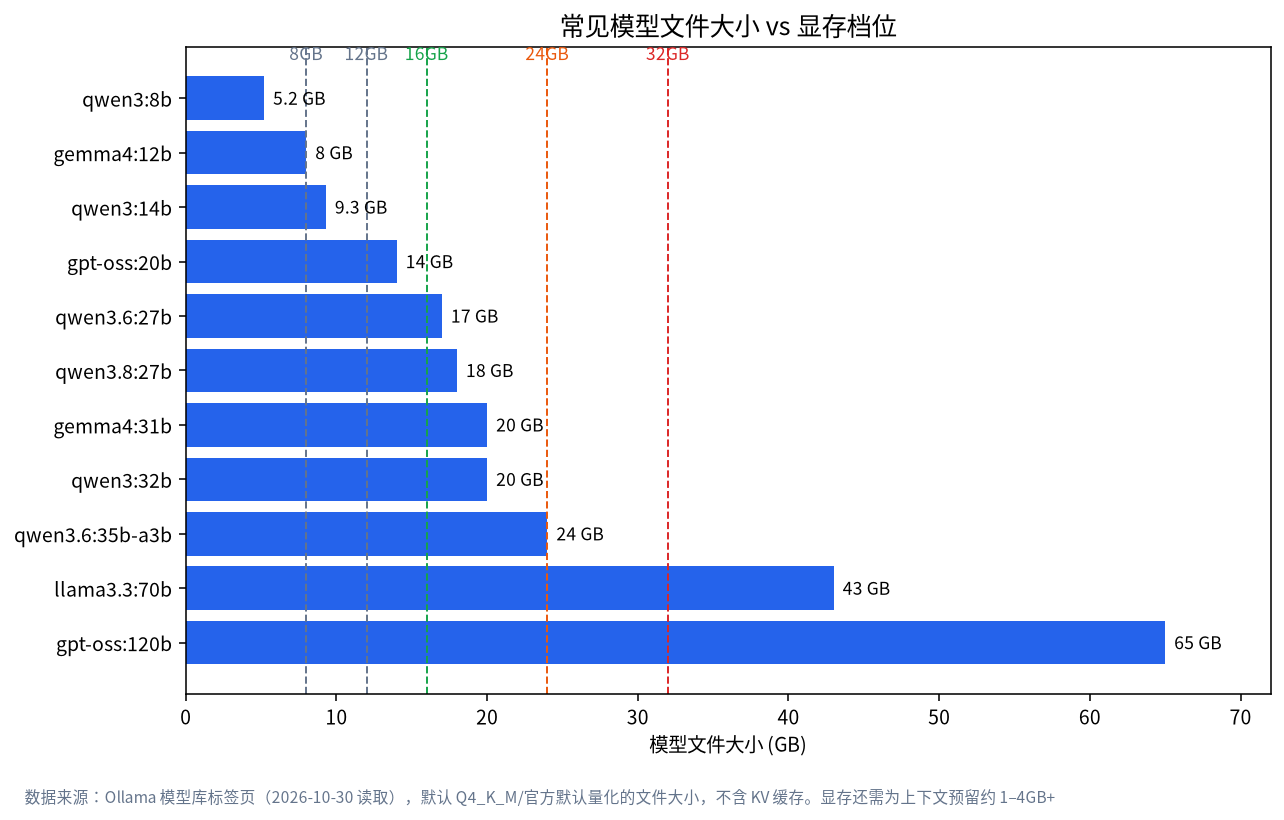
先看自己的显存或统一内存,再选文件大小。下面是粗略的起点,数据取自 Ollama 模型库的文件大小(2026-10-30),LM Studio 里的同名模型大小相近但不完全一样:
| 可用显存 / 内存 | 模型大小建议 | 搜索关键词示例 | Ollama 参考文件大小 |
|---|---|---|---|
| 8GB | 7B–8B | qwen3 8b |
5.2GB |
| 12GB | 12B–14B | qwen3 14b |
9.3GB |
| 16GB | 约 20B | gpt-oss 20b |
14GB |
| 24GB | 27B–32B | qwen3.6 27b、gemma 4 31b |
17–20GB |
注意:下载文件之外还要给上下文留空间,规则见《大模型显存需求怎么算》。8GB 显卡的选择可参考《8GB 显存能跑什么模型》。
开始聊天
- 在聊天页顶部点击模型选择器,选择已下载的模型并加载。
- 加载完成后,直接在底部输入框提问。
- 如果加载很慢或提示内存不足,换小一档的模型,或降低下面要讲的上下文长度。
调整加载参数
LM Studio 官方文档说明,可以为每个模型设置默认的加载参数:进入 My Models 页,点击模型旁的齿轮图标即可。常见的设置有:
- GPU 卸载(GPU offload):决定多少层放进显卡。放不下的层会留在内存,速度会下降。
- 上下文大小:越大占用内存越多。长文档分析可以调大,但要留意内存。
- Flash Attention:可选的优化,官方文档把它列为可按模型设置的选项。
调整后保存为默认值,下次加载就会沿用。参数含义的通俗解释,见《大模型显存需求怎么算》。
和文档聊天
官方文档说明,可以把 .docx、.pdf、.txt 文件附加到聊天里:
- 文档较短、能放进模型上下文时,LM Studio 会把全文放进对话。
- 文档很长时,LM Studio 会改用 RAG(检索增强生成),从长文档中检索相关片段交给模型。这种方式有时效果很好,有时需要调整。
- 官方的小技巧:提问时尽量多给上下文,写出你预期在文档里出现的词句,能提高检索命中率。
官方的离线说明还写明:文档处理全部在本地完成,上传到 LM Studio 的内容不会离开应用。
进阶:三种使用方式与运行时管理
LM Studio 不只是一个桌面窗口。按官方文档和下载页,它有三种形态:
| 形态 | 说明 | 适合场景 |
|---|---|---|
| LM Studio 桌面应用 | 图形界面,搜索、下载、聊天、本地服务器都在里面 | 个人电脑,新手 |
lms 命令行 |
用命令行聊天、下载模型、管理后台进程、控制服务器 | 想用脚本控制 |
| llmster(无界面版) | 官方称为 LM Studio 的无界面守护进程,面向服务器、云主机和 CI | 没有桌面环境的机器 |
下载页给出的 llmster 安装命令:Mac 和 Linux 用 curl -fsSL https://lmstudio.ai/install.sh | bash,Windows 用 irm https://lmstudio.ai/install.ps1 | iex。执行任何“从网络下载并运行脚本”的命令前,请先确认来源可信。
另外,LM Studio 用“运行时(LM Runtimes)”来执行模型:官方文档说明,它在各系统上用 llama.cpp 运行 GGUF 模型,在 Apple 芯片 Mac 上还可以用 MLX。在 Mac 上按 ⌘+Shift+R,在 Windows 和 Linux 上按 Ctrl+Shift+R 可以安装或管理运行时。遇到“新模型加载失败”时,先检查运行时是否需要更新,往往能解决问题。
十分钟上手清单
- 确认电脑满足系统要求,并查清自己的显存或统一内存大小。
- 下载并安装 LM Studio。
- 在 Discover 页搜索一个与你内存匹配的模型(例如 8GB 选 8B 级)。
- 选 Q4_K_M 或更高的版本,等待下载完成。
- 加载模型,问几个熟悉领域的问题,感受回答质量。
- 回到 My Models 页,给这个模型设置好默认的上下文大小。
- 需要时,开启本地服务器,用 OpenAI 格式的客户端接入。
开启本地服务器:用 OpenAI 格式调用
LM Studio 的开发者功能可以把模型变成一个本地接口。官方文档列出的兼容端点包括 /v1/models、/v1/chat/completions、/v1/embeddings、/v1/completions 等,示例中使用的端口是 1234。已有的 OpenAI 客户端只需把 base URL 改到本机即可:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:1234/v1", api_key="lm-studio")
resp = client.chat.completions.create(
    model="这里填 LM Studio 中显示的模型标识",
    messages=[{"role": "user", "content": "你好,请介绍一下你自己"}],
)
print(resp.choices[0].message.content)
api_key 填任意字符串即可(本地服务不校验,这是常见写法,我们没有逐版本验证,如被拒绝请参考官方文档)。服务器既可以只监听本机,也可以在局域网内提供服务;如果开放到局域网,请确认网络可信。
离线使用与隐私
按官方离线说明:聊天、与文档对话、运行本地服务器都不需要联网;搜索模型、下载模型和 Discover 页的目录更新需要联网。你可以先下载好模型,之后完全断网使用。官方也说明,在 LM Studio 里与模型聊天时输入的内容不会离开你的设备。
加载与运行故障排查
| 现象 | 可能原因 | 处理办法 |
|---|---|---|
| 加载模型报内存不足 | 模型太大或上下文太长 | 换更小的模型或量化版本,调低上下文 |
| 生成速度很慢 | 部分层落在内存,没放进显卡 | 提高 GPU 卸载层数,或换小一档模型 |
| 搜不到模型 | 没有联网 | 联网后再搜索,或手动导入已有模型文件 |
| 磁盘不够 | 模型文件太大 | 在 My Models 页改模型目录 |
| 界面和教程不一致 | 软件更新了 | 以官方文档为准 |
常见问题(FAQ)
LM Studio 免费吗?
价格与授权条款(个人与商用)请以 LM Studio 官方网站当前页面为准,我们不在此替官方下结论。
LM Studio 和 Ollama 能同时装吗?
可以,两者互不冲突。但同时加载两个大模型会占用双份内存。
Intel Mac 能用吗?
官方系统要求页面写明暂不支持 Intel Mac。
8GB 内存的电脑能用吗?
官方说可以尝试,但要选择较小的模型并控制上下文大小。
能不能联网搜索?
LM Studio 的核心功能本地运行,联网搜索类功能是否可用以官方文档为准,我们没有逐一验证。
怎么让别的设备访问?
开启本地服务器,并按官方文档使用局域网访问;也可以参考《Open WebUI + Ollama 搭建教程》得到一个网页界面。
下一步与社区
LM Studio 上手之后,下一步通常是选更合适的模型。可以看《本地大模型推荐》。如果你卡在某一步,欢迎来社区提问(加入社区)。我们在深圳做本地大模型机器的选型、组装与实测,也可以帮你配好开箱即用的机器;先聊需求,不强制购买。