端侧大模型是什么:手机与端侧能做什么
「端侧大模型是什么意思」?简单说,就是让大语言模型直接在你手里的设备上运行——手机、平板、笔记本、AI PC,甚至汽车和摄像头——而不是把问题发到远方的数据中心再等答案回来。“端”指的是终端设备,“侧”指的是这一边。这几年手机厂商发布会上反复出现的“端侧 AI”“端云协同”,说的都是这件事。本文用通俗的方式讲清楚端侧大模型是什么、有哪些、有什么用,以及普通人如何在安卓手机上体验通义千问这类手机端本地大模型。
核对说明:厂商产品与模型信息按 2026-11 公开资料整理,各家具体机型支持情况变化很快,以官方说明为准。模型规模和性能为量级估算,不是实测。
要点速览(更新于 2026-11-05)
- 端侧大模型 = 在终端设备本地推理的模型,数据不出设备,断网也能用。
典型规模是几亿到几十亿参数,通过量化压缩到几 GB 以内。
端侧大模型有哪些:手机厂商自研模型、Gemini Nano、Apple 设备端模型,以及 Qwen、Gemma、Phi、Llama 小尺寸开源模型。
适合做摘要、改写、翻译、语音助手、照片搜索;不适合复杂推理和长篇创作。
安卓用户可以用 MNN、MLC 等开源应用在手机上跑通义千问小模型。
端侧大模型是什么意思:和云端模型的区别
我们平时用的大多数 AI 聊天服务,都是“云端模型”:你在手机上输入问题,文字被发送到服务商的服务器,由成百上千张 GPU 组成的集群计算出答案,再传回你的手机。这种方式能用上最强的模型,但离不开网络,也意味着你的内容会经过别人的服务器。
端侧大模型反过来:模型文件就存在你的设备里,计算由设备自己的芯片完成,可能是 CPU、GPU,也可能是专门为 AI 设计的 NPU(神经网络处理器)。好处是隐私、离线和低延迟;限制是设备的内存、算力和电池都有限,所以只能跑比较小的模型。
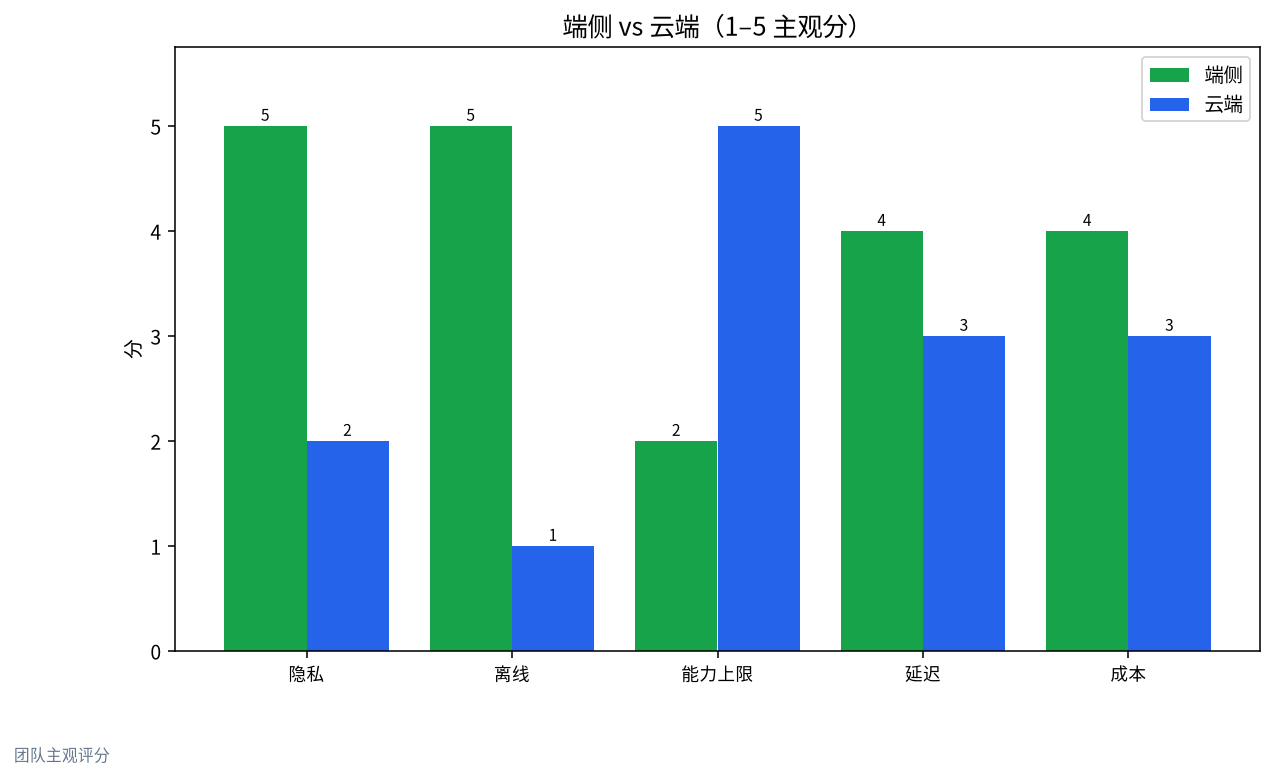
| 对比维度 | 端侧大模型 | 云端大模型 |
|---|---|---|
| 运行位置 | 手机、电脑等本机 | 服务商数据中心 |
| 模型规模 | 通常 1B–8B,量化后几 GB | 数百亿到万亿参数 |
| 是否需要联网 | 不需要 | 需要 |
| 数据隐私 | 数据不出设备 | 需信任服务商 |
| 响应延迟 | 无网络往返,首字快 | 受网络与排队影响 |
| 能力上限 | 适合轻量任务 | 复杂推理、长文创作更强 |
| 使用成本 | 一次性设备成本,耗电 | 订阅或按量计费 |
“端侧”和我们站点一直讲的“本地部署”是同一个思路,只是设备更小。在电脑上跑本地模型的完整入门,可以看 本地大模型是什么;断网能不能用的问题,可以看 离线 AI 需要联网吗。
端侧大模型有哪些
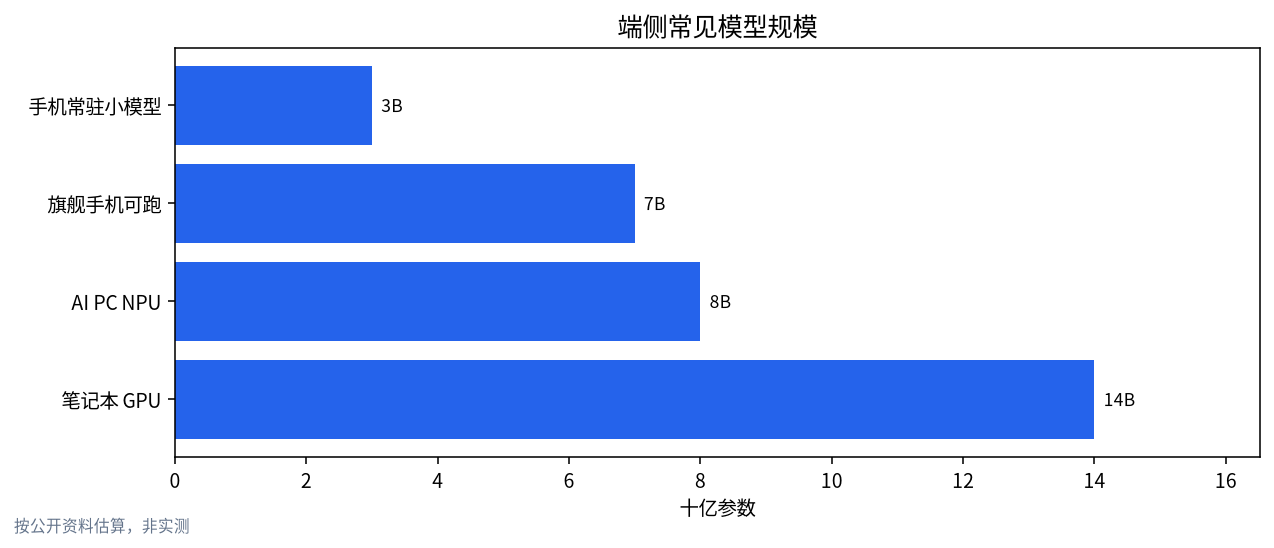
按来源大致可以分成三类:
第一类,手机和电脑厂商自研或内置的模型。 国内主流手机品牌几乎都推出了自己的端侧大模型,用于系统级的通话摘要、文本润色、图片消除和智能助手;苹果的 Apple Intelligence 在设备上运行一个约 30 亿参数级别的模型,复杂请求再交给云端;谷歌在 Pixel 和部分三星机型上提供 Gemini Nano。这类模型通常不对外开放权重,只能通过系统功能使用。
第二类,开源的小尺寸模型。 通义千问 Qwen 系列提供 0.5B 到 4B 左右的小尺寸版本,谷歌 Gemma、微软 Phi、Meta Llama 也都有适合端侧的版本。它们可以下载到手机或电脑上,用开源工具运行。选型建议见 本地大模型推荐。
第三类,AI PC 上的模型。 带 NPU 的新一代笔记本可以在低功耗下运行 7B–8B 级别的量化模型,微软 Copilot+ PC 对 NPU 算力提出了 40 TOPS 以上的门槛。NPU 是什么、有没有用,我们在 AI PC 与 NPU 解释 里专门写过;英特尔平台的情况见 英特尔显卡与 NPU 跑大模型。
| 类别 | 代表 | 能否自己下载 | 典型用途 |
|---|---|---|---|
| 厂商内置 | 各品牌手机端侧模型、Gemini Nano、Apple 设备端模型 | 一般不能 | 系统功能、助手 |
| 开源小模型 | Qwen 小尺寸、Gemma、Phi、Llama 小尺寸 | 可以 | 自建应用、离线问答 |
| AI PC 模型 | 各厂商针对 NPU 优化的版本 | 部分可以 | 办公助手、本地知识库 |
端侧大模型有什么用
很多人第一次听说端侧大模型,会觉得“小模型能干什么”。其实端侧真正擅长的,恰恰是那些频繁、轻量、又涉及隐私的任务:
- 通话与会议摘要:录音不上传,本机直接转写并提炼要点。
- 文本改写与回复建议:聊天输入法里的润色、缩写、换语气。
- 离线翻译:出国没有网络时依然可用。
- 照片与文件搜索:用自然语言搜索“去年在海边拍的照片”。
- 个人知识整理:在本机笔记上做问答,内容不出设备。
- 无障碍辅助:为视障用户描述屏幕内容,响应要求快、要求隐私。
而需要强推理、长篇写作、大量专业知识的任务,端侧小模型容易出错,更适合交给云端或家里的本地大模型主机。实际的产品大多是“端云协同”:简单的在本机处理,复杂的经用户同意后再上云。想了解电脑上有哪些好用的离线应用,可以看 最佳离线本地 AI 应用。
手机端本地大模型:硬件门槛
手机上跑大模型,最关键的不是“处理器多快”,而是内存。一个 3B 参数的模型经过 4 位量化后约 2GB,7B 约 4GB,加上系统和其他应用占用,8GB 内存的手机跑 3B 左右比较从容,12GB–16GB 内存的旗舰机才适合尝试 7B 级别。其次是芯片的 NPU 和 GPU 性能,它决定了每秒能生成多少字;最后是散热和电池,连续生成几分钟后手机发热降频很常见。
| 手机内存 | 推荐模型规模 | 体验 |
|---|---|---|
| 6GB | 0.5B–1.5B | 能跑,回答较简单 |
| 8GB | 1.5B–3B | 日常问答、改写可用 |
| 12GB | 3B–4B | 较流畅,可做摘要 |
| 16GB 及以上 | 7B–8B 量化 | 接近电脑端小模型体验,发热明显 |
我们在 手机上跑本地大模型 一文中有更详细的机型与实测思路。
通义千问安卓端部署:三种做法
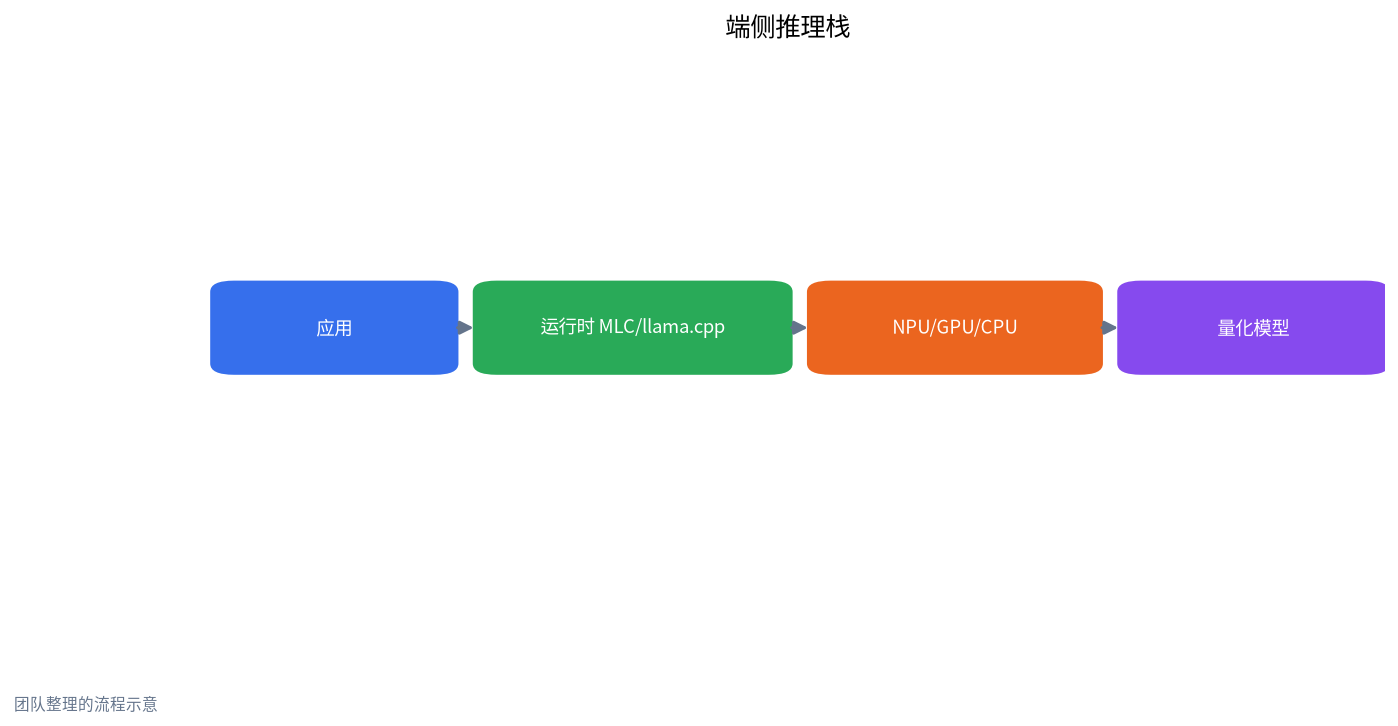
做法一:使用开源的 MNN 应用。 阿里巴巴开源的 MNN 推理框架提供了安卓端的大模型应用,可以在应用内下载 Qwen 等小尺寸模型直接对话,适合普通用户体验。请从官方 GitHub 发布页或可信应用商店获取安装包。
做法二:使用 MLC LLM 等通用框架。 MLC LLM 支持把模型编译到安卓 GPU 上运行,官方提供示例应用,也可以自己打包需要的 Qwen 模型。适合有一定动手能力的用户。
做法三:在 Termux 中运行 llama.cpp。 技术爱好者可以在安卓终端环境里编译 llama.cpp,加载 Qwen 的 GGUF 量化文件运行。灵活但门槛最高,速度通常不如前两种针对移动端优化的方案。
无论哪种做法,都请注意三点:只从官方渠道下载应用和模型,下载模型时尽量连接 Wi-Fi,并留出足够的存储空间。模型下载慢可以参考 Hugging Face 国内镜像指南。
端侧大模型的局限和误区
第一个误区是“端侧等于绝对安全”。数据不出设备确实降低了泄露风险,但应用本身是否上传日志、是否申请了不必要的权限,仍然需要你查看隐私说明。第二个误区是“端侧模型可以替代云端”。目前几十亿参数的模型在事实准确性和复杂推理上与大型云端模型仍有明显差距,重要的信息需要核实。第三个误区是“参数越大越好”。在手机上强行运行超出内存的模型,只会导致频繁闪退和严重发热,选择与设备匹配的尺寸,体验反而更好。如果你需要更强的本地能力,答案通常是在家里放一台 本地大模型电脑,手机通过局域网调用它。
常见问题(FAQ)
端侧大模型是什么意思?
指在手机、电脑、汽车等终端设备上本地运行的大语言模型,计算由设备自身完成,不依赖云端服务器,数据也不离开设备。
端侧大模型有哪些?
包括手机厂商内置的端侧模型、谷歌 Gemini Nano、苹果设备端模型,以及 Qwen、Gemma、Phi、Llama 等开源小尺寸模型。
端侧大模型有什么用?
适合摘要、改写、翻译、照片搜索、语音助手和个人笔记问答等频繁、轻量、注重隐私的任务。
手机端本地大模型需要什么配置?
主要看内存:8GB 适合 3B 左右模型,12GB–16GB 可以尝试 7B 级量化模型。芯片 NPU 和散热也会影响速度。
通义千问安卓端部署难吗?
用 MNN 这类现成应用很简单,下载应用后在应用内选择模型即可;用 MLC LLM 或 Termux 方案需要一定技术基础。
端侧模型会不会被“越狱”?
和其他模型一样存在被诱导输出不当内容的风险。本站只做科普和防护介绍,不提供绕过方法,相关内容见我们的越狱防护文章。
想交流端侧玩法?
欢迎到社区分享你的手机型号和体验,或发邮件到 admin@microaione.com。深圳团队会持续整理端侧机型与模型的搭配建议。
参考资料:MNN 开源项目、MLC LLM 文档、Gemini Nano 开发者文档、Qwen 模型主页、本站 越狱防护科普。