越狱防御怎么做:从对齐训练、分类器到权限隔离,大模型安全的分层防线
提到越狱防御,很多人第一反应是“把提示词里的危险关键词过滤掉”。这只是最浅的一层,也是最容易被绕过的一层。真正有效的防御是分层的:训练时让模型自己倾向于拒绝有害请求,推理时用独立的分类器检查输入和输出,应用层用权限隔离限制“即使被骗也做不了坏事”,再加上日志监控和持续的红队测试。这篇文章从防守方的角度,讲清每一层做什么、为什么单层不够、有什么代价、会怎样失效,并用一个概率算例说明“分层”的价值和陷阱。它是我们大模型越狱与安全专题的一部分;如果你对越狱本身的含义和攻击类别还不清楚,先读大模型越狱是什么。本站不发布任何绕过方法,所以这篇只讲防守。
要点速览(更新于 2026-11-04)
- 没有银弹:对齐训练、输入输出分类器、权限隔离、监控和红队测试要叠加使用。
Anthropic 的自测:加上 Constitutional Classifiers 后,10,000 条合成越狱提示的成功率从 86% 降到 4.4%;代价是改进版分类器让真实对话的拒答率上升约 0.38%,推理开销增加约 23.7%。
分层防御的价值取决于各层是否独立:三层各拦 90%,独立时漏过 0.1%,高度相关时可能漏过 2.5%(本文假设数字)。
对本地部署的模型,没有厂商替你加外层过滤,要自己加护栏,见 Llama Guard 与 Qwen3Guard 本地部署。
对带工具的应用,限制权限比拦截提示词更可靠:即使模型被诱导,也只能做它被允许做的事。
越狱防御的基本思路:为什么必须分层
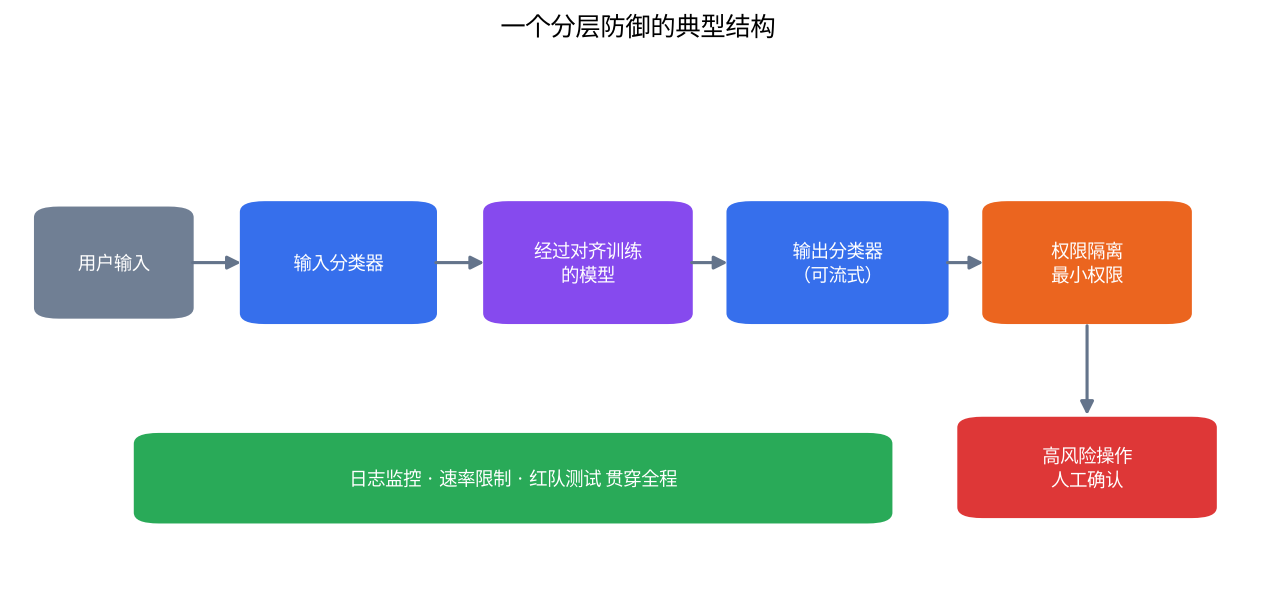
越狱防御要面对一个不对称的事实:攻击者只要找到一种绕过方式就够了,防守者却要覆盖所有方式。2023 年 Wei 等人的分析指出,安全训练的失效有“目标冲突”和“泛化不匹配”两种模式(见我们的总览文章),这意味着单靠训练很难做到滴水不漏。所以工程上的做法是纵深防御:每一层都不完美,但叠加之后,攻击需要同时绕过多层。
下图是一个典型的分层结构。
| 层次 | 做什么 | 能拦住什么 | 典型失效方式 | 主要代价 |
|---|---|---|---|---|
| 训练层:对齐训练 | 通过监督微调、偏好优化等让模型倾向拒绝有害请求 | 直白的有害请求 | 换一种包装或表达,覆盖不到的分布 | 训练成本,可能增加过度拒答 |
| 训练层:电路断路器等表征干预 | 在模型内部的表征层面打断有害输出的生成 | 一部分对输入形式不敏感的攻击 | 仍可能被新型攻击绕过,并可能影响能力 | 研究阶段,需要专门训练 |
| 输入分类器 | 在请求进入模型前判断是否违规 | 明显违规的请求、已知的攻击模式 | 误判、被改写绕过 | 额外推理开销、延迟 |
| 输出分类器 | 在回答返回前检查,可流式逐段检查 | 模型已被诱导后产生的有害输出 | 漏判;流式检查可能中途才发现 | 额外开销,可能打断正常回答 |
| 系统提示与角色约束 | 在对话前给出规则 | 低强度的诱导 | 容易被后续输入覆盖 | 几乎为零 |
| 权限隔离与最小权限 | 限制模型能调用的工具、能访问的数据 | 提示词注入、越权操作 | 配置错误,权限过大 | 开发与运维成本 |
| 监控、速率限制与封禁 | 发现异常使用模式,限制重试 | 自动化的大批量尝试 | 低频的精细攻击 | 日志与隐私合规 |
| 红队测试与评估 | 持续用攻击集检验 | 发现新漏洞 | 覆盖不全 | 人力 |
训练层:让模型自己倾向于拒绝
对齐训练是最基础的一层:通过人类或 AI 的反馈,让模型对有害请求倾向于拒绝,对无害请求保持有用。它的局限在于训练分布有限;越狱研究的核心发现就是“换一种说法,防线可能就不起作用”。
表征层面的干预是近年的研究方向。例如 Zou 等人在 2024 年提出的电路断路器(Circuit Breakers),思路是在模型内部检测到有害输出的表征倾向时直接打断,而不是依赖输出表面的拒绝措辞。这类方法试图让防御对攻击的输入形式不敏感,但仍属于研究和早期应用阶段,不能当成万能方案。
训练层还有一个重要权衡:过度拒答。训练得越保守,越容易把无害请求也拒掉。所以防御的评价指标不能只看“拦住了多少攻击”,还要看“误伤了多少正常请求”,这也是我们在 Qwen 本地部署需要破甲吗里提倡用自己的任务评估拒答率的原因。
推理层:独立的分类器
训练层的限制写在权重里,攻击者可以反复试探;而独立的分类器是另一套参数,可以按需更新,并且可以对输入和输出分别把关。
输入分类器在请求进入主模型前判断是否违规,适合拦截明显违规和已知攻击模式。输出分类器检查模型的回答,能处理“输入看起来无害、输出却有害”的情况。更先进的做法是流式检查:模型边生成边检查,一旦发现违规就立即停止,避免等回答完整生成后才发现。Anthropic 的 Constitutional Classifiers 研究就采用了这种思路:用一套书面的“宪法”规则生成大量合成训练数据,训练输入和输出分类器。
开源社区也有现成的护栏模型,例如 Meta 的 Llama Guard,阿里的 Qwen3Guard(提供流式版本和三级严重度标签),以及 OpenAI 的 gpt-oss-safeguard(可在推理时按自带政策判断)。它们的部署方法、显存需求和选择方法,我们放在 本地护栏部署教程里。
应用层:限制权限比拦截更可靠
OWASP 把提示词注入列为大模型应用的第一大风险。对带检索、带工具的应用,攻击者不必“越狱”模型,只要把恶意指令藏进网页或文档,模型读到后就可能照做。这时靠过滤提示词很难可靠,更有效的是让被骗之后的后果有限:
- 最小权限: 只给模型完成任务必需的工具和数据访问,不给全局密钥。
- 人工确认: 对高风险操作(转账、删除、发送外部消息)要求人工确认。
- 隔离不可信内容: 把检索到的外部内容标记为数据而非指令,并限制它能触发的动作。
- 输出过滤: 防止模型把敏感数据通过链接或工具调用带出去。
本地部署如果对外提供接口,还要做好认证和审计,见 本地 API 服务器指南。
一个概率算例:分层的价值与陷阱
假设有三层防御,每层都能拦下 90% 的攻击尝试(数字是我们为说明而设的,不是实测)。
- 只有一层: 漏过 10%。
- 三层完全独立: 漏过 0.1 × 0.1 × 0.1 = 0.001,即 0.1%。
- 三层相关: 假设能绕过第一层的攻击,有 50% 的概率也能绕过第二层,再有 50% 的概率绕过第三层,则漏过 0.1 × 0.5 × 0.5 = 0.025,即 2.5%。
| 情形 | 算式 | 漏过比例 |
|---|---|---|
| 单层 | 1 − 0.9 | 10% |
| 三层完全独立 | 0.1 × 0.1 × 0.1 | 0.1% |
| 三层相关(50% 连带失效) | 0.1 × 0.5 × 0.5 | 2.5% |
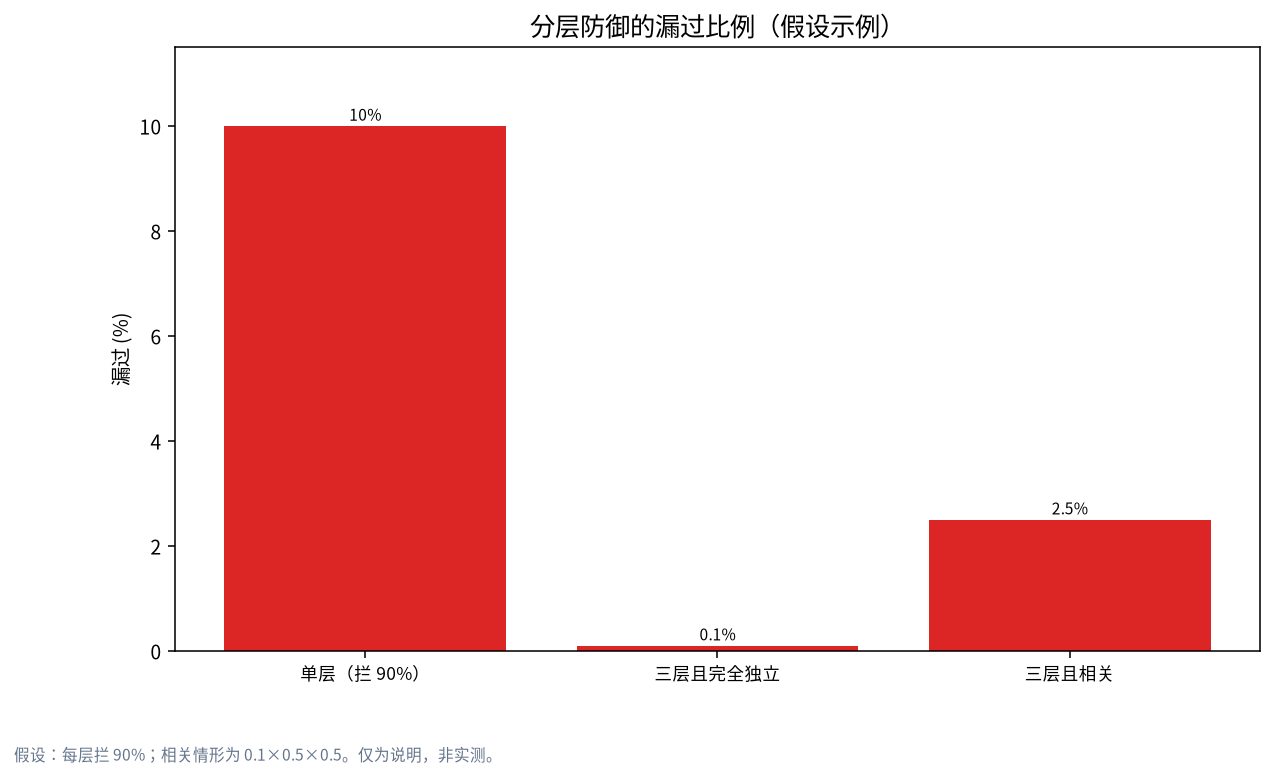
这个算例说明:分层的价值取决于各层是否真的独立。如果三层都用同一套训练数据、同一类模型,它们会在相似的地方失效,叠加的收益就大打折扣。所以工程上要让各层“长得不一样”:不同的训练数据、不同的模型、不同的机制(规则加模型加权限)。
防御的代价:算一算开销
防御不是免费的。Anthropic 报告的改进版分类器在 5,000 条真实对话上让拒答率上升约 0.38%(该差异在统计上不显著),推理计算开销增加约 23.7%。
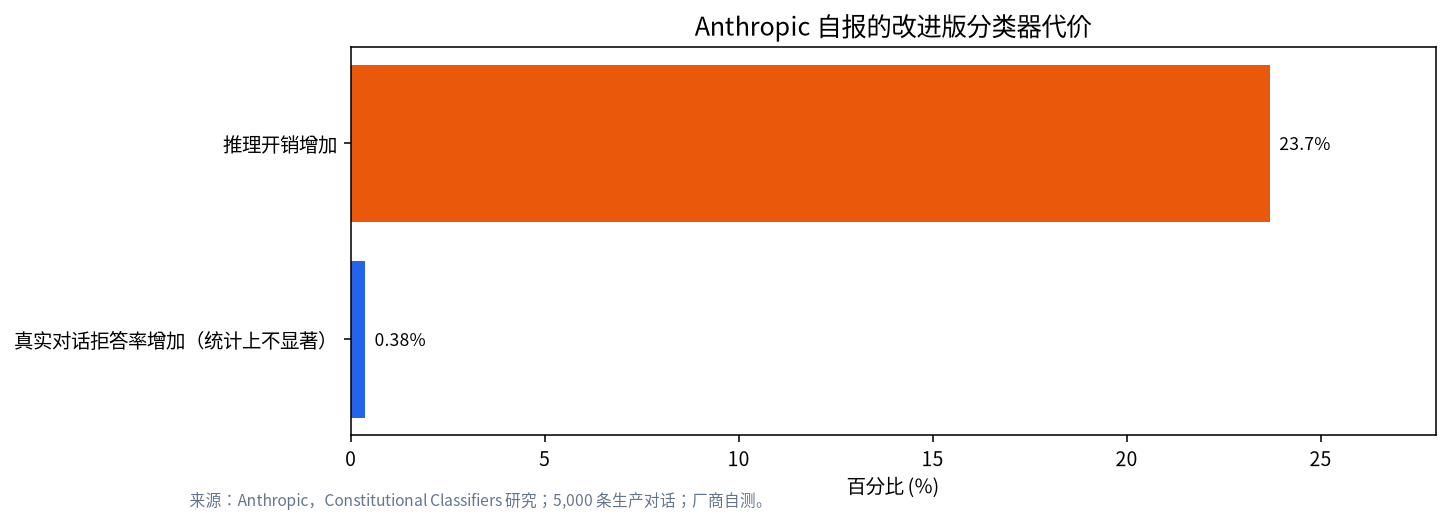
用这两个数字做个粗算:如果你的服务每月处理 100 万次对话,拒答率上升 0.38% 意味着约 3,800 次额外拒答;计算开销增加 23.7% 意味着,原本每月 1,000 元的推理成本会增加约 237 元。你要权衡的是:这点误伤和成本,和被越狱一次带来的风险相比是否值得。在本地部署里,护栏模型的开销可以按参数量粗算:用 0.6B 的小护栏守护 27B 的主模型,参数量只有约 2.2%;用 8B 的护栏则约 30%。这只是粗略比例,实际取决于输入输出长度与实现。
如何评估你的防御有没有用
- 用公开基准: 例如 HarmBench 这样的标准化评测框架,可以在隔离环境里度量攻击成功率;
- 同时测误伤: 用一批无害但“看起来敏感”的请求测拒答率;
- 持续回归: 每次更新模型、护栏或系统提示后重跑;
- 做红队: 见 本地模型红队测试入门。
注意,评估要在受控环境里做,用公开的评测集,结果只用于改进防御,不要用来研究如何伤害他人。
个人和小团队怎么落地
- 先选模型: 优先选经过对齐训练且有安全文档的模型。
- 加护栏: 对外提供服务时,在输入和输出两端各加一个分类器。
- 限权限: 带工具的应用按最小权限配置。
- 留日志: 记录被拦截的请求,注意隐私合规,见 本地大模型与隐私。
- 定期测: 每次变更后用同一套评测集回归。
对于模型权重被改动的情况(例如社区的“无审查版”),护栏尤其重要,因为模型自身的那一层已经被削弱,见 拒绝方向消融原理详解。关于攻防如何一路演变,见 大模型越狱简史。
常见问题 FAQ
越狱防御最有效的一层是什么?
没有单一最有效的一层。对话类应用,对齐训练加输入输出分类器是基础;对带工具的应用,最小权限往往比任何提示词过滤都更可靠。
输入过滤关键词能防住越狱吗?
很难。关键词过滤容易被改写绕过,也容易误伤;更可靠的是用语义分类器,并叠加输出检查和权限限制。
加了分类器会不会让模型变笨?
分类器是独立的模型,不改变主模型的能力;它的代价是延迟、算力和可能的误拦。Anthropic 报告的改进版在其测试中拒答率仅上升约 0.38%,但这只代表其测试条件。
本地部署的模型需要做越狱防御吗?
只给自己用时可以简化;一旦给其他人使用或接入业务,建议至少加输入输出审核和权限限制。
提示词注入和越狱的防御一样吗?
不完全一样。越狱防御偏重让模型守住自己的安全规则;提示词注入防御偏重隔离不可信内容和限制权限。
怎么知道防御有没有被绕过?
靠持续的红队测试、公开基准和日志监控;同时记录误伤,避免为了拦截而牺牲可用性。
和我们聊聊
如果你在为团队的本地模型设计护栏,欢迎把场景和部署方式发到社区或邮件 admin@microaione.com,我们可以一起梳理需要哪几层。更多相关文章见大模型越狱与安全专题。
参考资料:Anthropic Constitutional Classifiers(arXiv 2501.18837)、Zou 等,Circuit Breakers(arXiv 2406.04313)、Llama Guard(arXiv 2312.06674)、HarmBench(arXiv 2402.04249)、OWASP LLM01。数据读取于 2026-11-04,北京时间。
同专题新文:提示词注入与越狱的区别;拒答率评测详解;企业大模型内容安全清单