手机本地大模型:在安卓或 iPhone 上离线运行,AI Edge Gallery、MLC Chat 与 Termux(2026)
现代手机有很快的芯片、几 GB 的内存和大量存储,所以很自然会问:它能不能完全不联网地运行语言模型?答案是可以,但有限制。手机本地大模型 对简短的提问、改写、翻译和小段文字的总结效果不错,而且很私密,因为没有任何内容离开设备。它比不上桌面显卡,还会让手机发热。这篇文章列出五条实用路线,从现成应用到自己开发,估算手机内存能放下多大的模型,并给出发热、电量和隐私方面的建议。如果这些名词还很陌生,请先读《什么是本地大模型》。
核对说明:关于 Google AI Edge Gallery 的事实(开源、离线、Android 12 及以上、iOS 17 及以上、聊天、智能体技能和模型导入)来自其 GitHub README,MediaPipe 与 Gemma 移动端的事实来自 Google AI for Developers 文档。MLC LLM 的事实来自其文档,Termux 路线来自 llama.cpp 的 Android 文档,均于 2026-10-30 核对。我们没有测试任何手机,所以不给出速度。模型大小是根据 llama.cpp 公布的 Q4_K_M 大小外推的估算。
要点速览(更新于 2026-10-30)
- 最简单的路线是现成应用,比如 Google AI Edge Gallery;模型下载完成后不需要联网。
选小模型,大多数手机大约 1B 到 4B 参数,并按经验让文件小于内存的一半左右。
预计会发热和耗电:短时间使用,把手机当作方便的工具,而不是 PC 的替代品。
为什么要用手机本地大模型
有三个诚实的理由。隐私:提示词和文档留在设备上。可用性:在隧道里、飞机上或没有信号的地方也能用。成本:没有按 token 计费。也有诚实的限制:手机芯片与操作系统和其他应用共享内存,持续的重负载会让设备降频,而能放下的模型都很小。小模型对日常任务有用,但在困难的推理或长文档上能力较弱,所以期望要现实。
五条路线,从简单到进阶
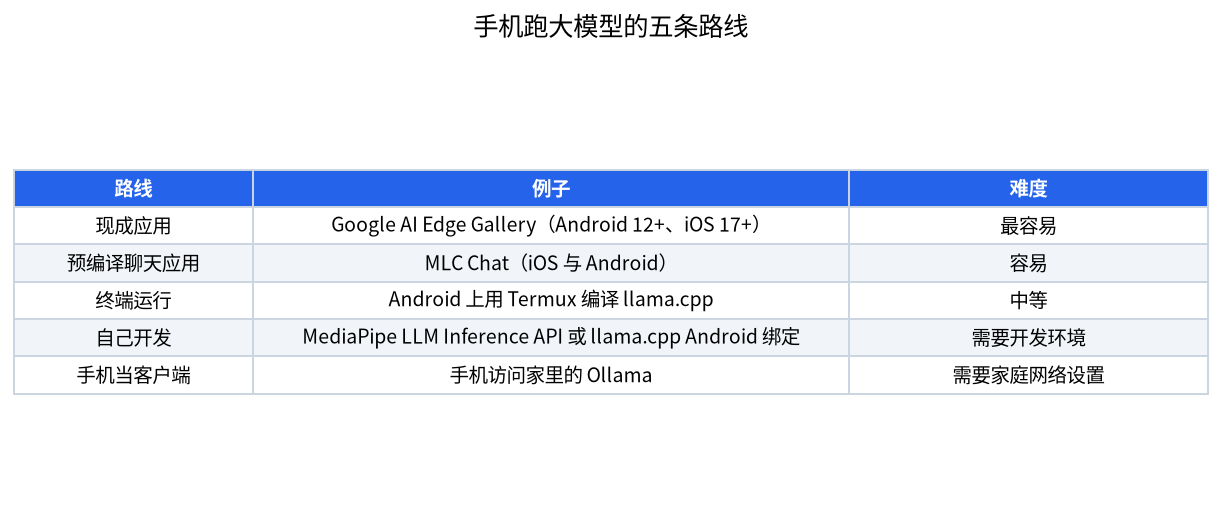
| 路线 | 例子 | 适合 | 主要限制 |
|---|---|---|---|
| 现成应用 | Google AI Edge Gallery | 几分钟内试用一个模型 | 限于支持的模型和功能 |
| 预编译聊天应用 | iOS 和 Android 上的 MLC Chat | 与多个开源模型聊天 | 模型列表取决于应用版本 |
| 终端运行 | Android 上 Termux 里的 llama.cpp | 学习和写脚本 | 要在手机上编译和敲命令 |
| 自己开发 | MediaPipe LLM Inference API、llama.cpp Android 绑定 | 给应用加入 AI 的开发者 | 需要 Android Studio 或 Xcode |
| 手机当客户端 | 手机访问家里 PC 上的 Ollama | 在家里任何地方用大模型 | 需要家庭网络和安全设置 |
路线 1:Google AI Edge Gallery
项目的 README 把它描述为一个在设备上运行开放模型的开源应用,下载之后完全离线且私密。它要求 Android 12 及以上或 iOS 17 及以上,可以从 Google Play 或 App Store 安装;没有 Google Play 的用户可以从最新发布页安装 APK。README 列出的功能包括带语音输入的 AI 聊天、可以调用工具的智能体技能,以及导入自己的模型。Google 的 Gemma 文档也把这个应用当作试用 MediaPipe LLM Inference API 和导入自己任务包模型的方式。对大多数读者来说这是第一个该试的:安装它,在 Wi-Fi 下下载一个小的 Gemma 模型,然后打开飞行模式开始聊天。
路线 2:MLC Chat
MLC LLM 提供 iOS 和 Android 的预编译应用,也记录了如何从源代码构建。Android 文档说你需要 Rust、带 NDK 和 CMake 的 Android Studio,以及一部真机,因为不支持模拟器。如果只想聊天,就用预编译应用。如果想把权重打包进应用,项目文档提供了相应的设置,但这是开发者的任务。
路线 3:Termux 里的 llama.cpp
llama.cpp 的 Android 文档描述了在 Termux 里构建命令行工具,Termux 是一个不需要 root 的终端模拟器。你安装几个软件包,按普通的构建说明用 CMake 构建,下载一个 GGUF 模型,运行 llama-cli。文档建议把模型放在你的主目录里以获得最佳性能,并从 4096 这样适中的上下文开始,否则内存可能飙升并杀死你的终端。它还描述了一个带硬件加速的 Android 应用绑定,在 Arm 上最高到 SME2。这条路线能让你学到很多,但设置较慢。关于格式的背景,请看《GGUF 与 llama.cpp 入门》。
路线 4:自己开发
开发者可以使用 MediaPipe LLM Inference API,Google 为 Android 和 iOS 提供了文档,描述它是用于设备端文本生成的封装,比如信息检索、起草邮件和文档总结。llama.cpp 的 Android 绑定是开源的替代方案。两者都需要开发环境,而且超出了大多数读者的需要。
路线 5:把手机当客户端
有时最好的“手机大模型”根本不在手机上。如果你在家里的 PC 上运行 Ollama,同一 Wi-Fi 下的手机可以通过网页界面使用它,见《Open WebUI 搭建指南》。Ollama 默认只监听本机,所以在网络上暴露它需要刻意的配置和认证,其文档对此有说明。这条路线能给你比手机放得下的大得多的模型,但只有连着家里网络时才能用,除非你自己设置好安全的远程访问。
手机能跑多大的模型
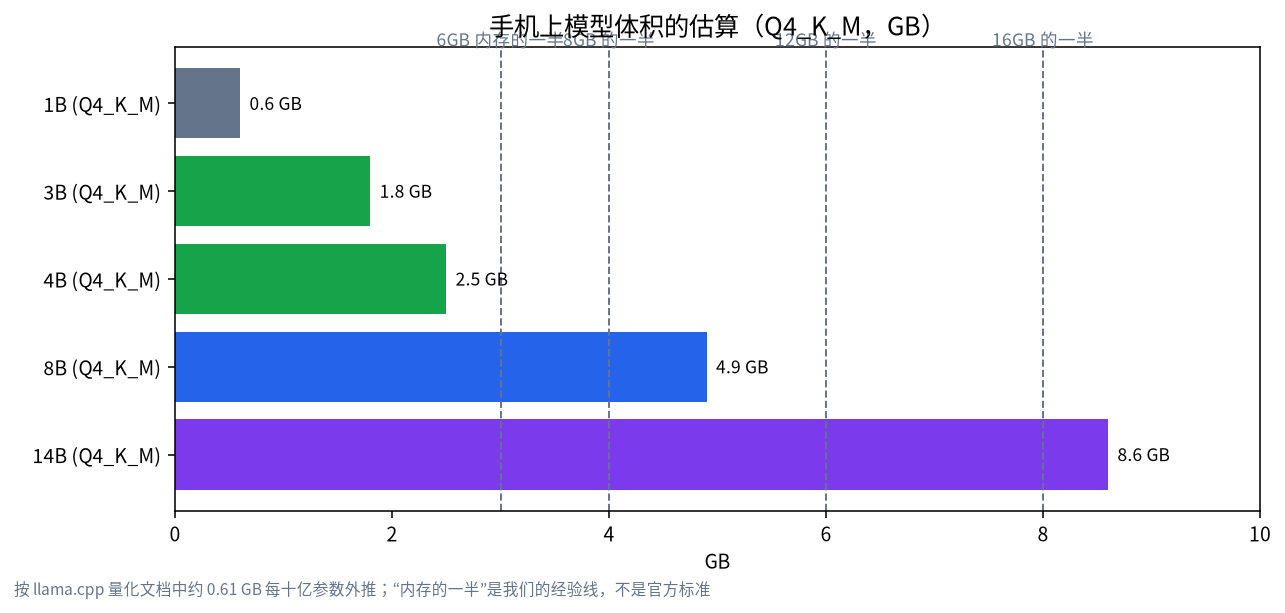
内存是限制。llama.cpp 文档列出 Llama 3.1 8B 的 Q4_K_M 约 4.9GB,折合约每十亿参数 0.61GB。据此外推,1B 模型约 0.6GB,4B 模型约 2.5GB,8B 模型约 4.9GB。手机必须同时容纳文件和上下文所需的工作内存,而操作系统和其他应用也需要内存。按经验,让模型文件小于内存的一半左右。按这个规则,8GB 内存的手机运行大约 4B 以内的模型比较从容,而 12GB 到 16GB 的手机可以在短上下文下试 8B。这是我们的经验线,不是官方限制,实际结果取决于应用和操作系统。
| 手机内存 | 比较从容的模型大小(经验线) | 示例想法 |
|---|---|---|
| 6GB | 1B 到 3B | 快速提问、改写 |
| 8GB | 大约 4B 以内 | Gemma e2b 或 e4b 级别,见《Gemma 部署指南》 |
| 12GB | 大约 7B 以内 | 短文档 |
| 16GB | 大约 8B 以内 | 仅限短上下文 |
量化也很重要:Q4 文件比原始文件小得多,这就是手机能运行这些模型的原因,见《Q4_K_M 详解》。在 PC 上用公式估算内存的方法,请看《显存计算器指南》。
发热、电量与实用建议
运行模型会让芯片一直忙碌,所以手机会发热,电量消耗比平常快。短时间使用,避免阳光直射,重负载使用时不要充电,开始之前关闭其他应用。如果几分钟后速度下降,手机多半是在降频控制温度。下载模型很大,请在 Wi-Fi 下进行,并先检查可用存储。保持上下文简短:长对话占用更多内存,也会变慢。
隐私:“离线”到底意味着什么
只有当应用不同时向服务器发送数据时,离线运行才保护你的提示词。开源应用让你可以检查它做了什么;对于闭源应用,请阅读隐私政策,并在飞行模式下测试。语音输入和一些智能体功能可能使用额外的组件或网络,所以请测试你依赖的每个功能。模型本身只下载一次,你应当从应用自带的列表或可信来源获取,因为手机上同样需要像 PC 上那样注意供应链安全。
常见错误
- 选的模型太大:应用崩溃或手机卡死;从 1B 到 4B 开始。
- 用移动数据下载:模型很大;用 Wi-Fi。
- 用 PC 的标准评判:手机上的小模型是方便工具,不是工作站。
- 一直开着:发热和电池损耗;用完关闭应用。
- 忘了存储:几个模型很快就会占满手机。
- 随意暴露家里的服务器:如果把手机连到家里的 Ollama,要保持认证开启,不要把端口开放给互联网。
什么时候手机是错误的工具
如果你需要处理长文档、写长文章,或运行推理能力强的模型,手机就是错误的工具。即使是一台配 12GB 显卡的普通台式机,也能运行比手机放得下的大好几倍的模型,持续速度也好得多。手机适合短的、私密的、随身的任务:翻译一个路牌、总结你复制的一段话、起草一条短消息,或在没有信号的地方快速提问。合理的做法是两者并用:在手机上保留一个小模型图方便,在家里的机器上放一个更大的,通过路线 5 的设置访问,用于较重的任务。选择家用机器请看《本地部署指南》。
一次简单的上手体验
如果今天就想试,留出二十分钟。连上 Wi-Fi,确认有几 GB 的可用存储,安装 Google AI Edge Gallery 这样的现成应用,选择它提供的最小模型之一。下载完成后,打开飞行模式问几个简短的问题,这样你就知道在没有网络的情况下设置也能用。然后试一个你真正有的任务,比如改写一段话或翻译一个短语,并留意答案与云端助手相比如何。注意手机变得多热,十分钟的使用耗了多少电。这样的体验比任何规格表都更能告诉你手机模型对你是否有用,而且除了一些存储空间之外不花任何钱。
常见问题
真的能在没有网络的手机上运行大模型吗?
可以,在模型下载之后。Google AI Edge Gallery 这样的应用在设备上运行模型,并说明了离线使用。
我需要什么手机?
Google AI Edge Gallery 列出 Android 12 及以上和 iOS 17 及以上。内存越多能用越大的模型;按经验让模型文件小于内存的一半。
应该选多大的模型?
从大约 1B 到 4B 参数的模型开始。Gemma 的小型边缘模型是常见选择;大小请看我们的 Gemma 指南。
速度有多快?
我们没有测试手机,所以不给数字。速度取决于芯片、模型、量化和应用,手机发热时还会下降。
私密吗?
模型在设备上运行,但请查看应用的隐私政策并在飞行模式下测试功能,因为有些功能可能用到网络。
手机能用我家里电脑上的模型吗?
可以,通过连接到家庭网络里 Ollama 的网页界面。保持认证开启,不要把服务暴露给公共互联网。
告诉我们哪些有效
如果你试过手机模型,欢迎告诉我们对你有效的手机、应用和模型。加入社区,或发邮件到 admin@microaione.com。
参考:Google AI Edge Gallery(GitHub)、移动设备上的 Gemma(Google AI for Developers)、MLC LLM Android 文档、llama.cpp Android 指南。