Was ist Strata? Warum diese lokale LLM-Engine viral ging und wie sie sich von Ollama unterscheidet
Aktualisiert 2026-11-04. Dieser Artikel wertet öffentliche Quellen aus. Wir haben Strata weder installiert noch selbst einen Benchmark ausgeführt.
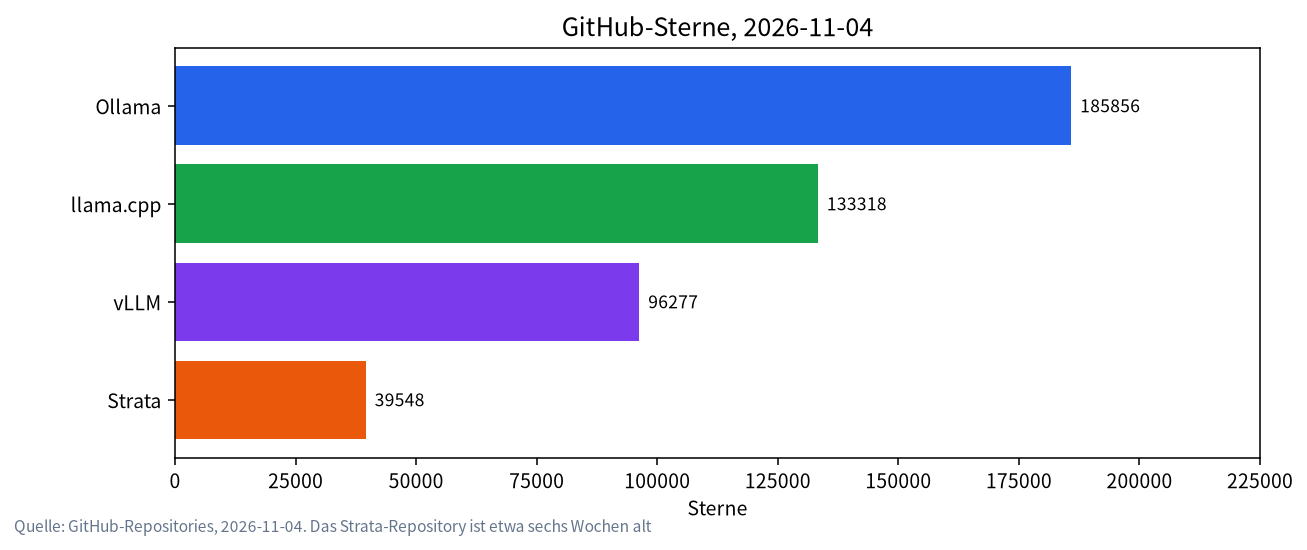
Was ist Strata? Es ist eine quelloffene Inferenz-Engine, als Desktop-App und Terminal-Werkzeug ausgeliefert, mit einer Grundidee: ein sehr großes Mixture-of-Experts-Modell (MoE), etwa das Qwen3.8-Flash-Next mit 125 Milliarden Parametern, auf einem normalen Gaming-PC laufen zu lassen, indem das Modell auf Grafikkarte, Arbeitsspeicher und SSD verteilt wird. Etwa sechs Wochen nach dem Anlegen des Repositorys hat es rund 39.500 GitHub-Sterne, und fast jedes Forum für lokale LLMs hat einen Thread dazu. Wir erklären, was Strata ist, warum es sich so schnell verbreitete, was unabhängige Tester gemessen haben und wo die Vorbehalte liegen. Es steht neben Ollama und ersetzt es nicht; den Vergleich finden Sie in unserem Artikel Strata vs Ollama.
Was ist Strata, in einem Absatz
Strata ist auf GitHub unter der MIT-Lizenz veröffentlicht, das Repository ist überwiegend in C++ geschrieben. Es wird als Desktop-App (Windows, Linux-AppImage, macOS) oder als Terminal-Werkzeug installiert, das Sie mit strata launch starten. Läuft ein Modell, stellt es auf Ihrem eigenen Rechner eine OpenAI-Chat-Completions-API, eine Anthropic-Messages-API und eine Responses-API bereit, sodass sich Coding-Werkzeuge verbinden können. Die Dokumentation nennt ggml, die Tensor-Bibliothek hinter llama.cpp, als Komponente von Dritten, aber die Planung, die Strata besonders macht, ist eigenständig.
| Punkt | Wert am 2026-11-04 | Quelle |
|---|---|---|
| Repository angelegt | 2026-09-24 | GitHub |
| Sterne / Forks | 39.548 / 4.298 | GitHub |
| Neueste Version | v0.2.10 (2. Nov. 2026, UTC) | GitHub-Releases |
| Lizenz der Engine | MIT | Repository |
| Lizenz des Modells | Die Gewichte von Qwen3.8-Flash-Next stehen unter der Qwen Community License 1.0, nicht MIT | Projektdokumentation |
| Standard-Adresse lokal | http://127.0.0.1:8080 |
Installationsanleitung |
| Telemetrie | Laut Projekt keine und kein Konto | Sicherheitsdokument |
| Externes Sicherheitsaudit | Laut demselben Dokument noch nicht | Sicherheitsdokument |
Die Modelle, die Strata ausführt
Ein Mixture-of-Experts-Modell hat viele spezialisierte Teilnetze („Experten“) und nutzt pro Token nur wenige. Qwen3.8-Flash-Next hat insgesamt etwa 125 Milliarden Parameter, aber nur rund 6 Milliarden sind pro Token aktiv (512 Experten pro Schicht, insgesamt 24.576, und ein natives Kontextfenster von 262.144 Token). Dieses Verhältnis – etwa 5 % der Gewichte pro Token – nutzt Strata aus.
| Modell | Größe | Was die Dokumentation sagt |
|---|---|---|
| Qwen3.8-Flash-Next | 125B gesamt, ~6B aktiv | Vier Quantisierungen mit 37,6 GB (Q2_0), 39,2 GB (IQ2_XS), 47,0 GB (IQ3_XXS) oder 54,8 GB (IQ3_S) RAM plus VRAM |
| Qwen3.6-35B-A3B | 35B gesamt, ~3B aktiv | Unsloth-Pakete, 32 bis 52 GB RAM |
| DeepSeek V4.1-Flash | Sehr groß | 239 bis 274 GB Download, 12-GB-GPU, 46 bis 64 GB RAM; siehe unseren Artikel zu DeepSeek V4.1 Flash mit 12 GB |
Warum sich MoE-Modelle so verhalten, erklärt unser MoE-Leitfaden.
Wie Strata funktioniert: drei Ebenen
Das HOW_IT_WORKS-Dokument von Strata beschreibt drei Ebenen.
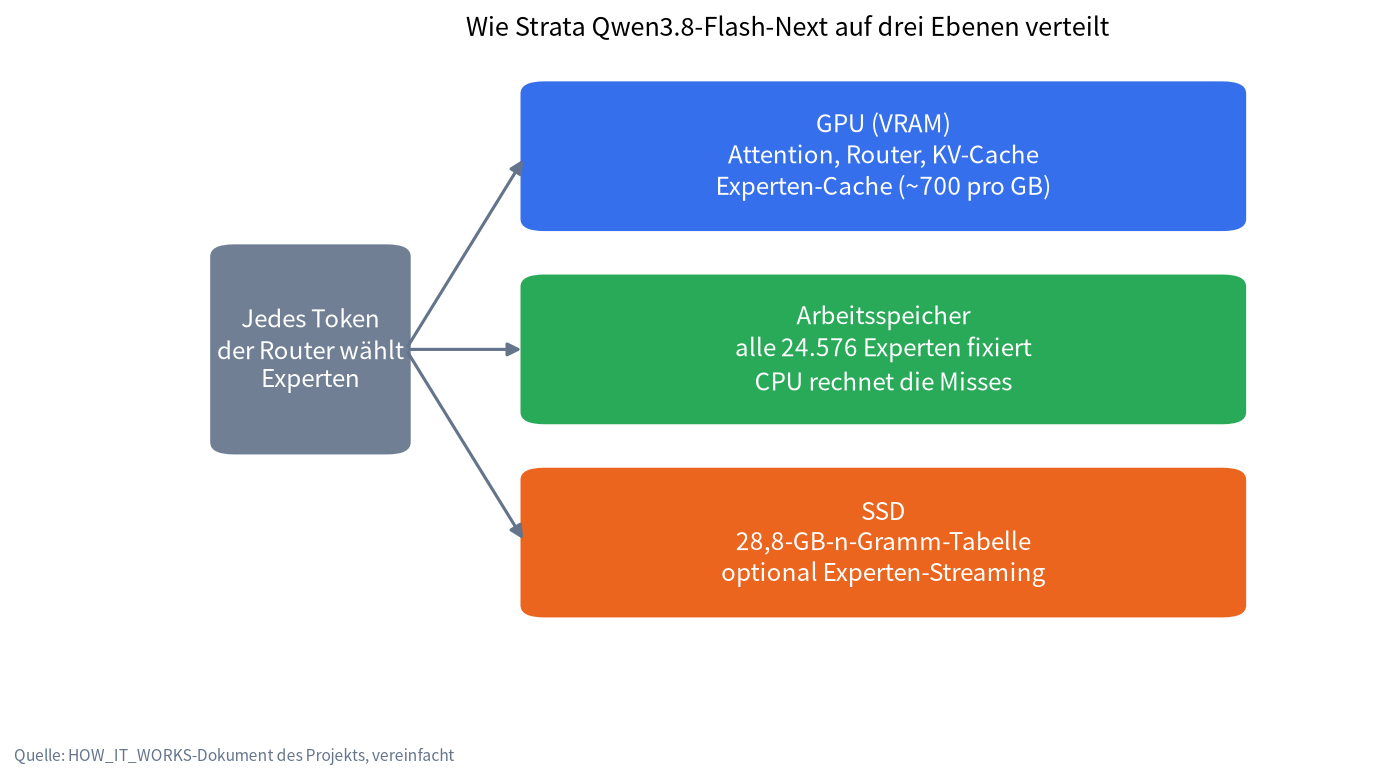
- GPU. Attention-Schichten, Router, gemeinsame Experten, der Ausgabekopf, die Entwurfsschicht für Multi-Token-Prediction (MTP), der KV-Cache und ein Expertencache, der den restlichen VRAM füllt. Laut Dokumentation fasst jedes zusätzliche Gigabyte VRAM etwa 700 weitere Experten.
- RAM. Alle 24.576 Experten, im Speicher fixiert. Wählt der Router einen Experten, der nicht im VRAM liegt, rechnet ihn die CPU an Ort und Stelle, statt ihn auf die Karte zu kopieren.
- SSD. Eine 28,8 GB große n-Gramm-Embedding-Tabelle, von der pro Token nur wenige Zeilen gelesen werden. Ein optionaler Modus
--mmap-expertskann bei knappem RAM auch Experten von der Platte streamen; das funktioniert, ist aber deutlich langsamer.
Das Tempo hängt dann davon ab, wie oft die Experten, die ein Token braucht, schon auf der GPU liegen. Der Test von PC Watch auf einer RTX 3060 meldete mit der Datei IQ2_XS etwa 3.031 Experten auf der Karte und eine Cache-Trefferquote von rund 72 %, mit IQ3_S etwa 1.104 Experten und 56 %. Das Paper des Projekts schreibt der spekulativen MTP-Dekodierung eine Beschleunigung um das 1,6- bis 1,8-Fache zu; diese Zahl stammt von den Autoren selbst.
Warum Strata viral ging
Nach den Quellen, die wir gelesen haben, kamen mehrere Dinge zusammen:
- Installation mit einem Klick. Ein Windows-Installer, ein Linux-AppImage und ein macOS-Disk-Image sowie ein Einzeiler-Installer fürs Terminal. Die Engine für Ihre GPU wird beim ersten Start geladen.
- Eine Schlagzeile zum Weitererzählen. „Ein 125B-Modell auf einer 12-GB-Grafikkarte“ lässt sich leicht teilen, obwohl das Gesamtbild für die größeren Quantisierungen 64 GB RAM verlangt.
- Das Timing. Qwen3.8-Flash-Next war schon im Oktober das Modell, über das alle sprachen.
- Unterstützung für Coding-Agenten.
strata connectschreibt die Konfiguration für Claude Code, Codex CLI, OpenCode, Hermes Agent, OpenClaw und andere. - Ein hohes Release-Tempo. Sechs Releases zwischen dem 25. Oktober und dem 2. November.
- Aufmerksamkeit auf Hacker News. Ein Thread hatte beim Lesen 940 Punkte und 420 Kommentare, und ein zweiter beklagte, dass Diskussionen über lokale LLMs mit Strata-Links überflutet würden. Zum Haupt-Thread.
Was unabhängige Tester gemeldet haben
Keine der folgenden Zahlen stammt von uns. Sie kommen von verschiedener Hardware, Strata-Versionen und Quantisierungen; nehmen Sie sie als Spanne, nicht als Rangliste.
| Quelle | Hardware | Modell und Quantisierung | Gemeldetes Ergebnis |
|---|---|---|---|
| Community-Benchmark von Strata (v0.1.41) | RTX 3060 12 GB, DDR4-3200 | Q2_0 / IQ2_XS / IQ3_XXS | 42,9 / 45,5 / 26,2 tok/s Generierung bei 4.096 Token Prompt |
| PC Watch (v0.1.38) | RTX 3060 12 GB, Core i9-12900, 64 GB DDR4 | IQ2_XS; IQ3_S | 34 bis 44; 25 bis 32 tok/s. Etwa 7 s bis zum ersten Token bei 5,9k Token Prompt, etwa 25 s bei 23k |
| note.com, usshi_it | RTX 3060 12 GB, Ryzen 5 3600, 48 GB | Q2_0 | 44,49 tok/s Generierung, 326,68 tok/s Prefill, 1,60 s bis zum ersten Token |
| Siddhant Dembi | RTX 3060 in einer Proxmox-VM, etwa 50 GiB RAM | IQ3_S | Etwa 36 bis 38 tok/s; ein Reasoning-Budget war nötig, um endloses Nachdenken zu vermeiden |
| AkitaOnRails | RTX 5090 | IQ3_S | Etwa 159 tok/s und 91 Punkte im eigenen Coding-Benchmark des Autors |
| arm1.ru | RTX-5080-Laptop, 30 GB RAM | Flash-Next gegen Qwen3.8-27B in llama.cpp | Ähnliche Coding-Qualität; Strata nutzte etwa 21 GB RAM, lagerte 4 bis 5 GB in den Swap aus und las in einem 1,3-stündigen Lauf etwa 6,9 TB von der SSD |
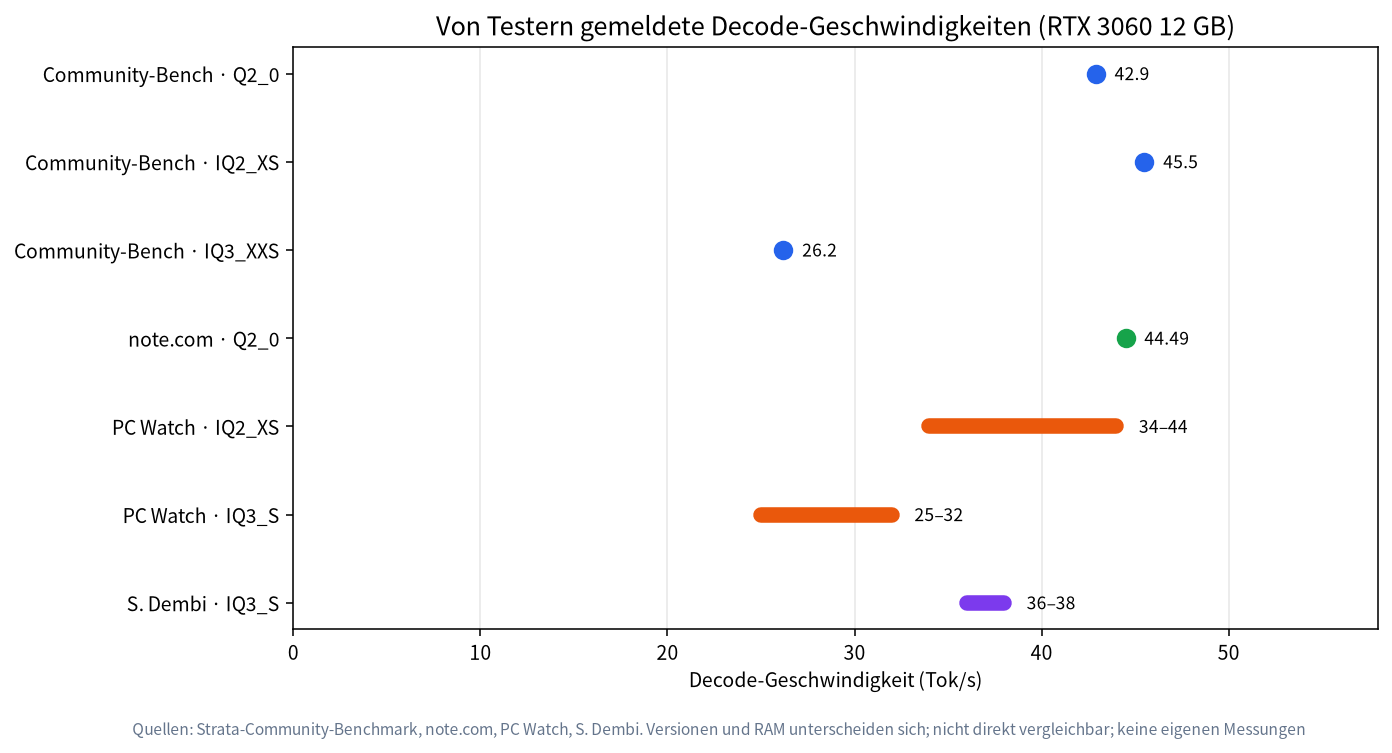
Eine einzige Karte, die RTX 3060, liefert je nach Quantisierung, Version und Speicher etwa 20 bis 45 Token pro Sekunde, weshalb „Wie schnell ist Strata“ keine einzelne Antwort hat.
Vorbehalte und Kritik
- Qualität bei 2 bis 3 Bit. Das Projekt sagt, IQ3_S entspreche dem vollen Modell in seinen veröffentlichten Tests. Das ist die Behauptung der Autoren. PC Watch fand die Code-Generierung bei IQ2_XS eine Stufe unter IQ3_S, und auf Hacker News gibt es skeptische Kommentare, darunter einen Nutzer, der in einem Vision-Test bei gleichen Gewichten einen größeren Fehler von Strata als von llama.cpp meldete. Das konnten wir nicht prüfen.
- Lange Prompts sind auf einer 12-GB-Karte langsam. PC Watch maß etwa 25 Sekunden bis zum ersten Token bei einem 23k-Token-Prompt, was Coding-Agenten trifft, die ganze Dateien senden.
- Speicherdruck. Der Test von arm1.ru zeigt einen Laptop mit 30 GB RAM, der den ganzen Lauf über swappt, während die SSD beschäftigt ist.
- Ein junges Projekt. Das Repository ist sechs Wochen alt, und alle zwei Tage erscheint ein Release. Einstellungen und Tempo ändern sich zwischen den Versionen, und die Strata-Dokumentation selbst sagt, dass es kein externes Sicherheitsaudit gab.
- Installer per Pipe. Der Einzeiler ist bequem, aber ein Skript, das Sie mit Ihren Benutzerrechten ausführen. Lesen Sie es oder nutzen Sie den signierten App-Installer.
- Modelllizenz. Die Engine ist MIT, die Qwen-Gewichte stehen aber unter der Qwen Community License; lesen Sie sie vor kommerzieller Nutzung.
- Die Zahlen stimmen nicht überall überein. Manche Beiträge nennen 176B Parameter; das Repository sagt 125B, und das verwenden wir.
Strata und Ollama auf einen Blick
| Strata | Ollama | |
|---|---|---|
| Hauptziel | Bestimmte sehr große MoE-Modelle mit wenig VRAM ausführen, indem GPU, RAM und SSD gestaffelt werden | Allgemeine Modellverwaltung: viele kleine und mittlere Modelle laden, ausführen und bereitstellen |
| Sterne (2026-11-04) | 39.548 | 185.856 |
| Modelle | Qwen3.8-Flash-Next, Qwen3.6-35B-A3B, DeepSeek V4.1-Flash | Eine große Bibliothek; siehe ollama.com/library |
| Neueste Version, die wir sahen | v0.2.10 (2. Nov.) | v0.40.14 (3. Nov.) |
| Qwen3.8-Flash-Next | Läuft unter Windows, Linux und macOS | Die Bibliotheksseite zeigte nur ein Tag, 125b-mlx (105 GB, für Apple Silicon); ein Tag für NVIDIA-GPUs fanden wir nicht und testeten nicht |
Sie überlappen sich weniger, als die Schlagzeilen vermuten lassen. Wer ein Werkzeug für viele Modelle will, ist mit Ollama weiter einfacher bedient; wer genau diese Modellklasse auf einer Karte mit 12 bis 24 GB will, für den ist Strata gebaut. Der vollständige Vergleich mit llama.cpp und LM Studio steht in unserem Vergleichsartikel, die Installation in der Installationsanleitung und die Hardware-Seite in unserem Artikel zu den Hardware-Anforderungen. Wenn Ollama selbst neu für Sie ist, beginnen Sie mit unserer Ollama-Installationsanleitung.
Was wir getan haben und was nicht
Am 2026-11-04 haben wir die Dokumente des Strata-Repositorys, seine Release Notes, die Release Notes und die Bibliotheksseite von Ollama sowie die oben verlinkten Berichte Dritter gelesen. Wir haben Strata nicht installiert, keine Gewichte heruntergeladen und kein Tempo gemessen. Jede Zahl ist ihrer Quelle zugeordnet.
Häufige Fragen (FAQ)
Was ist Strata in einfachen Worten?
Strata ist ein kostenloses Programm, mit dem ein normaler PC ein sehr großes KI-Modell ausführen kann, indem die am meisten genutzten Teile auf der Grafikkarte, der Rest im RAM und eine Nachschlagetabelle auf der SSD liegen. Es ist eine Engine plus Chat-App, kein Modell.
Ist Strata kostenlos und quelloffen?
Die Engine steht unter der MIT-Lizenz. Die Modelle, die sie lädt, haben eigene Lizenzen; Qwen3.8-Flash-Next nutzt die Qwen Community License 1.0.
Ist es wirklich ein 125B-Modell auf einer 12-GB-GPU?
Das Modell hat insgesamt 125 Milliarden Parameter, aber nur etwa 6 Milliarden sind pro Token aktiv. Strata verlangt dennoch etwa 38 bis 55 GB kombinierten RAM und VRAM für das Modell sowie rund 80 GB Plattenplatz; die 12-GB-Karte ist nur das Minimum für den GPU-Teil.
Kann ich Strata und Ollama auf demselben PC betreiben?
Ja. Strata lauscht standardmäßig auf Port 8080, Ollama auf 11434, aber beide wollen denselben VRAM und RAM, also führen Sie jeweils nur ein großes Modell aus. Die Installationsanleitung behandelt das.
Ist es sicher, Strata zu installieren?
Das Projekt sagt, es gebe keine Telemetrie und keine Konten, und sein Server lausche auf localhost, aber auch, dass es kein externes Sicherheitsaudit gab. Installieren Sie es zuerst auf einem Rechner ohne sensible Daten und laden Sie nur aus dem offiziellen Repository.
Ersetzt Strata Ollama?
Nein. Sie lösen unterschiedliche Probleme. Viele werden Ollama für Alltagsmodelle behalten und Strata für ein großes MoE-Modell hinzufügen.
Sprechen Sie mit uns
Haben Sie eine Frage zu GPU, RAM und Budget? Treten Sie der Community bei oder schreiben Sie an admin@microaione.com, dann gehen wir es gemeinsam durch. Wenn Sie lieber einen gebauten und getesteten Rechner möchten, lesen Sie unseren Leitfaden zu Maschinen und Lösungen.