Strata installieren: Anleitung für den Betrieb neben Ollama unter Windows oder Linux, Schritt für Schritt
Aktualisiert 2026-11-04. Diese Anleitung zum Strata installieren folgt der eigenen Dokumentation des Projekts (INSTALL.md und TERMINAL_LAUNCH.md) mit Stand v0.2.10. Wir haben den Installer nicht selbst ausgeführt; jeder Schritt ist daher seiner Quelle zugeordnet, und Sie sollten vor dem Start die aktuelle Dokumentation lesen.
Wenn Sie schon Ollama nutzen und Strata installieren möchten, um ein sehr großes Modell wie Qwen3.8-Flash-Next auszuprobieren, ist die gute Nachricht, dass die beiden nicht um Ports oder Modellordner streiten. Die schlechte: Um Grafikspeicher und RAM streiten sie sehr wohl. Diese Anleitung behandelt die ersten Prüfungen, die zwei Installationswege, die wichtigen Befehle, das Verbinden von Coding-Werkzeugen, den Betrieb neben Ollama und das, was laut Testern schiefgeht. Wenn Sie noch entscheiden, ob Sie es brauchen, lesen Sie zuerst unseren Vergleich Strata vs Ollama.
Bevor Sie anfangen
| Prüfung | Was die Dokumentation sagt |
|---|---|
| Betriebssystem | Windows 10/11 oder Linux x86-64 für NVIDIA-RTX-Karten; macOS 15 oder neuer auf Apple Silicon; Linux für Intel Arc; eigene Anleitungen für AMD Radeon, Ryzen AI Max und DGX Spark |
| NVIDIA-Treiber | CUDA-13-Pakete brauchen Treiber 580 oder neuer; ältere Karten nutzen eine CUDA-12-Engine |
| GPU-Speicher | Für Qwen3.8-Flash-Next werden 12 GB oder mehr empfohlen |
| RAM | Abhängig von der gewählten Größe, allein für das Modell etwa 38 bis 55 GB; siehe nächster Abschnitt |
| Platte | Etwa 80 GB frei auf einer SSD, laut einem Tester, der der Dokumentation folgte; DeepSeek V4.1-Flash braucht deutlich mehr |
| Internet | Nötig zum Laden von Modellen und Engine-Updates |
Installieren Sie zuerst einen Grafiktreiber; die Pakete von Strata ersetzen ihn nicht. Schließen Sie dann andere GPU-intensive Programme. Die Speicherplanung behandelt unser Artikel zu den Hardware-Anforderungen.
Strata installieren: zwei Wege
| Desktop-App | Terminal | |
|---|---|---|
| Am besten für | Ein Fenster mit Chat und Einstellungen | Coding-Werkzeuge, Server und Skripte |
| Wie | Installer vom neuesten Release laden: ein Windows-.exe-Setup (ohne Administratorrechte), ein Linux-AppImage oder ein macOS-.dmg |
Einzeiler-Installer ausführen, dann strata launch |
| Engine | Wird beim ersten Start für Ihre GPU geladen | Wird mit dem ersten Modell geholt, Signatur geprüft und probeweise gestartet |
Für das Terminal nennt die Dokumentation einen Befehl für Linux und macOS, der das Skript zuerst speichert und dann ausführt, sowie einen PowerShell-Befehl für Windows. Öffnen Sie das Skript und lesen Sie es, bevor Sie es ausführen; es läuft mit Ihren Benutzerrechten.
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
In der Windows-PowerShell lautet die dokumentierte Zeile irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex; wenn Sie möchten, laden Sie die Datei, lesen sie und führen sie dann aus. Öffnen Sie danach ein neues Terminal, damit strata im PATH ist. Startet ein AppImage nicht, weil FUSE fehlt, empfiehlt die Dokumentation, es mit --appimage-extract-and-run auszuführen.
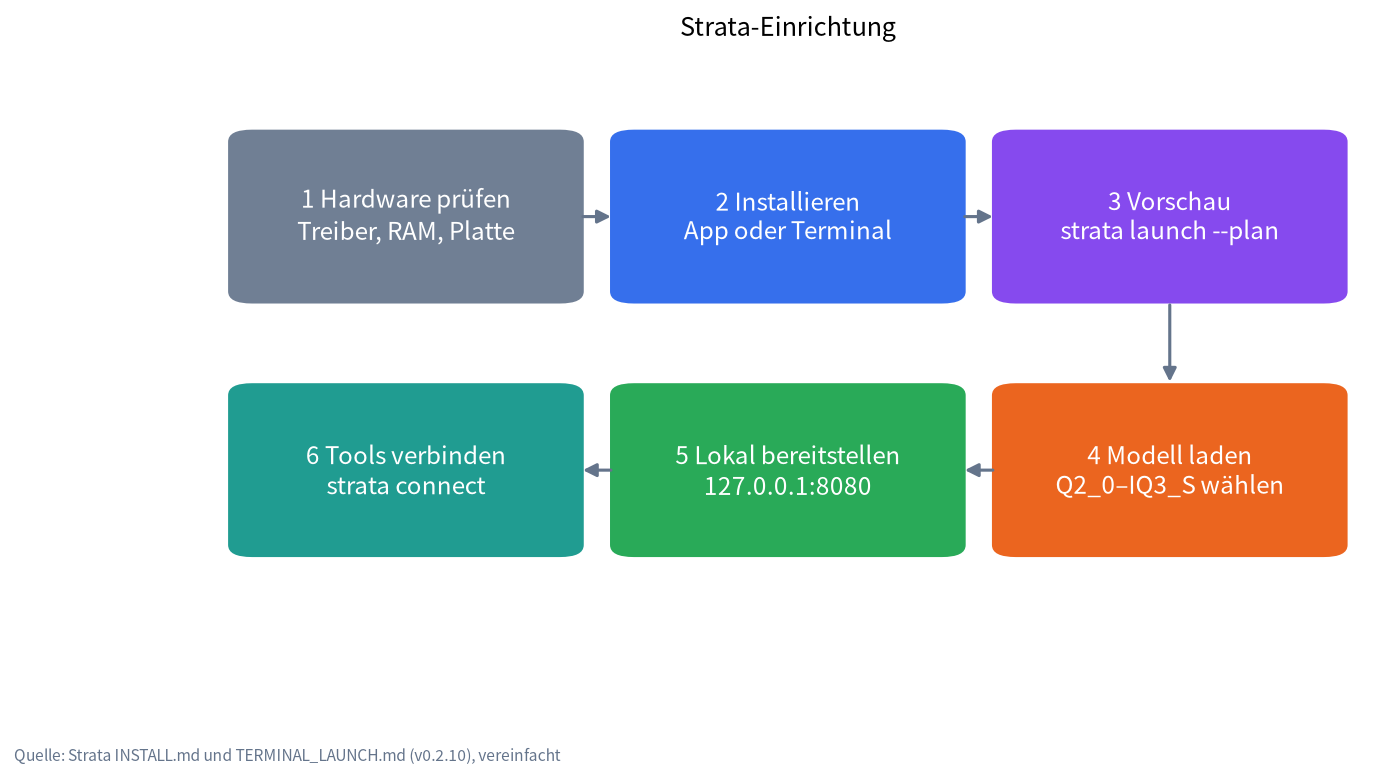
Schritt für Schritt im Terminal
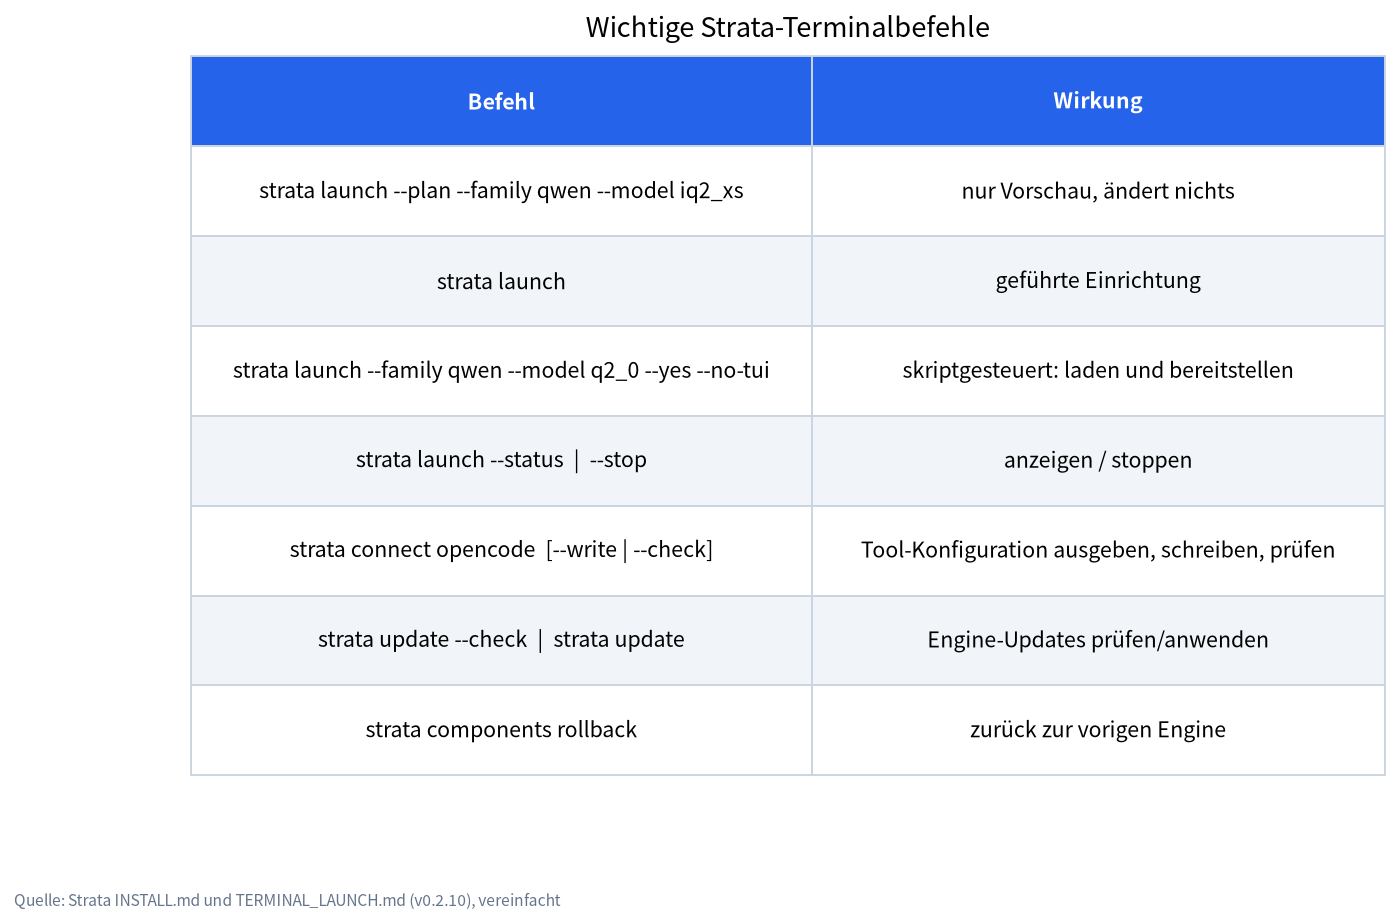
- Erst die Vorschau.
strata launch --plan --family qwen --model iq2_xszeigt, was passieren würde, und ändert nichts. Es sagt Ihnen auch, was fehlt. - Geführte Einrichtung. Führen Sie
strata launchaus und folgen Sie den Bildschirmen: Modell, Ordner, Kontext (8K bis 512K), Bilder, parallele Anfragen, Tuning, Zugriff und ein gespeichertes Preset. Bei den parallelen Anfragen passt sich der Standard Ihrer Karte an: 1 bei einer 12-GB-GPU, 2 bei 20 GB, 3 bei 24 GB und 4 ab 32 GB. Das schnelle Tuning dauert etwa 20 Minuten und ist optional. - Skriptgesteuerte Einrichtung.
strata launch --family qwen --model q2_0 --yes --no-tuilädt herunter, stellt bereit, gibt die Adresse aus und kehrt zurück.strata launch --statuszeigt, was läuft, undstrata launch --stopbeendet es.
Welche Größe wählen
| Größe | RAM + VRAM für das Modell | Beschreibung der Dokumentation |
|---|---|---|
| Q2_0 | 37,6 GB | Am schnellsten, gute Qualität |
| IQ2_XS | 39,2 GB | Schnell, bessere Qualität |
| IQ3_XXS | 47,0 GB | Langsamer, sehr gute Qualität |
| IQ3_S | 54,8 GB | Am langsamsten, beste Qualität; laut Dokumentation entspricht sie in den veröffentlichten Tests dem vollen Modell |
Lassen Sie Speicher für das Betriebssystem. Auf einer 12-GB-Karte mit 64 GB RAM haben Tester IQ2_XS und IQ3_S genutzt. PC Watch fand kurze Chats mit IQ2_XS angenehm, die Code-Generierung aber eine Stufe unter IQ3_S; wählen Sie also die größere Variante, wenn Sie programmieren und den RAM haben.
Prüfen, ob der Server läuft
Die Standard-Adresse ist http://127.0.0.1:8080. Strata stellt /health, /v1/models, den OpenAI-Chat-Completions-Pfad /v1/chat/completions, den Anthropic-Pfad /v1/messages und einen Responses-Pfad bereit.
curl http://127.0.0.1:8080/health
curl http://127.0.0.1:8080/v1/models
Verwenden Sie in Ihrem Client den von /v1/models zurückgegebenen Modellnamen. Jeder OpenAI-kompatible Client, auch Open WebUI (siehe unsere Open-WebUI-Anleitung), kann auf http://127.0.0.1:8080/v1 zeigen. Der Server lauscht nur auf Ihrem PC. Wenn Sie ihn für Ihr Netzwerk, einen Cloudflare-Tunnel oder Tailscale öffnen, setzen Sie einen API-Schlüssel, denn ohne ihn kann jeder, der den Port erreicht, das Modell und seine Werkzeuge nutzen. Die allgemeinen Sicherheitsregeln behandelt unser Leitfaden zum lokalen LLM-API-Server.
Coding-Werkzeuge mit strata connect verbinden
strata connect listet OpenCode, Codex CLI, Claude Code, oh-my-pi, pi, Hermes Agent und OpenClaw auf. strata connect opencode gibt die Konfiguration aus, --write schreibt sie nach Rückfrage (Ersetztes wird gesichert) und --check sendet einen Prompt und einen Werkzeugaufruf so, wie es die jeweilige App tut. Die Dokumentation nennt bekannte Grenzen: Claude Code braucht die Einstellung CLAUDE_CODE_MAX_CONTEXT_TOKENS, OpenCode braucht limit.input, Hermes lehnt Fenster unter 64K ab, sofern nicht konfiguriert, und OpenClaw braucht Node 24.16 oder neuer. Ein Tester mit OpenCode sah, wie ein als Klartext ausgegebener Werkzeugaufruf eine Aufgabe vorzeitig beendete, und behob das mit der Strata-Option tool_call_recovery; lesen Sie diesen Bericht.
Strata neben Ollama betreiben
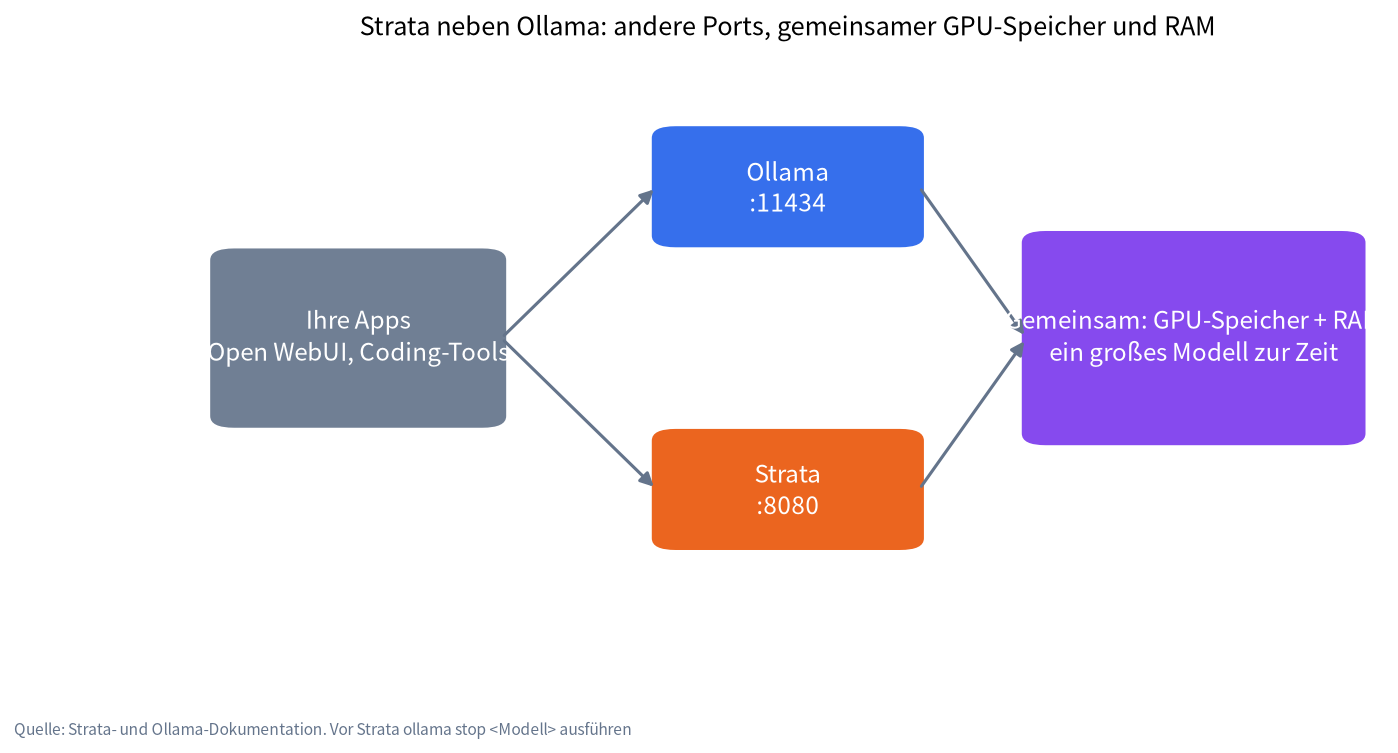
| Thema | Strata | Ollama | Was zu tun ist |
|---|---|---|---|
| Standard-Port | 8080 | 11434 | Kein Konflikt. Ändern Sie --port bei Strata, wenn ein anderes Werkzeug 8080 nutzt |
| Modelldateien | Eigener Installationsordner (~/.local/share/strata/install unter Linux, %LOCALAPPDATA%\Strata\install unter Windows) |
Der Modellordner von Ollama; siehe unseren Leitfaden zum Ollama-Modellpfad | Getrennt halten; die Dokumentation von Strata beschreibt keinen Import aus Ollama |
| GPU-Speicher | Füllt den VRAM mit einem Expertencache | Lädt ein Modell auf Anfrage und entlädt es nach Leerlaufzeit | Führen Sie ollama stop <Modell> aus, bevor Sie Strata starten |
| RAM | Fixiert alle Experten im RAM | Lädt pro Modell | Nicht zwei große Modelle gleichzeitig ausführen |
strata models import PATH --plan erkennt bestimmte Dateisätze, die Strata selbst installiert; nichts wird kopiert oder verschoben. In der Dokumentation fanden wir nichts dazu, von Ollama heruntergeladene Modelldateien wiederzuverwenden; gehen Sie also davon aus, dass Sie die Pakete von Strata separat laden. Zu Ollama selbst siehe unsere Ollama-Installationsanleitung.
Fehlerbehebung nach öffentlichen Berichten
| Symptom | Wahrscheinliche Ursache | Was Tester taten |
|---|---|---|
| Sehr langsame erste Minute | Engine und Pakete werden geladen | Warten, dann strata launch --status prüfen |
| System ruckelt, Swap wächst | Zu wenig RAM für die Größe | Kleinere Größe wählen oder Apps schließen; ein Laptop mit 30 GB RAM swappte 4 bis 5 GB |
| Langes Nachdenken ohne Antwort | Reasoning läuft aus dem Ruder | Ein Tester auf Proxmox setzte ein Reasoning-Budget von 4.096 Token und blieb bei IQ3_S |
| Langsames erstes Token bei langen Dateien | Prefill auf einer 12-GB-Karte | Kürzerer Kontext oder kleinere Prompts; PC Watch sah etwa 25 s bei 23k Token |
| Einstellungen scheinen versteckt | Einige Optionen stehen in settings.json |
Ein japanischer Nutzer auf note.com fand sie damals undokumentiert; prüfen Sie die aktuelle Dokumentation |
| Port bereits belegt | Ein anderer Server auf 8080, etwa llama-server |
Einen anderen --port übergeben |
Eine sichere Checkliste für den ersten Start
Weil Strata neu ist und sich schnell ändert, ersparen einige Gewohnheiten Ärger.
- Nutzen Sie zuerst einen Testrechner oder ein sauberes Benutzerkonto. Der Installer ist bequem, aber Sie führen das Skript eines anderen aus, und das Projekt selbst sagt, es gab kein externes Sicherheitsaudit.
- Führen Sie den Plan vor dem Download aus.
strata launch --planzeigt, welche Dateien geholt werden und wie viel Platz sie brauchen, damit Sie nicht nach 30 GB Download eine volle Platte entdecken. - Beginnen Sie mit der kleinsten Größe. Q2_0 oder IQ2_XS zeigt, ob RAM, Treiber und Kühlung in Ordnung sind, bevor Sie sich auf die größeren Pakete festlegen.
- Bleiben Sie auf localhost. Lassen Sie die Zugriffseinstellung auf „nur dieser Computer“, bis das Modell läuft. Wenn Sie später teilen, aktivieren Sie den API-Schlüssel.
- Halten Sie fest, was funktioniert. Speichern Sie ein Preset mit Namen, um nach einem Update mit denselben Einstellungen neu zu starten.
- Beobachten Sie Temperaturen und Speicher. Die SSD eines Testers las in einem 1,3-stündigen Lauf etwa 6,9 TB, und der Laptop eines anderen swappte; ein Monitorfenster oder der Monitor-Tab von Strata zeigt Probleme früh.
Aktualisieren
Im Terminal erledigen strata update --check und strata update die Engine-Updates; ist ein Modell geladen, fragt der Befehl, bevor er es stoppt. strata components rollback kehrt zur vorherigen Engine zurück. In der App nutzen Sie die Update-Steuerung in den Einstellungen. Weil etwa alle zwei Tage Releases erscheinen, lesen Sie die Release Notes, bevor Sie ein funktionierendes Setup aktualisieren.
Was wir getan haben und was nicht
Am 2026-11-04 haben wir die Dokumente des Projekts zu Installation, Terminal und Modellen sowie die oben verlinkten Berichte Dritter gelesen. Wir haben Strata nicht installiert, also wurde hier kein Befehl von uns ausgeführt. Versionsnummern und Flags ändern sich schnell; vertrauen Sie strata launch --help mehr als dieser Seite.
Häufige Fragen (FAQ)
Können Strata und Ollama gleichzeitig laufen?
Ja, auf verschiedenen Ports, aber sie teilen sich GPU-Speicher und RAM. Stoppen Sie das Ollama-Modell, bevor Sie ein großes Modell in Strata laden.
Muss ich Ollama zuerst deinstallieren?
Nein. Sie nutzen unterschiedliche Ports und Modellordner.
Kann Strata die Modelle wiederverwenden, die ich schon mit Ollama geladen habe?
Wir fanden keinen dokumentierten Import aus Ollama. Strata lädt eigene Pakete, planen Sie also zusätzlichen Plattenplatz ein.
Wie viel Plattenplatz brauche ich?
Etwa 80 GB frei für Qwen3.8-Flash-Next laut einem Tester, der der Dokumentation folgte, und 239 bis 274 GB für DeepSeek V4.1-Flash laut Projekt.
Ist es sicher, den Einzeiler-Installer auszuführen?
Es ist ein Skript, das mit Ihren Benutzerrechten läuft. Speichern Sie es, lesen Sie es und laden Sie nur aus dem offiziellen Repository. Das Projekt sagt, es sende keine Telemetrie, aber auch, dass es kein externes Sicherheitsaudit gab.
Welche Adresse verwenden meine Apps?
http://127.0.0.1:8080/v1 für OpenAI-kompatible Clients. Nutzen Sie den von /v1/models angezeigten Modellnamen.
Sprechen Sie mit uns
Hängen Sie bei einem Treiber, einer Speichergrenze oder einer Verbindung fest? Treten Sie der Community bei oder schreiben Sie an admin@microaione.com mit GPU, RAM und Fehlertext. Wenn Sie lieber einen getesteten Rechner möchten, lesen Sie unseren Leitfaden zu Maschinen und Lösungen.