GGUF 是什么?llama.cpp 入门:下载、运行与量化
刚接触本地大模型的人,几乎都会撞见 .gguf 这个后缀:Hugging Face 上一堆仓库叫“xxx-GGUF”,Ollama、LM Studio 的底层也都在读它。那么 GGUF 是什么?简单说,它是 llama.cpp 项目使用的单文件模型格式,把权重、分词器和元数据打包在同一个文件里,下载下来就能直接运行。这篇文章讲清楚三件事:GGUF 到底装了什么,llama.cpp 怎么装、怎么跑,以及不同量化会让文件体积差多少。读完你就能看懂模型仓库里那一排 Q4、Q5、Q8 该选哪个。需要先了解量化概念的话,可以配合《大模型量化与 Q4_K_M》阅读。
核对说明:GGUF 的定义和命令用法来自 llama.cpp 官方文档站(llama.app)和 Hugging Face 官方文档,体积和每权重比特数来自 llama.cpp 仓库的官方 quantize README(均在 2026-10-30 读取)。该 README 里的速度数字没有写明测试硬件,所以我们只引用体积,不引用速度。项目更新很快,命令参数请以你安装的版本为准。
要点速览(更新于 2026-10-30)
- GGUF 是 llama.cpp 使用的单文件模型格式,一个文件同时包含权重和元数据。
Q4_K_M 是最常见的折中:Llama 3.1 8B 约 4.58 GiB,原始 F16 约 14.96 GiB。
多数人直接下载现成 GGUF,用 llama-cli 聊天或 llama-server 提供接口。
GGUF 是什么:一个文件装下一个模型
按 llama.cpp 官方介绍,llama.cpp 运行的模型存放在 GGUF 格式里,这是一个单文件,把运行所需的东西打包在一起:模型权重、分词器(tokenizer)和元数据。Hugging Face 上有数千个现成的 GGUF 模型可以直接使用。
和以前常见的分散式格式比,单文件有几个实际好处:
- 好搬运:一个文件复制到另一台电脑就能用,适合离线和内网环境。
- 自描述:模型的层数、上下文长度、词表等信息都在文件头里,运行程序不需要再去找额外的配置文件。
- 适合量化:同一个模型可以发布成多个量化版本,每个版本都是独立的 GGUF 文件,按显存挑一个下载即可。
| 对比项 | GGUF | 原始 safetensors 权重 |
|---|---|---|
| 文件形态 | 单个 .gguf 文件,含分词器与元数据 |
多个分片文件加配置、分词器文件 |
| 主要用途 | llama.cpp、Ollama、LM Studio 等本地推理 | 训练、微调、用 Transformers 推理 |
| 是否常带量化 | 常见,一个仓库多个量化版本 | 通常是 BF16/FP16 原精度 |
| 本地直接运行 | 可以 | 多数本地工具需要先转换 |
GGUF 和 llama.cpp、Ollama、LM Studio 的关系
很多人以为这些是互相竞争的东西,其实是上下层关系。llama.cpp 是推理引擎,负责读取 GGUF 并计算;Ollama 和 LM Studio 在它之上提供下载管理、模型库、聊天界面和接口。Ollama 的安装和使用见《Ollama 安装教程》,图形界面的方案见《LM Studio 使用教程》。
直接用 llama.cpp 的好处是更透明、可调的参数更多、更新更快;代价是需要多敲几条命令。如果你想知道三者怎么取舍,后面会有专门的对比文章。
llama.cpp 入门:安装
按 Hugging Face 官方文档,有两种常见方式:
# macOS / Linux
brew install llama.cpp
# Windows
winget install llama.cpp
或者从源码编译。想让 NVIDIA 显卡参与计算,需要在编译时打开 CUDA:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON    # 不用 NVIDIA 显卡时去掉这个选项
cmake --build build --config Release
AMD ROCm 和 Intel SYCL 等硬件的编译选项不同,需要查看项目的构建文档。官方还提供预编译二进制包和 Docker 镜像,不想编译的话可以直接用。
第一次运行:用 -hf 直接下载模型
Hugging Face 的文档说明,只要给出仓库名和量化标签,llama.cpp 会自动下载并缓存模型,缓存位置由环境变量 LLAMA_CACHE 决定:
llama-cli -hf bartowski/Llama-3.2-3B-Instruct-GGUF:Q8_0
如果你已经有一个 .gguf 文件,用 -m 指向它:
llama-cli -m ./my-model.gguf
需要说明的是,llama.cpp 的新版官方文档站(llama.app)把命令统一成了 llama cli 和 llama serve 的写法,文档里还说它默认会根据你的设备内存自动调整未设置的选项,所以启动时的显存不足错误比较少见。旧文档里的 llama-cli、llama-server 写法在很多现有教程里仍然通用。两种写法对应同一套功能,用哪种取决于你安装的版本,运行 --help 就能确认。
把模型变成 API:llama-server
想让其他程序调用本地模型,可以启动服务器。官方文档说明,服务器提供与 OpenAI 兼容的接口(聊天补全、补全、向量嵌入等)、内置的网页聊天界面,以及并行解码和连续批处理:
llama-server -hf bartowski/Llama-3.2-3B-Instruct-GGUF:Q8_0
# 然后用 OpenAI 兼容接口调用
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"你好"}]}'
Hugging Face 文档里的示例端口是 8080,新版 llama.app 文档里默认监听 127.0.0.1:9931。端口以你的版本为准,启动日志里会打印实际地址。官方文档里几个常用参数如下:
| 参数 | 作用 |
|---|---|
-c, --ctx-size N |
上下文长度(token 数),设为 0 表示使用模型的最大值 |
-ngl, --gpu-layers N |
放到 GPU 上的层数,可设 auto、all 或具体数字 |
-np, --parallel N |
并发请求的槽位数 |
--host、--port |
监听地址与端口,默认只监听本机 |
--api-key KEY |
要求带密钥访问 |
如果你想让局域网里的其他电脑访问,需要把 --host 改成 0.0.0.0,同时一定要设置 --api-key 并配置防火墙,不要把没有保护的接口直接暴露到公网。
GGUF 量化:同一个模型,体积差多少
量化就是用更少的比特存储权重,体积变小、对显存要求变低,代价是可能损失一些质量。llama.cpp 官方 quantize README 用 Llama-3.1-8B 列出了各种量化的每权重比特数和文件大小:
| 量化类型 | 每权重比特数 | 文件大小(GiB) |
|---|---|---|
| IQ2_M | 2.93 | 2.74 |
| Q2_K | 3.16 | 2.95 |
| Q3_K_M | 4.00 | 3.74 |
| Q4_K_S | 4.67 | 4.36 |
| Q4_K_M | 4.89 | 4.58 |
| Q5_K_M | 5.70 | 5.33 |
| Q6_K | 6.56 | 6.14 |
| Q8_0 | 8.50 | 7.95 |
| F16 | 16.00 | 14.96 |
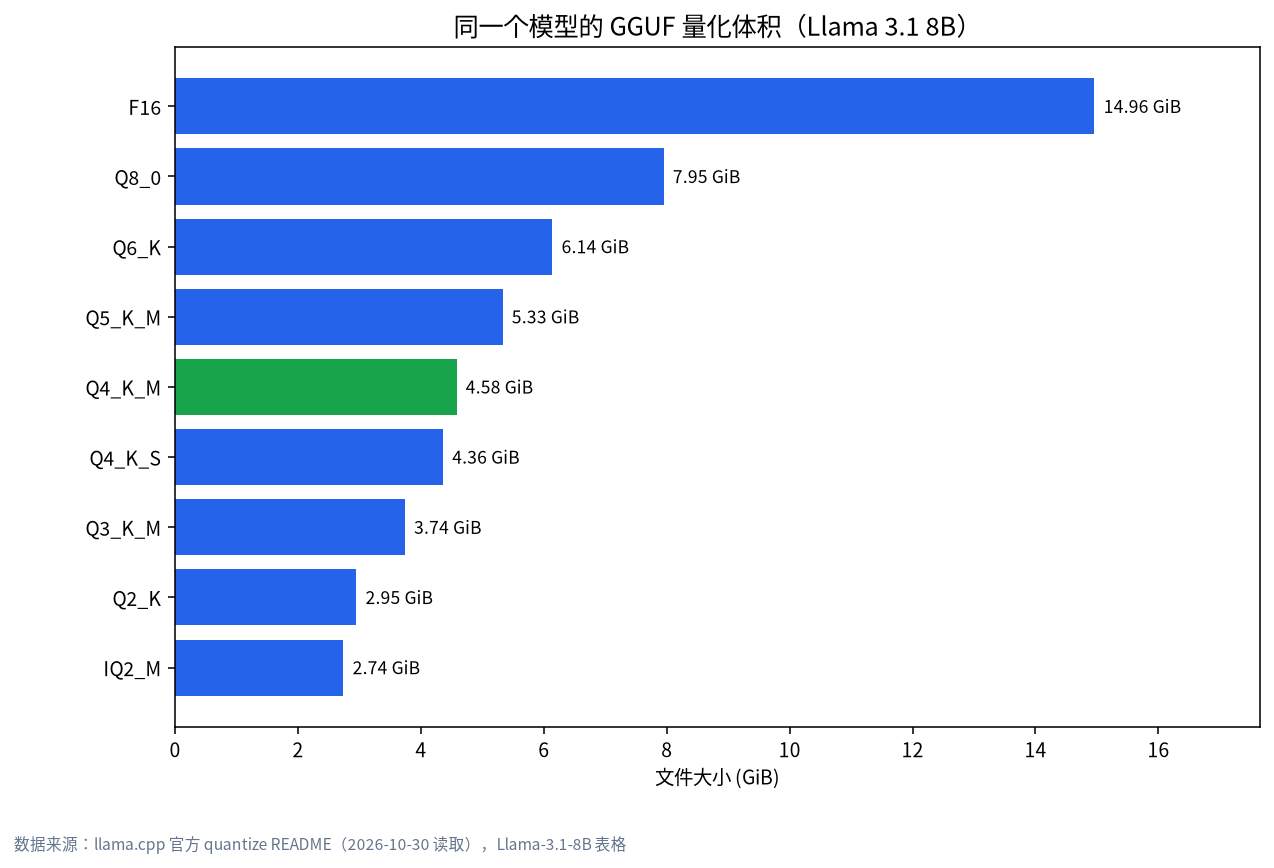
可以看到,Q4_K_M 约 4.9 比特每权重,大约是 F16 体积的三分之一不到。这就是它成为常见默认选择的原因:体积小很多,质量通常仍然够用。Hugging Face 的文档也说明,不指定量化时默认用 Q4_K_M。选择量化的思路是:先看你的显存,在放得下的前提下尽量选更高的量化。具体算法见《大模型显存需求怎么算》,而不同量化对质量的影响,我们没有自己做评测,建议读模型发布方的说明,再用自己的任务试一试。
自己转换和量化:什么时候需要
大多数人不需要自己转换,直接下载别人做好的 GGUF 就行。但如果你拿到的是 Hugging Face 上的原始权重,官方 README 给出的流程是两步:先用 convert_hf_to_gguf.py 转成高精度的 GGUF(如 bf16),再用 llama-quantize 压缩:
python convert_hf_to_gguf.py --outfile model-bf16.gguf --outtype bf16 <模型目录>
./build/bin/llama-quantize model-bf16.gguf model-Q4_K_M.gguf Q4_K_M
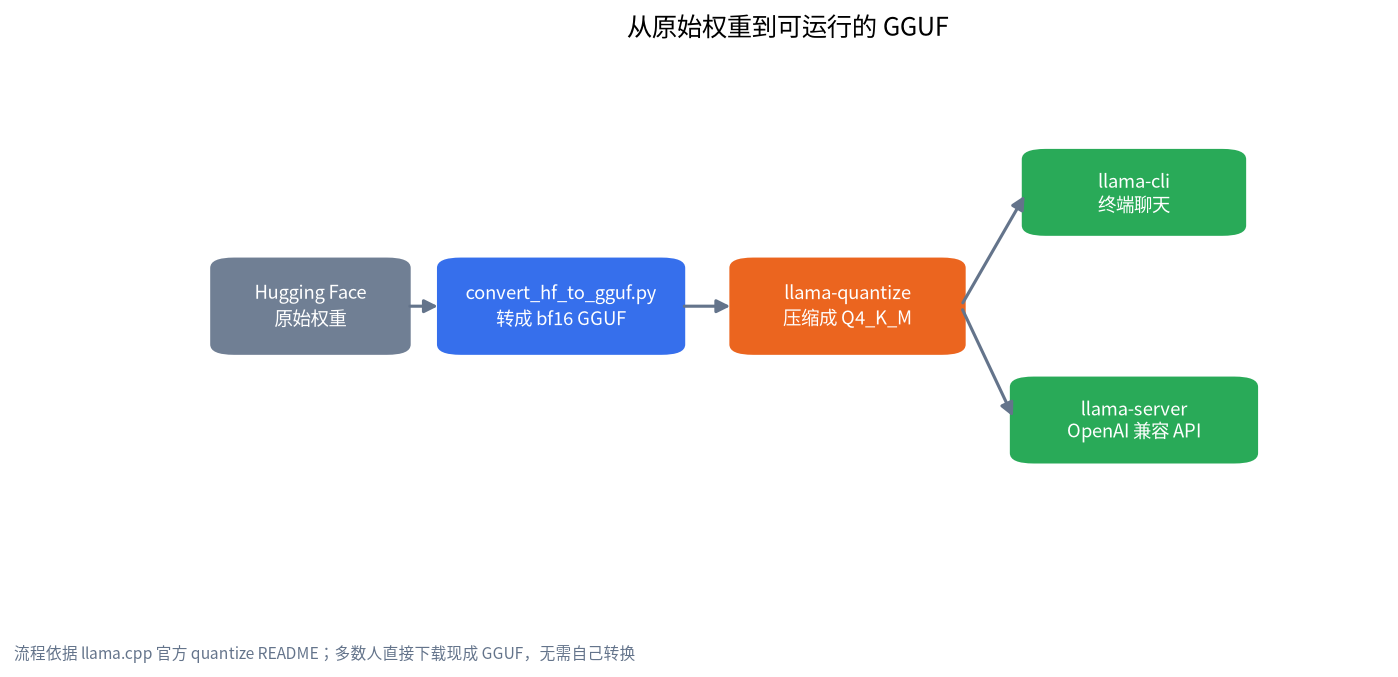
README 还提醒了两件事。第一,转换和量化过程需要足够的磁盘空间存放中间文件;第二,处理视觉等多模态模型时,多模态投影部分通常保持在 bf16 或 q8 这样的高精度格式,因为用更低的量化对速度和内存几乎没有好处,只会影响质量。
怎么挑一个靠谱的 GGUF 仓库
GGUF 仓库很多是第三方上传的,质量参差不齐。下载前建议检查:
- 看发布者:优先选模型原作者官方仓库,或长期维护、口碑好的量化发布者。
- 看模型卡:确认原始模型、许可证、量化方式和模板说明。
- 看文件大小:和你的显存对比,并给上下文缓存留余量,见《本地大模型怎么选》的分档表。
- 看是否分片:大模型可能被切成多个文件,要全部下载。
- 下载慢怎么办:可以参考《Ollama 下载慢怎么办》里关于魔搭和 Hugging Face 的做法。
运行时常见报错与处理
| 现象 | 常见原因 | 处理办法 |
|---|---|---|
| 提示不认识模型架构(unknown model architecture) | llama.cpp 版本太旧,不支持这个新模型 | 升级到较新版本,或换回已支持的模型 |
| 加载很慢、速度很低 | 模型没有放进显存,部分层在 CPU 上 | 换更低的量化,或缩短上下文,调整 -ngl |
| 提示找不到文件或分片缺失 | 大模型被分成多个文件,只下了一部分 | 把所有分片放在同一目录并从第一个分片启动 |
| 输出乱码或重复 | 对话模板不匹配,或量化太低 | 确认模型卡里的模板,必要时换高一档的量化 |
| 局域网访问被拒绝 | 默认只监听本机 | 设置 --host,同时配好 --api-key 与防火墙 |
这几类问题里,最常见的是“版本太旧”和“显存放不下”。前者升级即可,后者的思路与《Ollama 不使用 GPU 怎么办》里说的一致:先确认模型有多少层真正放进了显存,再决定是换小模型、降低量化,还是缩短上下文。我们没有为这张表逐项复现,它是对常见现象的整理,具体报错文字以你的版本为准。
常见问题
GGUF 是什么意思,是缩写吗?
它是 llama.cpp 项目使用的模型文件格式,官方介绍的重点是“单文件、包含权重、分词器和元数据”。我们在这里不展开它的缩写来历,因为对使用没有影响。
GGUF 文件能用在 Ollama 里吗?
可以。Ollama 的底层基于 llama.cpp,支持直接从 Hugging Face 拉取 GGUF,写法是 ollama run hf.co/用户名/仓库名:量化。也可以下载到本地后用 Modelfile 导入。
Q4_K_M 和 Q8_0 应该选哪个?
先看显存。放得下 Q8_0 又想要更高精度就选 Q8_0,显存紧张就选 Q4_K_M。按官方表格,8B 模型的 Q4_K_M 约 4.6GiB,Q8_0 约 8GiB,差了近一倍。
我必须自己编译 llama.cpp 吗?
不必。可以用 brew 或 winget 安装,也有预编译包和 Docker 镜像。只有想启用特定硬件后端(比如 CUDA)或使用最新功能时,才需要自己编译。
GGUF 模型安全吗?
GGUF 本身是数据文件,不像可执行程序。但任何第三方下载的文件都应该检查来源、核对哈希和模型卡,并只在可信渠道获取。使用前也要确认许可证是否允许你的用途。
llama.cpp 和 Ollama 该选哪个?
想要省事、有模型库和统一接口,选 Ollama;想要更细的控制、更快跟进新功能,选 llama.cpp。两者读取的是同一类 GGUF 文件,不冲突。
想继续动手
想把 GGUF 部署到一台具体的机器上,或者不确定自己的显卡该选哪个量化,欢迎加入社区提问,或发邮件到 admin@microaione.com,附上显卡型号和内存大小。入门路线可以回看《本地部署大模型入门》。
参考与延伸阅读:llama.cpp 官方文档、Hugging Face:GGUF 与 llama.cpp、llama.cpp quantize 说明。