vLLM 教程:Ollama 不够用时,如何用 vLLM 和 SGLang 部署本地大模型服务
大多数人从 Ollama 开始接触本地模型,对一个人来说它就是正确的工具。但当好几个人或好几个程序同时发请求时,就需要另一类软件:专门为 GPU 上每秒处理大量请求而设计的推理服务引擎。这篇 vLLM 教程讲清楚 vLLM 和 SGLang 与 Ollama 有什么不同,什么时候值得多花力气,怎样安装和启动 vLLM,以及怎样规划显存,免得服务跑到一半内存不足。默认你已经了解模型大小和显存的关系,如果还不熟,请先读我们的显存计算指南。
核对说明:vLLM 的说法(支持的硬件、
vllm serve、位于 localhost:8000 的 OpenAI 兼容服务、每个服务一个模型、--gpu-memory-utilization默认 0.92)来自 vLLM 文档;SGLang 的说法来自 SGLang 文档;PagedAttention 来自 Kwon 等人发表于 SOSP 2023 的论文,均于 2026-10-30 核对。文中的并发数字是我们自己的示意计算,不是基准测试,写这篇文章时我们没有实际运行 vLLM 或 SGLang。要点速览(更新于 2026-10-30)
- 单人用 Ollama 或 llama.cpp;当多人或多个程序同时使用同一块 GPU 时,再考虑 vLLM 或 SGLang,因为它们会批处理请求,并更高效地管理 KV 缓存。
vLLM 用
vllm serve <模型>在 8000 端口启动 OpenAI 兼容服务,默认会预留 92% 的 GPU 显存,所以它不适合和别的任务共用一块卡。显存规划公式是:权重加上每个请求的 KV 缓存乘以同时请求数;上下文一长,并发数就会迅速下降。
Ollama 够用与不够用的分界
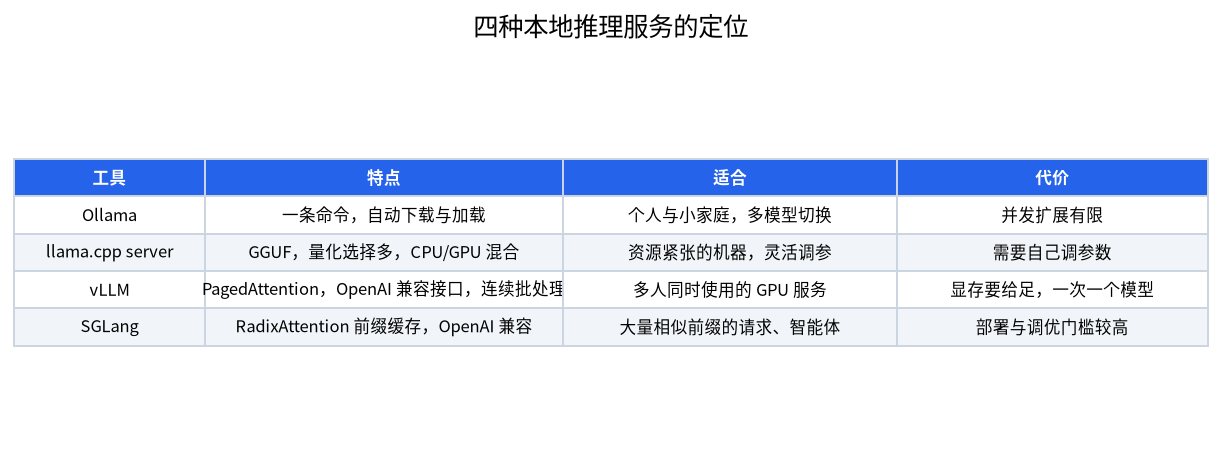
Ollama 和 llama.cpp 为方便和灵活的硬件而设计:一条命令就能下载模型,量化文件能在小显卡甚至 CPU 和 GPU 混合内存里运行,还可以按需加载和卸载多个模型。对一个家庭或一位开发者来说,这正合适,我们的 Ollama、LM Studio 与 llama.cpp 对比讲了它们的区别。
负载一上来,情况就变了。如果十位同事或一个批处理任务同时发请求,你希望 GPU 同时处理很多条序列,而不是一条接一条。这正是推理服务引擎的设计目的。vLLM 和 SGLang 采用连续批处理:旧请求结束时,新请求就加入正在运行的批次;两者也都会仔细管理 KV 缓存,不让内存浪费在空白上。vLLM 的做法叫 PagedAttention,把缓存按块存放,而不是给每个请求分配一大块连续区域,这项技术出自 2023 年的 SOSP 论文。SGLang 增加了 RadixAttention,当很多请求有相同开头时可以复用已缓存的计算,智能体和带长系统提示的聊天应用经常是这种情况。
也要老实说清代价。这些引擎期望你有一块像样的 GPU,通常是英伟达 CUDA 或 AMD ROCm;它们通常以比 Ollama 用户习惯的 4 位文件更高的精度加载模型;每个服务只托管一个模型。在单张 8GB 或 12GB 显卡上,Ollama 往往体验更好。
vLLM 和 SGLang 做什么
按官方文档,vLLM 支持英伟达 CUDA、AMD ROCm、英特尔 XPU、几类 CPU,以及通过独立 Metal 插件支持苹果芯片。它启动的服务实现了 OpenAI 风格的接口,如列出模型、聊天补全和文本补全,所以为 OpenAI 客户端写的应用只要把基础地址改过去就能使用。服务默认监听本机的 8000 端口,一次托管一个模型。SGLang 的文档把它描述为面向生产服务的推理框架,从单卡到大型集群都适用,具有 RadixAttention、前缀缓存和多卡并行,兼容 Hugging Face 模型和 OpenAI 风格接口。
实际上两个项目有不少重叠,而且都在快速演进,所以请以你要用的模型对应的最新文档为准。新架构有时在其中一个引擎上先得到支持。如果你的模型不受支持,再怎么调优也没用,所以下载之前先看支持模型列表。
vLLM 教程:安装并启动 vLLM
vLLM 快速入门推荐用 uv 管理干净的 Python 环境。在装有英伟达显卡和较新驱动的 Linux 上,流程是:创建 Python 3.12 的虚拟环境,自动选择后端安装 vllm,然后用 vllm serve 启动模型。快速入门的示例用的是一个小模型 Qwen2.5-1.5B-Instruct,下载快,很适合作为第一次测试。服务提示已运行后,就可以用任何 OpenAI 兼容客户端向 http://localhost:8000/v1 发请求。
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm serve Qwen/Qwen2.5-1.5B-Instruct
请留意启动日志:它会报告模型加载情况,以及为 KV 缓存预留了多少显存,这个数字决定了你能同时服务多少请求。
在 Windows 上,常见路线是 WSL2 加上 Windows 侧的英伟达驱动,可参考我们的 Windows 与 WSL2 指南,或者在 Linux 上使用 Docker 镜像。AMD 用户应按 vLLM 文档里的 ROCm 说明操作,我们核对时文档写的是支持 Python 3.12 和 ROCm 7.0。
规划 GPU 显存
vLLM 的 --gpu-memory-utilization 选项是服务可以使用的 GPU 显存比例,文档给出的默认值是 0.92。加载完权重后,vLLM 会把剩下的大部分显存分给 KV 缓存,所以不管模型多大,服务看起来总是把整张卡占满。这是有意的设计,也意味着除非你调低这个比例,否则不能在同一张 GPU 上同时运行游戏或另一个模型。--max-model-len 选项设置服务接受的最长上下文,调低它可以腾出缓存给更多并发请求。
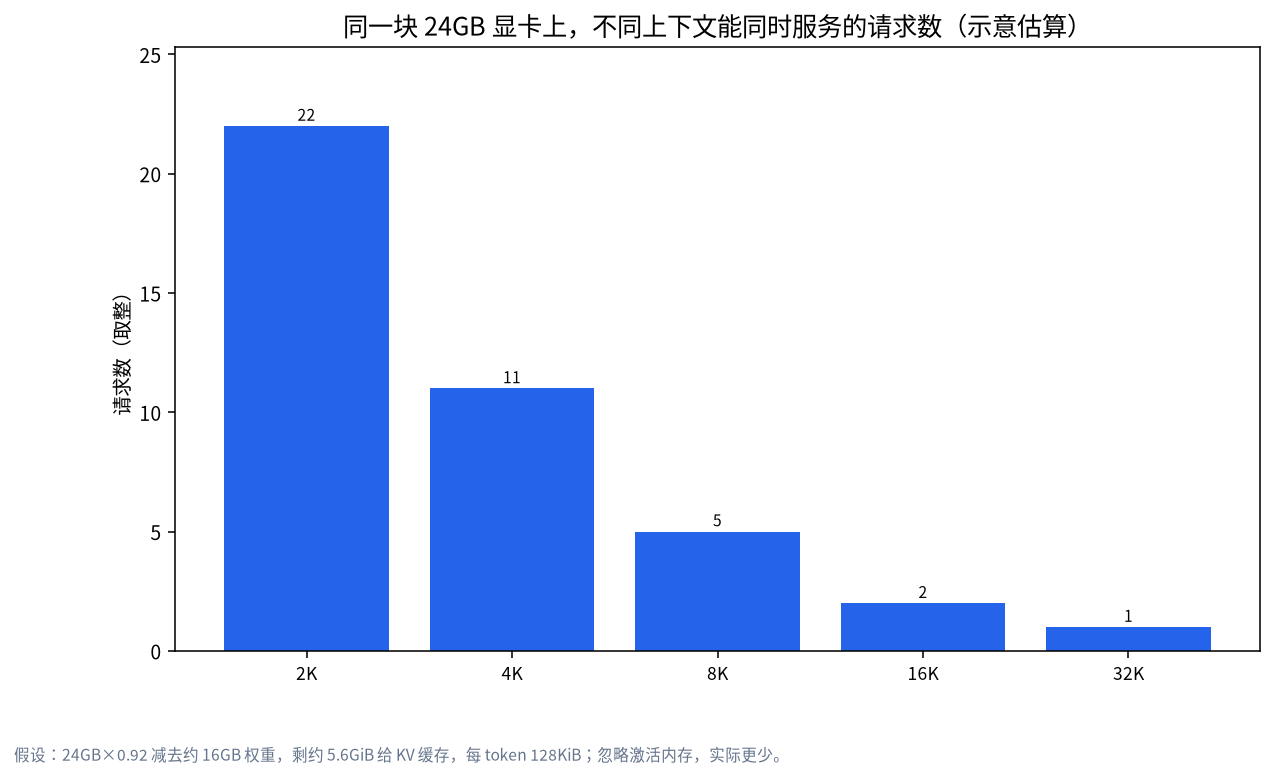
下面是我们推算出来的一个例子。16 位的 Llama 3.1 8B 大约有 80 亿参数,权重约 16GB。24GB 显卡在 0.92 的利用率下,大约有 22GB 可用,权重之后剩下约 6GB 给 KV 缓存(忽略激活内存和额外开销)。这个模型的缓存在 16 位下每个 token 需要 128 KiB(见我们的 KV 缓存指南),所以一个 8K token 上下文的请求大约占 1 GiB。也就是说只能同时服务大约 5 个 8K 请求,或约 11 个 4K 请求,或约 22 个 2K 请求。实际数字会因开销而更低,请把它当作规划的形状,而不是承诺。
| 每个请求的上下文 | 每个请求的 KV 缓存 | 约 5.6 GiB 内可容纳的请求数 |
|---|---|---|
| 2K token | 0.25 GiB | 约 22 |
| 4K token | 0.5 GiB | 约 11 |
| 8K token | 1 GiB | 约 5 |
| 16K token | 2 GiB | 约 2 |
| 32K token | 4 GiB | 1 |
这张表说明了为什么推理服务引擎对短请求和中等长度的请求最有价值。许多聊天应用共用同一段系统提示,带前缀缓存的引擎可以只缓存一次,既省内存又省时间。
量化与多卡
推理服务引擎也支持量化模型,但格式与 GGUF 不同。vLLM 和 SGLang 常用的是 Hugging Face 上的 AWQ、GPTQ 或 FP8 检查点,所以你要下载引擎支持的格式,而不是转换 GGUF 文件。如果你有两张 GPU,张量并行会把每一层拆到两张卡上,详见我们的双显卡指南。它能让更大的模型装得下,也会增加通信开销,所以在为此买第二张卡之前请先测试。
连接应用
因为服务说的是 OpenAI 协议,所以 Open WebUI、编程助手和脚本只需要把基础地址设为 http://你的服务器:8000/v1,并填一个占位密钥(除非你启动服务时设置了 API 密钥)。请把这个端口当作内部服务对待:没有认证就不要暴露到互联网上,访问控制的思路可参考我们的企业部署指南。如果想要浏览器界面,我们的 Open WebUI 指南说明了如何连接到 OpenAI 兼容端点。
三种引擎怎么选
| 问题 | Ollama 或 llama.cpp | vLLM | SGLang |
|---|---|---|---|
| 同时使用的人数 | 一人到几人 | 很多 | 很多 |
| 常见模型格式 | GGUF,常用 4 位 | Hugging Face 检查点 | Hugging Face 检查点 |
| 配置难度 | 几分钟 | Python 环境、GPU 驱动 | Python 环境、GPU 驱动 |
| 显存行为 | 按需加载和卸载 | 预留大部分显存 | 预留设定比例 |
| 强项 | 方便,适合小显卡 | 批处理与生态广 | 共享提示的前缀复用 |
请把这张表当作起点,而不是结论。如果你们团队大多发的是长度中等、内容各不相同的问题,vLLM 因为用户多、文档全,通常是更常见的第一选择。如果你的应用在每个请求前面都放同样的长指令或文档,很多智能体框架和检索系统就是这样,那么 SGLang 的前缀复用值得测试。如果同时使用者不到三个人,额外的配置工作很少能回本。
用你自己的负载做测试
公开的基准数字很少与你的提示一致,所以要自己测。收集五十条真实的提示,包含它们平常的长度,并包括几条很长的。按你真正需要的上下文长度启动服务,然后用一个小脚本分别以 1、4、8 个并发请求发出这些提示,记下首个 token 的时间和每一轮的总时间。运行时观察 GPU 显存:如果请求排队或被拒绝,就降低上下文长度、改用更小或量化的模型,或者增加一块 GPU。如果你装了 Ollama,也用同样的测试再跑一遍,这样对比才公平。我们不公布这些引擎的速度数字,因为它们很大程度上取决于模型、显卡和设置,真正重要的是你自己硬件上的结果。
第一次测试要小而无聊。先用一个很小的模型,证明驱动、Python 环境和网络路径都正常,再花一个晚上去下载大型检查点。之后再换成你真正打算提供服务的模型,并且每次只改一个设置,这样你才知道是哪一项改动起了作用。
常见错误
- 在另一个 GPU 任务旁边启动 vLLM:默认会预留大部分显存,请调低利用率或换一块 GPU。
- 把最大上下文设得很大:这会减少能同时容纳的请求数,只设你真正需要的长度。
- 下载 GGUF 文件:推理服务引擎通常需要受支持格式的 Hugging Face 检查点。
- 用单个请求判断速度:vLLM 这类引擎的优势在并发场景,而不是单条提示。
- 不看支持模型列表:下载之前先确认你的模型架构受支持。
常见问题
vLLM 比 Ollama 更好吗?
不是绝对的。vLLM 为 GPU 上的大量同时请求而设计;Ollama 对单个用户更简单,也能在更普通的硬件上运行。
vLLM 能在 Mac 或 CPU 上运行吗?
文档列出了对 CPU 和苹果芯片的支持,但支持最完善的路径是 Linux 上的 GPU。请查看你所用平台的最新说明。
vLLM 用哪个端口?
服务默认监听本机的 8000 端口,你可以通过主机和端口选项更改地址。
为什么 vLLM 几乎占满了我的显存?
它的默认显存利用率是 0.92,并把权重之后剩下的显存分给 KV 缓存。如果需要给其他任务留空间,请调低这个设置。
SGLang 能取代 vLLM 吗?
两者解决的问题相似。SGLang 强调 RadixAttention 和前缀缓存,vLLM 则使用广泛、文档完善,请用你自己的负载分别测试。
vLLM 能用 GGUF 模型吗?
推理服务引擎通常使用 AWQ、GPTQ 或 FP8 等格式的 Hugging Face 检查点。GGUF 文件请用 llama.cpp 或 Ollama。
和我们聊聊
在为共享 GPU 服务器做容量规划,或者在几种引擎之间犹豫?欢迎加入社区,或发邮件到 admin@microaione.com。