
Qwen 本地部署:Qwen3 / 3.5 / 3.6 / 3.8 怎么选尺寸、怎么跑
核对说明:模型文件大小、上下文窗口和功能说明均读自 Ollama 官方模型页面(2026-10-30);显存估算取自 CanRun。我们没有自测速度或质量,也不引用厂商的跑分。第三方估算与实际加载可能有出入,以
ollama ps为准。
Qwen(通义千问)是目前本地部署里最常见的开源模型家族之一:尺寸从不到 1GB 的小模型到 140GB 以上的大模型都有,而且大多可以直接用 Ollama 一条命令运行。这篇文章聚焦 Qwen 本地部署:Qwen3、Qwen3.5、Qwen3.6、Qwen3.8、Coder 与 VL 各是什么、文件多大、你的显卡该选哪个,以及怎么跑起来、怎么控制思考模式。第一次用 Ollama 的话,请先看《Ollama 安装教程》。
Qwen 本地部署前:先认清 Qwen 家族
| 系列 | Ollama 上的尺寸(文件大小) | 上下文窗口(页面标注) | 输入 | 特点 |
|---|---|---|---|---|
| Qwen3 | 0.6b 523MB;1.7b 1.4GB;4b 2.5GB;8b 5.2GB;14b 9.3GB;30b 19GB;32b 20GB;235b 142GB | 多数 40K;4b、30b、235b 为 256K | 文本 | 稠密与 MoE 混合家族,支持 100 多种语言 |
| Qwen3.5 | 0.8b 约 1.2GB;2b 约 2.7GB;4b 约 3.3GB;9b 约 6.6GB;27b 17–20GB;35b 22GB;122b 81GB | 256K | 文本与图像 | 统一的视觉-语言基础模型 |
| Qwen3.6 | 27b 18–19GB;35b 23GB | 256K | 文本与图像 | 强化智能体编程;可保留历史思考内容 |
| Qwen3.8 | 27b 18GB | 256K | 文本与图像 | 思考模式默认开启,可按请求关闭 |
| Qwen3-Coder | 30b 19GB;480b 290GB | 256K | 文本 | 面向代码的 MoE 模型,30B 总参数、约 3.3B 激活 |
| Qwen3-VL | 2b 1.9GB;4b 3.3GB;8b 6.2GB;30b 20GB;32b 21GB;235b 143GB | 256K | 文本与图像 | 视觉理解,需要 Ollama 0.12.7 或更新版本 |
几个要点:Qwen3 的 30B 是 MoE 模型,每次只激活约 3.3B 参数,生成速度较快,但整份文件(19GB)都要放进内存;Qwen3-Coder 的 480B 本地至少需要 250GB 内存,不是个人设备的范畴;尺寸标注是 Ollama 默认量化的文件大小,不同标签(如 MLX 版本)略有差异。
Qwen 本地部署的显存对照:按显卡选尺寸
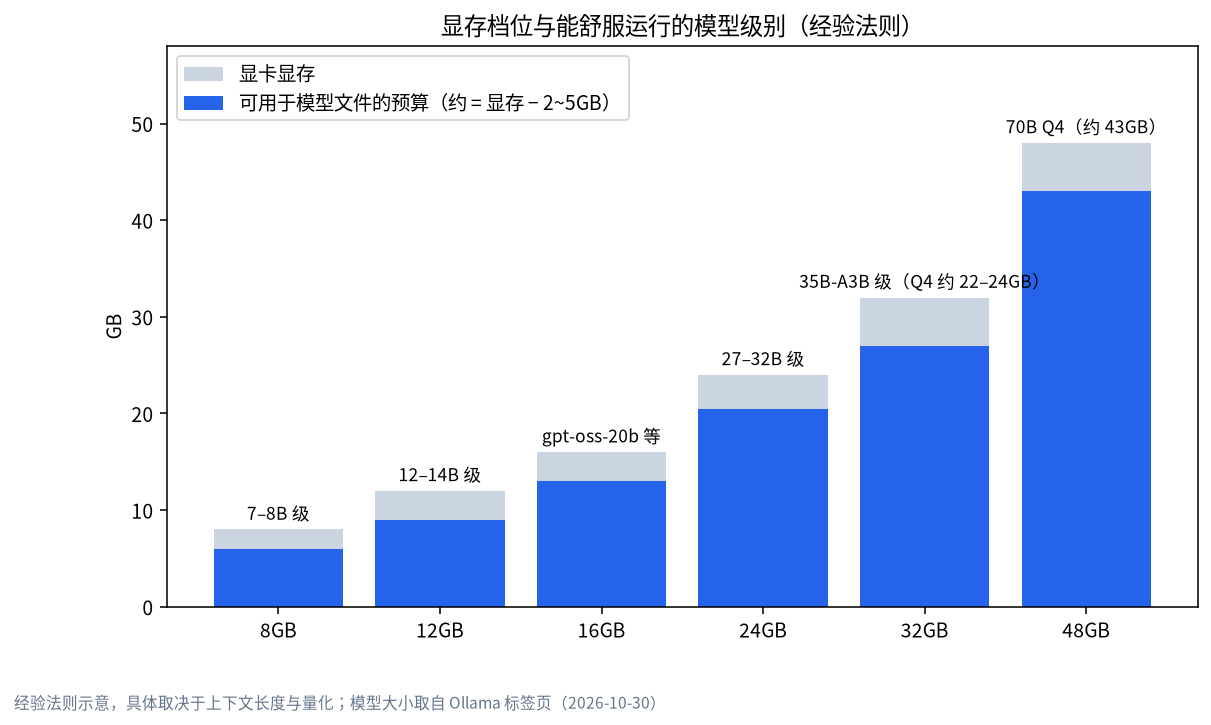
下表结合 Ollama 文件大小与 CanRun 对 8k 上下文的估算:
| 显存档位 | 推荐 Qwen 标签 | 文件大小 | CanRun 8k 估算 | 说明 |
|---|---|---|---|---|
| 8GB | qwen3:8b |
5.2GB | 未单列 | 4k 上下文;留意 8GB 的可用量约 7.4GB |
| 8GB | qwen3.5:9b |
6.6–7.6GB | 未单列 | 可识图,但余量很小 |
| 12GB | qwen3:14b |
9.3GB | 10.5GB | 刚好放下,上下文控制在 4k–8k |
| 16GB | qwen3:14b |
9.3GB | 10.5GB | 余量宽裕,可开更长上下文 |
| 24GB | qwen3.6:27b |
18–19GB | 17.2GB | 余量最宽裕的 27B |
| 24GB | qwen3.8:27b |
18GB | 17.6GB | 同级别,较新 |
| 24GB | qwen3:30b(MoE) |
19GB | 19.8GB | 速度快 |
| 24GB | qwen3:32b |
20GB | 22.0GB | 余量很小,只适合短上下文 |
| 24GB | qwen3.6:35b(MoE) |
23GB | 21.8GB | 偏紧 |
| 64GB 以上统一内存 | qwen3.5:122b |
81GB | 未单列 | 需要大内存设备 |
CanRun 对 Qwen 的估算:Qwen3 14B 在 8k 上下文下合计约 10.5GB;Qwen3.6 27B 约 17.2GB(权重 16.1GB 加 KV 缓存 0.5GB);Qwen3.8 27B 约 17.6GB;Qwen3 30B-A3B 约 19.8GB;Qwen3 32B 约 22.0GB(权重 19.3GB 加 KV 缓存 2.1GB);Qwen3.6 35B-A3B 约 21.8GB。8GB 显卡可用约 7.4GB,12GB 显卡可用约 11.4GB,24GB 显卡可用约 23.4GB。显存计算方法见《大模型显存需求怎么算》。
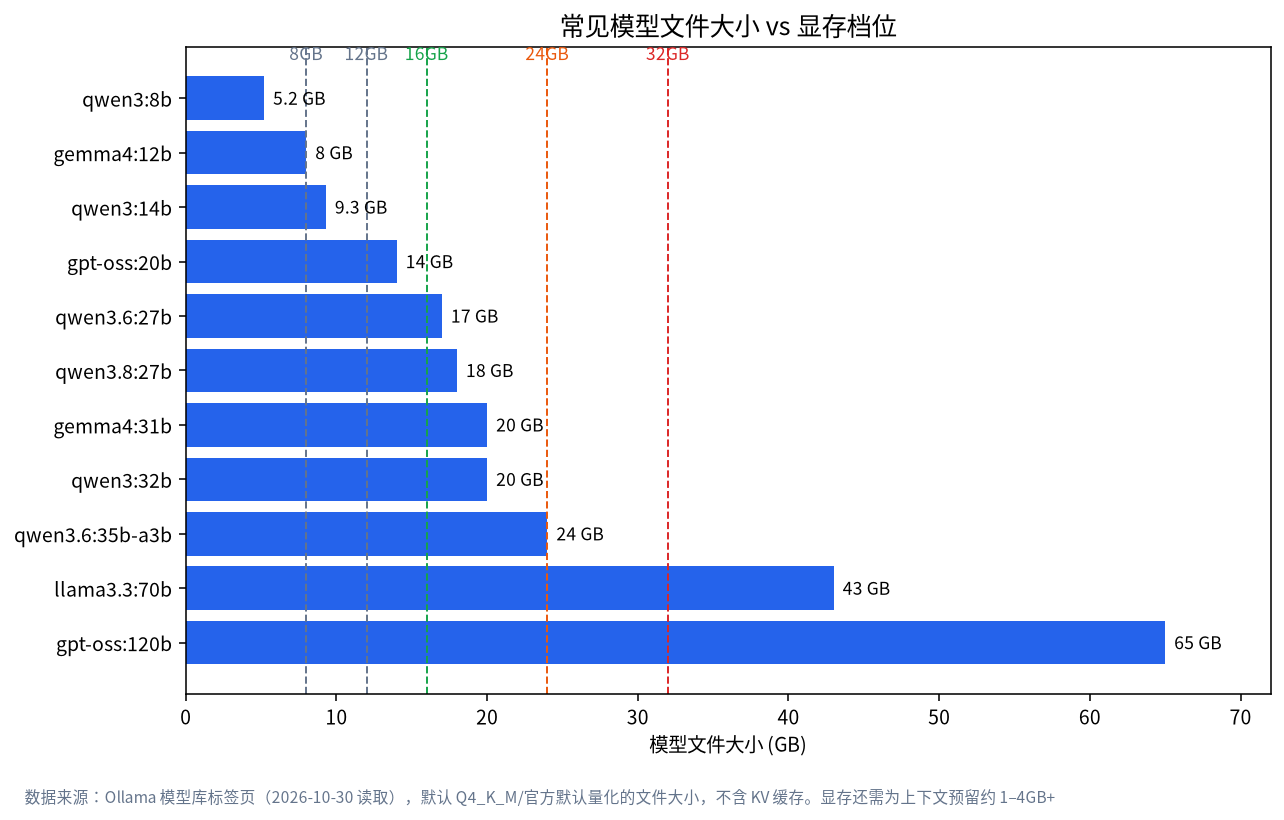
各档位的详细玩法:8GB 看《8GB 显存跑大模型》,24GB 看《24GB 显存跑大模型》。
一步步跑起来
假设你已经装好了 Ollama。
ollama pull qwen3:8b
ollama run qwen3:8b
第一条命令下载模型,第二条进入对话。想要更新的 27B 级模型:
ollama run qwen3.6:27b
加载完成后,用另一个终端运行 ollama ps,查看 PROCESSOR 是否是 100% GPU;如果出现 CPU 占比,说明显存放不下,请换小一档的模型。
通过接口调用同样简单,Ollama 页面给出的示例格式如下:
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3.6:27b",
  "messages": [{"role": "user", "content": "你好!"}]
}'
如果想要带界面的聊天体验,请看《Open WebUI 搭建教程》。
Qwen 的思考模式:开还是关
Qwen3.8 页面写明:思考模式默认开启,可以按请求关闭,推理深度可用 reasoning_effort 调节,历史思考内容可用 preserve_thinking 保留;Qwen3.6 则新增了保留历史消息中推理上下文的选项。
在 Ollama 的接口里,可以用 think 字段控制:true 请求思考输出,false 请求不输出思考(如果模型允许),不设置则用模型默认。思考内容和最终答案分别在 message.thinking 和 message.content 两个字段里返回。官方文档还说明:不同模型的思考控制不同,可以通过 /api/show 查看模型支持的取值。
使用建议:写作、聊天、翻译可以关闭思考,响应更快;数学、逻辑、复杂编程再打开。注意思考过程会消耗上下文和时间,同时在 24GB 以下的显卡上,上下文还要预留给思考内容。
编程场景:Qwen3-Coder 与新版 27B
Qwen3-Coder 的 30B 版本在 Ollama 上的文件大小是 19GB,页面标注上下文 256K,30B 总参数、约 3.3B 激活,适合在 24GB 显卡上做代码补全和仓库级阅读。Ollama 页面还列出了 ollama launch claude --model qwen3-coder 之类的启动方式,可以把本地模型接入常见的编程智能体工具,具体支持的工具与版本以官方页面为准。
Qwen3.6 的页面强调“智能体编程”的升级。需要注意:智能体和编程工具通常需要较长的上下文(官方建议至少 64000 token),在 24GB 以下显卡上要么选更小的模型,要么配合 KV 缓存量化,参见《大模型量化与 Q4_K_M》。
视觉模型:Qwen3-VL 与 Qwen3.5/3.6 的图像输入
Qwen3-VL 从 2b(1.9GB)到 235b(143GB)共有六档,8b 版本只有 6.2GB,适合 8GB 显卡看图。Qwen3.5、Qwen3.6 和 Qwen3.8 的页面则标注输入为“文本与图像”,也就是新一代模型本身就带视觉能力。需要识别截图、表格或文档图片时,可以直接选这些模型,不必另装视觉模型。
许可与商用
我们核对到的 Hugging Face 模型页面显示 Qwen3.6-27B 使用 Apache-2.0 许可证,Qwen3 与 Qwen3.8 同样标注为 Apache-2.0。Apache-2.0 一般允许商用,但需要保留版权与许可声明。具体到你要用的模型,请阅读该模型页面上的许可证原文,不要只看本文;对公司内部使用或私有化交付有疑问时,应由法务确认。
量化档位怎么选
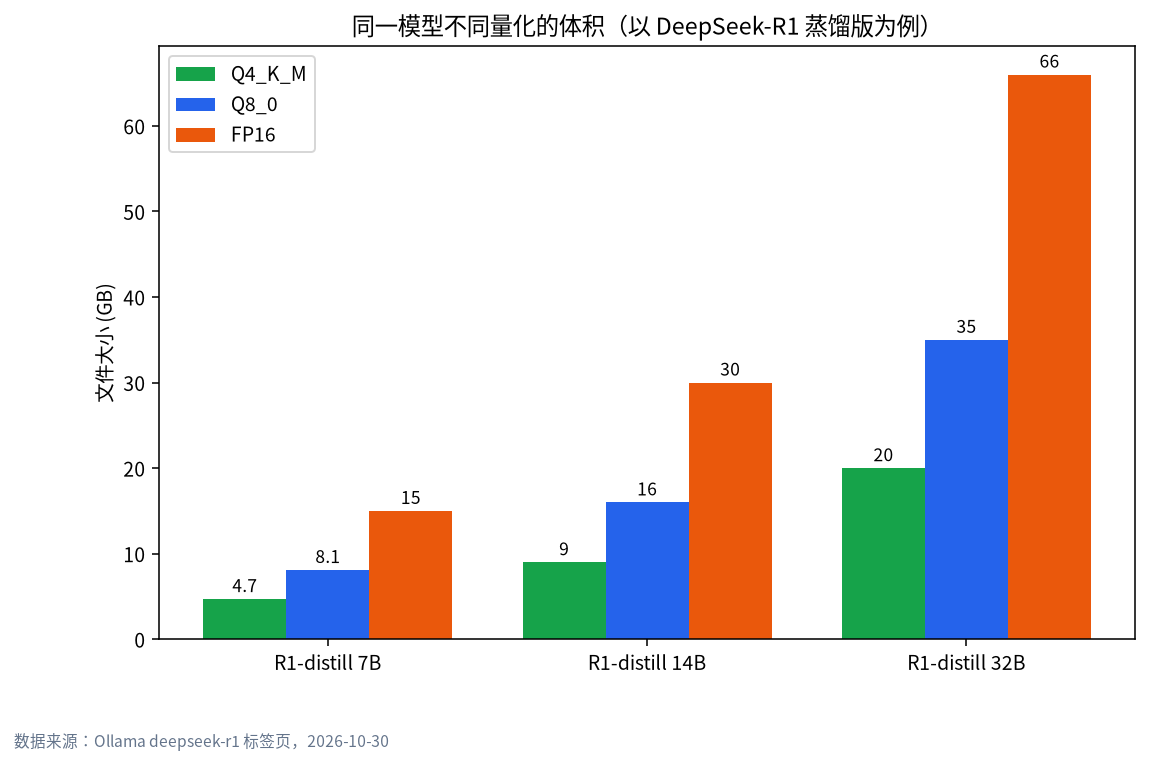
同一个 Qwen 模型有不同量化档位,文件大小差别很大。下表取自 Ollama 标签页(2026-10-30):
| 模型 | Q4_K_M | Q8_0 | BF16/FP16 | 建议 |
|---|---|---|---|---|
qwen3.6:27b |
17GB | 30GB | 56GB | 24GB 卡选 Q4_K_M;Q8_0 需要 32GB 以上 |
qwen3:32b |
20GB | 35GB | 66GB | 24GB 卡只能选 Q4_K_M |
qwen3:30b-a3b |
19GB | 33GB | 61GB | 同上 |
对大多数人来说,Q4_K_M 是文件大小和质量之间的合理折中;原因与取舍见《大模型量化与 Q4_K_M》。直接用默认标签(不带后缀)就是 Ollama 推荐的默认量化。
Mac 用户:MLX 标签
Ollama 为部分 Qwen 模型提供了 -mlx 标签,例如 qwen3.6:27b-mlx(19GB)、qwen3.6:35b-mlx(23GB)、qwen3.5:9b-mlx(8.9GB),面向 Apple 芯片。统一内存的大小决定你能选多大的尺寸,Mac 的 GPU 只能用到约 70% 的内存,见《Mac 跑大模型怎么选》。具体能否使用 MLX 标签取决于你的 Ollama 版本,请以官方页面的说明为准。
按使用场景选 Qwen
| 场景 | 建议 | 备注 |
|---|---|---|
| 日常聊天、翻译 | qwen3:8b(8GB)或 qwen3.6:27b(24GB) |
可关闭思考提速 |
| 看图、识别截图 | qwen3-vl:8b(6.2GB)或带图像输入的新版 |
视觉模型需要 Ollama 0.12.7+ |
| 写代码、仓库阅读 | qwen3-coder:30b(19GB) |
24GB 卡的主力 |
| 数学与逻辑推理 | 打开思考模式的 27B 级 | 思考内容占上下文 |
| 低配电脑、速度优先 | qwen3:4b(2.5GB)或 qwen3:1.7b(1.4GB) |
能力有限,适合轻任务 |
更新与清理模型
Qwen 系列更新很快,Ollama 页面上的标签和大小也会变化。想拿到最新版本,可以重新执行 ollama pull 模型名;用 ollama list 查看已下载的模型,用 ollama rm 模型名 删除不用的,释放硬盘空间。每个模型都是几 GB 到几十 GB,建议定期清理。
与其他热门模型的对比
| 模型 | Ollama 文件大小 | 24GB 卡能否放下 | 特点 |
|---|---|---|---|
qwen3.6:27b |
18–19GB | 能,余量宽裕 | 稠密;强化智能体编程 |
gemma4:31b |
19GB(默认标签) | 能 | 稠密;Apache-2.0 |
deepseek-r1:32b |
20GB | 能,余量小 | 推理模型,思考内容长,见《DeepSeek 本地部署》 |
llama3.3:70b |
43GB | 不能 | 需要 48GB 以上 |
更多横向比较与场景推荐见《本地大模型推荐》。
部署之后:让同事也能用
如果你想让家里或公司内网的其他设备用同一台机器上的 Qwen,可以让 Ollama 监听局域网地址(环境变量 OLLAMA_HOST),再配合 Open WebUI 提供网页界面和账号,详细步骤见《Open WebUI 搭建教程》。需要提醒的是,只应在可信的内网中这样做;暴露到公网需要额外的认证和防护。多人同时使用时,显存要同时容纳模型和多份上下文缓存,OLLAMA_NUM_PARALLEL 越大,占用越多,所以并发需求较高的团队,应该按并发量重新估算显存,而不是照搬单人使用的数字。
选型小结
- 先按显存选尺寸:8GB 选 8B–9B,12GB–16GB 选 14B,24GB 选 27B–32B。
- 再按用途选系列:聊天选 Qwen3 或新版 27B,代码选 Qwen3-Coder,看图选 VL 或新版。
- 最后用
ollama ps验证并调整上下文与思考模式。
Qwen 排错清单
- 下载很慢:模型文件几个到几十 GB,建议换到网络稳定的时段;中断后重新执行同一条命令会续传。
- 提示模型不被支持:Qwen3-VL 需要 Ollama 0.12.7 或更新版本,先升级 Ollama。
- 没用到 GPU:检查驱动和
ollama ps,见《Ollama 常见报错》。 - 越聊越慢或忘记前文:很可能是上下文太短或缓存爆显存,见《大模型显存需求怎么算》。
- 回答前停顿很久:思考模式在“想”,对简单任务可以关闭。
常见问题(FAQ)
Qwen3、Qwen3.5、Qwen3.6、Qwen3.8 该选哪个?
追求稳定和资料多可选 Qwen3;需要图像输入和较新能力,可选 Qwen3.5、Qwen3.6 或 Qwen3.8。具体以你的显存和用途为准,先用上方对照表选尺寸。
8GB 显卡能跑 Qwen 吗?
可以,qwen3:8b(5.2GB)或 qwen3.5:9b(6.6–7.6GB)都能运行,但上下文要控制,见《8GB 显存跑大模型》。
24GB 显卡首选哪个 Qwen?
qwen3.6:27b 或 qwen3.8:27b 余量最宽裕;想要更快的生成速度可选 qwen3:30b(MoE)。
Qwen 能商用吗?
我们看到的 Qwen3、Qwen3.6、Qwen3.8 页面标注为 Apache-2.0,一般允许商用,但请以所用模型的许可证原文为准。
Qwen 和 DeepSeek 有什么区别?
Qwen 提供从极小到很大的各种尺寸,DeepSeek-R1 更偏向推理场景。同级别的文件大小对比见上表。
能不能不用 Ollama,用 LM Studio?
可以,LM Studio 提供图形界面,见《LM Studio 教程》。
下一步与社区
Qwen 家族更新很快,哪个尺寸适合你的设备,欢迎到社区交流(加入社区)。我们在深圳做本地大模型机器的选型、采购、组装与实测,也可以根据你想跑的模型规模给出硬件建议;先聊需求,不强制购买。