MoE 模型本地运行指南:为什么 30B 的模型能像 3B 一样快
浏览模型列表时,你会看到 Qwen3-30B-A3B 或 gpt-oss-20b 这样的名字,似乎同时宣称自己又大又小。它们就是 MoE 模型,即混合专家模型,会改变本地大模型对硬件的通常规则。它们需要为所有参数准备内存,但每个 token 只读取其中一小部分,所以生成速度可以比同样文件大小的稠密模型快得多,尤其是在内存很大、带宽一般的机器上。这篇指南解释这个思路,给出你今天就能运行的模型的数字,展示推算的速度上限,并介绍让 MoE 在家用硬件上变得实用的选项。
核对说明:参数量来自 Hugging Face 上 gpt-oss(OpenAI)、Qwen3-30B-A3B(Qwen)和 DeepSeek-V3 的模型卡;下载大小来自 Ollama 模型库;llama.cpp 的选项来自其服务器文档,均于 2026-10-30 核对。速度上限是我们根据内存带宽推算的估计,不是基准测试,写这篇文章时我们没有运行这些模型。
要点速览(更新于 2026-10-30)
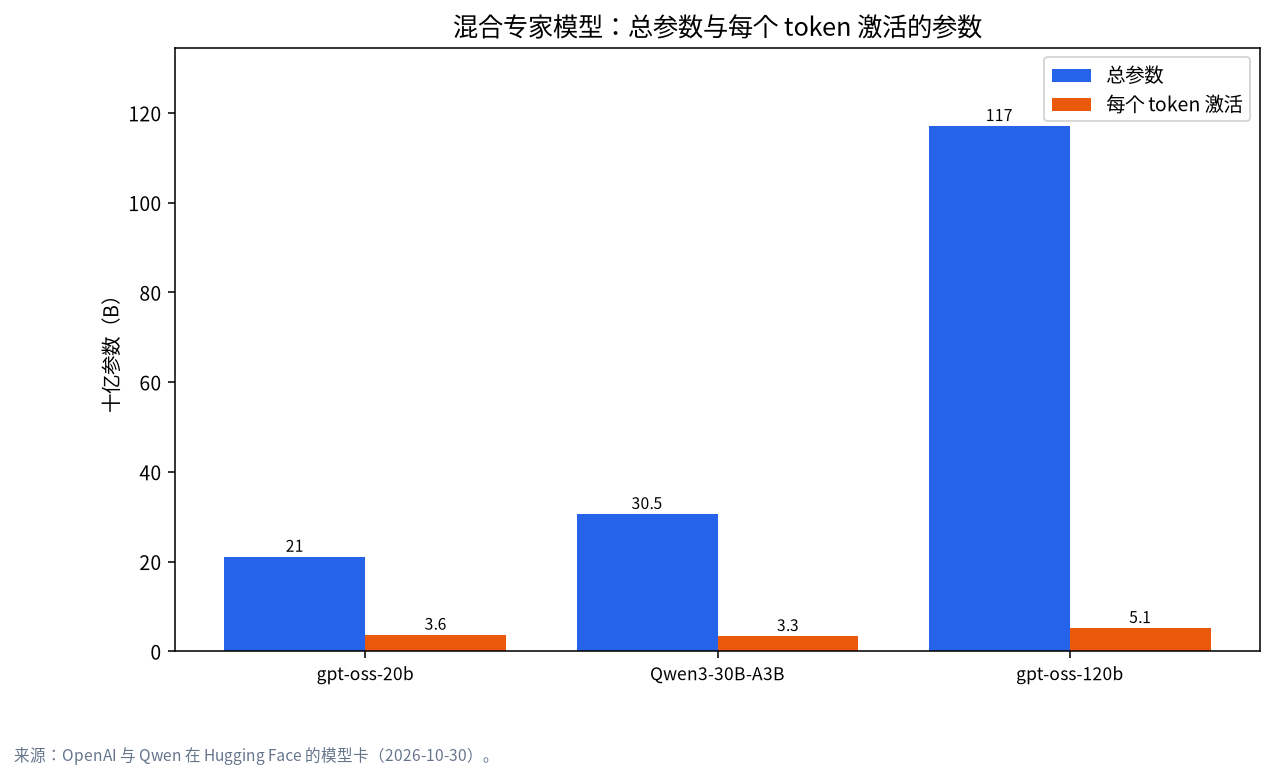
- MoE 模型把所有专家都存在内存里,但每个 token 只激活几个:gpt-oss-20b 有 21B 参数、激活 3.6B,Qwen3-30B-A3B 有 30.5B、激活 3.3B,gpt-oss-120b 有 117B、激活 5.1B。
内存容量仍然要装下整个模型,在 Ollama 模型库里 gpt-oss-20b 约 14GB,gpt-oss-120b 约 65GB,但速度取决于激活的权重,所以 MoE 模型在系统内存上也跑得不错。
llama.cpp 可以用
--cpu-moe或--n-cpu-moe把专家权重留在 CPU,把共享层放在 GPU;这是对“普通显卡加大量内存”最好的利用方式。
一段话讲清稠密模型与 MoE
在 Llama 3.1 70B 这样的稠密模型里,每个参数都参与产生每个 token,所以每个 token 都要读完 Q4_K_M 文件的全部 43GB。在混合专家模型里,每一层的前馈部分被拆成许多小的专家网络,由路由器为每个 token 挑选其中几个。例如按模型卡所说,Qwen3-30B-A3B 每层有 128 个专家,每个 token 只用其中少数几个。注意力层和路由器是共享的,始终被使用。结果就是:一个拥有大型网络的知识容量、却只有小型网络的单 token 计算量的模型。
你能运行的模型的数字
| 模型 | 总参数 | 每个 token 激活 | Ollama 下载大小 |
|---|---|---|---|
| gpt-oss-20b | 21B | 3.6B | 14GB |
| Qwen3-30B-A3B | 30.5B | 3.3B | 19GB |
| gpt-oss-120b | 117B | 5.1B | 65GB |
| DeepSeek-V3 | 671B | 37B | 大多数家用环境装不下 |
OpenAI 把 gpt-oss-120b 描述为可以装进单张 80GB GPU,把 gpt-oss-20b 描述为面向本地使用,这与上面的文件大小一致。DeepSeek-V3 的模型卡写的是总共 671B 参数、每个 token 激活 37B,这在最大规模上展示了同样的规律:它每个 token 的计算量相当于 37B 的模型,而内存需求却是 671B 的。我们关于 gpt-oss 的文章讲了实际运行,最佳模型清单则比较了 MoE 与稠密模型的选择。
MoE 对内存与速度的影响
先说容量。整个模型必须存放在某处,所以同样文件大小的 MoE 模型所需内存与稠密模型相同。14GB 的 gpt-oss-20b 放不进 8GB 的显卡,65GB 的 gpt-oss-120b 需要大容量统一内存的机器或者很多内存。我们的显存计算指南对容量的规则完全适用,照常为上下文留出空间。
速度才是 MoE 的好处所在。我们在内存与显存的文章里得出的规则是:每个 token 都需要从内存里读取激活的权重,所以速度上限等于内存带宽除以每个 token 读取的字节数。对稠密模型,这就是整个文件;对 MoE 模型,大致是激活的那部分。我们把每个 token 的读取量估算为文件大小乘以激活参数再除以总参数,这只是近似,因为注意力权重总是被读取,不同的 token 也会用到不同的专家。
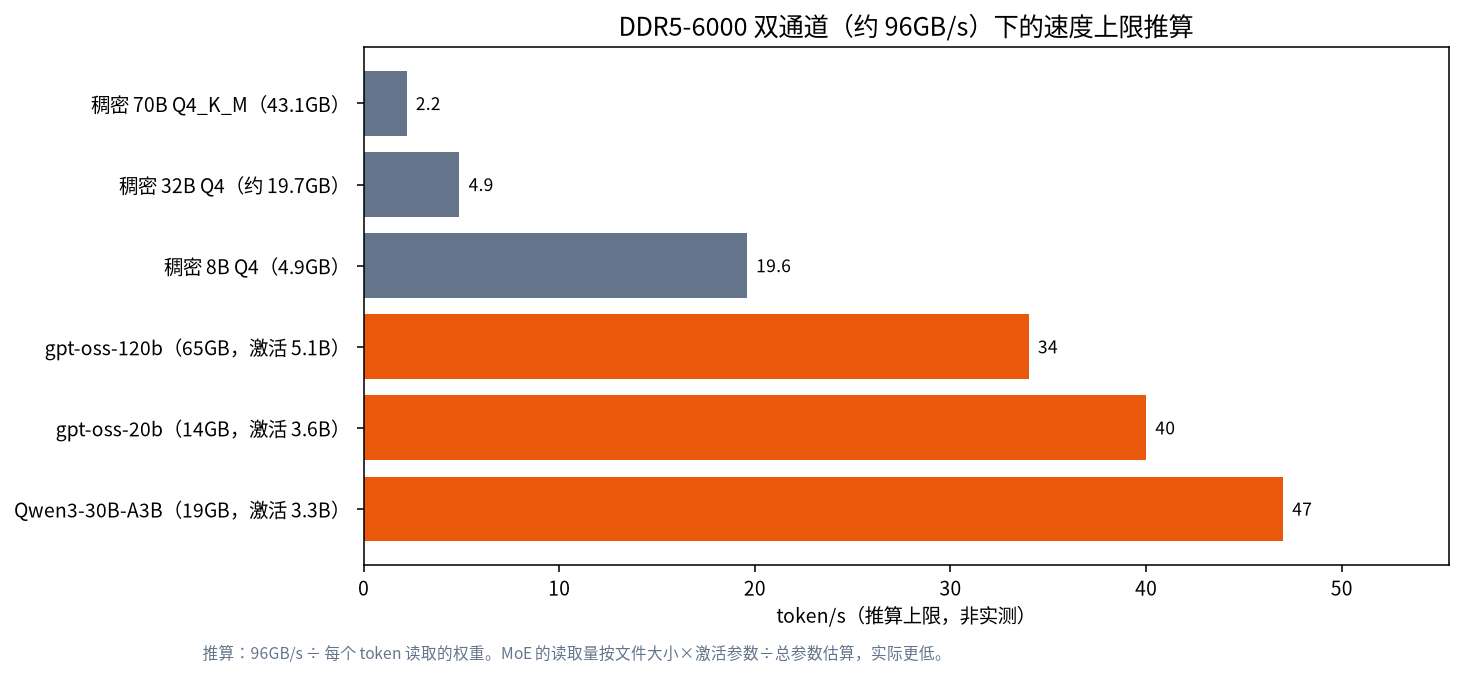
在约 96 GB/s 的双通道 DDR5-6000 上,稠密 70B 的 Q4_K_M 模型上限约为每秒 2.2 个 token,稠密 32B 约为 4.9。相比之下,我们对 gpt-oss-20b 的估算约为 40,对 Qwen3-30B-A3B 约为 47,即使是 gpt-oss-120b,只要模型放得进内存,也约为 34。这些是理论上限,实际速度更低,但稠密和 MoE 之间的差距是真实而且很大的。这解释了为什么人们反映 MoE 模型在没有强力 GPU 的机器上,包括笔记本和迷你主机上,用起来很快;请看我们的迷你主机指南。
提示处理是另一回事。当你粘贴一份长文档时,模型要先读完它才开始回答,这一阶段受计算能力的限制比受内存带宽的限制更大,所以慢速 CPU 上的 MoE 模型,在长提示的前几秒仍然可能显得迟钝。处理共享层的 GPU 在这里帮助最大,这也是为什么要把普通显卡与大量内存搭配,而不是只依靠 CPU。
在普通硬件上运行 MoE 模型
有三种实用的配置。
- 全部放在 GPU 上:如果整个模型能放进显存,MoE 模型就是非常快。16GB 的显卡可以放下 14GB 的 gpt-oss-20b 下载文件,并留有适度的上下文。
- 共享层在 GPU,专家在内存:llama.cpp 有
--cpu-moe,把所有专家权重留在 CPU;还有--n-cpu-moe N,只对前 N 层这样做。注意力和共享部分留在显存里,因为每个 token 都会用到;庞大的专家权重放在便宜的系统内存里,每个 token 只读取其中几个。这种配置让 12GB 或 16GB 的卡能以出人意料的可用速度运行比显存大得多的模型。llama.cpp 文档还列出了一个针对留在 CPU 上的专家的缓存选项。 - 全部放在内存里:在有 64GB 或更多高速内存的机器上,仅靠 CPU 就能以可读的速度运行 gpt-oss-120b,不过比有 GPU 帮忙时更慢。
无论哪种配置,都要记住上下文也需要内存。我们的上下文长度指南解释了 KV 缓存,对于 MoE 模型,缓存与相同层宽的稠密模型相近,所以长上下文仍然可能用光显存。
一份算好的内存方案
以一台配有 12GB 显卡和 64GB 系统内存的台式机为例,假设你想试 gpt-oss-120b,它在 Ollama 的下载大小是 65GB。模型本身就略大于内存,所以这台机器没法靠大量使用磁盘来运行它,那样太慢了。更合理的目标是 19GB 的 Qwen3-30B-A3B。12GB 的显卡放不下全部,但专家可以放在内存里,占据这 19GB 的大部分,而共享层和适度上下文的 KV 缓存则使用显卡。操作系统和其他程序仍需要几个 GB,所以 64GB 的机器空间绰绰有余。如果升级到 128GB 内存,例如在统一内存的迷你主机上,gpt-oss-120b 就变得现实了,我们推算的 DDR5 级带宽上约 34 token/s 的上限说明了为什么大家觉得它可用。
同样的算术也告诉你什么不该买。一套 64GB 的内存救不了 117B 的模型,而放在内存里的专家,换更快的 GPU 帮助也不大,因为这些层的速度由内存带宽决定。如果想在这个方案里提高速度,更快的双通道内存,或者内存通道更多的平台,比换更大的显卡更有用。
怎样确认它在正常工作
用正常的日志启动 llama.cpp 并阅读加载信息:它会报告有多少层被卸载到 GPU 以及每个缓冲区的大小,所以你能看到有多少在显存、有多少在 CPU 内存。模型生成时用 nvidia-smi 观察显存。如果显存几乎是空的,说明你的参数让太多内容留在了 CPU;如果显存已满并且程序报错,就减小上下文,或把更多专家移到 CPU。然后生成一段长回答并记下速度。每次只改一个参数并做好记录,因为最佳设置取决于你的模型、内存条和上下文长度。用 Ollama 时选择是自动的,ollama ps 会显示 CPU 与 GPU 的分配。
稠密还是 MoE:怎么选
| 情况 | 更好的选择 | 原因 |
|---|---|---|
| 12GB 到 16GB 显卡,内存很多 | 专家放内存的 MoE | 快,知识容量更大 |
| 显存充足,想要同等大小下最好质量 | 稠密模型 | 每存储一个 GB 往往更强 |
| 只有 CPU 的笔记本或迷你主机 | 小型 MoE | 速度取决于激活的权重 |
| 总内存紧张 | 量化后的小型稠密模型 | MoE 仍要存储全部权重 |
| 在家做微调 | 小型稠密模型 | 工具更简单 |
公平地总结:MoE 是用内存换速度。你付出的是容量,因为 30B 的 MoE 文件和 30B 稠密文件一样大,而节省的是带宽。如果你的瓶颈是内存容量,MoE 帮不上忙;如果你的瓶颈是廉价硬件上的速度,它能彻底改变体验。
质量、量化与注意事项
不要假定某个总大小的 MoE 模型在质量上等同于同样大小的稠密模型,也不要假定它等同于与激活大小相同的稠密模型。实际上,MoE 模型的质量介于两者之间,取决于训练,也随任务而异,所以请用你自己的提示去测试。量化同样适用于 MoE 模型,我们的 Q4_K_M 指南里讲的各种缩减对它们同样适用;gpt-oss 系列以紧凑的原生格式发布,所以它们的文件比参数量所暗示的要小。各个程序的工具支持仍然不均衡,所以在下载大文件前,请确认你运行时的版本支持该架构。
常见错误
- 把“A3B”当成 3B 的内存需求:整个模型都要存储,只有速度取决于激活的部分。
- 把专家放在慢速硬盘上还期待 MoE 的速度:专家要放内存或显存,不要放在交换空间。
- 忽视上下文内存:KV 缓存仍然随上下文长度增长。
- 只用激活参数比较质量:总大小和训练同样重要。
- 忘了运行时版本:新架构需要较新的 llama.cpp 或 Ollama。
常见问题
Qwen3-30B-A3B 里的 A3B 是什么意思?
按模型卡,它表示总共 30.5B 参数里,每个 token 约有 3B 参数处于激活状态(3.3B)。
MoE 模型需要的显存更少吗?
不是。它们需要为全部权重准备内存,是更快,而不是更小,不过你可以把专家留在系统内存里,从而使用更少的显存。
gpt-oss-20b 是 MoE 模型吗?
是。OpenAI 把它描述为 21B 参数、激活 3.6B,面向本地使用。
cpu-moe 是做什么的?
它让 llama.cpp 把专家权重留在 CPU,而其他层可以使用 GPU,这样能节省显存,速度损失不大。
MoE 模型比稠密模型更好吗?
不一定。它们对于相同大小来说每个 token 更快,但稠密模型在相同内存占用下往往更强,请在你自己的任务上测试。
我能在家里运行 gpt-oss-120b 吗?
如果你有约 65GB 或更多可用内存,再加上上下文的空间,就可以运行,速度取决于你的带宽。
和我们聊聊
在为你的硬件选稠密模型还是 MoE 模型?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:gpt-oss-20b 模型卡、Qwen3-30B-A3B 模型卡、DeepSeek-V3 模型卡、llama.cpp 服务器文档。