迷你主机跑大模型:128GB 统一内存的锐龙 AI Max+ 395、DGX Spark 与 Mac 怎么选
独立显卡的显存最大也就 24GB 或 32GB,想跑 70B、120B 的大模型,要么上多卡,要么上价格高昂的专业卡。2026 年出现了另一条路:迷你主机跑大模型。这类设备把 CPU 和 GPU 放在同一套大容量“统一内存”上,128GB 的内存可以直接让显卡部分使用,一个只有书本大小的盒子就能装下一个 100B 级的量化模型。但它不是万能的:能放得下,不等于跑得快。这篇文章讲清楚三类设备(锐龙 AI Max+ 395、DGX Spark、Mac)的内存、带宽、参考价格和取舍。如果你对统一内存还不熟,先看《Mac 跑本地大模型》,显存基础见《显存多大才够用》。
核对说明:规格来自 NVIDIA 与 AMD 官方页面及 AMD ROCm 技术博客(2026-10-30 读取);价格取自我们的参考价格表,是 2026-10-30 的中位参考价,不是报价;速度数字来自第三方文章,我们没有在自己的机器上复现,只用来说明量级。统一内存的“可用于显卡的部分”会受 BIOS、系统和软件限制,请以你的设备为准。
要点速览(更新于 2026-10-30)
- 128GB 统一内存放得下 70B 量化模型(约 43GB),但带宽约 256 GB/s,稠密 70B 理论上限只有约 6 字每秒。
稀疏(MoE)大模型最适合这类机器。
128GB 档参考价:锐龙 AI Max+ 395 约 24566 元,DGX Spark 约 42500 元,Mac Studio M5 Max 约 41749 元。
迷你主机跑大模型的关键:容量够,但带宽有限
先把原理讲清楚,这样后面的选择就容易了。大模型生成每一个字,都要把模型权重(或其中被激活的部分)从内存读一遍,所以生成速度的上限大致等于内存带宽除以每个字要读取的数据量。独立显卡的显存带宽很高,而统一内存设备的带宽低得多。
以锐龙 AI Max+ 395 为例:它使用 256 位 LPDDR5X-8000 内存,最大 128GB,理论带宽约 256 GB/s。AMD 称通过可变显存功能,最多可以把 96GB 分给显卡使用,4 位量化的模型最多可到约 1280 亿参数。我们读到的一个社区测试里,实测可用的显存带宽大约是 215 GB/s。
用这个带宽来估算:一个 70B 稠密模型 Q4_K_M 量化后约 43GB(llama.cpp 官方 quantize 文档的 Llama 3.1 70B 数据),每生成一个字都要读取这 43GB,理论上限约 256 ÷ 43 ≈ 6 个字每秒。这与第三方文章给出的约 6 tok/s 的量级一致。而对于只激活一小部分参数的稀疏(MoE)模型,每个字只需要读取激活的部分,速度会快得多:第三方测试给出的 gpt-oss-120b 生成速度大约在每秒 35 到 55 个字,取决于使用 Vulkan 还是 ROCm 后端;Qwen3-30B-A3B 约每秒 78 个字(Vulkan)。这些数字来自第三方文章,仅说明量级,你的实际速度会因软件版本和设置而不同。
结论:统一内存大机器最适合 稀疏(MoE)大模型,不太适合 70B 稠密模型。MoE 的细节见后续的专题文章。
三类设备对比
| 对比项 | 锐龙 AI Max+ 395 迷你主机 | NVIDIA DGX Spark | Mac Studio / Mac mini(M5 系列) |
|---|---|---|---|
| 内存 | 最高 128GB 统一内存,最多 96GB 可分给显卡 | 64GB 或 128GB 统一内存 | 24GB 至 128GB 多档,因机型而异 |
| 官方定位 | AI PC / 迷你工作站 | 桌面 AI 开发,最高 1 petaFLOP(FP4),官方称可推理最高 2000 亿参数的模型 | 通用电脑,MLX 与 llama.cpp 都支持 |
| 参考价(元,中位) | 约 24566(128GB) | 约 42500(128GB) | 约 41749(Mac Studio M5 Max 128GB),约 24249(Mac mini M5 Pro 64GB) |
| 系统与生态 | Windows 或 Linux,Vulkan/ROCm | 预装 NVIDIA 的 Linux,CUDA 生态 | macOS,Metal 与 MLX |
| 适合谁 | 想用最低价格拿到 128GB 容量 | 要做 CUDA 开发、微调、与服务器环境一致 | 想要安静、稳定、少折腾 |
参考价来自我们整理的 2026-10-30 价格表,各项分别来自 1 到 4 个报价,不同渠道、不同配置会有差异。DGX Spark 的美国商店标价曾缺货并两次上调,请以实时为准。
每 GB 内存多少钱
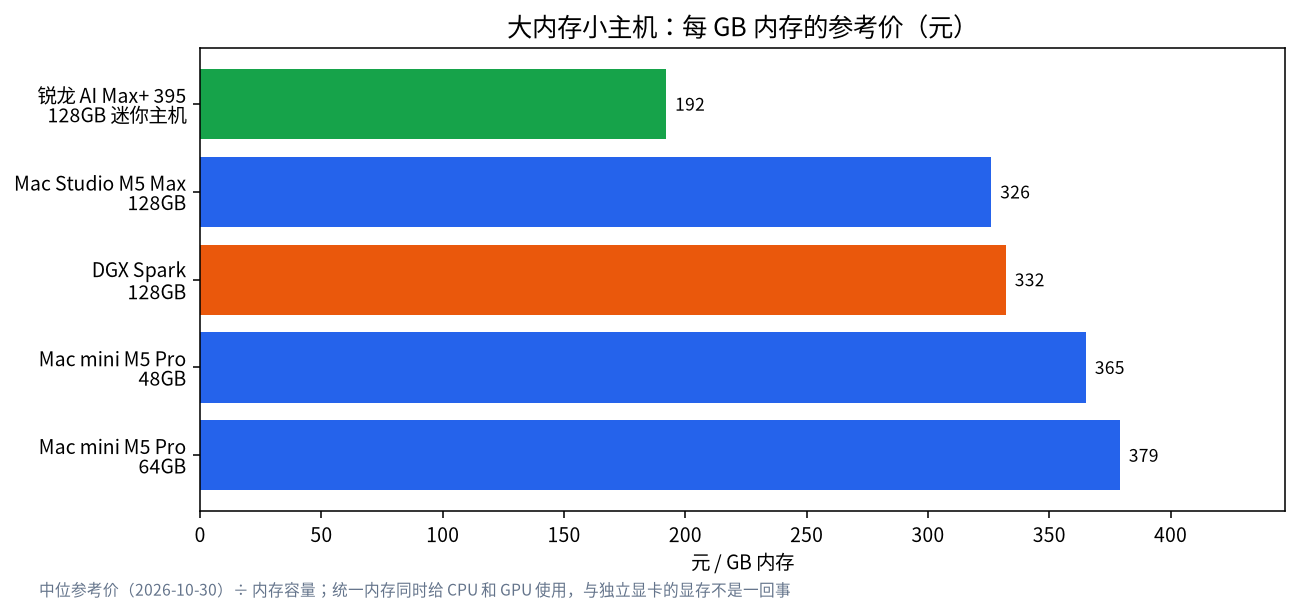
按参考价折算,128GB 的锐龙 AI Max+ 395 迷你主机每 GB 内存约 192 元,而 DGX Spark 约 332 元,Mac Studio M5 Max 128GB 约 326 元,Mac mini M5 Pro 64GB 约 379 元。图里能看出,锐龙迷你主机的容量单价最低,代价是软件生态相对更需要折腾,带宽并不比其他两者占优。但请注意:统一内存的“每 GB”和独立显卡显存的“每 GB”不是一回事,带宽差距很大,不能直接相比。显卡显存的单价比较见《二手显卡跑大模型》。
怎么选:从模型体积出发
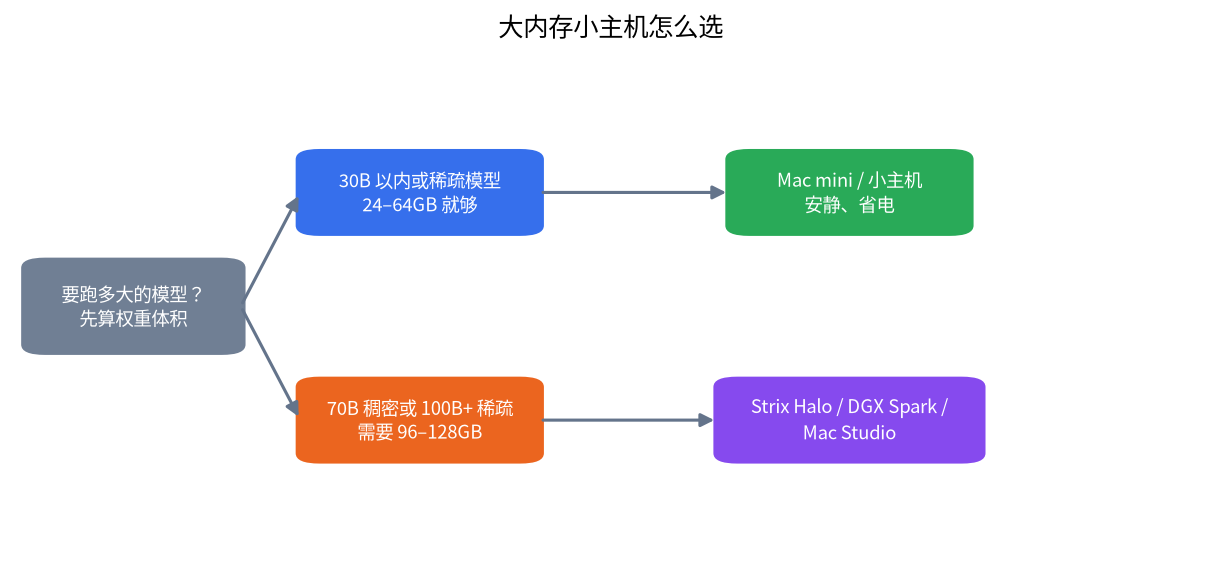
- 先算模型体积:用《大模型显存需求怎么算》估出权重和上下文的总需求。例如 30B 级模型 4 位量化后只要几十 GB,24–64GB 就够。
- 要跑 70B 稠密或 100B+ 稀疏模型:才需要 96–128GB。
- 看速度预期:稠密大模型在统一内存上只有每秒几个字,适合离线批处理或对话不追求实时的场景;稀疏模型的体验要好得多。
- 看使用习惯:要 Windows、想玩游戏,选锐龙;要 CUDA、微调,选 DGX Spark;想安静省心,选 Mac。
哪些模型放得下:用官方数据对照
下面用 llama.cpp 官方 quantize 文档里 Llama 3.1 系列的 Q4_K_M 文件大小(原始 16 位权重分别为 32.1GB、280.9GB 和 1625.1GB),对照两档内存。注意这里只算权重,没有计入上下文占用的 KV 缓存,也没有计入系统自身占用的内存,所以实际可用空间要比表中小。
| 模型 | Q4_K_M 约大小 | 64GB 统一内存 | 128GB 统一内存 | 说明 |
|---|---|---|---|---|
| Llama 3.1 8B | 4.9GB | 轻松放下 | 轻松放下 | 速度主要看带宽,通常很流畅 |
| Llama 3.1 70B | 43.1GB | 能放下,但余量有限 | 放得下,余量充足 | 稠密模型,速度受带宽限制明显 |
| Llama 3.1 405B | 249.1GB | 放不下 | 放不下 | 需要多机或服务器级设备 |
这张表的用处是帮你快速判断“能不能放进去”:64GB 档适合 30B 到 70B 的单个量化模型,128GB 档适合 70B 加长上下文,或同时加载两个模型。想跑 405B 这类超大模型,迷你主机不是合适的工具。同时,Q4_K_M 只是常见的折中选择,量化的取舍见《Q4_K_M 量化怎么选》,如果你想知道应该选哪个模型,可以看《本地大模型怎么选》。
一个简单的例子
假设你想在小办公室里本地跑一个约 120B 的稀疏模型,同时常驻一个 30B 模型处理日常问答。大模型 4 位权重要几十 GB,小模型再占一部分,长上下文的 KV 缓存还要留出空间。128GB 的机器可以从容应付,64GB 的机器就会比较紧张。反过来,如果你只跑 14B 的模型,64GB 的迷你主机已经是浪费,一张 16GB 的显卡装进普通台式机更便宜也更快。买之前先把要跑的模型列成清单,是避免为用不到的内存付费的最便宜办法。
实际使用中的几个注意点
- BIOS 与显存分配:锐龙迷你主机需要在 BIOS 或驱动里设置分给显卡的内存比例;AMD 的文档说明最多 96GB 可作为专用显存,具体以厂商 BIOS 为准。
- 软件后端:第三方测试普遍显示,短上下文生成时 Vulkan 往往更快,长上下文预填充和稳定性上 ROCm 更好。版本变化很快,建议两个都试。
- 长上下文:统一内存的容量虽大,但 KV 缓存同样要占内存,上下文越长,速度越慢,见《上下文长度与 KV 缓存》。
- 散热与噪音:小机箱满载时风扇声音较大,放置位置要考虑。
- 售后与固件:新平台的驱动和固件更新频繁,购买前看一下厂商的更新记录。
购买前的核对清单
- 把想跑的模型列出来,查清楚它们 4 位量化后的文件大小,再加上上下文需要的缓存。
- 确认厂商标注的内存是不是焊死的、能不能升级;这类机器的内存通常不能后期扩展。
- 确认可分配给显卡的内存上限,以及是否需要在 BIOS 里手动设置。
- 查看你要使用的软件(Ollama、llama.cpp、LM Studio)对该平台的支持情况和已知问题。
- 确认保修、固件更新渠道和散热设计,尤其是需要长时间满载运行时。
什么时候不该买
- 你的主要模型是 70B 稠密模型,并且要求每秒十几个字以上,这种情况下多卡 24GB 的方案更合适,见《24GB 显存跑大模型》。
- 预算有限,只想跑 8B 到 14B 的模型,一张 12GB 或 16GB 的显卡更便宜,整机方案见《本地大模型装机配置》。
- 需要大规模并发服务的团队,应该看服务器方案,而不是迷你主机。
常见问题
128GB 统一内存等于 128GB 显存吗?
不等于。统一内存由 CPU 和 GPU 共享,能分给显卡的比例受 BIOS 和系统限制,例如 AMD 说明最多 96GB 可作为专用显存。而且它的带宽远低于高端独立显卡。
迷你主机能跑 70B 模型吗?
能放得下,Q4 量化的 70B 约 43GB。但稠密 70B 在约 256 GB/s 带宽下,理论上限只有每秒 6 个字左右,更适合稀疏模型。
锐龙 AI Max+ 395 和 DGX Spark 选哪个?
要最低容量单价、想用 Windows 或 Linux,选锐龙;要 CUDA 生态、微调,或者要和服务器环境保持一致,选 DGX Spark。价格上,参考价约 24566 元对比约 42500 元。
迷你主机适合做家用 AI 服务器吗?
适合。功耗低、体积小、噪音可控,能用 Ollama 或 llama.cpp 对外提供接口,安装方法见《Ollama 安装教程》。
统一内存比独立显卡慢多少?
不同设备差距很大,统一内存设备的带宽通常比高端独立显卡低一个量级,所以同一个模型的生成速度会慢很多。可以用“带宽除以模型体积”做粗略估算。
现在的价格会继续涨吗?
2026 年内存价格上涨较明显,参考价格表里 DGX Spark 的美国标价就曾两次上调。我们不预测价格,建议按需求决定,并在下单前再查一次。
需要选型帮助
如果你想知道自己的模型能不能放进某台迷你主机,或者想要我们协助整机选型与交付,欢迎到社区交流,或发邮件到 admin@microaione.com,说明你的模型大小和预算。入门路线见《本地部署大模型入门》。
参考与延伸阅读:NVIDIA:DGX Spark、AMD:锐龙 AI Max+ 395、llama.cpp:quantize 文档。