内存和显存:本地大模型的 CPU 卸载如何工作,速度代价有多大
每个本地大模型用户迟早会遇到同一个提示:模型放不进显卡。程序并不会停下,而是悄悄把模型的一部分挪进系统内存,然后继续运行,只是慢得多。要判断这能不能接受,你需要弄清楚内存和显存各自做什么,为什么其中一个快得多,以及增加其中任何一种到底能得到什么。这篇指南用你可以复现的数字,一步步解释 CPU 卸载,最后给出什么时候多买系统内存值得的规则。默认你已经了解本地模型的 GPU 显存的基础知识。
核对说明:关于 Ollama 的
ollama ps中 Processor 一列,来自 Ollama 常见问题;llama.cpp 的选项(--n-gpu-layers、--cpu-moe、自动适配)来自 llama.cpp 服务器文档;GPU 带宽来自英伟达规格。DDR 带宽按“传输速率×8 字节×通道数”计算,PCIe 为理论值。速度上限是我们自己推算的,并已标注,写这篇文章时我们没有对卸载做基准测试。要点速览(更新于 2026-10-30)
- 生成每个 token 基本都要读取全部权重,所以速度受权重所在内存的带宽限制:3090 或 4090 的显存约 936 到 1008 GB/s,而普通双通道系统内存只有约 50 到 100 GB/s。
部分卸载的收益比比例看上去的要小:即使在 24GB 显卡上放了一半左右的 70B 模型,我们推算的上限也只有每秒几个 token,因为慢的那一部分起决定作用。
更多系统内存能让更大的模型加载,也有利于长上下文;但不会让被卸载的层变快。混合专家模型是值得研究的例外。
内存和显存各做什么
显存是显卡上的内存。它通过非常宽、非常快的总线连接到 GPU,所以现代显卡能达到每秒几百 GB 甚至更高:英伟达标注 RTX 3090 级别的带宽是 936 GB/s,RTX 4090 超过 1000 GB/s。系统内存挨着 CPU。普通台式机的双通道内存带宽低得多,而且 GPU 不能以全速直接读取它:数据必须穿过 PCIe 插槽,这比两种内存都还要慢。
语言模型一次生成一个 token,每生成一个 token,处理器都要读一遍模型权重。容量决定模型能否加载,带宽决定它跑得多快。我们关于计算显存的文章讲容量,这一篇讲容量用完之后会发生什么。
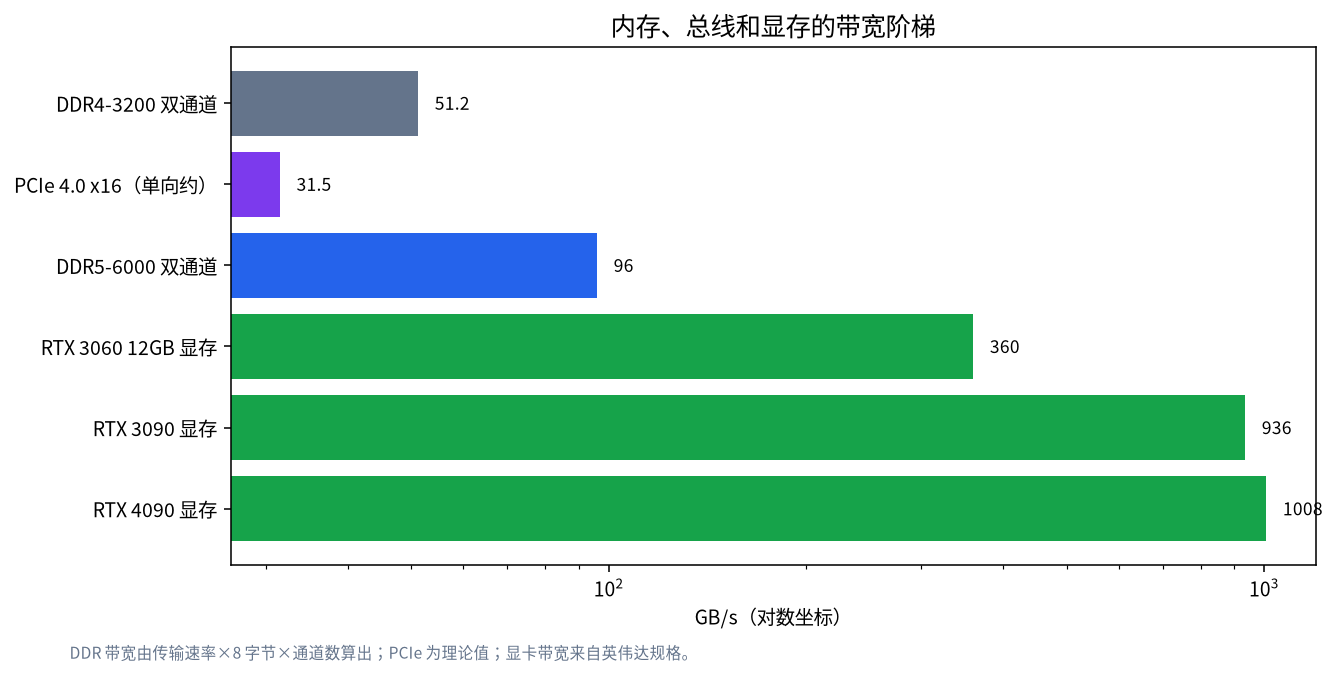
带宽阶梯
图表使用对数坐标,因为差距很大。DDR4-3200 的两个通道约提供 51 GB/s(每秒 32 亿次传输乘以 8 字节再乘以 2 个通道)。同样的算法,两通道的 DDR5-6000 约为 96 GB/s。一条 PCIe 4.0 x16 插槽理论上每个方向约 31.5 GB/s。相比之下,RTX 3060 12GB 是 360 GB/s,RTX 3090 是 936 GB/s,RTX 4090 是 1008 GB/s。也就是说,现代 GPU 的显存比不错的双通道 DDR5 快十倍,比 DDR4 快将近二十倍。这个比例就是卸载的全部故事。
CPU 卸载如何工作
llama.cpp 和 Ollama 都按层拆分模型。前面的层放进 GPU,直到显存装满,其余的层由 CPU 从系统内存里计算。在 llama.cpp 里,放在 GPU 上的层数由 --n-gpu-layers 控制,默认会自动选择以适配你的设备内存,另有一个适配选项会调整未设置的参数,以留出安全余量。Ollama 会替你做同样的决定并报告出来:ollama ps 命令会显示 Processor 一列,模型完全在 GPU 上时显示 100% GPU,完全在系统内存时显示 100% CPU,部分在两边时显示类似 48% CPU 和 52% GPU 的分配。
每生成一个 token,GPU 上的层跑得很快,CPU 上的层跑得很慢,两者都完成后这个 token 才算完成。总时间是两部分之和,所以一小块慢的部分就可以起决定作用。
70B 模型的算例
按我们的大小表,Q4_K_M 的 Llama 3.1 70B 约为 43.1GB。假设你有一张 24GB 的 RTX 3090,把其中约 20GB 放在卡上,剩下约 23GB 在系统内存里。每个 token,GPU 以 936 GB/s 读 20GB,约需 0.021 秒;CPU 以约 96 GB/s 的 DDR5-6000 读 23.1GB,约需 0.24 秒。总计约 0.26 秒每个 token,也就是上限约 3.8 token/s。如果是 DDR4-3200,CPU 部分需要 0.45 秒,上限降到约 2.1 token/s。完全用 CPU 的话,DDR5 的上限是 2.2 token/s,DDR4 是 1.2。相比之下,两张 24GB 显卡把所有内容放在显存里,上限约为 21.7。
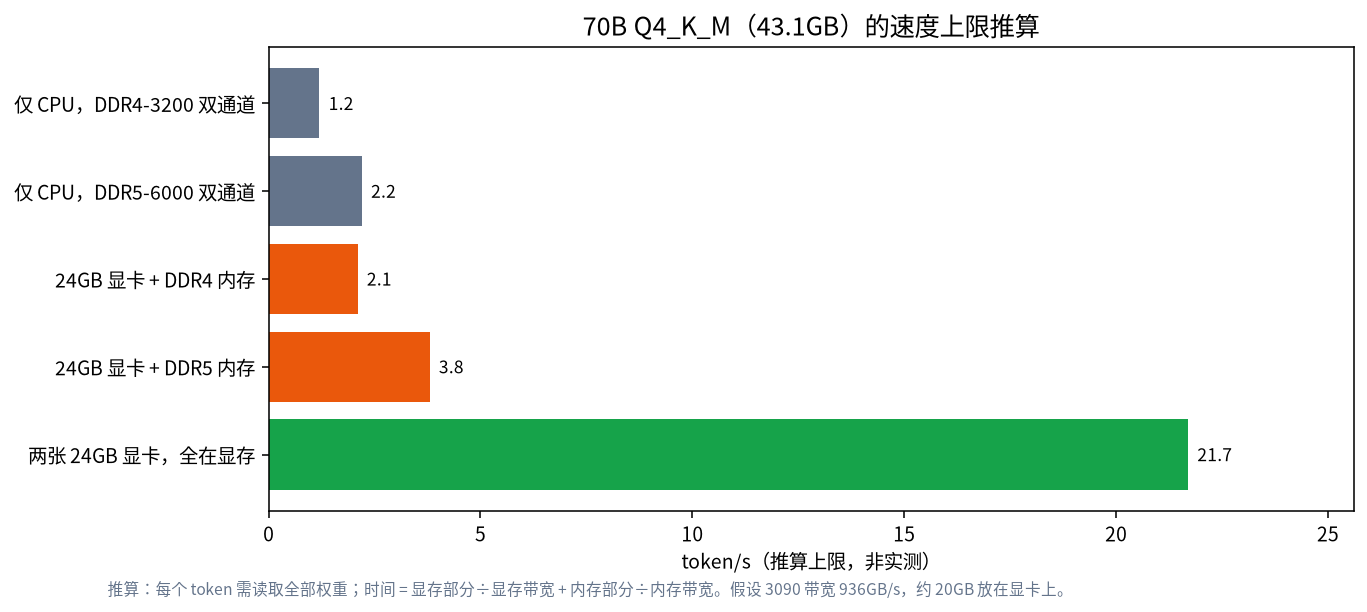
这些是推算的上限,不是实测值。实际速度会因额外开销而更低,但顺序是可靠的:无论哪种内存,卸载都只给出约 1.7 倍于纯 CPU 的上限,尽管将近一半的权重放在了带宽高十倍的显卡上。慢的那部分起决定作用。所以实用的建议是:为你想要的模型买够显存,把卸载当作运行“稍微太大”而不是“大得多”的模型的办法。
| 70B Q4_K_M 的配置 | 推算上限(token/s) | 结论 |
|---|---|---|
| 仅 CPU,DDR4-3200 | 约 1.2 | 聊天太慢 |
| 仅 CPU,DDR5-6000 | 约 2.2 | 只适合耐心使用 |
| 24GB 显卡加 DDR4 | 约 2.1 | 很慢,但能运行 |
| 24GB 显卡加 DDR5 | 约 3.8 | 适合非交互任务 |
| 两张 24GB 显卡,全在显存 | 约 21.7 | 很舒适 |
多买内存到底能得到什么
更多系统内存有三个用处。它能让比显存更大的模型至少能加载,所以你可以在 24GB 的卡上试一试 70B 模型。它为操作系统和大型上下文缓存留出空间,这对长上下文很重要。它还有利于带大容量统一内存的迷你主机这类 CPU 为主的机器,我们的大内存迷你主机文章讨论过,因为这些机器的内存带宽比普通台式机更高。多买内存做不到的是让被卸载的层变快。把台式机内存从 32GB 加到 64GB,只是让你能加载更大的模型,而不是跑得更快。
对于双通道内存,一旦容量够用,更快的内存条和两条一致的内存比容量更重要。四条内存往往比两条运行速度更低,所以尽量选两条更大的。请在 BIOS 里启用内存的额定配置,因为许多主板默认使用较慢的速度。
什么时候适合用卸载
卸载在三种情况下是合理的选择。第一,你想试一个只比显存稍大的模型,比如在 12GB 显卡上运行长上下文的 14B 模型;挪几层出去会损失一些速度,但仍然可用。第二,你运行的是非交互任务,比如通宵总结文档,这时每秒多少 token 没那么重要,能运行才重要。第三,你使用混合专家模型,每个 token 只读取一部分权重,这就是 llama.cpp 提供 --cpu-moe 之类选项的原因:把专家权重留在系统内存里,其余部分留在 GPU 上。我们关于 MoE 模型的文章讲了这种情况,在那里内存比稠密模型更重要。
测一测你自己的分配
不要只相信我们的算术,在你的机器上用十分钟验证一下。加载你关心的模型,运行 ollama ps 查看 Processor 一列。然后用同一个固定提示提问,比如请求一份四百字的总结,记下 Ollama 或 llama.cpp 打印出的生成速度。如果你用 llama.cpp,请用不同的 --n-gpu-layers 值重复运行,并记下速度如何变化:随着更多层挪到 GPU,速度应当稳步上升,整个模型都放得下时会出现跃升。如果两种设置之间速度几乎没有变化,说明瓶颈在别处,也许是温度限制或者内存配置太慢。
在各次运行之间保持两件事不变:上下文长度和提示内容。更长的上下文会增加 KV 缓存,它会占用显存,让更多层在你不知不觉中被挪到 CPU 上。这就是为什么同一个模型在短对话里感觉很快,在长文档里却很慢。把数字连同日期记在一张小表里;下次你更换驱动、量化版本或内存条时会用得上。
该多买显存还是多买内存
| 目标 | 更好的投入 | 原因 |
|---|---|---|
| 快速运行 7B 到 14B 模型 | 显存 | 完全放得下,按 GPU 速度运行 |
| 偶尔试试 70B 模型 | 内存,加一张 24GB 的卡 | 能加载并缓慢运行 |
| 每天使用 70B | 更多显存或统一内存机器 | 卸载太慢 |
| 大型 MoE 模型 | 内存加一张像样的 GPU | 每个 token 只读一部分权重 |
| 中等模型的长上下文 | 先加显存 | KV 缓存被频繁读取 |
如果你在多买内存和换更大的显卡之间犹豫,更大的显卡几乎总能带来更好的速度。每种显存大小无需卸载就能运行什么,可以看我们的 24GB 显存指南和 8GB 显存指南;想通过缩小模型来放进显存,请看 Q4_K_M 量化。
常见错误
- 以为卸载是线性的:慢的那部分决定每个 token 的时间。
- 为 70B 计划只买内存:能加载,但跑不快。
- 四条内存条降速运行:两条往往更快。
- 忘了 XMP 或 EXPO 配置:内存可能在很慢的默认速度下运行。
- 不看
ollama ps:它能立刻告诉你模型是否在 GPU 上。
常见问题
大模型能用系统内存代替显存吗?
可以。Ollama 和 llama.cpp 都能让部分层在 CPU 上从系统内存运行,但速度低得多,因为内存带宽远低于显存带宽。
卸载一个模型需要多少内存?
至少是放不进显存的那部分大小,再加操作系统和上下文的空间。请按模型大小再加几个 GB 来规划。
DDR5 对大模型比 DDR4 好很多吗?
对 CPU 推理来说,带宽越高,上限直接越高。在我们推算的例子里,DDR5-6000 大约是 DDR4-3200 上限的两倍。
怎么看我的模型是否在 GPU 上?
运行 ollama ps 并看 Processor 一列,它会显示 100% GPU、100% CPU 或者混合比例。
卸载会降低质量吗?
不会。使用的是同样的权重,回答相同,变化的只有速度。
买第二块 GPU 还是更多内存更好?
要速度,通常第二块 GPU 更好。要以较低成本加载超大模型并接受慢速,内存更便宜。
和我们聊聊
围绕大模型规划装机,不确定需要多少内存?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:Ollama 常见问题、llama.cpp 服务器文档、英伟达 RTX 3090 规格、英伟达 RTX 4090 规格。