
8GB 显存跑大模型:能跑什么模型?附推荐清单与设置
核对说明:文件大小来自 Ollama 模型库(2026-10-30 读取);可用显存和各模型能否放下的判断参考 CanRun 的公开估算,已标注。我们没有在 8GB 显卡上逐一实测速度和质量,文中不含自测跑分。
很多人手里的显卡只有 8GB 显存,想知道 8GB 显存跑大模型到底能跑什么。结论可以先放这里:8GB 能舒服运行 7B–8B 级、文件大小在 5–6GB 以内的模型;12B 级只能勉强,14B 及以上会有一部分落到内存,速度明显下降;27B 以上基本不用想。 下面逐类给出推荐清单、设置建议和升级判断。
8GB 显存跑大模型:先算清楚到底有多少可用
8GB 是标称值,系统和显示输出会占用一部分。CanRun 的指南估算,8GB 的 RTX 4060 可用显存约 7.4GB。再扣掉上下文缓存和运行开销,真正可以放模型文件的空间大约是 5.5–6.5GB。
| 项目 | 大小 | 说明 |
|---|---|---|
| 标称显存 | 8GB | 显卡规格 |
| 可用显存 | 约 7.4GB | CanRun 对 RTX 4060 的估算 |
| 上下文缓存 + 开销 | 约 1–2GB(8k 上下文) | 模型不同而不同,详见《大模型显存需求怎么算》 |
| 能放模型文件的空间 | 约 5.5–6.5GB | 我们的粗算 |
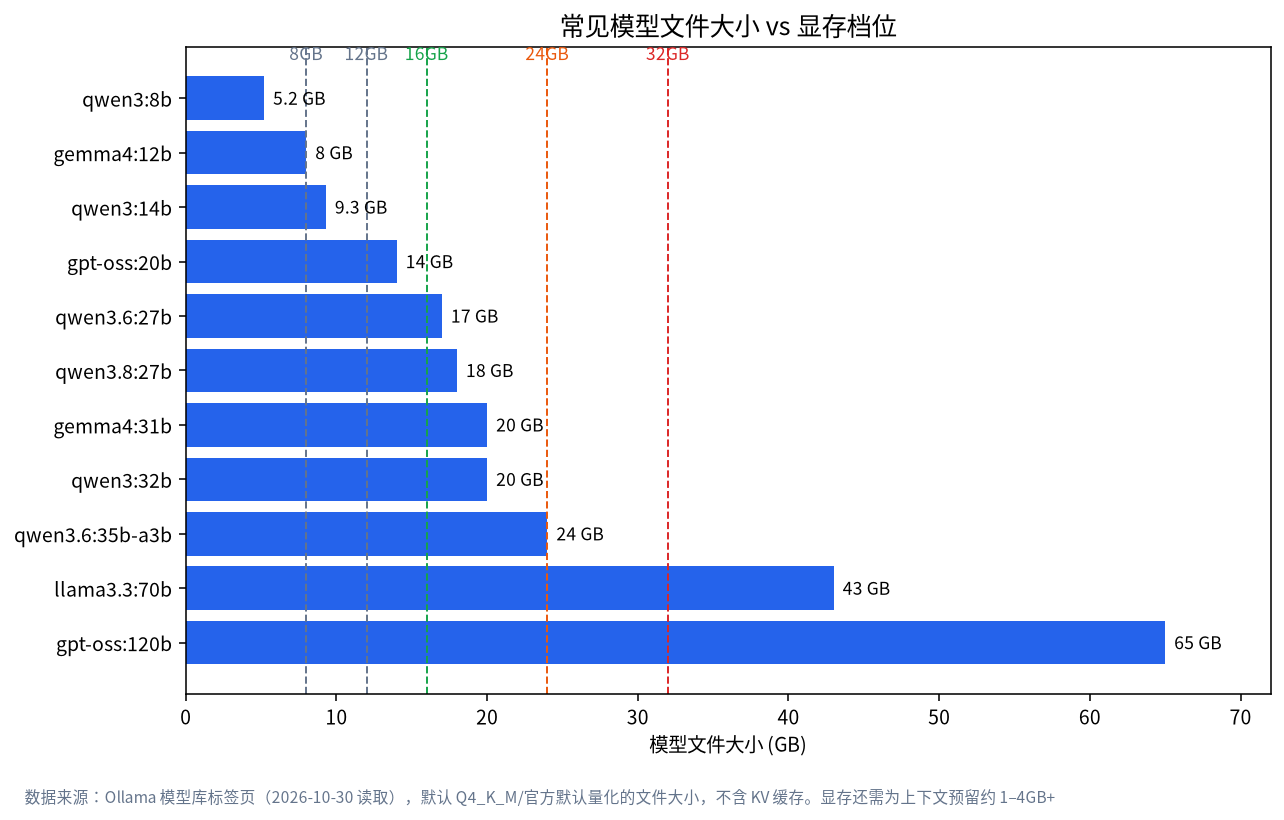
例如 CanRun 估算 Llama 3.1 8B(Q4_K_M)在 8k 上下文下共需 6.3GB,在 7.4GB 可用空间内有约 1GB 余量;Gemma 4 12B 需要 7.8GB,已超过 7.4GB,只能有约九成放在 GPU 上,属于部分卸载;Gemma 3 12B 需要 8.4GB、Qwen3 14B 需要 10.5GB,则有较多权重落到内存,速度明显变慢。
8GB 显卡推荐模型清单(按用途)
下表文件大小来自 Ollama 页面。“适合度”是我们的判断,依据是文件大小与 5.5–6.5GB 的预算对比,不是实测。
| 用途 | 推荐标签 | 文件大小 | 适合度 | 备注 |
|---|---|---|---|---|
| 日常聊天 | qwen3:8b |
5.2GB | 合适 | 8B 级通用模型 |
| 日常聊天 | llama3.1:8b |
4.9GB | 合适 | 上下文可到 128K(受显存限制) |
| 日常聊天 | gemma4:e4b |
6.6GB | 偏紧 | 贴近上限,上下文要小 |
| 推理(数学、逻辑) | deepseek-r1:8b |
5.2GB | 合适 | 先输出思考过程,会多占上下文,见《DeepSeek 本地部署》 |
| 编程 | qwen2.5-coder:7b(即 latest) |
4.7GB | 合适 | 该模型页更新时间较早,可对比较新的通用模型 |
| 看图理解 | qwen3-vl:8b(即 latest) |
6.2GB | 偏紧 | 图片本身也占上下文 |
| 看图理解(轻量) | qwen3-vl:4b |
3.3GB | 宽裕 | 适合 8GB 卡 |
| 轻量快速 | llama3.2:3b(即 latest) |
2.0GB | 宽裕 | 速度快,能力有限 |
| 轻量快速 | phi4-mini |
2.5GB | 宽裕 | 128K 上下文上限 |
| 轻量快速 | qwen3:4b |
2.5GB | 宽裕 | 小模型里的常见选择 |
| 文档检索(嵌入) | nomic-embed-text |
274MB | 极轻 | 配合 RAG 使用,不是聊天模型 |
选择建议:优先选 5GB 左右的 8B 级模型,既能保证 100% 放进 GPU,又给上下文留余地。更多模型比较见《本地大模型推荐:按显存和用途》。
想“撑一撑”:12B 以上的模型值得吗?
| 模型 | 文件 | CanRun 估算 8k 需求 | 在 7.4GB 可用下的情况 |
|---|---|---|---|
| Gemma 4 12B(默认 Q4) | 8.0GB | 7.8GB | 约九成放进 GPU,其余在内存,CanRun 判定“可用” |
| Gemma 4 12B(IQ4_XS) | — | 7.1GB | 可以完全放进,余量极小 |
| Gemma 3 12B | 8.2GB | 8.4GB | 部分在内存,CanRun 判定“较慢” |
| Qwen3 14B | 9.3GB | 10.5GB | 部分在内存,较慢 |
“撑一撑”的代价是:速度下降、上下文受限、稳定性变差。如果你只是想偶尔试试大一点的模型,可以尝试;如果要长期使用,我们建议直接升级显卡,见下文。
8GB 显存设置建议
- 控制上下文:Ollama 对小于 24GiB 显存的默认上下文是 4k,足够日常聊天。长文档任务才调到 8k–16k,并随时检查
ollama ps。 - 压缩 KV 缓存:设置环境变量
OLLAMA_FLASH_ATTENTION=1和OLLAMA_KV_CACHE_TYPE=q8_0,官方说明 q8_0 约占 f16 一半的内存、精度损失很小。 - 限制并发:个人使用时
OLLAMA_NUM_PARALLEL=1,避免为多个并发请求预留缓存。 - 关闭占显存的软件:浏览器的硬件加速、视频软件、游戏都会占用显存。可以用
nvidia-smi看看谁在占。 - 用
ollama ps核对:PROCESSOR 应为100% GPU;出现 CPU 比例就换更小的模型。
如果显卡明明有 8GB,却没有被使用,请看《Ollama 常见报错:GPU 没用上怎么办》。
实操:在 8GB 显卡上完整走一遍
下面是一套保守的流程,适合第一次在 8GB 卡上跑模型。命令都是 Ollama 官方支持的写法,安装见《Ollama 安装教程》。
# 1. 拉取并运行一个 5GB 左右的 8B 模型
ollama run qwen3:8b

# 2. 在对话里把上下文设为 8k(默认 4k 足够聊天,长文档再调大)
/set parameter num_ctx 8192

# 3. 另开终端,确认是否 100% GPU
ollama ps
如果第三步显示 100% GPU,说明模型和缓存都放进了显卡,可以继续使用。如果出现 CPU 比例,先把上下文降回 4096,再不行就换 qwen3:4b 之类更小的模型。这套流程的核心是:先用小的、稳的配置确认能跑,再一点点加大,而不是一上来就加载最大的模型然后排查为什么慢。
量化在 8GB 上的意义
同一个 8B 模型,不同量化的体积差别很大。用上一篇里的经验比例(Q4_K_M 约 0.6GB/10 亿参数,Q8_0 约 1.1GB,FP16 约 2GB)估算:
| 8B 模型的版本 | 估算文件大小 | 8GB 卡上的情况 |
|---|---|---|
| Q4_K_M | 约 4.8GB(Ollama 实际约 5.2GB) | 合适,是默认选择 |
| Q8_0 | 约 8.8GB | 放不下,会大量落到内存 |
| FP16 | 约 16GB | 完全不可能 |
所以在 8GB 卡上,Q4_K_M 基本就是唯一合理的选择。更低的量化(如 Q3)可以省下一点空间,但质量下降更明显,通常不值得。量化的原理和取舍见《大模型量化是什么》。
8GB 用户的五个典型场景
| 场景 | 建议 | 要留意 |
|---|---|---|
| 日常问答、写作润色 | qwen3:8b,4k–8k 上下文 |
别开太长的上下文 |
| 阅读长文档 | 先让模型总结分段,而不是一次塞入全文 | 8GB 的 KV 缓存撑不起很长的上下文 |
| 写代码辅助 | 7B–8B 级模型,配合短上下文 | 复杂项目会受限;Ollama 对编程工具建议至少 64000 tokens,8GB 做不到,需要预期管理 |
| 数学、逻辑题 | deepseek-r1:8b |
思考过程占上下文,需要调大 num_ctx |
| 看图 | qwen3-vl:4b |
8b 版 6.2GB 偏紧 |
常见误区
| 误区 | 事实 |
|---|---|
| “8GB 就能放 8GB 的模型文件” | 可用约 7.4GB,还要留缓存,模型文件应在 5.5–6.5GB 以内 |
| “换成更大的内存条就能弥补显存” | 内存能让模型“跑起来”,但落入内存的部分会明显变慢 |
| “参数少就一定好用” | 3B–4B 模型适合轻量任务,复杂推理和长文本能力有限 |
| “显存不够就硬上大模型” | 速度和稳定性都会差,不如选小一档的模型 |
| “所有 8GB 显卡速度一样” | 容量一样,带宽不同(224–448GB/s),速度有差别 |
8GB 显卡之外:内存、硬盘与笔记本
显存只是一半。8GB 显卡的机器想流畅跑模型,还要留意几件事:
- 系统内存:建议 16GB 以上。当模型有一部分落到内存、或者你同时开着浏览器和开发工具时,内存会立刻吃紧。
- 硬盘:5GB 左右的模型很容易下载好几个,建议留出至少 50GB 空闲空间,并用固态硬盘,加载更快。
- 笔记本:笔记本版 8GB 显卡带宽通常更低,持续高负载会触发降频和风扇噪音,建议接电使用并保持散热通畅。
- 驱动:NVIDIA 显卡需要较新的驱动,Ollama 官方要求驱动 550 以上;版本过旧会导致 GPU 没被使用,见《Ollama 常见报错》。
常见 8GB 显卡对比
CanRun 的显卡表列出了 8GB 档位的常见显卡及带宽(同容量下,带宽越高,生成越快):
| 显卡 | 显存 | 带宽 | 备注 |
|---|---|---|---|
| GeForce RTX 3070 | 8GB | 448GB/s | 带宽较高的老卡 |
| GeForce RTX 5060 | 8GB | 448GB/s | |
| GeForce RTX 5060 Ti 8GB | 8GB | 448GB/s | 与 16GB 版本同名,购买时要看清显存 |
| GeForce RTX 4060 Ti 8GB | 8GB | 288GB/s | |
| GeForce RTX 4060 | 8GB | 272GB/s | 最常见 |
| GeForce RTX 4060 Laptop / 4070 Laptop | 8GB | 256GB/s | 笔记本版 |
| GeForce RTX 3050 8GB | 8GB | 224GB/s | 带宽最低 |
CanRun 的结论是:这些 8GB 显卡可用的显存相同(约 7.4GB),能放下的模型一样;差别主要在速度上。
什么时候该升级,升到哪一档
| 如果你想 | 建议 | 参考 |
|---|---|---|
| 想要更好的回答质量,预算有限 | 12GB(如 RTX 3060 12GB,可用约 11.4GB) | 能放下 12B–14B,但 14B 余量不到 1GB |
| 想舒服地用 20B 级模型 | 16GB | 可放下 gpt-oss:20b(14GB) |
| 想跑 27B–32B | 24GB | 见《24GB 显存能跑什么模型》 |
具体显卡与价格区间见《本地大模型显卡推荐》。升级前,先用上面的清单确认自己真正的需求是不是“更大的模型”,还是只是“设置不合适”。
一个简单的决策流程
如果你还是不知道先下载哪个,按下面的顺序基本能定下来:
- 主要是聊天、改写、翻译?先用
qwen3:8b,上下文 4k。 - 需要一步步推理的数学或逻辑题?试
deepseek-r1:8b,把上下文调到 8k。 - 需要看截图或照片?用
qwen3-vl:4b,只有ollama ps仍是 100% GPU 时再换 8b 版。 - 旧笔记本、更看重速度?3B–4B 的模型(如
llama3.2:3b、qwen3:4b)会更流畅。 - 以上都不满意?这就是考虑 12GB 或 16GB 显卡的信号,而不是继续和限制死磕。
8GB 显存做不到的事
- 27B–32B 级模型:文件 17–20GB,大部分落在内存。
- 长上下文(如 32K 以上):缓存本身就会超出显存。
- gpt-oss-120b:CanRun 判定在 8GB 卡上“跑不动”。
- 同时加载多个模型:会超出可用空间。
常见问题(FAQ)
8GB 显存最适合哪个模型?
综合文件大小和通用性,qwen3:8b(5.2GB)或 llama3.1:8b(4.9GB)是比较稳的起点;想要推理能力可以试 deepseek-r1:8b。
RTX 4060 8GB 能跑 14B 吗?
可以加载,但 CanRun 估算 Qwen3 14B 需要 10.5GB,超过 7.4GB 的可用显存,部分权重在内存里,速度较慢。
笔记本的 8GB 显卡也一样吗?
显存容量一样,但笔记本版带宽通常更低(如 4060 Laptop 为 256GB/s),速度会稍慢。
8GB 显存能不能跑图像模型?
本文只讨论文本大模型和看图理解模型;绘图模型的显存需求与这里不同,我们没有核对,暂不给结论。
为什么 8GB 显卡跑 8B 模型还是有点慢?
先看 ollama ps 是否 100% GPU,其次看上下文是否过大、是否有其他软件占显存。
要不要为了跑大模型直接换 24GB 显卡?
取决于预算和需求。想长期使用 27B–32B 级模型,24GB 才是甜点档位;只是日常聊天,8B 级已经够用。
下一步与社区
不确定自己的 8GB 显卡该选哪个模型,或者想知道升级到哪一档最划算?欢迎把显卡型号和用途发到社区(加入社区)。我们在深圳做本地大模型机器的选型、组装与实测,也可以帮你评估“升级显卡”还是“整机更换”;先聊需求,不强制购买。