Strata vs Ollama vs llama.cpp vs LM Studio vs vLLM: Wofür jedes Werkzeug gut ist und welches Sie wählen
Aktualisiert 2026-11-04. Auf Grundlage öffentlicher Dokumentation, Release Notes und Berichte Dritter. Wir haben selbst keine Benchmarks ausgeführt.
Strata vs Ollama ist der Vergleich, nach dem diesen Monat alle fragen, aber es ist kein fairer Kampf zweier Werkzeuge mit derselben Aufgabe. Strata ist eine neue Engine, gebaut, um eine Klasse sehr großer Mixture-of-Experts-Modelle (MoE) auf einem PC mit kleiner Grafikkarte auszuführen. Ollama ist eine ausgereifte, allgemeine Modellverwaltung. llama.cpp, LM Studio und vLLM stehen in anderen Ecken derselben Landkarte. Dieser Artikel stellt die fünf nebeneinander, zeigt, wofür jedes gedacht ist, prüft, was wir zur Unterstützung von Qwen3.8-Flash-Next verifizieren konnten, und endet mit einer Entscheidungshilfe. Wenn Sie „Strata“ nur dem Namen nach kennen, beginnen Sie mit unserer Erklärung, was Strata ist.
Strata vs Ollama: die kurze Antwort
- Strata: Wählen Sie es, wenn Sie ein sehr großes MoE-Modell, vor allem Qwen3.8-Flash-Next, auf einem PC mit 12- bis 24-GB-GPU und 48 bis 64 GB RAM wollen.
- Ollama: Wählen Sie es, wenn Sie viele kleine und mittlere Modelle am einfachsten ausführen und mit Apps verbinden wollen.
- llama.cpp: Wählen Sie es, wenn Sie maximale Kontrolle über GGUF-Modelle und Hardware wollen oder ein Werkzeug nutzen, das darauf aufbaut.
- LM Studio: Wählen Sie es, wenn Sie eine grafische App zum Finden, Herunterladen und Chatten mit Modellen wollen.
- vLLM: Wählen Sie es, wenn Sie viele Nutzer gleichzeitig von GPUs mit genug Speicher bedienen.
Nebeneinander
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| Hauptaufgabe | Riesige MoE-Modelle mit wenig VRAM ausführen, indem GPU, RAM und SSD gestaffelt werden | Viele Modelle mit einem Befehl laden, ausführen und bereitstellen | Die Inferenz-Bibliothek und der Server, auf denen viele Werkzeuge aufbauen | Desktop-App zum Stöbern, Herunterladen und Chatten | Serving-Engine mit hohem Durchsatz |
| Lizenz | MIT (Engine) | MIT | MIT | Proprietäre App, laut Bedingungen für Privat- und Berufsnutzung kostenlos | Apache-2.0 |
| GitHub-Sterne (2026-11-04) | 39.548 | 185.856 | 133.318 | Kein offenes Repository | 96.277 |
| Oberfläche | Desktop-App und Terminal | Kommandozeile, App, REST-API | Kommandozeile und llama-server |
Grafische App, lms-CLI, Headless-Modus |
Python-Bibliothek und Server |
| API | OpenAI-, Anthropic- und Responses-Stil | Eigene API plus OpenAI-kompatible Endpunkte | OpenAI-kompatibler Server | OpenAI-kompatibler Server | OpenAI-kompatibler Server |
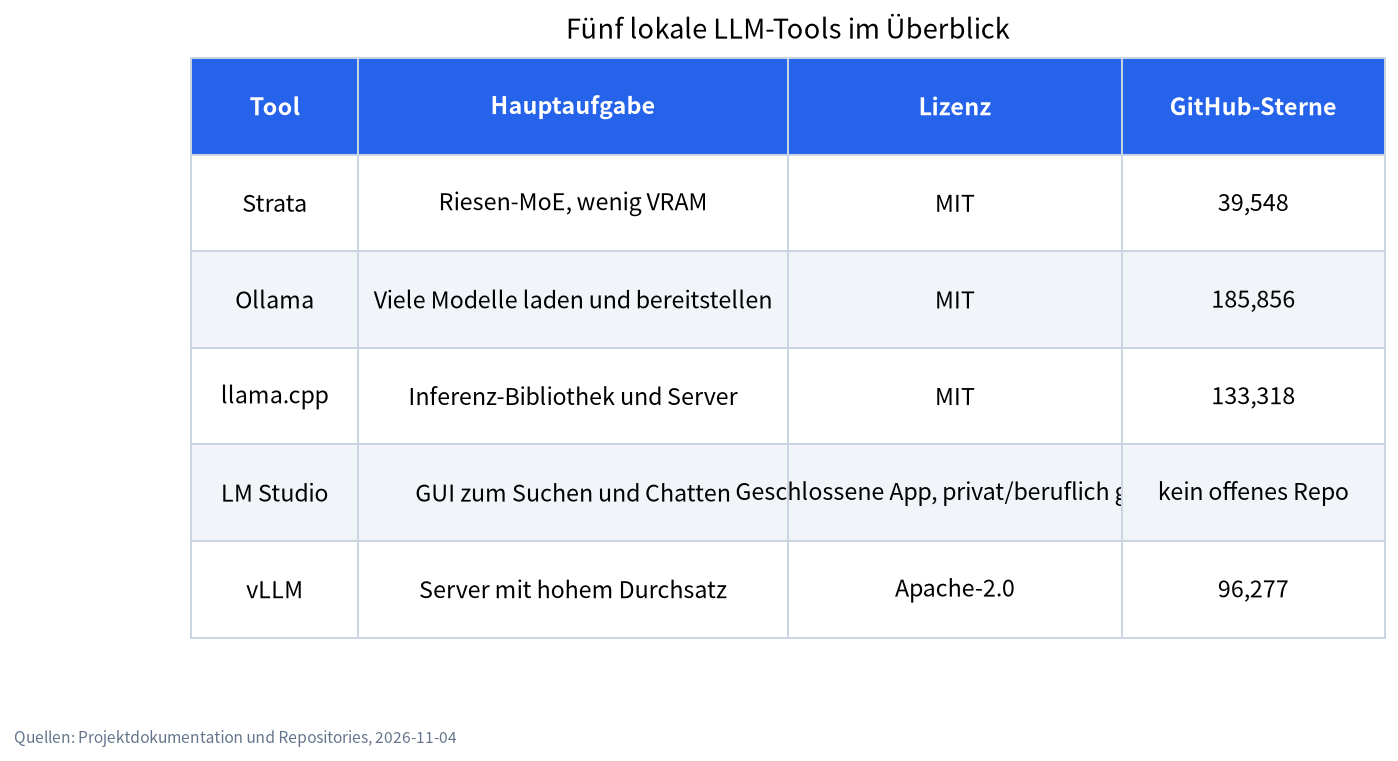
Sterne messen Aufmerksamkeit, nicht Qualität. Das Repository von Strata ist sechs Wochen alt; das von Ollama hatte Jahre zum Sammeln. Die Release Notes sagen mehr über den Schwung: Strata veröffentlichte sechs Releases zwischen dem 25. Oktober und dem 2. November, und v0.40.14 von Ollama erschien am 3. November.
Was jedes gut kann und worauf Sie achten sollten
| Werkzeug | Stark bei | Achtung bei |
|---|---|---|
| Strata | Sehr großen MoE-Modellen auf Karten mit 12 bis 24 GB, Installation mit einem Klick, strata connect für Coding-Agenten |
Wenige unterstützte Modelle, junges Projekt, lange Prompts sind auf 12-GB-Karten langsam (PC Watch), laut eigener Dokumentation kein externes Sicherheitsaudit |
| Ollama | Einfachheit, große Modellbibliothek, riesiges Ökosystem, ollama launch für Coding-Werkzeuge, MLX auf Apple Silicon seit v0.40.0 |
Nicht dafür gebaut, ein 125B-MoE aus RAM und SSD zu streamen; neben der lokalen Nutzung gibt es optionale Cloud-Modelle und kostenpflichtige Tarife |
| llama.cpp | Breite Hardware-Unterstützung, Quantisierungsformate, feine Kontrolle; Unterstützung für Qwen3.8-Flash-Next kam mit Pull Request #27742, gemergt am 2026-08-27 | Mehr Optionen zu lernen; Sie stellen das Setup selbst zusammen |
| LM Studio | Freundliche GUI, nutzt llama.cpp- und MLX-Engines, kann mit lms headless laufen |
App mit geschlossenem Quellcode; beachten Sie die Bedingungen, wenn Sie sie in ein Produkt einbetten |
| vLLM | Durchsatz bei vielen parallelen Anfragen | Braucht GPU-Speicher für das ganze Modell; nicht auf eine 12-GB-Karte ausgelegt |
Das eigene Repository von vLLM liegt unter github.com/vllm-project/vllm. Für einen längeren Blick auf die drei gängigsten Werkzeuge siehe unseren Leitfaden Ollama vs LM Studio vs llama.cpp, zu vLLM unsere Einführung in vLLM und SGLang.
Unterstützung für Qwen3.8-Flash-Next, soweit wir sie prüfen konnten
Dies ist das Modell hinter dem meisten Strata-Hype, daher ist Genauigkeit wichtig. Alles hier ist auf den 2026-11-04 datiert.
- Strata: dafür gebaut (Modellliste). Die Dokumentation nennt vier Quantisierungen mit 37,6 bis 54,8 GB RAM plus VRAM.
- llama.cpp: Pull Request #27742, „model: add Qwen3.8-Flash-Next (qwen4exp)“, wurde am 2026-08-27 gemergt. Ein Hacker-News-Nutzer meldete auf einem AMD-Setup llama.cpp mit etwa 21 Token/s gegen Strata mit etwa 60 Token/s. Das ist eine Anekdote, kein Test, für den wir einstehen können.
- Ollama: Die Bibliotheksseite zu
qwen3.8-flash-nextzeigte ein einziges Tag,125b-mlx(105 GB, für Apple Silicon). Ein Feature-Request wurde am 2026-10-17 geschlossen. Ein Tag für NVIDIA-GPUs fanden wir nicht und testeten nicht, daher behaupten wir nicht, Ollama könne es nicht ausführen, nur dass wir keinen dokumentierten Weg fanden. - LM Studio und vLLM: haben wir nicht geprüft.
Wie jedes Werkzeug ein Modell behandelt, das größer ist als Ihr VRAM
Hier unterscheiden sich die Werkzeuge wirklich. Passt ein Modell nicht auf die Karte, teilen Ollama und llama.cpp es normalerweise nach Schichten: Einige Schichten laufen auf der GPU, der Rest auf der CPU, mit den Gewichten im RAM. Das funktioniert gut bei dichten Modellen und ist der Standardweg auf kleinen Karten. Ein MoE-Modell ist anders, denn pro Token werden nur wenige Experten genutzt. llama.cpp hat Optionen, die Experten auf der CPU-Seite halten (die Flag-Familie --cpu-moe), und ein Hacker-News-Nutzer meldete damit 16 Token/s mit einer Q8_0-Datei auf einem Rechner mit 192 GB RAM. Strata geht einen Schritt weiter: Es hält einen Cache der meistgenutzten Experten auf der GPU, berechnet die übrigen auf der CPU, wo sie im RAM liegen, und kann den Rest von der SSD streamen. Das Ergebnis ist ein Werkzeug, das eine Sache gut kann, auf Kosten der Unterstützung nur weniger Modelle. vLLM dagegen setzt voraus, dass das ganze Modell im GPU-Speicher liegt, weshalb es zu Servern passt und nicht zu einer 12-GB-Desktopkarte.
Wie man Geschwindigkeitsaussagen liest
Die meisten Beiträge nach dem Muster „Strata ist schneller“ vergleichen verschiedene Modelle. Der japanische Blogger hinter einem RTX-3060-Test stellte die 44,49 Token/s von Strata beim 125B-Modell neben Ollama-Ergebnisse mit 9B- und 26B-Modellen auf demselben PC und sagte dann klar, diese Tabelle zeige nicht, dass Strata schneller oder langsamer als Ollama sei. Der Test von arm1.ru verglich Strata mit Flash-Next gegen llama.cpp mit einem anderen Modell, Qwen3.8-27B. Ein fairer Vergleich braucht dasselbe Modell, dieselbe Quantisierung, denselben Kontext, dieselbe Hardware und dieselbe Softwareversion; keinen, der diese Latte ganz erfüllt, haben wir gefunden. Bis einer erscheint, lesen Sie Geschwindigkeiten als „was dieses Werkzeug mit diesem Modell erreichte“, nicht als „welches Werkzeug schneller ist“. Lesen Sie die Quellen: den Test auf note.com, arm1.ru und den Hacker-News-Thread.
Entscheidungshilfe
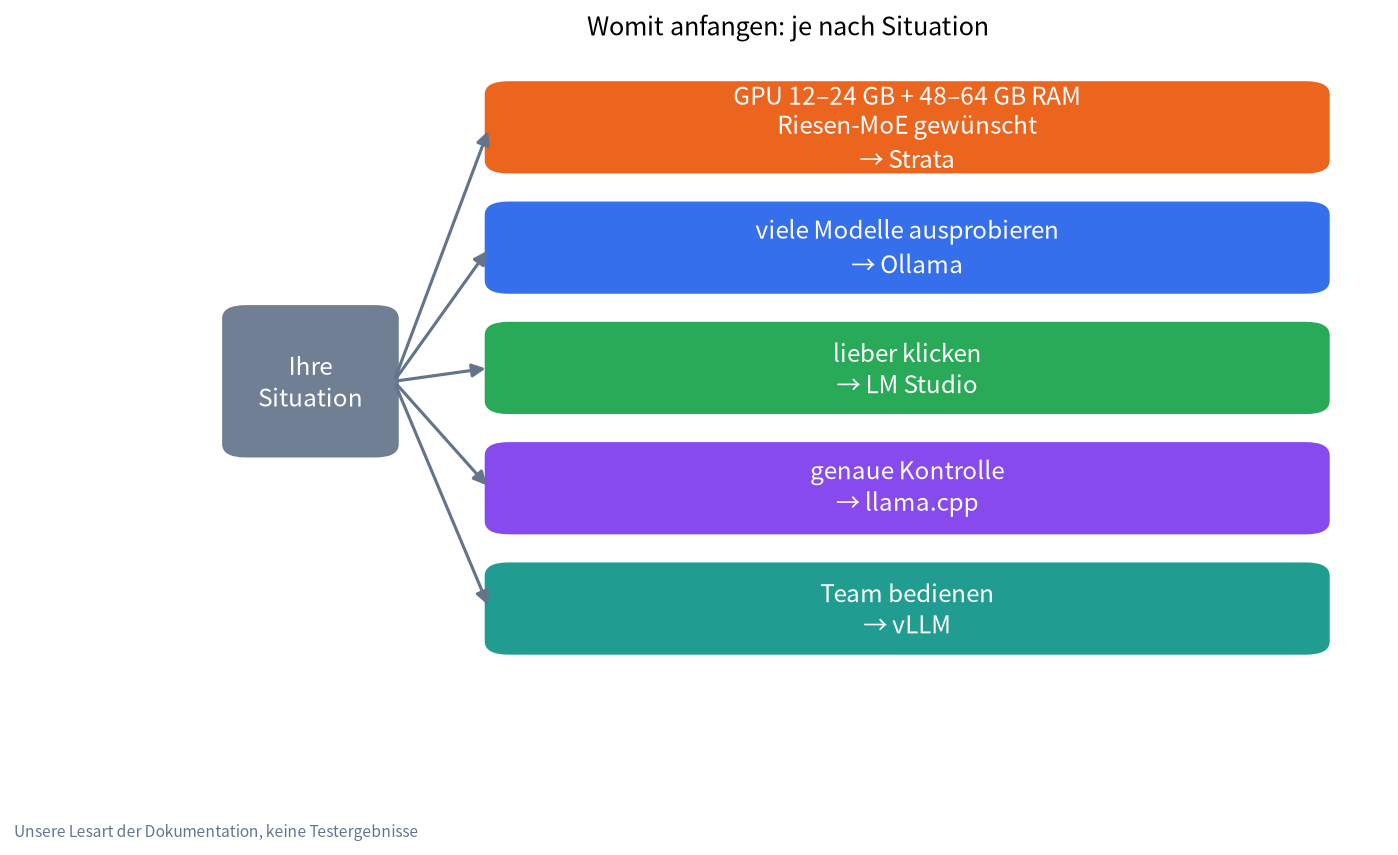
| Ihre Situation | Beginnen Sie mit | Warum |
|---|---|---|
| NVIDIA- oder AMD-GPU mit 12 bis 24 GB, 48 bis 64 GB RAM, Sie wollen Qwen3.8-Flash-Next | Strata | Es ist für dieses Modell und diese Speicheraufteilung gebaut |
| Sie wollen schnell viele Modelle testen oder Open WebUI anbinden | Ollama | Einfachste Installation und größtes Ökosystem; siehe unsere Ollama-Installationsanleitung |
| Sie klicken lieber, als zu tippen | LM Studio | Grafischer Modell-Browser; siehe unser LM-Studio-Tutorial |
| Sie brauchen genaue Kontrolle über Flags, Quantisierung oder Builds | llama.cpp | Am nächsten an der Hardware |
| Sie bedienen ein Team von einem GPU-Server | vLLM | Für gleichzeitige Anfragen gebaut |
| Sie haben einen Mac mit viel Unified Memory | Zuerst Ollama oder LM Studio | Beide nutzen MLX auf Apple Silicon; Strata unterstützt ebenfalls macOS 15 oder neuer |
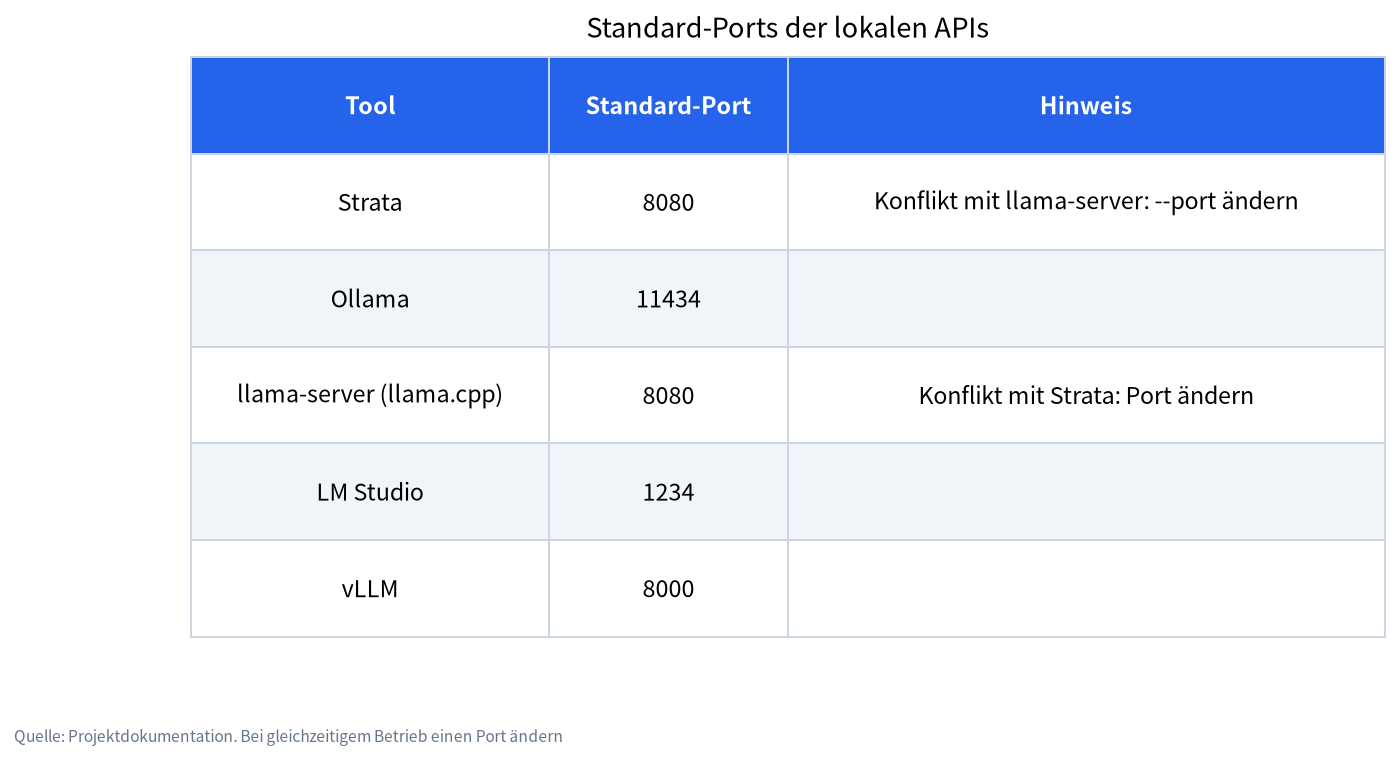
Nichts hindert Sie daran, zwei zu nutzen. Viele werden Ollama für Alltagsmodelle behalten und Strata für ein großes Modell hinzufügen; denken Sie nur daran, dass beide denselben VRAM und RAM wollen. Die praktischen Schritte stehen in unserer Installationsanleitung für Strata neben Ollama, die Speicherzahlen in unserem Artikel zu den Hardware-Anforderungen.
Lizenzen, Daten und Kosten
Die Engines sind quelloffen (MIT oder Apache-2.0), aber Modellgewichte haben eigene Lizenzen; Qwen3.8-Flash-Next nutzt die Qwen Community License 1.0, lesen Sie sie also, wenn Sie kommerzielle Nutzung planen. Die Dokumente von Strata sagen, es gebe keine Telemetrie und kein Konto; Ollama führt lokale Modelle ohne Anmeldung aus und bietet laut seinen Release Notes auch optionale Cloud-Modelle und kostenpflichtige Tarife an; die Bedingungen von LM Studio erlauben Privat- und Berufsnutzung, aber keine Weitergabe und kein Hosting als Dienst. Prüfen Sie die aktuellen Bedingungen immer selbst.
Was wir getan haben und was nicht
Am 2026-11-04 haben wir Repository, Release Notes und Dokumentation jedes Projekts sowie die oben verlinkten Berichte Dritter gelesen. Wir haben für diesen Artikel keines der fünf Werkzeuge installiert und keine einzige Geschwindigkeit gemessen. Wo eine Aussage von einem einzelnen Nutzer stammt, sagen wir das.
Häufige Fragen (FAQ)
Ist Strata schneller als Ollama?
Das können wir nicht sagen. Veröffentlichte Vergleiche nutzen meist verschiedene Modelle und beantworten die Frage daher nicht. Laut Testern kann Strata ein 125B-MoE-Modell mit Dutzenden Token pro Sekunde auf einer 12-GB-Karte ausführen, aber das ist eine andere Aufgabe, als ein 9B-Modell in Ollama laufen zu lassen.
Kann Ollama Qwen3.8-Flash-Next ausführen?
Am 2026-11-04 listete die Bibliothek von Ollama ein 105-GB-MLX-Tag für Apple Silicon. Einen dokumentierten Weg für NVIDIA-GPUs fanden wir nicht und testeten nicht; prüfen Sie daher die Bibliotheksseite für Ihre Plattform.
Welches Werkzeug ist für Einsteiger am besten?
Ollama oder LM Studio. Beide sind in Minuten installiert und haben die meisten Anleitungen. Fügen Sie Strata später hinzu, wenn Sie ein bestimmtes sehr großes Modell wollen.
Baut Strata auf llama.cpp auf?
Seine Dokumentation nennt ggml, die Tensor-Bibliothek hinter llama.cpp, als Komponente von Dritten, aber Strata ist eine eigene C++-Engine mit eigener Planung. Es wird nicht als Fork von llama.cpp beschrieben.
Was eignet sich am besten, um ein Team zu bedienen?
vLLM, wenn Sie genug GPU-Speicher für das ganze Modell haben. Der Standard von Strata passt die parallelen Anfragen an Ihre Karte an (eine bei einer 12-GB-GPU); eine 12-GB-Karte ist also für einen einzelnen Nutzer gedacht, nicht für ein Team.
Muss ich Ollama deinstallieren, um Strata auszuprobieren?
Nein. Sie nutzen unterschiedliche Standard-Ports und unterschiedliche Modellordner. Laden Sie nur nicht zwei große Modelle gleichzeitig auf dieselbe GPU.
Sprechen Sie mit uns
Wenn Sie nicht wissen, welches Werkzeug zu Ihrer GPU und Ihrem Budget passt, treten Sie der Community bei oder schreiben Sie an admin@microaione.com mit GPU, RAM und Einsatzzweck. Wenn Sie dafür lieber einen gebauten und getesteten Rechner möchten, lesen Sie den Leitfaden zu Maschinen und Lösungen.