双3090 装机:两张二手 3090 凑 48GB 显存,配件、电源、散热与局限(2026)
单张 24GB 显卡可以舒服地跑 32B 模型,却放不下 70B 模型。本地大模型社区里常见的办法是买两张二手 RTX 3090,用比工作站卡便宜得多的价格得到 48GB 显存。这篇文章用实用的方式讲 双3090 装机:48GB 实际能放下什么,主板、电源和机箱必须提供什么,llama.cpp 和 Ollama 怎样使用两张卡,由我们的参考价推算出的造价,以及什么时候单卡是更好的选择。如果你还没决定是否上单张 24GB 显卡,请先看《24GB 显卡装机方案》和《二手显卡选购指南》。
核对说明:llama.cpp 的分卡模式选项来自其服务器文档;Ollama 的多 GPU 行为来自其常见问题;3090 的尺寸、三槽设计、NVLink 支持和单卡 750W 电源要求来自 NVIDIA 的 RTX 3090 页面;均于 2026-10-30 核对。价格是我们 2026-10-30 调研的参考中位价,不是报价,双卡总价是推算值。我们没有为这篇文章实际组装或测试双 3090 机器,所以不提供速度数字。
要点速览(更新于 2026-10-30)
- 两张 24GB 显卡共 48GB,足够放下 70B Q4_K_M 文件(43.1GB)并留出适度上下文,但不量化缓存就撑不起长上下文。
按层拆分到两张卡上增加的是容量而不是速度:一个 token 仍要依次经过各层。
一对卡大致是多一张二手 3090 的价格,加上更好的主板、电源和散热;我们推算的参考总价约 22,000 元,未含主板、机箱与散热升级。
48GB 能买到什么
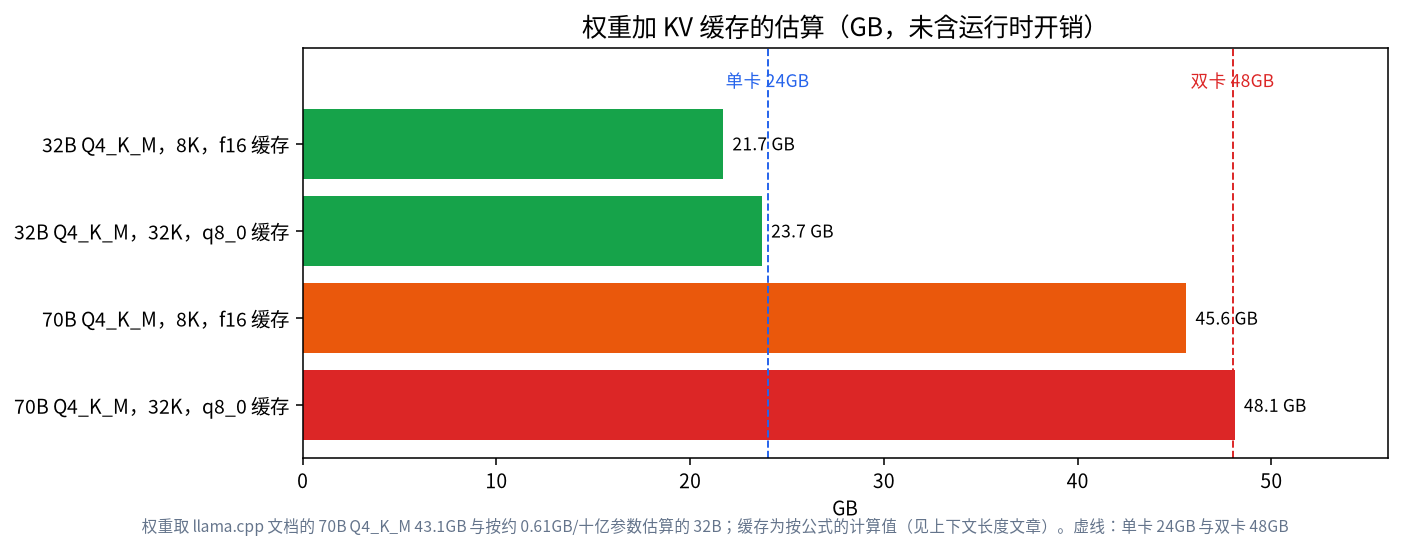
加第二张卡的主要原因是容量。llama.cpp 文档给出 Llama 3.1 70B 的 Q4_K_M 文件是 43.1GB。它完全放不进一张 24GB 的卡,但可以放进两张,剩下约 5GB 给上下文缓存和缓冲区。用《上下文长度与显存》里的 KV 缓存公式,Llama 3.1 70B 在 8K 上下文 f16 下约需 2.5GiB,所以 70B Q4_K_M 在 8K 时约 45.6GB,还未计入运行时开销。32K 时 f16 缓存涨到 10GiB,放不下;用 q8_0 缓存约 5GiB,总量约 48.1GB,正好卡在极限,实际上太紧。
| 模型 | 权重(Q4_K_M) | 缓存与上下文 | 合计(估算) | 24GB 单卡 | 2 × 24GB |
|---|---|---|---|---|---|
| 32B | 约 19.7GB | 8K,f16,2GiB | 约 21.7GB | 能放下,很紧 | 能 |
| 32B | 约 19.7GB | 32K,q8_0,4GiB | 约 23.7GB | 实际不行 | 能 |
| 70B | 43.1GB | 8K,f16,2.5GiB | 约 45.6GB | 不行 | 能,很紧 |
| 70B | 43.1GB | 32K,q8_0,5GiB | 约 48.1GB | 不行 | 实际不行 |
这些是估算,还没算运行时自己的缓冲区,也没算第一张卡的桌面占用。每张卡请留一到两 GB 的余量。
双3090 装机的关键配件
主板与 PCIe
多数消费级主板只有一个全速 x16 插槽,其他插槽的通道数较少,所以要查手册看两个插槽同时使用时通道如何分配;很多主板提供 x8 加 x8,有的会把第二个插槽降到 x4 或走芯片组通道。按层拆分时卡间流量不大,而 Ollama 常见问题指出把模型放在一张 GPU 上可以减少经过 PCI 总线的数据,这暗示了拆分是有代价的。第二个插槽通道较少的主板能用,但加载模型可能更慢。更重要的限制是物理尺寸:按 NVIDIA 的数据,3090 公版是三槽厚、长 313mm,所以两张需要插槽间距和足够大的机箱。我们单卡参考方案里便宜的 B760M 主板不太可能适合两张这样的卡,请为更大的主板预留预算。
电源
NVIDIA 给出单张 3090 的系统要求是 750W 电源。一对卡需要更多余量。公版设计的 3090 额定功耗大约每张 350W,所以两张卡、CPU 和其他部件加起来峰值可能接近 1000W。1000W 的优质电源是下限,1200W 更从容;你也可以用 nvidia-smi -pl 限制每张卡的功率,这样降低发热和噪音,请在自己的任务上测试会损失多少速度。我们的参考价表里,1000W 电源约 1,199 元。
散热与机箱
两张三槽卡并排会憋热。选前面进风强的机箱,主板允许的话在两张卡之间留出间隙,并用 nvidia-smi 监控温度。二手卡的硅脂或导热垫可能已经老化,所以买到后要马上检查温度。NVIDIA 给出 3090 的最高 GPU 温度是 92 摄氏度;持续负载下应当远低于这个值。
NVLink:不是必需
RTX 3090 支持 NVLink,NVIDIA 也销售 30 系列用的桥接器。对于按层拆分的推理它不是必需的,两张卡通过 PCIe 工作,很多社区装机并不用桥接器。NVLink 对训练和某些张量并行的方案更重要。如果卖家便宜地附送桥接器是个加分项,但做聊天和编程用途时不要为它多花钱。
软件怎样使用两张卡
llama.cpp
llama.cpp 服务器文档描述了分卡模式选项:none 只用一张 GPU,layer(默认)把层和 KV 按流水线拆到各张 GPU,row 按行拆分权重,tensor 被标注为实验性。--tensor-split 设置每张卡的比例,例如两张相同的卡用 1,1,不同的卡用 3,1,--main-gpu 选择主卡。对大多数用户来说,默认的 layer 模式加平均拆分就对了。
Ollama
Ollama 常见问题说明,如果模型能完全放进一张 GPU,就加载到那张上,这通常性能最好;放不下才会分散到所有可用 GPU。也就是说,一对卡只在模型放不进单卡时才会用到,正好是 70B 的情况。你不需要手动配置拆分。
速度如何
按层拆分是依次运行各层,所以对单个对话,第二张卡增加的是内存而不是速度。生成速度的限制是内存带宽,见《显存指南》;每个 token 仍要读取所有权重,70B 模型读的比 32B 多得多,所以 70B 在两张卡上每个 token 的速度会比 32B 在一张卡上慢。我们这里不发布实测数字,请在自己的机器上测试。如果同时服务多个用户且每个模型能放进一张卡,两张卡可以提升吞吐,因为每张卡可以各自处理一个请求。
推算的造价
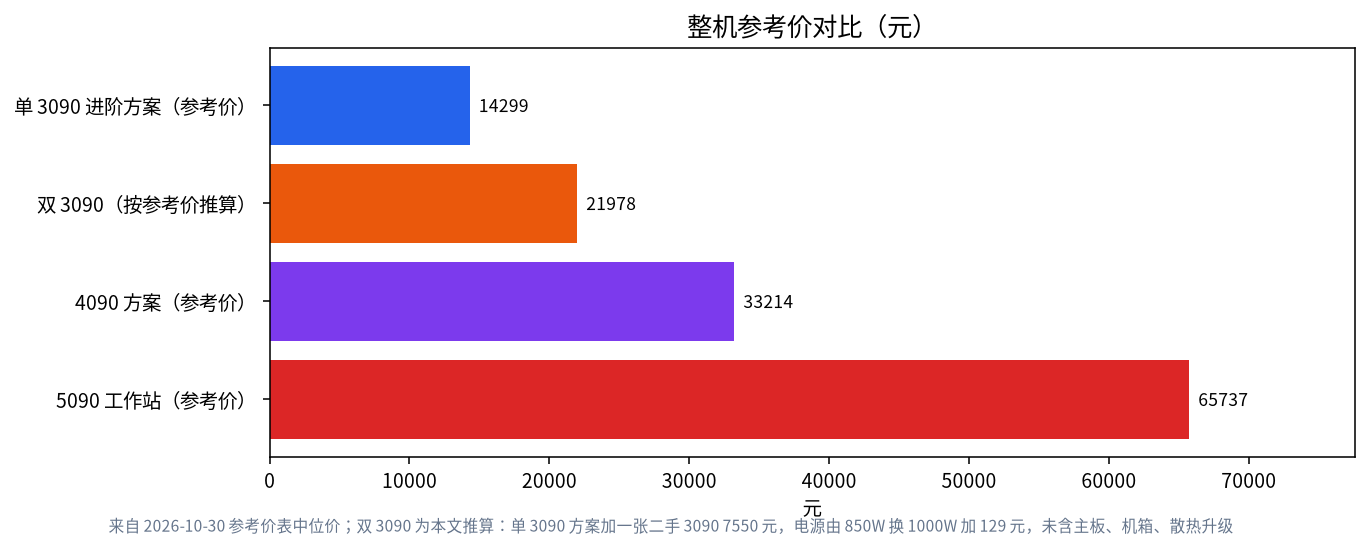
参考方案里,单 3090 的进阶配置是 14,299 元,其中二手 3090 为 7,550 元,850W 电源为 1,070 元。再加一张 7,550 元的二手 3090,并把电源换成 1,199 元的 1000W(多 129 元),得到约 21,978 元。这没有包括间距合适的主板、更大的机箱和额外散热,这些可能增加不少,而二手卡的价格还会因成色和卖家而异。作为对比,4090 参考方案是 33,214 元,5090 工作站是 65,737 元。这一对卡的总内存比两者都多,但只是内存,每张卡的带宽仍是 3090 的 936 GB/s。
| 方案 | 显存 | 参考价 | 优点 | 缺点 |
|---|---|---|---|---|
| 一张二手 3090 | 24GB | 整机 14,299 元 | 简单、便宜 | 跑不了 70B |
| 两张二手 3090 | 48GB | 约 21,978 元(推算,未含升级) | 适度上下文下的 70B Q4 | 电源、发热、体积、二手风险 |
| 一张 4090 | 24GB | 整机 33,214 元 | 单卡更快 | 仍是 24GB |
| 一台 5090 工作站 | 32GB | 整机 65,737 元 | 最新、单卡最快 | 成本高,仍低于 48GB |
什么时候单卡更好
- 你只跑最多 32B 的模型:第二张卡只是增加成本和噪音。
- 你重视安静和低功耗:单卡更容易。
- 你对二手硬件没把握:两张二手卡风险翻倍。
- 你想要每个模型的最佳速度:模型放得下时,一张更快的卡胜过两张较慢的。
谁适合这样装机
一对二手卡适合特定的用户:出于隐私或成本原因想在本地运行 70B 级模型,能接受二手硬件,有放得下大型、有噪音机器的机箱和桌面,并且不要求最快的速度。爱好者试验很多模型、小团队想要共享模型服务器、以及用大模型处理长文档的人都是典型例子。如果你的工作主要是用最多 32B 的模型聊天和写代码,一张 24GB 的卡更简单也更便宜,需求增长时再回头考虑第二张。很多装机者先用一张卡,主板和电源选能容纳第二张的,这样把成本摊开,也能在看清自己实际怎么用这台机器之后再决定。
噪音、发热和电费的规划
两张高功耗显卡在持续负载下会产生明显的热量和风扇噪音,而一对二手卡的风扇可能不如新卡安静。把机器放在噪音无所谓的地方,或选带大尺寸慢转风扇的机箱,并考虑限制显卡功率。还要看电费:一台每天运行几个小时、功率几百瓦的机器会增加你的账单,与其他电器共用的线路也应该有余量。如果机器要一直开着当服务器,待机功耗也很重要;请在自己的机器上看每张卡待机时的功耗,并决定不用时是否关机。这些都不是避开这种装机的理由,但它们是配件清单不会显示的真实成本的一部分。
采购与安装清单
- 确认机箱能放下两张三槽卡,并量好空间。
- 选择第二个插槽通道数和间距足够的主板。
- 选 1000W 到 1200W 的优质电源,供电接口数量要足够。
- 先把每张二手卡单独测试,再装两张。
- 安装最新驱动,用
nvidia-smi确认两张卡都被识别。 - 先用小上下文加载 70B 模型,再边看内存边增大。
常见错误
- 把 48GB 当成没有余量的一整块:每张卡都需要缓冲区空间。
- 忽视电源:电源功率不足会在负载下崩溃。
- 两张卡贴得太近:发热降频会降低速度并缩短寿命。
- 期待速度翻倍:一对卡增加的是内存,不是生成速度。
- 跳过二手卡的测试:在装一对之前先单独测试每一张。
常见问题
两张 24GB 显卡能跑 70B 模型吗?
可以跑 Q4_K_M,llama.cpp 文档给出其文件约 43.1GB,上下文适度。长上下文需要量化缓存,而且余量很小。
需要 NVLink 吗?
对按层拆分的推理不需要,两张卡通过 PCIe 通信。NVLink 对训练更有用。
第二张 GPU 能让速度翻倍吗?
不能。按层拆分增加的是内存。单个对话仍要按顺序经过各层。
需要多大的电源?
NVIDIA 给出单张 3090 系统是 750W。两张的话,最低按 1000W,想要余量用 1200W,并考虑用 nvidia-smi -pl 限制功率。
Ollama 会自动用两张卡吗?
根据其常见问题,能放进一张 GPU 的模型会加载到那张上,放不下的模型会分散到所有可用 GPU。
可以混用不同的 GPU 吗?
llama.cpp 允许用 --tensor-split 做不均匀拆分,但混用的卡受限于较小的那张和驱动支持;依赖它之前请先测试。
分享你的装机
如果你组装过双卡机器,欢迎告诉我们哪些做法有效。可以发到社区,或发邮件到 admin@microaione.com。
参考:NVIDIA GeForce RTX 3090 系列、llama.cpp 服务器文档、Ollama 常见问题、llama.cpp 量化说明。