本地微调显存需求:QLoRA 与 LoRA 到底要多少 GPU 显存
运行一个模型需要的内存,远少于教它新东西所需的内存,这个差距让几乎每个在家尝试微调的人都感到意外。这篇关于 本地微调显存需求 的指南给出 QLoRA 和 LoRA 在 3B 到 70B 的公开显存下限,解释是什么让真实占用高于这些下限,并列出训练刚刚因显存不足崩溃时的补救手段,也讲了 Mac 和 Windows 的路线,以及训练之后怎么使用适配器。如果你还没确定微调是不是合适的工具,请先看本地 RAG 指南,因为检索能解决很多人想靠训练来解决的问题。
核对说明:显存下限来自 Unsloth 文档,文档明确说这些是绝对最低值,有些模型需要更多。“48GB 上微调 65B”的说法来自 QLoRA 论文摘要,MLX 的默认值来自 mlx-lm 的 LoRA 文档。我们没有为这篇文章实际运行训练任务,所以建议的余量是我们自己的经验法则,并已标注,算例都是假设性的。
要点速览(更新于 2026-10-30)
- 按 Unsloth 文档,QLoRA(4 位)的下限是 7B 需 5GB、14B 需 8.5GB、32B 需 26GB、70B 需 41GB;同样尺寸的 16 位 LoRA 分别需要 19GB、33GB、76GB 和 164GB。
这些是下限,不是预算。批大小、样本长度和模型本身都会让真实占用更高,所以要留余量。
训练爆显存时,先降批大小,再缩短样本,然后改用 QLoRA,最后用梯度检查点。
先问一句:真的需要微调吗
微调改变的是模型的行为:语气、输出格式、在某个窄任务上的习惯。它不适合用来添加事实,因为训练进去的事实既难更新又难核对。如果你的目标是让模型根据你的文档回答,检索通常是更好的第一步,我们的 RAG 指南讲了怎么做。如果你想要不同的风格、严格的输出格式,或者提示词撑不住的专门行为,微调才有意义。
一个简单的测试有帮助:写一个好的提示词,在里面放几个示例,用你现有的模型跑一下。如果大多数时候都行,可能就不需要训练。如果它总是以同样的方式失败,你就找到了适合 LoRA 的任务。本地训练还能让训练数据留在你自己的机器上,当样本涉及隐私时,这很重要,见隐私指南。
用大白话讲 LoRA 和 QLoRA
全量微调要更新模型的每个权重,所以需要为权重、梯度和优化器状态准备内存。2021 年论文提出的 LoRA 冻结原始权重,只训练加在旁边的小型低秩适配器矩阵。只有适配器需要梯度和优化器状态,因此内存大幅下降,产出的是一个小的适配器文件,而不是模型的另一份完整拷贝。
QLoRA 又走了一步。作者描述的做法是:让梯度穿过一个冻结的 4 位量化预训练模型,反向传播到 LoRA 适配器里,摘要里说这把内存降到足以在单张 48GB 显卡上微调 65B 参数的模型。实际上,QLoRA 意味着基座模型以 4 位形式加载,类似我们量化指南里讲的量化文件,而适配器用更高精度训练。代价是多一些计算,视配置而定可能还有一点质量损失,所以它是消费级显卡的默认选择。
不同尺寸的本地微调显存需求
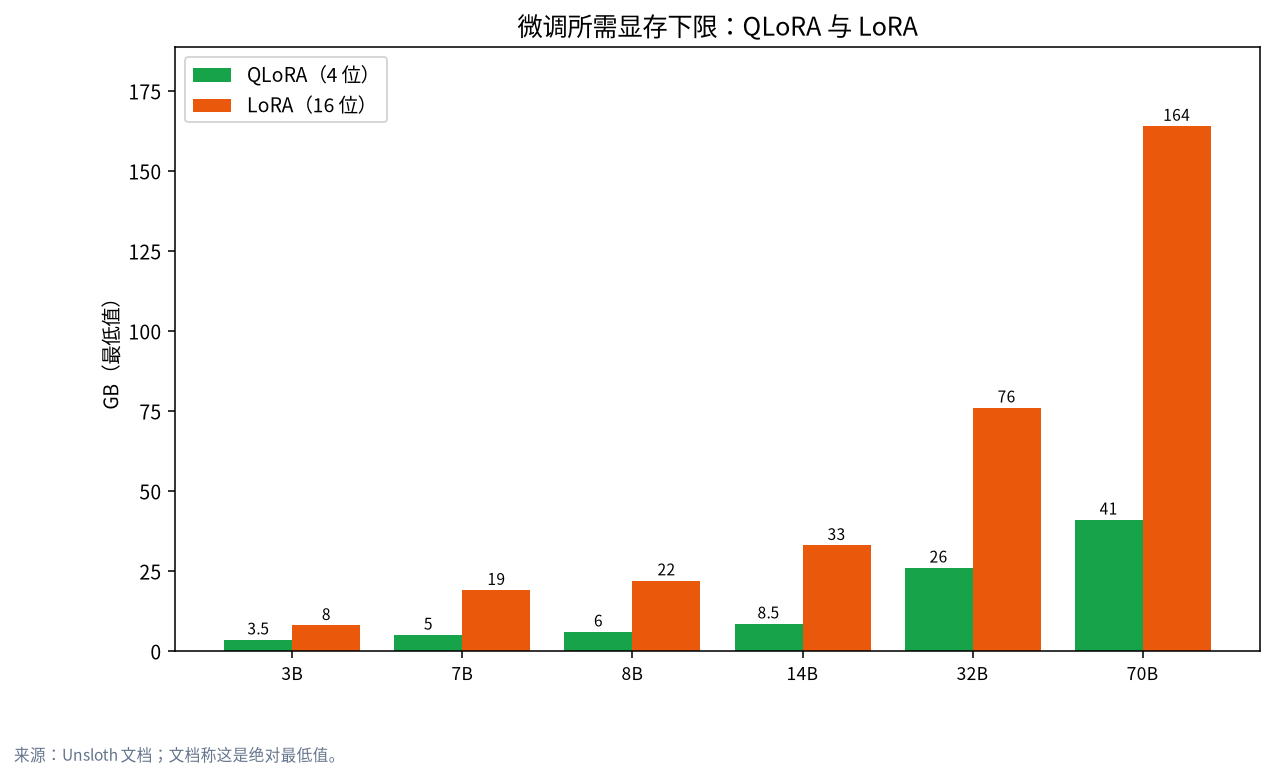
Unsloth 文档发布了一张按模型尺寸和方法排序的最低显存表,是我们找到的最清晰的公开参考。它说明 QLoRA 用 4 位、LoRA 用 16 位,数字是绝对最低值,因为有些模型需要更多。
| 参数量 | QLoRA(4 位)下限 | LoRA(16 位)下限 |
|---|---|---|
| 3B | 3.5GB | 8GB |
| 7B | 5GB | 19GB |
| 8B | 6GB | 22GB |
| 14B | 8.5GB | 33GB |
| 27B | 22GB | 64GB |
| 32B | 26GB | 76GB |
| 70B | 41GB | 164GB |
有两点很突出。第一,16 位 LoRA 增长很快:14B 模型要约 33GB,超出了除 32GB 的 RTX 5090 之外的所有单张消费卡,而加上余量之后,连它也不够。第二,QLoRA 让 14B 在纸面上能放进 12GB 的显卡,32B 能放进 32GB 的显卡。对比一下推理:14B 的 Q4_K_M 光权重就约 8.6GB,见显存指南。
你的显卡能放下什么
用上面的下限,看看常见显存容量怎么对应。右边一列是我们自己的经验法则,不是公开数字:我们建议选 QLoRA 下限不超过显存约 70% 到 75% 的模型,这样更长的样本和大于 1 的批大小也放得下。
| 你的显存 | QLoRA 下限能放下的最大模型 | 比较舒适的选择(我们的经验法则) |
|---|---|---|
| 8GB | 7B 为 5GB,8B 为 6GB | 3B 到 7B,样本要短 |
| 12GB | 14B 为 8.5GB | 8B,或谨慎地用 14B |
| 16GB | 14B 为 8.5GB | 14B |
| 24GB | 27B 为 22GB | 14B 很舒适,27B 勉强 |
| 32GB | 32B 为 26GB | 14B 到 27B,32B 偏紧 |
| 48GB | 70B 为 41GB | 32B 舒适,70B 偏紧 |
特别是 24GB 显卡,Unsloth 的表把 27B 放在 22GB,几乎没有余量,而 32B 的 26GB 根本放不下。这些显卡还能做什么,见 24GB 指南和 12GB 与 16GB 指南。如果你在为微调选模型尺寸,模型尺寸选择指南用同样的思路讲了推理的情形,原则是通用的:从比你想象的更小的开始。
为什么真实占用比表里更高
Unsloth 的页面明确说这些数字是下限。有几件事会把真实占用推高。
批大小。 Unsloth 把批大小过高列为爆显存的常见原因,建议试试 1、2 或 3。每多同时处理一个样本,激活内存就多一份。
样本长度。 更长的训练样本需要更多内存,因为激活随序列长度增长。mlx-lm 的文档也这么说:更长的样本需要更多内存,如果对你的数据来说合理,就把它们拆开。
适配器大小和模型本身。 更高的适配器秩会增加可训练参数,不同架构的用量也不同,所以文档提醒有些模型需要比表里更多。
显卡上的其他东西。 桌面、浏览器和其他使用 GPU 的进程都从同一块显存里取用。长时间训练前请关掉它们。
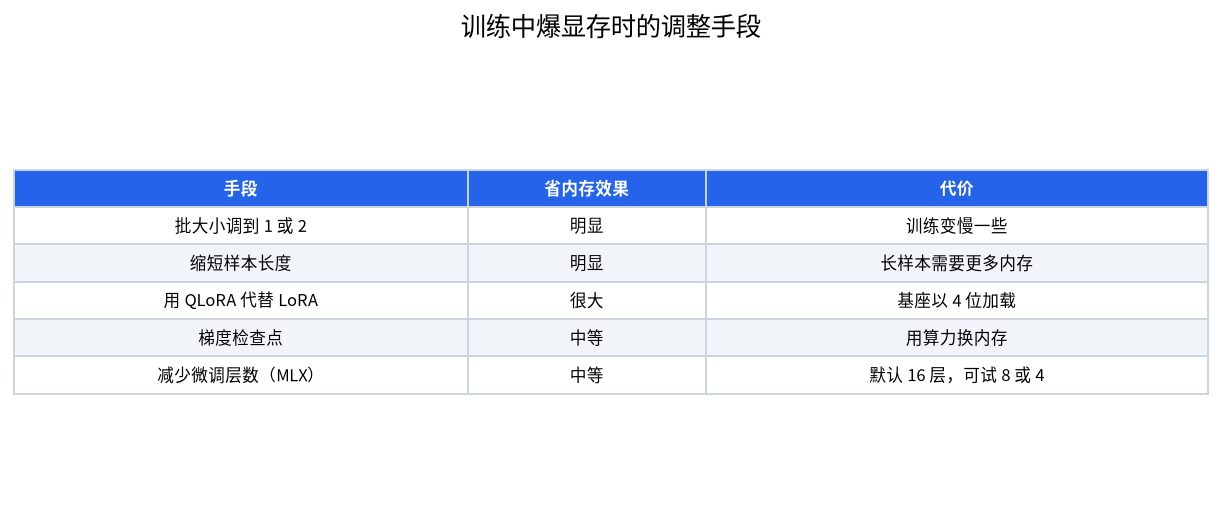
按我们会采用的顺序调整内存手段
当训练因显存不足崩溃时,一次只改一样,并在改下一样之前简单重跑一下。
- 把批大小降到 1 或 2。 这是最便宜的办法,只会让训练稍微变慢。如果想要更大的有效批,可以改用梯度累积。
- 缩短样本。 如果对你的数据合理,就裁剪或拆分过长的样本。
- 用 QLoRA 代替 LoRA。 以 4 位加载基座是最大的单项节省,表里一目了然。
- 打开梯度检查点。 它用额外的计算换更低的内存,对长序列最有帮助。
- 换一个更小的基座模型。 如果别的都不行,能放下的小模型胜过永远跑不完的大模型。
推理阶段的显存不足,原因不同,见显存不足排障指南。
Mac 路线:MLX
在苹果芯片上,mlx-lm 包含 LoRA 微调。它的文档给出形如 mlx_lm.lora --model <path_to_model> --train --data <path_to_data> --iters 600 的命令,并说明:如果模型路径指向量化模型,训练用 QLoRA,否则用普通 LoRA。支持的微调类型有 lora(默认)、dora 和 full。
同一份文档里有一节“Memory Issues”,与上面的手段一一对应:建议用 QLoRA、调小 --batch-size(默认是 4)、用 --num-layers 减少层数(默认是 16,可试 8 或 4)、缩短样本,以及加上 --grad-checkpoint。数据放在 train.jsonl 里,可选的 valid.jsonl 会报告验证损失,适配器默认存到 adapters/。mlx_lm.fuse 命令能把适配器合并进模型并保存融合后的模型。
在 Mac 上,限制是与其他程序共享的统一内存,所以我们 Mac 指南的实用建议同样适用:给系统留出空间,关掉其他吃内存的应用。MLX 与 GPU 的速度对比我们不下结论,因为没有实测过。
Windows 和 Linux 路线
Unsloth 的要求页面列出了 Windows、macOS、Linux 和 WSL,以及仅 CPU 的选项。在 Windows 上,很多人更喜欢 WSL 2,因为它像 Linux 一样工作又能用到 GPU,设置方法见 WSL 2 与 Docker 指南。无论走哪条路线,开始前请查看当前的要求页面里你这代 GPU 的情况,因为驱动和库的支持随版本变化。
训练之后怎么使用适配器
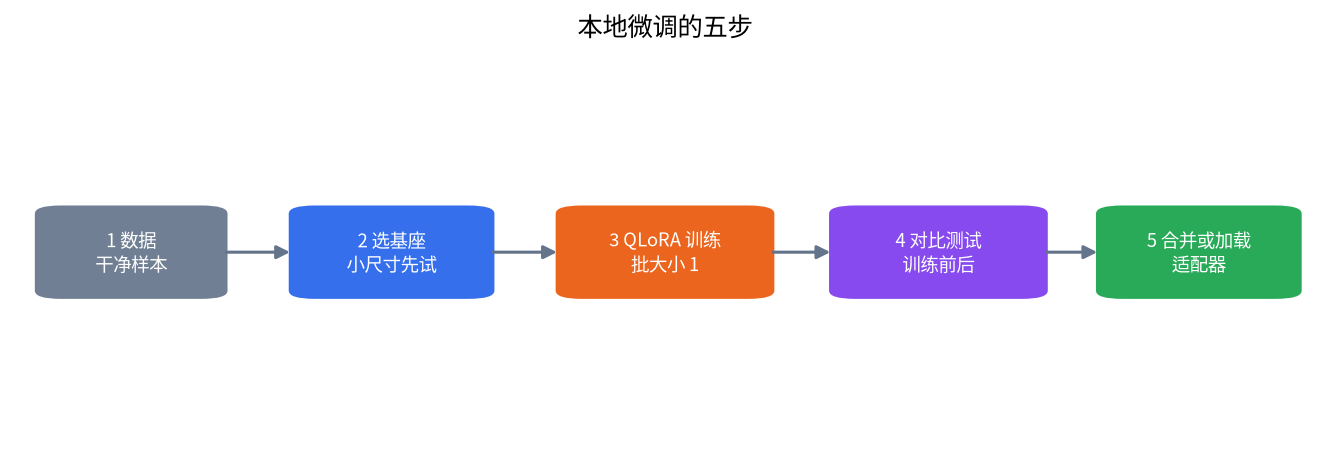
训练会产出一个适配器,用法有两种。可以把它合并进基座模型,得到一个单独的模型文件,就像 Mac 上的 mlx_lm.fuse 那样。也可以在运行时把适配器挂在基座旁边加载。llama.cpp 的服务端用 --lora FNAME 支持这点,加载 GGUF 格式的 LoRA 适配器,README 还提到,使用不同 LoRA 配置的请求不会被合并成一批,这可能降低性能。llama.cpp 仓库里有 convert_lora_to_gguf.py 脚本用来转换适配器,格式本身见我们的 GGUF 指南。请查阅你所用服务工具的文档,看它期望的适配器形式,因为各家支持不同。
一个假设性的规划算例
这是对方法的演示,不是真实运行的记录。假设你有一块 16GB 的显卡,想要一个按固定格式回答客服工单的模型。表里 14B 模型的 QLoRA 下限是 8.5GB,约占 16GB 的 53%,在我们的经验法则之内。你会从批大小 1、裁剪到真正需要的长度的样本,以及一次短运行开始,看损失是否下降、内存是否稳住。然后把调好的模型和原模型放在你没用于训练的一批样本上比较。如果内存紧张,就退到 8B 基座,而不是硬撑 14B。
比较这一步是人们最常跳过的。一定要留几条样本不参与训练,在训练前后用同样的提示词运行,自己判断回答的好坏。训练损失下降只说明模型在学你的样本,不说明它在真实任务上更好。
常见错误
- 把表当作预算。 这些数字是下限,要为余量做规划。
- 一上来就用 16 位 LoRA。 同样尺寸下,它需要的内存是 QLoRA 的数倍。
- 没注意就用了很长的样本。 长度决定内存,要检查。
- 跳过留出的测试。 没有它,你分不清是改进还是死记硬背。
- 为了添加事实去微调。 想改变知识,检索通常更好。
- 其他 GPU 应用没关。 它们和训练共用同一块显存。
常见问题
微调 7B 模型需要多少显存?
Unsloth 文档给出的下限是 QLoRA 5GB,16 位 LoRA 19GB。真实占用取决于批大小和样本长度。
能在家里微调 70B 吗?
QLoRA 列出的下限是 70B 需 41GB,所以需要 48GB 级别的配置,而且很紧。16 位 LoRA 列出的是 164GB。
LoRA 和 QLoRA 有什么区别?
LoRA 在冻结的权重上训练小型适配器。QLoRA 做同样的事,但冻结的基座以 4 位加载,内存大幅下降。
24GB 显卡够用吗?
对 QLoRA 来说,按给出的 22GB 下限,它能覆盖到约 27B,几乎没有余量。14B 更舒适。
能在 Mac 上微调吗?
可以,mlx-lm 包含 LoRA 和 QLoRA 训练。速度和内存取决于你的机器,我们没有实测。
做文档问答机器人需要微调吗?
通常不需要。从你的文档里检索是更常见也更简单的路线,见我们的 RAG 指南。
和我们聊聊
在社区告诉我们你的显卡和任务,我们帮你估算一次训练,或者发邮件到 admin@microaione.com。
参考资料:Unsloth 要求页面、QLoRA 论文、LoRA 论文、mlx-lm LoRA 文档、llama.cpp 服务端 README。