Voyage 4 Large 评测:最好的嵌入模型?对比 Qwen3-Embedding、Gemini 与本地 voyage-4-nano
Voyage 4 Large 是 Voyage AI 在 2026 年 1 月随 voyage-4 系列发布的旗舰文本嵌入模型,官方称它是首个商用的混合专家(MoE)嵌入模型。要说它是”最好的嵌入模型”,证据主要来自 Voyage 自己发布的 RTEB 对比:在 29 个数据集上的平均 NDCG@10,它超过 Gemini Embedding 001、Cohere Embed v4 和 OpenAI v3 Large。但在公共的 MTEB 英文检索榜单上,我们没有在前十里找到它;前十里有的是 Qwen3-Embedding-8B 这样的开放权重模型。这篇文章把厂商自测、公共榜单、价格和存储成本放在一起,回答本地读者的问题:做 RAG 要不要付费用 Voyage 4 Large,还是用能下载运行的 voyage-4-nano 或 Qwen3-Embedding。
核实说明:Voyage 4 Large 的性能数据来自 Voyage 官方博客(2026-01-15),均为厂商自测;价格读取自 Voyage 官方定价页;MTEB 英文检索榜单读取自 modelmenu.dev(2026-10-27 更新);Qwen3-Embedding 的数据来自其 Hugging Face 模型卡,那里的 MTEB 分数日期是 2025 年 6 月,已经不是最新;voyage-4-nano 的信息来自其 Hugging Face 模型卡。我们没有自己评测过任何嵌入模型,存储与成本数字是我们的算术。
要点速览(更新于 2026-11-01)
- 厂商自测:RTEB 29 个数据集平均 NDCG@10,voyage-4-large 比 voyage-4 高 1.87%,比 Gemini Embedding 001 高 3.87%,比 Cohere Embed v4 高 8.20%,比 OpenAI v3 Large 高 14.05%。
价格:voyage-4-large 每百万 token 0.12 美元,voyage-4 为 0.06 美元,voyage-4-lite 为 0.02 美元;每个账号前 2 亿 token 免费。
本地:voyage-4-nano(Apache-2.0,约 3.4 亿参数)与旗舰共享嵌入空间;Qwen3-Embedding 有 0.6B、4B、8B 三档。
先看结论:榜首来自厂商自测
| 来源 | Voyage 4 Large 的位置 | 需要知道的前提 |
|---|---|---|
| Voyage 官方博客(RTEB,29 个数据集) | 领先所比较的 Gemini Embedding 001、Cohere Embed v4、OpenAI v3 Large 与自家 voyage-4、voyage-4-lite | 厂商自测,比较对象由厂商选择;博客比较的是 RTEB 的平均 NDCG@10 |
| MTEB 英文检索(modelmenu.dev) | 前十中未见 | 我们没有看到它的 MTEB 提交;榜首为 Yuan Embedding 2.0 En(70.7) |
| 价格 | 每百万 token 0.12 美元 | 比 Gemini Embedding 001(约 0.15 美元)便宜 |
这个结论的重点是:”没有出现在榜单上”不等于”不好”,而是意味着它和榜单上的模型没有在同一把尺子上量过。RTEB 是 Voyage 自己发起并用于其评测的检索基准,我们无法在这篇文章里独立核实其数据集构成,所以这里只是转述厂商的结论。
MTEB 英文检索榜单
modelmenu.dev 的 MTEB 英文检索榜单(2026-10-27 更新,数字为平均 nDCG@10 乘以 100):
| 名次 | 模型 | 平均 nDCG@10 | 备注 |
|---|---|---|---|
| 1 | Yuan Embedding 2.0 En | 70.7 | — |
| 2 | Ingot 8B R3 | 70.0 | — |
| 3 | Qwen3-Embedding-8B | 69.4 | 4096 维,上下文约 33K,开放权重 |
| 4 | Geevec | 68.8 | — |
| 5 | Qwen3-Embedding-4B | 68.5 | 2560 维,开放权重 |
| 6 | Seed1.5 | 67.5 | — |
| — | Gemini Embedding 001 | 64.4 | 3072 维,上下文 2K,约 0.15 美元每百万 token |
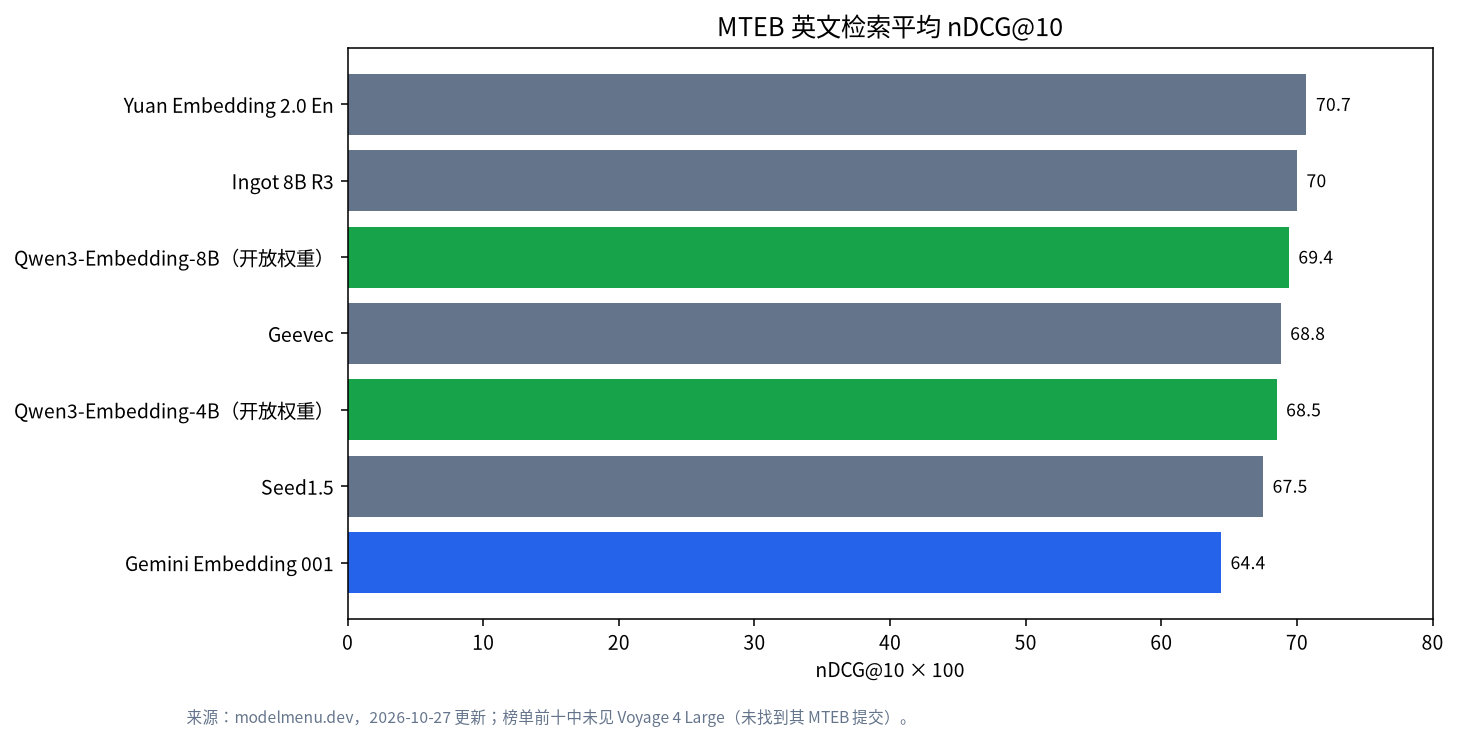
可以看到,开放权重的 Qwen3-Embedding-8B 排第 3,4B 版排第 5,与榜首只差约 1.3 分和 2.2 分。对于要在本地做检索的人,这是个重要事实:公共榜单上,开放权重已经处在第一梯队。至于 Voyage 4 Large,我们没有找到它在这张榜单上的成绩。
Voyage 4 系列的设计:共享嵌入空间
voyage-4 系列的一个独特设计是:voyage-4-large、voyage-4、voyage-4-lite 和 voyage-4-nano 共享同一个嵌入空间。这意味着你可以用较大的模型嵌入文档(一次性离线做),再用较小、较便宜甚至本地的 nano 模型嵌入查询,两者的向量仍可直接比较,无需为换模型而重建索引。官方还说明 voyage-4-large 采用 MoE 架构,服务成本比同等稠密模型低约 40%(厂商数据)。向量维度支持 2048、1024、512、256 四档(套娃式),数据类型支持浮点、int8、uint8 和二进制。文档给出的上下文长度是 32,000 token,默认维度 1024。
价格与成本
Voyage 官方定价页(我们读取了本页):
| 模型 | 每百万 token(美元) | 免费额度 |
|---|---|---|
| voyage-4-large | 0.12 | 前 2 亿 token |
| voyage-4 | 0.06 | 前 2 亿 token |
| voyage-4-lite | 0.02 | 前 2 亿 token |
| 旧款 voyage-3-large | 0.18 | 无 |
| Batch API | 在标准价基础上 33% 折扣 | 12 小时完成窗口,免费额度不适用于批处理 |
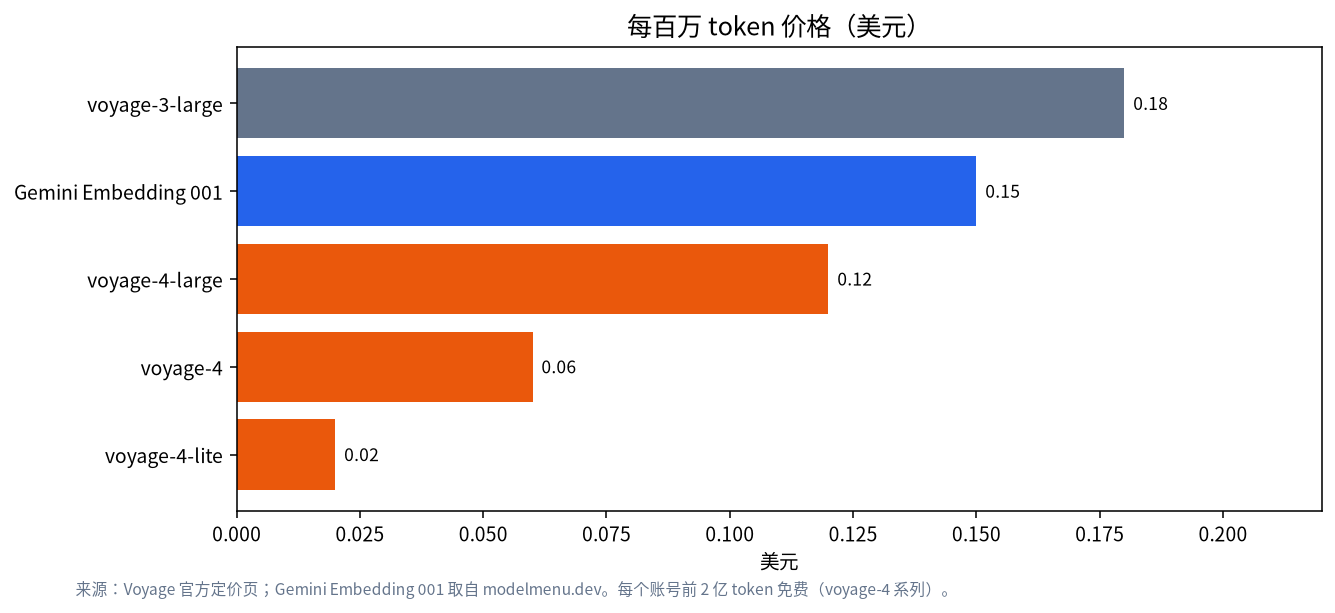
做两个算例(我们的算术,不含查询量):
- 小型知识库,5,000 万 token 的语料:在前 2 亿免费 token 之内,嵌入成本为 0。
- 10 亿 token 的语料:扣除前 2 亿免费 token,剩余 8 亿 token。按 voyage-4-large 约 96 美元,voyage-4 约 48 美元,voyage-4-lite 约 16 美元。若走 Batch API(不扣免费额度),10 亿 token 按 voyage-4-large 约 80.4 美元。
结论:嵌入的一次性成本本身不高,真正的成本来自持续的查询量、重新嵌入(换模型或文档更新)以及向量存储。
向量存储:维度与数据类型决定账单
我们的算术:每个向量占用的字节数等于维度乘以每维字节数。100 万篇文档:
| 配置 | 每向量字节数 | 100 万向量体积 |
|---|---|---|
| 2048 维,float32 | 8,192 | 约 8.19GB |
| 1024 维,float32 | 4,096 | 约 4.10GB |
| 1024 维,int8 | 1,024 | 约 1.02GB |
| 256 维,int8 | 256 | 约 0.26GB |
| 1024 维,二进制 | 128 | 约 0.13GB |
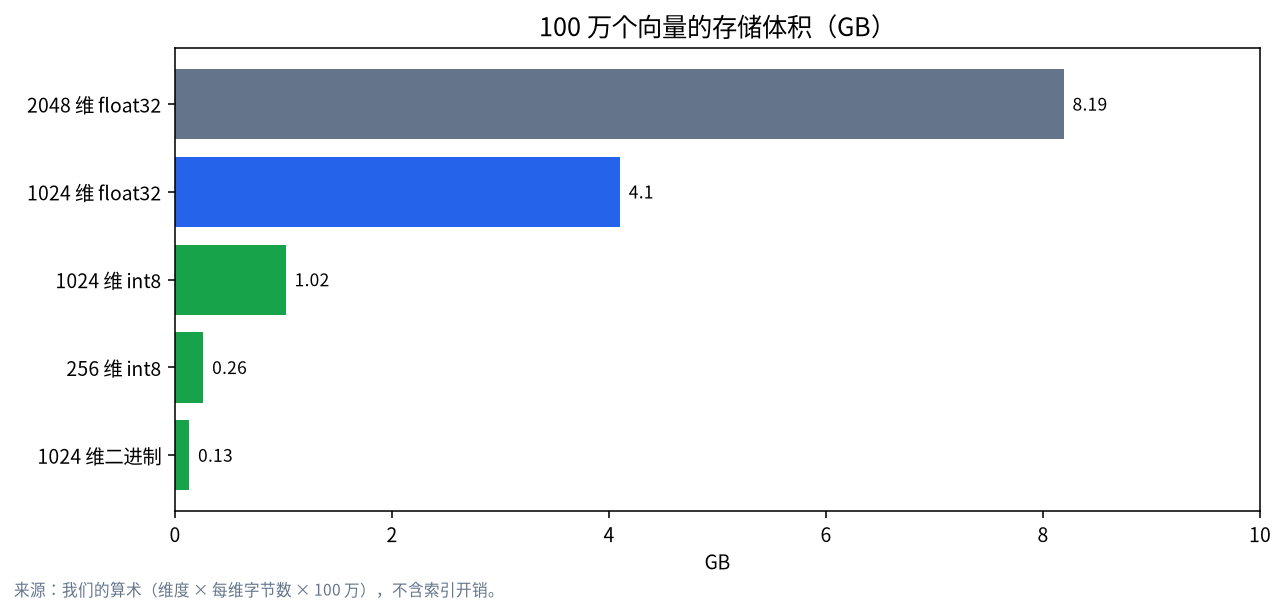
从 2048 维浮点降到 1024 维 int8,体积下降到八分之一;降到 1024 维二进制,是 64 分之一。这些压缩会带来检索质量损失,具体损失我们没有在本文核实,必须在你自己的数据上测。
本地能用什么:voyage-4-nano 与 Qwen3-Embedding
| 模型 | 规模 | 特点 | 许可证与说明 |
|---|---|---|---|
| voyage-4-nano | 约 3.4 亿参数(1.8 亿非嵌入参数加 1.6 亿嵌入参数) | 上下文 32K;维度 2048、1024、512、256;与 voyage-4-large 共享嵌入空间;有 GGUF 版本可用于 Ollama | Apache-2.0 |
| Qwen3-Embedding-0.6B / 4B / 8B | 0.6B、4B、8B | 上下文 32K,维度最高 4096(可自定义 32 到 4096);支持 100 多种语言与指令;官方 MTEB 多语种分数 64.33、69.45、70.58(2025 年 6 月),C-MTEB 中文 66.33、72.27、73.84 | 许可证请以模型卡为准,本文未核实 |
Qwen3-Embedding-8B 的权重按参数量约 16GB(BF16,我们的算术),4B 约 8GB,0.6B 约 1.2GB;这不含推理时的激活与批量开销。对中文读者,C-MTEB 的数据尤其有价值:8B 版为 73.84,4B 版为 72.27。想搭建本地检索系统,可以看本地知识库 RAG 搭建和Dify 与 RAGFlow 本地部署;硬件可参考GPU 显存指南。
怎样选:付费旗舰还是本地模型
| 你的情况 | 倾向 | 理由 |
|---|---|---|
| 数据不能出本机 | Qwen3-Embedding 或 voyage-4-nano | 开放权重,可在本地运行 |
| 主要是中文,且要本地 | Qwen3-Embedding-4B 或 8B | C-MTEB 数据较高,支持 100 多种语言 |
| 要尽快上线、语料不大 | voyage-4-large(API) | 前 2 亿 token 免费,接入简单 |
| 要降低查询成本又想保留旗舰质量 | 旗舰嵌入文档、nano 嵌入查询 | 共享嵌入空间,无需重建索引 |
| 对存储敏感 | 较小维度加 int8 或二进制 | 体积可降到八分之一以下,但需自测质量 |
查询成本:被低估的一项
很多人只算一次性的文档嵌入费,却忘了查询每天都在产生费用。做个算例(我们的算术,假设每次查询约 30 个 token,且不计免费额度):每天 10 万次查询是每天 300 万 token,每月约 9,000 万 token。按 voyage-4-large 约 10.8 美元每月,按 voyage-4-lite 约 1.8 美元每月。金额都不大,但如果你的查询量是这个的一百倍,差别就会变得明显;而如果查询放在本地用 nano 模型完成,边际成本接近零,只剩电费。这正是共享嵌入空间的价值:文档一次性用大模型嵌入,查询在本地用小模型嵌入。
怎么读厂商的”领先 X%”
Voyage 博客写的是”比 Gemini Embedding 001 高 3.87%,比 OpenAI v3 Large 高 14.05%”。读这类数字有三个要点。第一,它是相对差距,不是绝对分数,我们没有看到博客里完整的绝对分数表可供在文中复述,所以不要把它换算成”NDCG 提升多少个点”。第二,比较对象由厂商选择,博客里没有出现榜单上开放权重的 Qwen3-Embedding;这并不是说它们更好,而是说这个比较回答不了”和开放权重模型相比如何”。第三,平均数会掩盖分布:某个数据集上差,另一个数据集上好,平均下来仍然领先,而你的数据可能恰好落在差的那一类里。关于怎样读榜单,请见怎么读模型评测榜单。
上下文 32K 不是让你塞满
文档给出的上下文是 32,000 token,Qwen3-Embedding 也是 32K。但对检索来说,把一整篇长文塞进一个向量通常不是好主意:一个向量要代表一篇长文的所有内容,细节会被稀释,检索出来的片段也太长,后面送给大模型的上下文会被撑满。更常见的做法是切成数百 token 的块,保留标题等元数据,并在块之间留出重叠。长上下文的价值在于:当你的段落本身很长(如法律条文、论文章节)时,不必被迫硬切。具体切块与评估方法,请参考本地知识库 RAG 搭建。
自己复现:评测方法
我们没有评测过这些模型,下面的流程可以让你在自己的数据上做出判断。
- 构建 200 条查询:来自真实用户问题,并为每条标注 1 到 3 篇相关文档。
- 准备干扰文档:至少 1 万篇,包含与相关文档相近的”难负例”。
- 统一流程:同样的切块方式、同样的相似度(余弦),只替换嵌入模型。
- 指标:计算 Recall@10、nDCG@10 和 MRR;中文与英文分开统计。
- 压缩实验:对每个模型,测试 1024、512、256 维以及 int8、二进制,记录质量下降。
- 成本与速度:记录每百万 token 的嵌入耗时与费用;本地记录显存与电费。
- 混合实验:用旗舰嵌入文档、nano 嵌入查询,验证共享嵌入空间在你的数据上是否可用。
常见错误
- 把厂商自测当成公共榜单:Voyage 4 Large 的领先来自 RTEB 的厂商对比。
- 忽略榜单日期:Qwen3-Embedding 模型卡上的 MTEB 分数是 2025 年 6 月的。
- 只看嵌入费,不看存储与重嵌入:长期成本往往来自这两项。
- 压缩向量却不测质量:int8 或二进制的损失取决于数据。
- 混用不同嵌入空间:只有 voyage-4 系列声明共享空间,别把它们和其他厂商的向量混在一起。
相关阅读
常见问题:Voyage 4 Large
Voyage 4 Large 是最好的嵌入模型吗?
在 Voyage 自己发布的 RTEB 对比中,它领先所比较的 Gemini Embedding 001、Cohere Embed v4 和 OpenAI v3 Large。但我们没有在公共 MTEB 英文检索榜单前十里看到它。
Voyage 4 Large 多少钱?
官方定价页写明每百万 token 0.12 美元,每个账号前 2 亿 token 免费;Batch API 有 33% 折扣。
有能本地运行的版本吗?
有 voyage-4-nano,Apache-2.0,约 3.4 亿参数,与旗舰共享嵌入空间,并有可用于 Ollama 的 GGUF 版本。
Qwen3-Embedding 能替代它吗?
在公共 MTEB 英文检索榜上,Qwen3-Embedding-8B 为 69.4,排第 3。是否能替代,取决于你的数据,请按本文方法自测。
向量维度怎么选?
维度越高通常质量越好但存储越大。1024 维 int8 比 2048 维 float32 小到八分之一;具体损失需自测。
中文检索用哪个?
Qwen3-Embedding 的 C-MTEB 中文分数为 8B 版 73.84、4B 版 72.27。Voyage 4 Large 的中文表现我们没有读到独立数据。
和我们聊聊
在搭建本地检索或 RAG 系统?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:Voyage AI 博客:voyage-4、Voyage 官方定价、Voyage 嵌入文档、modelmenu.dev MTEB 榜单、Hugging Face:voyage-4-nano、Hugging Face:Qwen3-Embedding-8B。