ElevenLabs Scribe v2 评测:最好的语音识别?对比 Whisper、Nemotron 与 Voxtral
Scribe v2 是 ElevenLabs 的语音识别模型,官方文档称它是”最先进的语音识别模型”。但如果按 Artificial Analysis 的 AA-WER v2(2026-11-01 读取)来排,Scribe v2 的词错误率是 2.2%,排在第 4:前面有 Fun-Realtime-ASR-preview(1.7%)、MAI-Transcribe-2(2.0%)和 Voxtral Small Transcribe 3(2.1%)。也就是说,”最好的 ASR”这个说法在这一榜单上并不成立,更准确的说法是”第一梯队”。它的真正卖点在功能(说话人分离、关键词提示、实体检测、90 多种语言)而不是单一的错误率。本文对照榜单与功能,算出每千小时音频的转写成本,并给本地读者看真正能下载运行的模型:Nemotron 3.5 Transcribe、Voxtral Small、Whisper 和 Parakeet。
核实说明:榜单、价格与速度读取自 Artificial Analysis 语音转文字榜单(2026-11-01),AA-WER v2 由 AgentTalk(50%)、VoxPopuli-Cleaned(25%)和 Earnings22-Cleaned(25%)组成,以英语为主;Scribe v2 的功能读取自 ElevenLabs 官方文档的模型页,文档与官网营销页在个别数字上不一致(例如语言数 90+ 与 99、关键词提示 1000 与 100 个、实体类型 65 与 56、说话人上限 32 与 48),本文一律按文档写;Nemotron 3.5 Transcribe 的数据读取自 Hugging Face 模型卡(英伟达自测)。我们没有自己跑过任何语音识别模型,成本是我们的算术。
要点速览(更新于 2026-11-01)
- AA-WER:Fun-Realtime-ASR-preview 1.7%,MAI-Transcribe-2 2.0%,Voxtral Small Transcribe 3 2.1%,Scribe v2 2.2%(第 4)。
价格:Scribe v2 约 3.67 美元每 1,000 分钟,折合每 1,000 小时约 220 美元;MAI-Transcribe-2 约 1.67 美元每 1,000 分钟。
本地:开放权重里 Nemotron 3.5 Transcribe 与 Voxtral Small 都是 2.8%;Nemotron 为 34B 总参数、约 4.3B 激活,官方部署参考为一块 80GB 的 H100,也支持 NVFP4 的 RTX 5090。
先看结论:第一梯队,不是第一名
| 名次 | 模型 | AA-WER(越低越好) | 每 1,000 分钟(美元) | 备注 |
|---|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.7% | 2.82 | 预览版 |
| 2 | MAI-Transcribe-2 | 2.0% | 1.67 | — |
| 3 | Voxtral Small Transcribe 3 | 2.1% | 4.00 | — |
| 4 | Scribe v2 | 2.2% | 3.67 | 速度系数约 74.4 倍 |
| 5 | Voxtral Mini Transcribe 3 | 2.2% | 3.50 | — |
| 6 | Grok Voice Transcribe | 2.3% | 1.67 | 速度系数约 182.8 倍 |
| — | StepAudio 3 ASR | 2.5% | 6.67 | — |
| — | Gemini 3.5 Transcribe | 2.6% | 5.00 | — |
| — | GPT Transcribe(OpenAI) | 3.3% | 4.50 | — |
| — | Whisper Large v3(fal 托管) | 4.1% | — | 开放权重 |
| — | Parakeet TDT 0.6B V3 | 4.5% | — | 开放权重,速度系数约 638 倍 |
| — | Nova-3 | 5.2% | — | — |
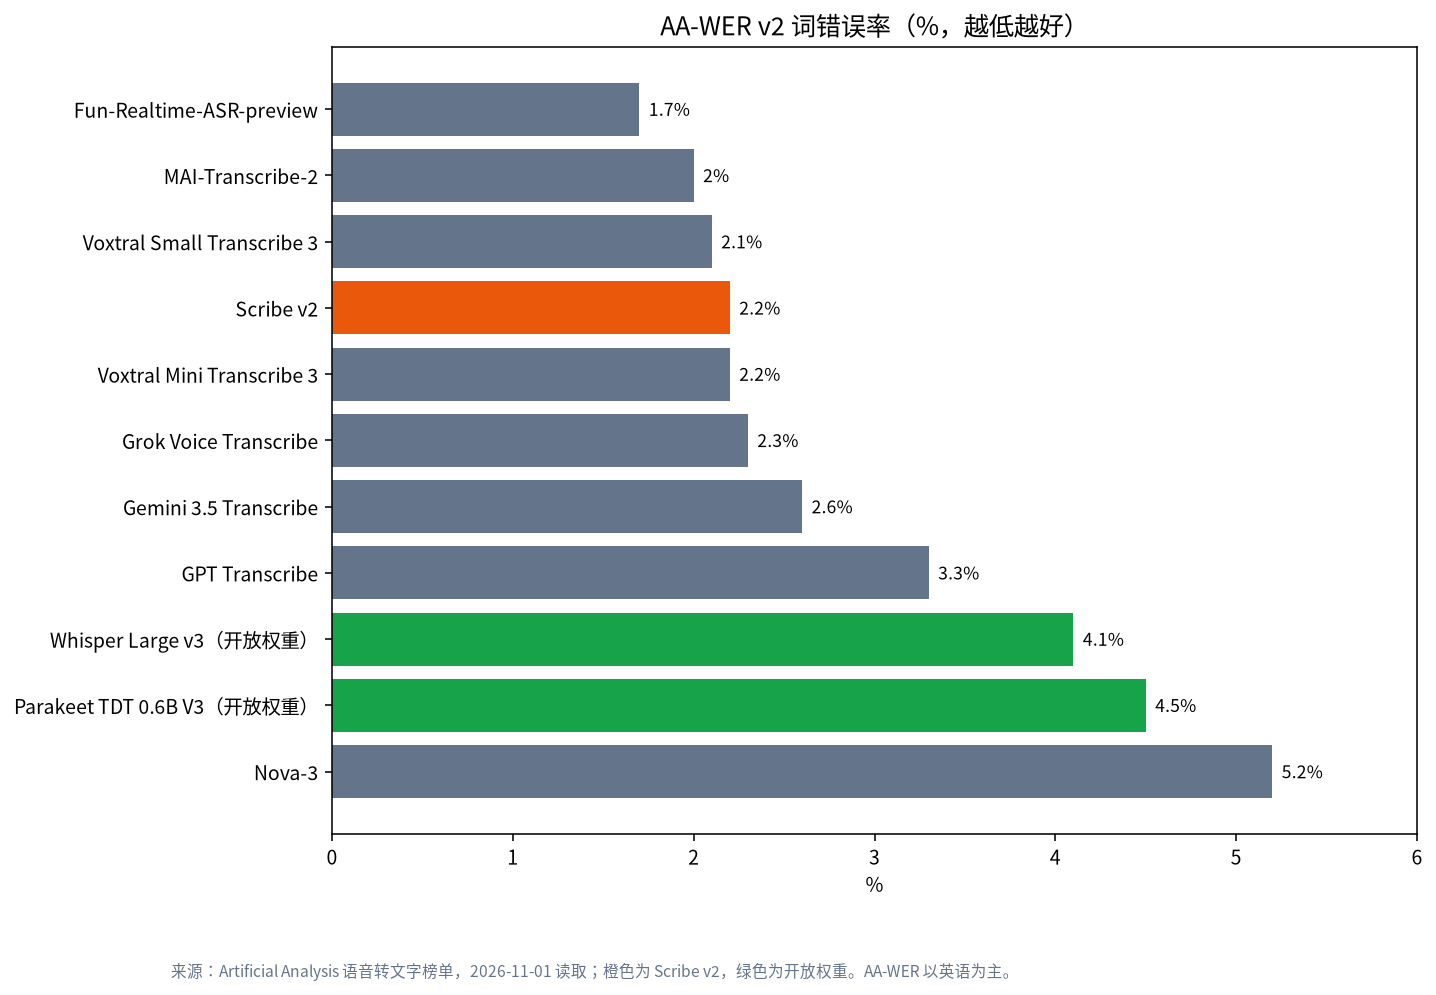
前五名的差距只有 0.5 个百分点,我们把它换成直观的数字:每 1 万个词,Fun-Realtime 约错 170 个,Scribe v2 约错 220 个,Whisper Large v3 约错 410 个。榜首与 Scribe v2 之间的差距是每万词 50 个错误,在很多业务里小于”是否有说话人分离””能不能给专有名词加提示”这些功能的差别。需要强调,AA-WER 以英语为主,并不度量中文,所以对中文读者而言,这张榜只是参考。
Scribe v2 官方文档里的功能
读取模型页后:Scribe v2 支持 90 多种语言,关键词提示最多 1,000 个词,实体检测 65 种类型,说话人分离最多 32 位,带词级时间戳,支持动态音频标签与用自然语言指令编辑转写稿;Scribe v2 Realtime 面向实时场景,提交转写的中位延迟约 150 毫秒;Scribe v2 Medical 面向临床音频,文档称比 Scribe v2 在临床音频上少 35% 的转写错误,价格和 API 相同,并支持 HIPAA 与零保留模式。需要提醒的是,官网的营销页写法与文档不一致,例如语言数写 99 种,所以做采购决策时,请以文档与实测为准。
成本:每千小时音频要花多少钱
按榜单价格折算(我们的算术,每 1,000 小时 = 60,000 分钟,不含订阅优惠、重试与存储):
| 服务 | 榜单价格(每 1,000 分钟) | 每 1,000 小时 |
|---|---|---|
| Grok Voice Transcribe | 1.67 美元 | 约 100.20 美元 |
| MAI-Transcribe-2 | 1.67 美元 | 约 100.20 美元 |
| Fun-Realtime-ASR-preview | 2.82 美元 | 约 169.20 美元 |
| Scribe v2 | 3.67 美元 | 约 220.20 美元 |
| Voxtral Small Transcribe 3 | 4.00 美元 | 约 240.00 美元 |
| GPT Transcribe | 4.50 美元 | 约 270.00 美元 |
| Whisper turbo(Groq 托管) | 0.67 美元 | 约 40.20 美元 |
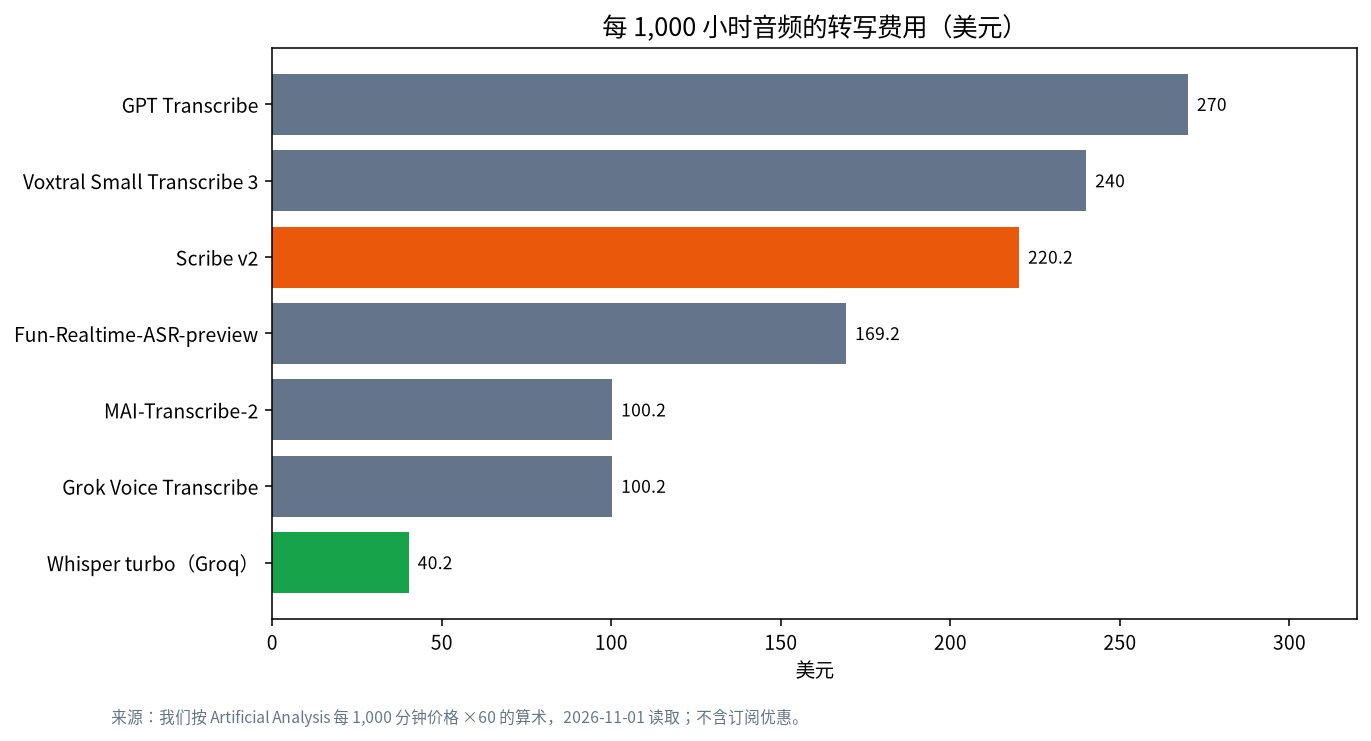
如果你每月只转写几十小时的会议,不管哪家,费用都是几美元,选准确率和功能最合适的;如果你每月有几千小时的客服录音,价格差就会成为可观的预算,这时按功能分层:普通录音用便宜或本地模型,需要说话人分离或专有名词提示的重要录音再用 Scribe v2。
本地能用什么
| 模型 | AA-WER(榜单) | 规模与硬件 | 许可证与说明 |
|---|---|---|---|
| Nemotron 3.5 Transcribe | 2.8% | 34B 总参数、约 4.3B 激活;BF16、FP8、NVFP4 三种精度;官方部署参考为一块 80GB H100;NVFP4 版本列出支持 RTX 5090 与 DGX Spark | OpenMDW-1.1;40 种语言;离线模型,不是实时流式服务;录音最长约 1 小时 |
| Voxtral Small(Mistral) | 2.8% | 约 24B | 本文参照 Hugging Face 与榜单,开放版与 API 版 “Voxtral Small Transcribe 3” 是否为同一模型我们没有核实 |
| Whisper Large v3 | 4.1%(fal 托管) | 我们没有在本次研究中读取其硬件数据 | 开放权重 |
| Parakeet TDT 0.6B V3 | 4.5% | 0.6B 参数,榜单速度系数约 638 倍 | 速度最快的一档 |
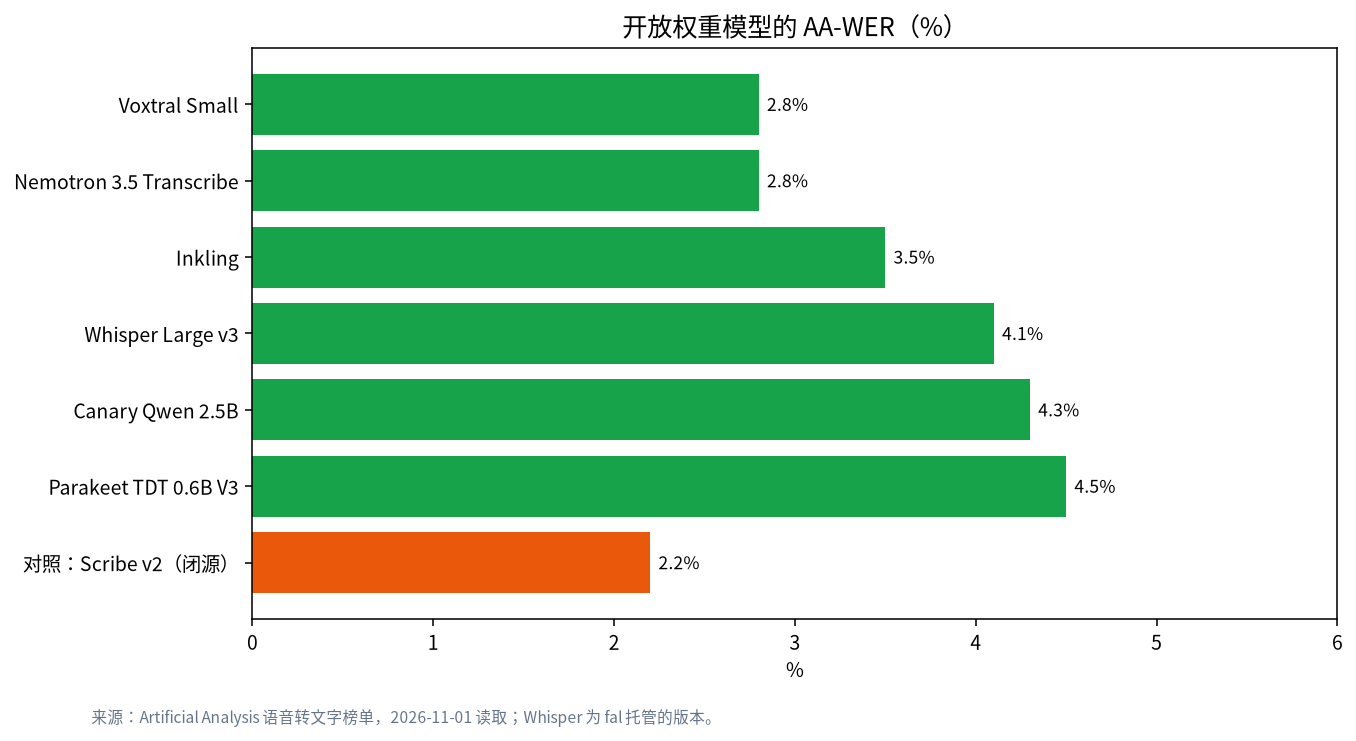
Nemotron 3.5 Transcribe 的模型卡数据(英伟达自测):在 9 个英语公开数据集的 Open ASR 榜单上平均词错误率为 4.71%,这是与 AA-WER 不同的评测,二者不要混用;长音频平均 10.98%;多语种平均 4.62%。它的语言表里,普通话被列为”Supported”(最低一档,可能需要微调),而英语、德语、法语、西班牙语、日语等被列为更高档,普通话在 FLEURS 上的字错误率为 8.62%。所以中文读者应该先在自己的录音上测试,不要直接采用。官方还说明,在英伟达的 NIM 里,一块 RTX PRO 6000 Blackwell 服务器版显卡可达每秒转写 2,238 秒音频(NVFP4 配合推测解码),但这些优化尚未进入开源版本,开源版的 vLLM 集成大约慢一倍。想了解硬件,请读 RTX 5090、4090、3090 对比与 RTX PRO 6000 工作站,部署参考 vLLM 与 SGLang 入门。涉及隐私的录音,本地转写的价值见本地 AI 与隐私。
AA-WER 到底在测什么
AA-WER v2 由三个数据集按权重合成:AgentTalk 占 50%,VoxPopuli-Cleaned 与 Earnings22-Cleaned 各占 25%。前者偏向与语音智能体对话相关的口语,后两者分别是议会发言和财报电话会。”Cleaned”表示对参考文本做过清洗,使错误率更反映识别本身而不是标注差异。这个组合很适合评估英语的客服与财经场景,却不能代表带口音、带背景噪声或中英混说的真实录音,也没有覆盖中文。所以当两个模型只差 0.1 到 0.3 个百分点时,不要把名次当成事实,要在你自己的音频上比较。关于怎样读这类榜单,可参考怎么读模型评测榜单。
实时与离线:选对形态比选对模型重要
语音识别有两种形态。实时(流式)识别边说边出字,适合语音助手与直播字幕,Scribe v2 Realtime 的提交转写中位延迟约 150 毫秒;离线(批量)识别等整段录音结束再处理,适合会议纪要、访谈和客服质检,准确率通常更高,也更容易做说话人分离和长音频处理。Nemotron 3.5 Transcribe 是明确的离线模型,录音最长约 1 小时;如果你的场景需要边说边出字,它不是合适的选择,应当找专门的流式模型。很多团队的实际做法是:实时场景用流式模型保证响应,结束后再用离线模型重新转写一遍,得到更准确的存档文本。
按场景选择
| 场景 | 建议 | 理由 |
|---|---|---|
| 英语财经电话会,要说话人与专有名词 | Scribe v2 | 说话人最多 32 位,关键词提示最多 1,000 个词 |
| 预算敏感的大批量英语转写 | MAI-Transcribe-2 或 Grok Voice Transcribe | 榜单价格约 1.67 美元每 1,000 分钟 |
| 追求榜单最低错误率的英语场景 | Fun-Realtime-ASR-preview | AA-WER 1.7%,但为预览版 |
| 数据不能出本机 | Nemotron 3.5 Transcribe 或 Voxtral Small | 开放权重,榜单 2.8% |
| 需要最快速度的批处理 | Parakeet TDT 0.6B V3 | 榜单速度系数约 638 倍,但错误率 4.5% |
| 中文为主 | 先在自己的录音上测试各家 | 榜单不测中文,Nemotron 的普通话档位为 Supported |
转写之后:接上本地大模型
语音识别通常只是流水线的第一步。转写文本可以交给本地大模型做摘要、提取待办事项或翻译,这时 ASR 与 LLM 都在本机,音频和文本都不出门。具体做法是用 本地模型 API 服务器的方式启动一个兼容 OpenAI 接口的服务,把转写稿分段送入。要注意长录音的转写稿很长,需要按话题或时间分段,再合并摘要,避免超出上下文。与云端相比,这条本地流水线的成本主要是显卡与电费,选择云端还是本地的一般框架请读本地部署与云端 API 怎么选。
自己复现:语音识别测试方法
我们没有跑过这些模型,下面是你可以直接执行的流程。
- 收集 3 小时你自己的真实录音:含安静单人、会议多人、电话噪声、中英混说各约 45 分钟。
- 人工校对一份标准文本:这是计算词错误率的前提;中文用字错误率。
- 统一规范化:去掉标点与大小写差异,数字写法统一,再计算错误率。
- 分场景计错:专有名词、数字、人名单独统计。
- 测说话人分离:对多人录音,统计说话人切换的错误比例。
- 测速度与成本:云端记录等待时间与账单;本地记录每小时音频的处理时间、显存与电费。
- 测稳定性:用 1 小时以上的长录音,检查是否出现重复、截断或幻觉文字。
常见错误
- 把”官方说最先进”当成”榜单第一”:AA-WER 上 Scribe v2 是第 4。
- 拿英语榜单推断中文效果:AA-WER 以英语为主,Nemotron 的普通话档位也只是”Supported”。
- 混用不同榜单的数字:Nemotron 的 4.71% 与 AA-WER 的 2.8% 不是一个评测。
- 只看词错误率:说话人分离、关键词提示往往更影响业务。
- 忽略营销页与文档的差异:功能数字请以文档为准。
相关阅读
常见问题:Scribe v2
Scribe v2 是最好的语音识别模型吗?
在 AA-WER v2 上它的词错误率是 2.2%,排第 4,前面有 Fun-Realtime-ASR-preview(1.7%)、MAI-Transcribe-2(2.0%)和 Voxtral Small Transcribe 3(2.1%)。
Scribe v2 多少钱?
榜单列出约 3.67 美元每 1,000 分钟,折合每 1,000 小时约 220 美元。具体计费以 ElevenLabs 为准。
Scribe v2 支持多少种语言?
官方文档写 90 多种语言,官网营销页写 99 种;两处不一致,请以文档为准。
有能本地运行的语音识别吗?
有。Nemotron 3.5 Transcribe 与 Voxtral Small 在榜单上都是 2.8%;Whisper Large v3 与 Parakeet 更老但更容易部署。
中文识别用哪个?
AA-WER 以英语为主,并不度量中文。Nemotron 把普通话列为最低一档的”Supported”,请先用自己的录音测试。
Nemotron 3.5 Transcribe 能实时用吗?
不能,官方说明它是离线模型,内部分块不等于流式服务。
和我们聊聊
在做本地语音转写?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:Artificial Analysis 语音转文字榜单、ElevenLabs 官方文档:模型、Hugging Face:NVIDIA Nemotron 3.5 Transcribe。