笔记本跑本地大模型怎么选:显存、带宽、散热与 Mac 对比(2026)
很多人想用一台笔记本同时解决办公、出差和本地大模型,这是可行的,但选型的逻辑和台式机很不一样。笔记本跑本地大模型 的关键不是 CPU,也不是宣传里的”AI 算力”,而是 GPU 的显存容量、显存带宽和持续功耗:显存焊死在显卡上,买了就不能升级;功耗和散热又决定了它能不能长时间保持速度。这篇文章按 NVIDIA 官方的 50 系列笔记本规格,加上 Mac 的统一内存路线,讲清楚不同档位能跑什么、该怎么避坑。显存的基础知识见《显存与本地大模型:怎么选 GPU》。
核对说明:笔记本 GPU 的显存、带宽和功耗范围来自 NVIDIA 笔记本 50 系列页面及其规格转载;模型体积中 8B 的 Q4_K_M 取自 llama.cpp 官方 quantize 文档(约 4.9GB),其余按每十亿参数约 0.61–0.62GB 外推,仅为估算。我们没有逐款笔记本做实测,速度上限是由带宽算出的理论值。我们的参考价格表没有核实的笔记本整机价格,所以本文不给笔记本价格,只在最后用台式参考配置作对照。
要点速览(更新于 2026-10-30)
- 笔记本的显存是固定的:RTX 5090 笔记本 24GB、5080 笔记本 16GB、5070 Ti 笔记本 12GB,5070 与 5060 笔记本多为 8GB(5070 另有 12GB 版本,买前要查具体型号)。
笔记本 GPU 的带宽比同名台式机低,且功耗上限只有 45–150W 左右,持续性能受散热限制。
想要更大容量,可以考虑 Mac 的统一内存路线;想要最高性价比,台式机仍然更划算。
笔记本跑本地大模型:显存才是硬指标
按 NVIDIA 官方页面,RTX 50 系列笔记本 GPU 的规格如下。注意这里的”显存”是显卡自带的 GDDR7,而不是你在商品页看到的 16GB 或 32GB 系统内存。
| 笔记本 GPU | 显存 | 显存带宽 | GPU 功耗范围(NVIDIA 标注) |
|---|---|---|---|
| RTX 5090 Laptop | 24GB GDDR7 | 896 GB/s | 95–150W |
| RTX 5080 Laptop | 16GB GDDR7 | 896 GB/s | 80–150W |
| RTX 5070 Ti Laptop | 12GB GDDR7 | 672 GB/s | 60–115W |
| RTX 5070 Laptop | 8GB 或 12GB(依型号) | 384 GB/s | 50–100W |
| RTX 5060 Laptop | 8GB GDDR7 | 384 GB/s | 45–100W |
这里有一个必须小心的地方:RTX 5070 笔记本在 NVIDIA 美国页面上同时出现 8GB 和 12GB 两种配置,而其他地区页面仍显示 8GB。所以”5070 笔记本有多少显存”没有统一答案,下单前一定要看具体机型的完整规格表,而不是只看 GPU 名称。
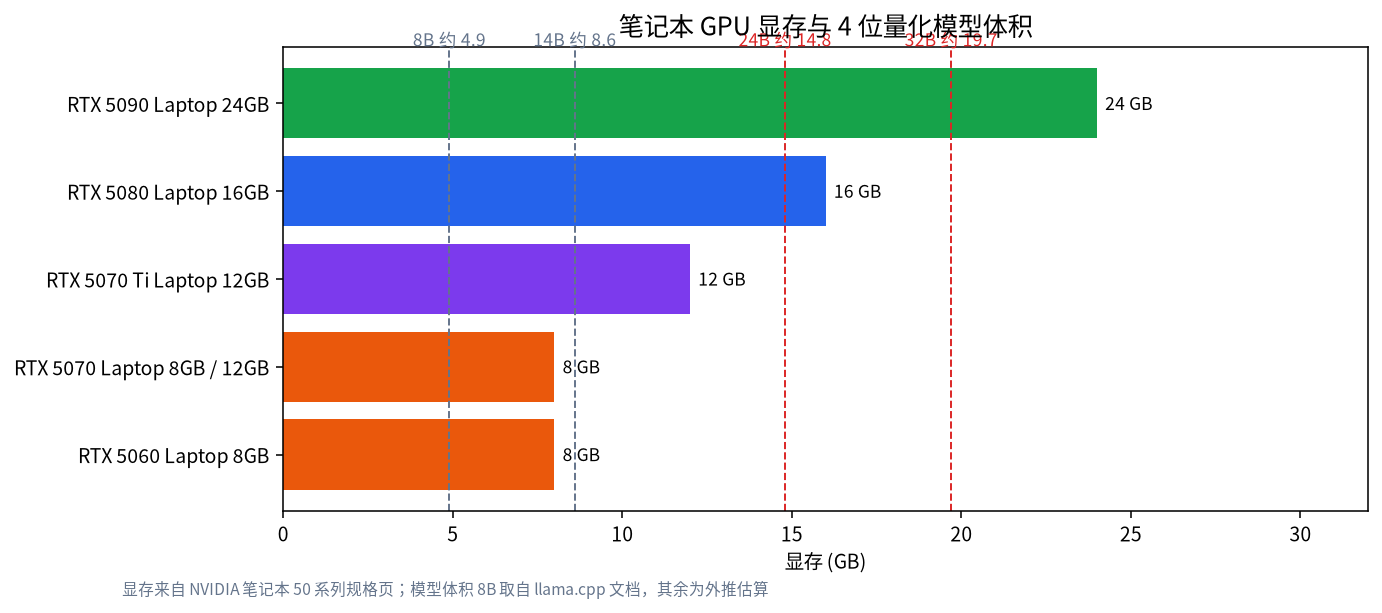
把图和模型体积放在一起看就很清楚:8GB 的笔记本适合 7B、8B 这一档,具体见《8GB 显存能跑什么大模型》;12GB 与 16GB 适合 14B 到 24B,见《12GB 与 16GB 显存跑大模型》;只有 24GB 的 5090 笔记本才有机会放下 32B 级的 4 位量化模型,见《24GB 显存跑大模型》。每一档还要给上下文缓存留出余量,估算方法见《大模型显存需求怎么算》。
带宽与功耗:笔记本为什么比台式机慢
生成速度的理论上限约等于显存带宽除以模型体积。以约 8.6GB 的 14B 模型为例,896 GB/s 的 5090 / 5080 笔记本上限约 104 tok/s,672 GB/s 的 5070 Ti 笔记本约 78,384 GB/s 的 5070 / 5060 笔记本约 45。这些是理论值,不是实测速度;笔记本因为功耗和散热限制,实际会更低。
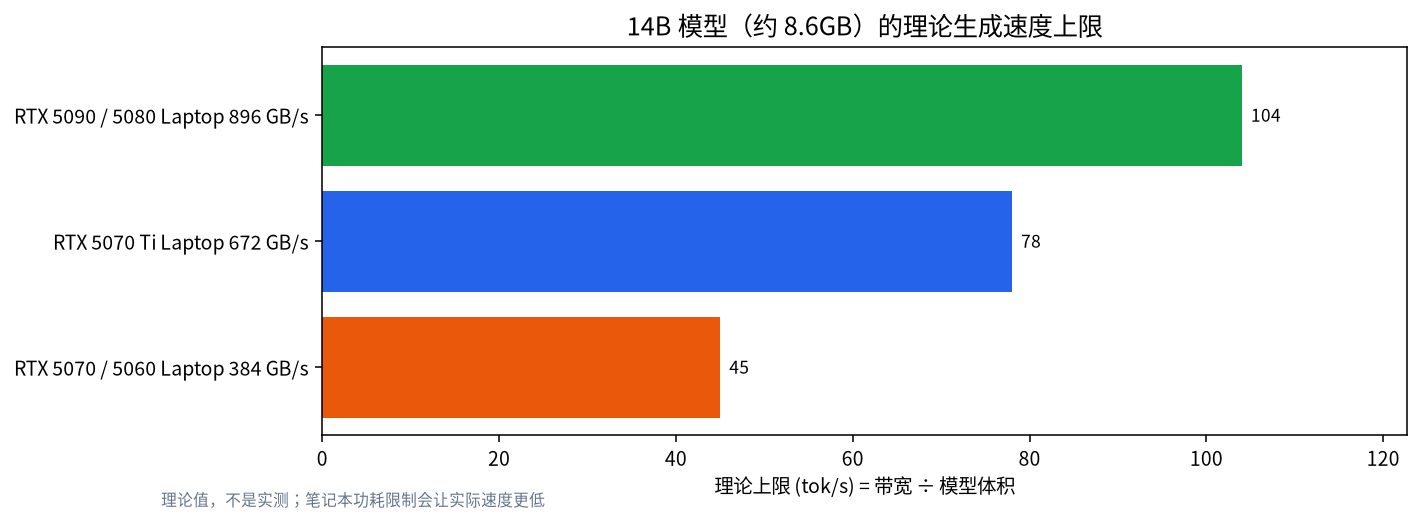
功耗是另一个差别。笔记本 GPU 的功耗范围是 NVIDIA 给出的允许区间,不同厂商、不同机型会设置不同的功耗墙。同样叫”5080 笔记本”,薄款机型和厚款机型的持续性能可能相差很大。所以比较的时候,不要只看 GPU 型号,要看这台机器给了 GPU 多少瓦、散热模组有多大、长时间满载时风扇噪音是否能接受。
Windows 笔记本、Mac 与台式机的取舍
| 方案 | 优势 | 劣势 | 适合谁 |
|---|---|---|---|
| NVIDIA 游戏本或创作本 | 软件生态最好,能跑 CUDA 工具;便携 | 显存固定且较小;功耗与散热受限;价格高 | 经常出差,又要在本机跑模型的人 |
| Mac(统一内存) | 内存容量可以很大,静音省电;见《Mac 跑本地大模型》 | 带宽低于高端独显;部分工具以 CUDA 为主 | 想要装下大模型、重视静音和续航的人 |
| 台式机加独显 | 同价位显存更大、带宽更高、可升级 | 不能随身带 | 主要在固定地点使用的人 |
| 笔记本加远程台式机 | 笔记本只作为终端,模型跑在家里或公司的机器上 | 需要稳定的网络和一台常开的机器 | 已经有台式机或小主机的人 |
作为台式机的价格参考:我们在 2026-10-30 整理的参考配置里,入门 12GB 档约 7899 元,主流 16GB 档约 10853 元(均为参考价,不同地区和时间会变)。把这个价格和你看中的笔记本对比,常常会发现:同样的预算在台式机上能买到更大的显存。
选购与验收清单
- 先定模型,再定显存:想跑 7B 到 8B 选 8GB,14B 到 24B 选 12GB 到 16GB,32B 以上考虑 24GB 或 Mac。
- 核对具体型号:同一个 GPU 名称下的显存和功耗墙可能不同,一定要看机型的完整规格。
- 看散热与功耗墙:长时间推理会让 GPU 持续满载,薄本更容易降频。
- 留好内存:系统内存建议不少于 32GB,因为模型放不下时部分层会落到内存里,速度会明显下降。
- 到手先验货:用
nvidia-smi确认显存容量,跑一个 8B 模型并查看功耗和温度,再决定是否留下,保留好退换货期限。
按使用场景来选
如果你主要是写作、翻译和日常问答,8GB 显存加一个量化好的 7B 或 8B 模型就够用了,把省下的预算花在更好的屏幕、续航和散热上更实际。如果你要做代码辅助或者长文档总结,建议至少 12GB 到 16GB,因为这类任务的上下文更长,缓存会占掉不少显存。如果你要同时开多个应用,比如浏览器、编辑器和模型服务,就要把系统内存也算进去,32GB 是比较舒服的起点。
至于想在笔记本上跑 32B 以上的模型,现实的做法只有两条:选 24GB 的旗舰笔记本,或者选大内存的 Mac。这两条路都要花不少预算,所以更值得先问自己:这个模型带来的质量提升,对你的任务是否真的必要。很多时候,换一个量化更合适的 14B 模型,就能解决大部分需求。
让笔记本稳定运行的几个习惯
长时间推理时,建议插电并使用厂商提供的高性能模式,把笔记本垫高或放在散热支架上,避免进风口被堵住。运行前关闭不用的程序,把显存留给模型。观察一段时间的温度和功耗,如果持续降频,可以适当缩短上下文或换小一档的模型,而不是一味追求更大的参数量。这些习惯不需要额外花钱,却能明显改善体验。
常见误区
- 把系统内存当显存:笔记本商品页写的 32GB 通常是系统内存,显存是另一回事。
- 只看 GPU 名称:同名 GPU 的显存、功耗在不同机型上可能不同。
- 用电池跑大模型:多数笔记本在不插电时会限制 GPU 功耗,速度会明显下降,建议插电使用。
- 期待 NPU 解决一切:宣传中的”AI 算力”不等于能跑大模型,容量和带宽才是关键,见后续对 AI PC 的讲解。
- 买了才发现装不下:先用估算方法算清楚,再下单。
如果预算有限怎么办
如果你的预算只够 8GB 显存的笔记本,也不必放弃:选好量化版本的 7B 或 8B 模型,已经足够处理日常的写作、总结和简单问答。想用更大的模型时,可以把笔记本当作终端,让模型跑在另一台机器上,或者在需要时临时使用云端接口。选哪种方式,可以参考《本地部署还是云端接口》。重要的是先明确自己的使用场景,再决定把预算花在笔记本,还是更划算的台式主机上。
常见问题
笔记本能跑本地大模型吗?
能。只要显存放得下模型,并且插电使用,笔记本可以流畅运行 7B 到 24B 级别的量化模型,具体取决于显存。
买笔记本跑大模型,显存多少够用?
只想用 7B、8B 选 8GB;14B 到 24B 选 12GB 到 16GB;想跑 32B 级模型要 24GB。上下文越长,需要的余量越大。
RTX 5070 笔记本是 8GB 还是 12GB?
两种都存在,不同地区的官方页面不一致,所以要看具体机型的规格表。
笔记本和 Mac 哪个更适合跑大模型?
看需求:NVIDIA 笔记本带宽高、生态好但显存小;Mac 的统一内存容量大、安静省电,但带宽较低。
笔记本散热会影响大模型速度吗?
会。笔记本 GPU 的功耗上限较低,长时间满载时可能降频,因此持续速度往往低于理论上限。
能把笔记本当作终端,模型放别处吗?
可以。把模型跑在家里的主机上,笔记本通过网络访问,是预算友好的做法。
需要帮你选型
如果你拿不准某款笔记本能不能满足需求,欢迎到社区告诉我们你的预算和想跑的模型,也可以发邮件到 admin@microaione.com。系统化的配置对比见《本地大模型电脑配置推荐》。