RTX PRO 6000 工作站装机指南:96GB 显存跑本地大模型值得吗
大多数本地 AI 的建议止步于 24GB 或 32GB 显存。英伟达 RTX PRO 6000 Blackwell Workstation Edition 把单卡显存做到了 96GB,远在这条线之上,让你不必把模型拆到多张卡上。同时它的价格是游戏旗舰卡的好几倍。这篇 RTX PRO 6000 工作站装机指南会讲清楚这张卡是什么、96GB 能让你运行什么、按我们的参考价整机要多少钱、它的速度和替代方案在纸面上怎么比,以及什么时候更便宜的路线才是更聪明的购买。如果你还在几张消费级显卡之间犹豫,请先读RTX 5090、4090、3090 的对比。
核对说明:显卡规格来自英伟达 RTX PRO 6000 Blackwell Workstation Edition 页面,于 2026-10-30 阅读。价格来自我们同一天的参考文件。PRO 6000 的价格来自单一市场来源,置信度较低,我们给出的整机价格是估算而不是报价。速度由显存带宽推算,不是实测,我们没有测试过这张卡。
要点速览(更新于 2026-10-30)
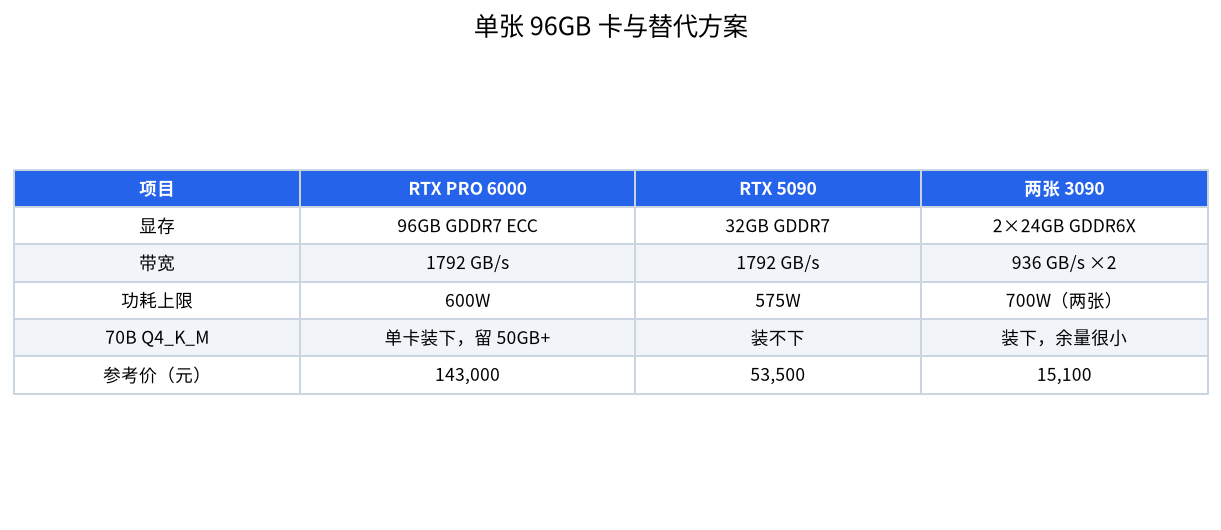
- 英伟达标注它为 96GB 带 ECC 的 GDDR7、1792 GB/s 带宽、最大功耗 600W 的双槽显卡。
按约 143,000 元的参考价,整机约 155,000 元,是 5090 工作站的两倍多,约为两张 3090 整机的七倍。
它是用一张卡运行 70B 模型加长上下文最简单的办法;对许多用户来说,两张二手 3090 或大内存迷你主机能用少得多的钱获得同样的容量,只是速度更低。
RTX PRO 6000 Workstation Edition 是什么
这张卡属于英伟达的专业产品线。根据英伟达页面,它配备 96GB 带纠错码的 GDDR7 显存,显存带宽 1792 GB/s,最大功耗 600W,外形为 5.4 英寸乘 12.0 英寸的双槽。带宽与 RTX 5090 相同,这意味着对两者都装得下的模型,生成速度的上限大致一样。区别在于容量:是 5090 的三倍。另外还有 Max-Q 版本;英伟达页面提到,多实例 GPU 功能可以把 Max-Q 卡划分为最多四个相互隔离的实例,我们的价格文件列出同一单一来源的 Max-Q 价格为 119,000 元。
它不是普通的游戏卡。它通过工作站渠道和合作伙伴销售,支持 ECC 显存以提高可靠性,价格同时反映了显存和市场。如果你想让它在普通台式机里工作,请在下单之前检查机箱、电源和散热,供电与散热指南里有说明。
96GB 能让你运行什么
显存容量是购买它的主要原因。按 Q4_K_M 约每十亿参数 0.61GB 计算,70B 模型约占 43.1GB。这样还剩下 50GB 以上用于缓存和运行时,而 Llama 3.1 70B 的 f16 缓存每个 token 约 320 KiB,所以 32K 上下文约需 10 GiB。模型可以带着很长的上下文装下,甚至还能再放一个较小的模型,比如检索用的嵌入模型。
Q8_0 文件每个权重约 8.5 比特,所以 70B 模型大约需要 74GB,也能装下,还剩约 20GB。也就是说,你可以选择更高质量的量化而不必卸载到系统内存。像 gpt-oss-120b 这样的 MoE 模型,Ollama 标注为 65GB,可以完整放进显存并留出上下文空间。在我们的 MoE 指南里,这类模型运行得很快,因为每个 token 只激活几十亿参数。在 32GB 的卡上,这些配置没有一个能不卸载就装下。卸载在速度上的代价见卸载指南。
推算的速度上限
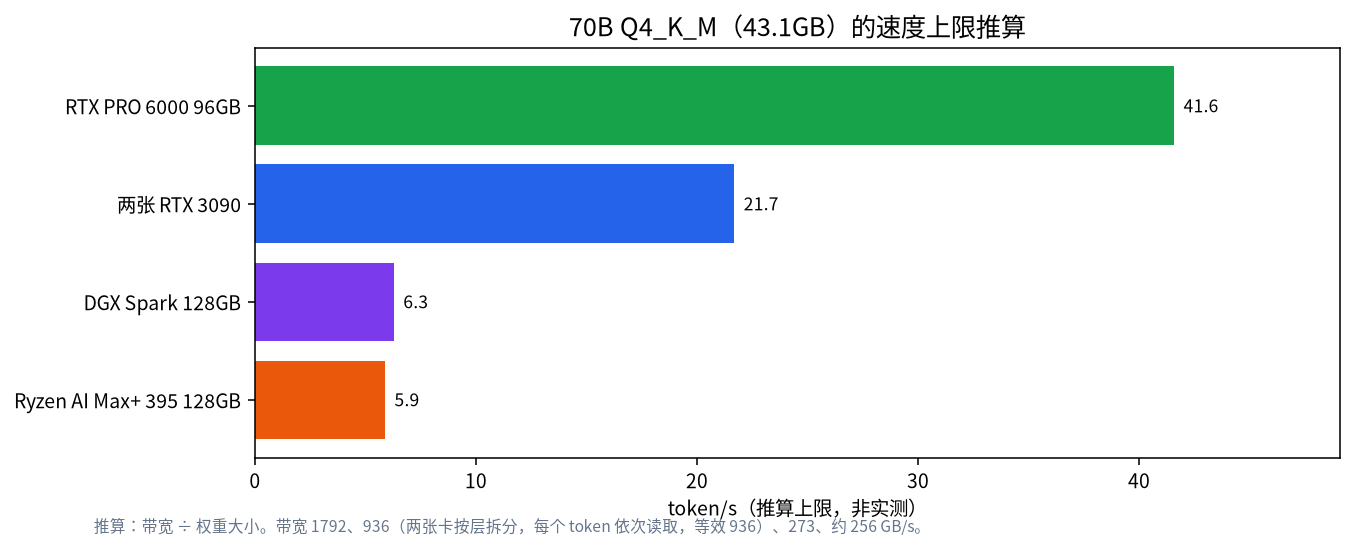
单卡的速度遵循一贯的规则:带宽除以每个 token 读取的字节数。对于 43.1GB 的 70B Q4_K_M 模型,PRO 6000 的 1792 GB/s 给出约每秒 41.6 个 token 的上限。两张 RTX 3090 按层拆分时依次读取权重,所以有效上限大约等于一张卡,936 除以 43.1,约为 21.7。英伟达 DGX Spark 的 273 GB/s 约为 6.3,Ryzen AI Max+ 395 迷你主机约 256 GB/s,约为 5.9。这些是推算的上限,不是实测,但比例解释了为什么有人愿意为一张又大又快的卡付钱:对同一个 70B 模型,速度大约是两张 3090 的两倍,是大内存迷你主机的约七倍。
整机要多少钱
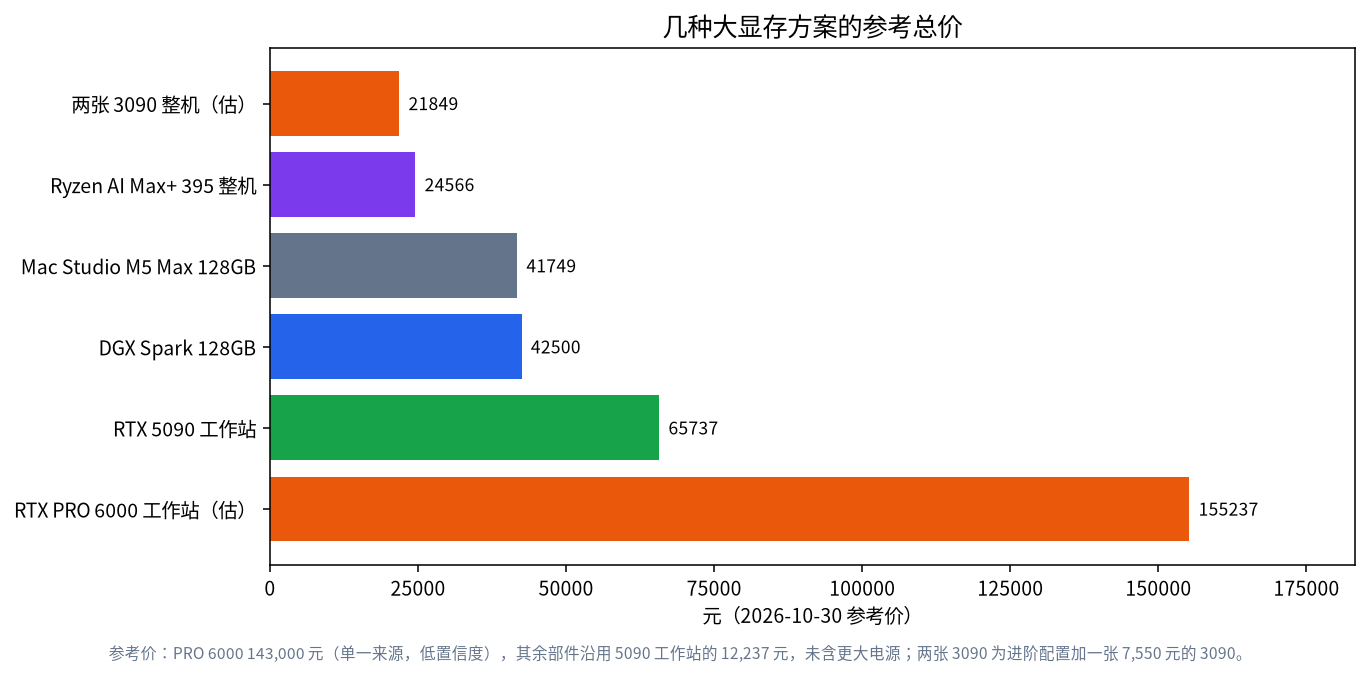
| 方案 | 内存 | 参考总价(元) | 备注 |
|---|---|---|---|
| 两张 3090 整机(估算) | 48GB | 21,849 | 进阶配置再加一张 7,550 元的二手卡;可能需要更大的电源 |
| Ryzen AI Max+ 395 迷你主机 | 128GB 统一内存 | 24,566 | 带宽低,安静小巧 |
| Mac Studio M5 Max 128GB | 128GB 统一内存 | 41,749 | 官方价格,来自我们的参考文件 |
| DGX Spark | 128GB 统一内存 | 42,500 | 带宽 273 GB/s |
| RTX 5090 工作站 | 32GB | 65,737 | 来自我们的参考配置 |
| RTX PRO 6000 工作站(估算) | 96GB | 约 155,237 | 显卡 143,000 加上 5090 配置的其他部件 12,237 |
PRO 6000 的总价是显卡 143,000 元,加上我们 5090 工作站其他部件的 12,237 元,没有计入可能需要的更大电源,也没有计入服务器级机箱,请把它看作下限。我们的参考文件列出企业一体机 70B 档为 319,800 元,所以自己组装的 PRO 6000 整机比它便宜,但没有厂商支持,也没有安装服务。
什么时候合适
| 情况 | PRO 6000 合适吗 | 更便宜的替代 |
|---|---|---|
| 需要 70B 加长上下文,并让几个人快速得到回复 | 合适 | 两张 3090,速度更慢 |
| 团队全天运行一个大模型,在意功耗和噪音 | 合适,单卡 | 多卡增加发热和复杂度 |
| 个人使用,偶尔用 70B | 不合适 | 大内存迷你主机 |
| 主要用 8B 到 32B 的模型 | 不合适 | 一张 24GB 或 32GB 的卡 |
| 在本地训练或微调大模型 | 可能 | 短期任务租用云端 GPU |
| 需要厂商支持和保修 | 先看渠道 | 企业一体机 |
为团队做容量计算
支持 96GB 的最有力理由是并发。每个活跃的对话都需要自己的 KV 缓存,对 Llama 3.1 70B 来说,f16 下约为每个 token 320 KiB。如果八个人各有一个 8K token 的对话,缓存需要 8 × 8,192 × 320 KiB,约 20 GiB。43.1GB 的 70B Q4_K_M 模型加上 20 GiB 缓存约 64GB,远在 96GB 之内,还留有应对峰值的空间。在 48GB 的双卡配置上,同样的负载需要约 64GB,装不下,你就得缩短上下文或减少用户。这是推算的估计,实际数字取决于推理引擎,它预留内存的方式可能不同,但它说明了对共享服务器而言,容量比纯速度更重要。我们的 vLLM 指南解释了引擎如何管理这部分内存。
速度也是共享的。以每秒 41.6 个 token 作为单路上限,几个用户同时生成会瓜分带宽,不过批处理使总吞吐量高于任何单路。如果团队的问题短而零散,一张卡绰绰有余;如果大家整天跑长任务,就要规划排队。
RTX PRO 6000 工作站其余部件怎么选
显卡承担大部分工作,所以其余部分可以普通,但必须扎实。选择电源时,要在 600W 的显卡功耗之上留出充裕余量,因为英伟达给出的是显卡的最大功耗,而 CPU、硬盘和风扇还要额外耗电。下单前请查看英伟达的数据表和你电源的接口。选择风道真正前进后出、能放下 12 英寸显卡的机箱,以及有全长 PCIe 插槽、不会被显卡挡住的主板。模型放在显卡上时,系统内存的重要性低于显存,但 64GB 能给操作系统和工具留出空间。使用高速 NVMe 硬盘,因为 70B 的模型文件很大,加载时间很重要。我们的整机配置指南列出了其他档次的参考配置。
对团队来说,通过能同时处理多个用户的推理引擎来提供这张卡的服务;小团队指南介绍了这一点,如果你需要审批流程、日志和支持,企业私有部署指南也有说明。
运维一张工作站显卡
这个价位的显卡值得监控。用英伟达驱动工具观察温度、功耗和显存使用,并为持续的高温设置告警。保持驱动和推理引擎更新,但先在配置的副本上测试升级,因为新驱动可能改变行为。ECC 显存有助于检测并纠正部分内存错误,对要连续运行几个月的服务器很有用,但它不能代替数据和配置的备份。把机器放在温度和灰尘受控的房间里,并定期清理滤网。最后,记下能正常工作的驱动、引擎和模型文件的确切版本,这样故障之后你可以重建环境。
承诺之前先测试
花 143,000 元之前,先确认你真的需要 96GB。在租用或借来的大内存机器上,或者在带卸载的更便宜方案上,用你的真实负载跑几天,并记录你实际用到的模型大小、上下文长度和用户数。如果这些数字从未超过 48GB,两张二手 3090 或一张较小的卡就够用。如果你经常需要让几个人用长上下文的 70B,PRO 6000 会让一切变简单。一体机选购指南可以作为厂商支持路线的对照。也算一算等待的成本:如果一台更便宜的机器回答稍慢一点,却能省下十万元,多等的那几秒对你的团队来说可能很划算。
常见错误
- 把单一价格当成市场报价。 我们的数字来自一个来源,请向多个卖家索取实时报价。
- 低估功耗和风道。 600W 的显卡需要强力的电源和能走风的机箱。
- 为能装进 24GB 的模型买 96GB。 用不上的容量就是浪费钱。
- 忽略保修和渠道。 从授权合作伙伴处购买,并保留发票。
- 指望比 5090 有速度飞跃。 带宽相同,提升的是容量。
常见问题
RTX PRO 6000 有多少显存?
英伟达标注 Workstation Edition 为 96GB 带 ECC 的 GDDR7。
跑大模型它比 RTX 5090 快吗?
对两者都装得下的模型,生成上限相近,因为两者标注的带宽都是 1792 GB/s。当模型装不进 32GB 时,PRO 6000 才占优势。
它能跑 Q8 的 70B 模型吗?
按我们的计算,Q8_0 的 70B 模型约 74GB,能放进 96GB,并留出中等长度的上下文。
用两张 3090 更便宜吗?
按参考价是的,便宜很多,但你只有 48GB,纸面上 70B 模型的速度约为一半,而且发热和复杂度更高。
它需要特殊的电源吗?
英伟达标注最大显卡功耗为 600W。请选择余量充裕的电源,并查看数据表中的接口要求。
应该买 Max-Q 版本吗?
根据英伟达的介绍,它存在,并且可以划分为隔离的实例。决定之前,请对比它的价格、功耗和对你负载的性能。
和我们聊聊
在为团队规划大显存机器?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:英伟达 RTX PRO 6000 Blackwell Workstation Edition、英伟达 RTX PRO 6000 Blackwell 系列、Ollama gpt-oss 页面。