Strata vs Ollama: llama.cpp, LM Studio, vLLM과의 차이와 선택 가이드
업데이트 2026-11-04. 공개된 문서, 릴리스 노트, 제3자 보고서를 바탕으로 했습니다. 저희가 직접 벤치마크를 돌리지는 않았습니다.
Strata vs Ollama는 이번 달 가장 많이 나오는 비교이지만, 같은 일을 하는 두 도구의 공정한 대결은 아닙니다. Strata는 작은 그래픽카드가 달린 PC에서 아주 큰 MoE(전문가 혼합) 모델 한 부류를 돌리려고 만든 새 엔진입니다. Ollama는 성숙한 범용 모델 관리 도구입니다. llama.cpp, LM Studio, vLLM은 같은 지도의 다른 구석에 있습니다. 이 글은 다섯 도구를 나란히 놓고 각각의 용도를 보여 주고, Qwen3.8-Flash-Next 지원에 대해 저희가 확인할 수 있었던 내용을 정리한 뒤, 선택 가이드로 마무리합니다. ‘Strata’라는 이름만 들어 보셨다면 먼저 Strata란 무엇인가 설명 글을 읽어 보세요.
Strata vs Ollama: 결론부터
- Strata: 12~24 GB GPU와 RAM 48~64 GB를 갖춘 PC에서 아주 큰 MoE 모델, 주로 Qwen3.8-Flash-Next를 돌리고 싶을 때 고릅니다.
- Ollama: 여러 소형·중형 모델을 가장 쉽게 돌리고 앱에 연결하고 싶을 때 고릅니다.
- llama.cpp: GGUF 모델과 하드웨어를 최대한 세밀하게 제어하고 싶거나, 쓰는 도구가 그것을 바탕으로 만들어졌을 때 고릅니다.
- LM Studio: 화면에서 모델을 찾고, 내려받고, 대화하고 싶을 때 고릅니다.
- vLLM: 모델 전체가 들어갈 만큼 메모리가 넉넉한 GPU로 여러 사용자에게 동시에 서비스할 때 고릅니다.
나란히 비교
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| 주된 역할 | GPU, RAM, SSD를 층으로 나눠 거대한 MoE 모델을 작은 VRAM에서 실행 | 명령 하나로 많은 모델을 받고, 실행하고, 제공 | 많은 도구가 바탕으로 쓰는 추론 라이브러리와 서버 | 둘러보기, 내려받기, 대화를 위한 데스크톱 앱 | 높은 처리량의 서빙 엔진 |
| 라이선스 | MIT (엔진) | MIT | MIT | 독립 앱. 약관상 가정과 업무에서 무료 | Apache-2.0 |
| GitHub 스타 (2026-11-04) | 39,548 | 185,856 | 133,318 | 오픈소스 저장소 아님 | 96,277 |
| 인터페이스 | 데스크톱 앱과 터미널 | 명령줄, 앱, REST API | 명령줄과 llama-server |
GUI 앱, lms CLI, 헤드리스 모드 |
Python 라이브러리와 서버 |
| API | OpenAI, Anthropic, Responses 형식 | 자체 API와 OpenAI 호환 엔드포인트 | OpenAI 호환 서버 | OpenAI 호환 서버 | OpenAI 호환 서버 |
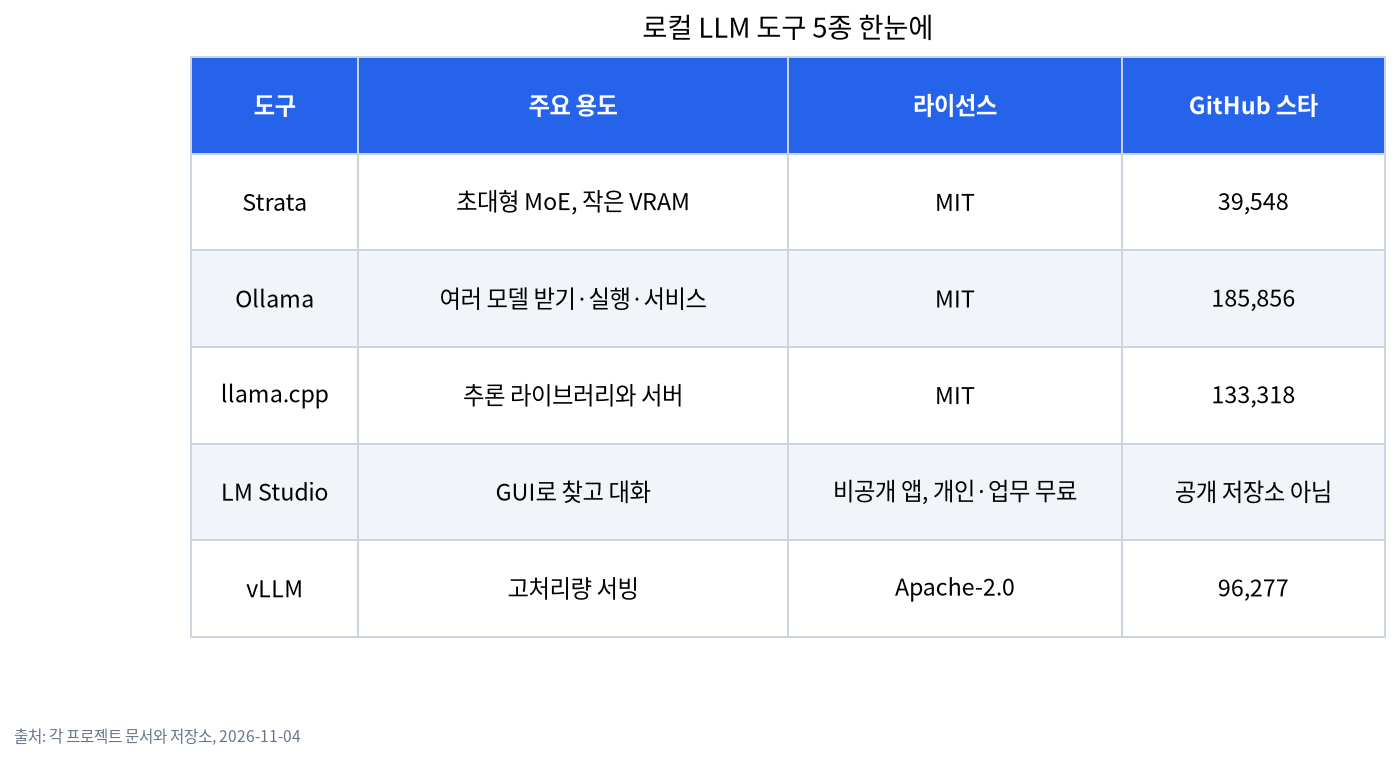
스타는 관심도를 재는 것이지 품질을 재는 것이 아닙니다. Strata 저장소는 6주밖에 되지 않았고, Ollama는 쌓을 시간이 몇 년 있었습니다. 기세는 릴리스 기록이 더 잘 보여 줍니다. Strata는 10월 25일부터 11월 2일 사이에 여섯 번 릴리스했고, Ollama의 v0.40.14는 11월 3일에 나왔습니다.
각각의 강점과 주의할 점
| 도구 | 잘하는 것 | 주의할 것 |
|---|---|---|
| Strata | 12~24 GB 카드에서의 아주 큰 MoE 모델, 원클릭 설치, 코딩 에이전트용 strata connect |
지원 모델이 적음, 어린 프로젝트, 12 GB 카드에서 긴 프롬프트가 느림(PC Watch), 문서상 외부 보안 감사 없음 |
| Ollama | 간편함, 큰 모델 라이브러리, 거대한 생태계, 코딩 도구용 ollama launch, v0.40.0부터 Apple Silicon에서 MLX |
RAM과 SSD에서 125B MoE를 스트리밍하도록 설계되지 않음. 로컬 사용 외에 선택형 클라우드 모델과 유료 플랜이 있음 |
| llama.cpp | 폭넓은 하드웨어 지원, 양자화 형식, 세밀한 제어. 풀 리퀘스트 #27742(2026-08-27 병합)에서 Qwen3.8-Flash-Next 지원 추가 | 배워야 할 플래그가 많고 환경은 직접 구성해야 함 |
| LM Studio | 친근한 GUI, llama.cpp와 MLX 엔진, lms로 헤드리스 실행 가능 |
클로즈드 소스 앱. 제품에 넣는다면 약관을 따라야 함 |
| vLLM | 병렬 요청이 많을 때의 처리량 | 모델 전체가 GPU 메모리에 들어가야 하며 12 GB 카드용이 아님 |
vLLM의 공식 저장소는 github.com/vllm-project/vllm입니다. 가장 흔한 세 도구를 더 자세히 보려면 Ollama·LM Studio·llama.cpp 비교 가이드를, vLLM은 vLLM과 SGLang 입문을 참고하세요.
Qwen3.8-Flash-Next 지원: 저희가 확인한 범위
Strata를 둘러싼 열기의 대부분이 이 모델에서 나왔기 때문에 정확히 적어 둡니다. 아래는 모두 2026-11-04 기준 상태입니다.
- Strata: 이 모델을 위해 만들어졌습니다(모델 목록). 문서에는 양자화 4종이 있고 RAM과 VRAM 합계로 37.6~54.8 GB입니다.
- llama.cpp: 풀 리퀘스트 #27742 “model: add Qwen3.8-Flash-Next (qwen4exp)”가 2026-08-27에 병합되었습니다. Hacker News의 한 사용자는 어떤 AMD 환경에서 llama.cpp가 약 21 토큰/초, Strata가 약 60 토큰/초였다고 보고했습니다. 이는 한 사례일 뿐이며 저희가 보증할 수 있는 테스트가 아닙니다.
- Ollama:
qwen3.8-flash-next의 라이브러리 페이지에는125b-mlx(105 GB, Apple Silicon용) 태그 하나만 있었습니다. 기능 요청 이슈는 2026-10-17에 닫혔습니다. NVIDIA GPU용 태그는 찾지 못했고 테스트도 하지 않았으므로, Ollama가 못 돌린다고 말하는 것이 아니라 문서화된 경로를 찾지 못했다고만 말씀드립니다. - LM Studio와 vLLM: 확인하지 않았습니다.
VRAM보다 큰 모델을 각 도구는 어떻게 다루나
도구마다 진짜 차이가 나는 곳이 여기입니다. 모델이 카드에 들어가지 않을 때 Ollama와 llama.cpp는 보통 층 단위로 나눕니다. 일부 층은 GPU에서, 나머지는 CPU에서 돌리고 가중치는 RAM에 둡니다. 조밀한 모델에는 잘 맞고 작은 카드의 표준적인 방법입니다. MoE 모델은 사정이 다릅니다. 토큰당 쓰는 전문가가 몇 개뿐이기 때문입니다. llama.cpp에는 전문가를 CPU 쪽에 두는 옵션(--cpu-moe 계열 플래그)이 있고, Hacker News의 한 사용자는 RAM 192 GB 머신에서 이 방식으로 Q8_0 파일을 16 토큰/초로 돌렸다고 보고했습니다. Strata는 한 걸음 더 나아가, 자주 쓰는 전문가의 캐시를 GPU에 두고, 나머지는 RAM에 있는 채로 CPU가 계산하며, 그래도 모자라면 SSD에서 스트리밍합니다. 그 결과 한 가지를 잘하는 도구가 되었지만, 지원하는 모델은 몇 개뿐입니다. 반면 vLLM은 모델 전체가 GPU 메모리에 있다고 가정하므로, 12 GB 데스크톱 카드가 아니라 서버에 어울립니다.
속도 주장은 이렇게 읽으세요
‘Strata가 더 빠르다’는 글의 대부분은 서로 다른 모델을 비교합니다. RTX 3060 테스트를 쓴 일본의 한 블로거는 125B 모델에서의 Strata 44.49 토큰/초를 같은 PC에서 Ollama가 9B, 26B 모델을 돌린 결과 옆에 놓고, 이 표는 Strata가 Ollama보다 빠른지 느린지를 보여 주지 않는다고 분명히 적었습니다. arm1.ru의 테스트는 Flash-Next를 돌리는 Strata와 다른 모델인 Qwen3.8-27B를 돌리는 llama.cpp의 비교였습니다. 공정한 비교에는 같은 모델, 양자화, 컨텍스트, 하드웨어, 소프트웨어 버전이 필요한데, 그 기준을 완전히 충족하는 것은 찾지 못했습니다. 그런 비교가 나올 때까지는 속도를 ‘어느 도구가 더 빠른가’가 아니라 ‘이 도구가 이 모델에서 낸 값’으로 읽으세요. 출처는 note.com 테스트, arm1.ru, Hacker News 글입니다.
선택 가이드
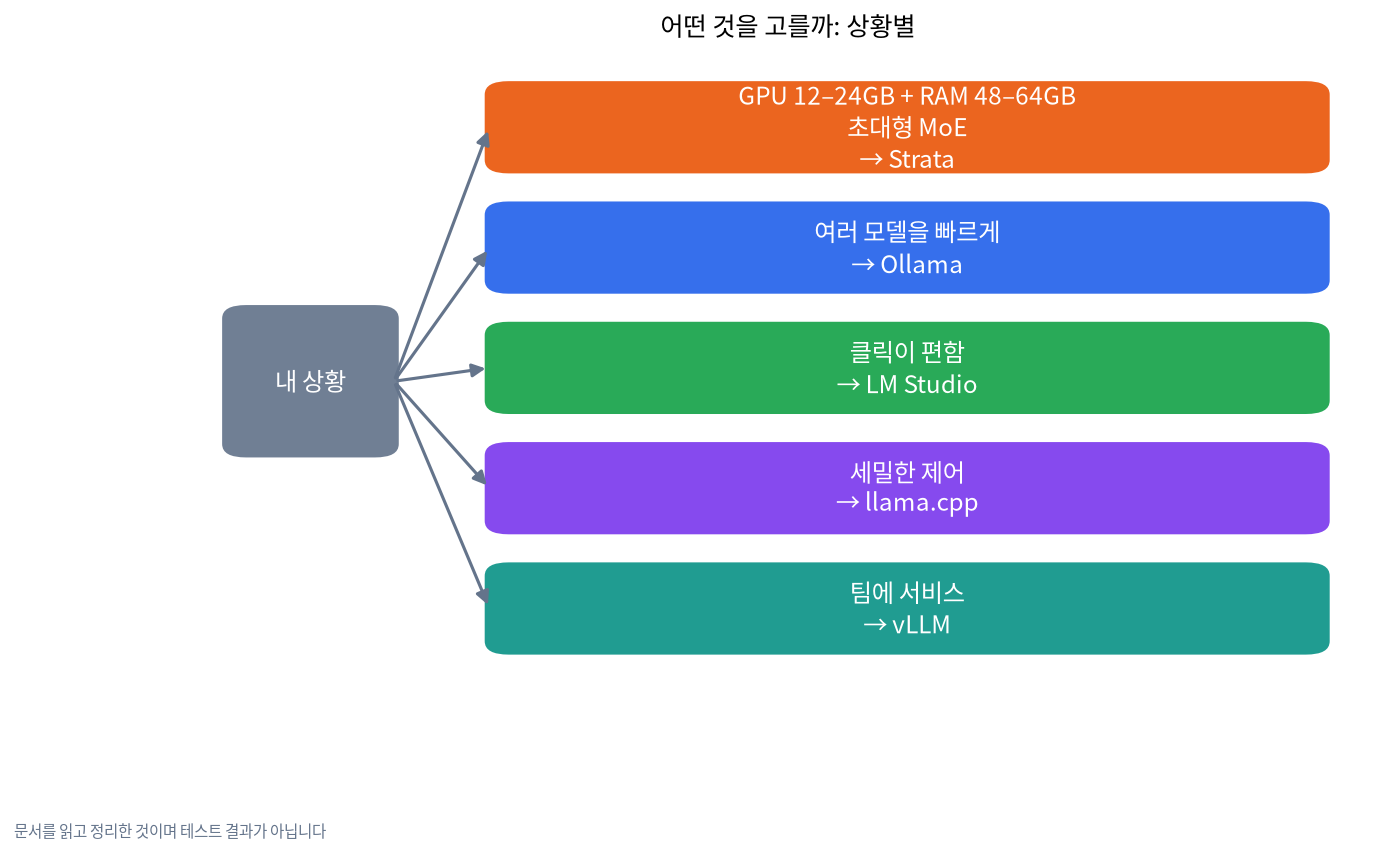
| 상황 | 먼저 쓸 것 | 이유 |
|---|---|---|
| 12~24 GB NVIDIA 또는 AMD GPU, RAM 48~64 GB, Qwen3.8-Flash-Next를 돌리고 싶다 | Strata | 그 모델과 그 메모리 배치를 위해 만들어졌다 |
| 여러 모델을 빨리 써 보고 싶다, Open WebUI를 연결하고 싶다 | Ollama | 설치가 가장 쉽고 생태계가 가장 크다. Ollama 설치 가이드 참고 |
| 타이핑보다 클릭이 편하다 | LM Studio | GUI 모델 탐색기. LM Studio 튜토리얼 참고 |
| 플래그, 양자화, 빌드를 정확히 제어해야 한다 | llama.cpp | 하드웨어에 가장 가깝다 |
| GPU 서버 한 대로 팀에 서비스한다 | vLLM | 동시 요청을 위해 만들어졌다 |
| 통합 메모리가 큰 Mac이 있다 | 먼저 Ollama나 LM Studio | 둘 다 Apple Silicon에서 MLX를 쓴다. Strata도 macOS 15 이상 지원 |
둘을 같이 쓰는 것을 막는 것은 없습니다. 많은 분이 일상적인 모델에는 Ollama를 두고, 큰 모델 하나를 위해 Strata를 추가할 것입니다. 다만 둘 다 같은 VRAM과 RAM을 쓰려 한다는 점은 기억하세요. 실제 절차는 Ollama 옆에서 Strata를 돌리는 설치 가이드에, 메모리 수치는 하드웨어 요구 사양 글에 있습니다.
자주 쓰는 조합
이 부분은 문서를 바탕으로 한 저희의 정리이지 프로젝트의 권장이 아니며, 저희가 직접 테스트한 것도 아닙니다.
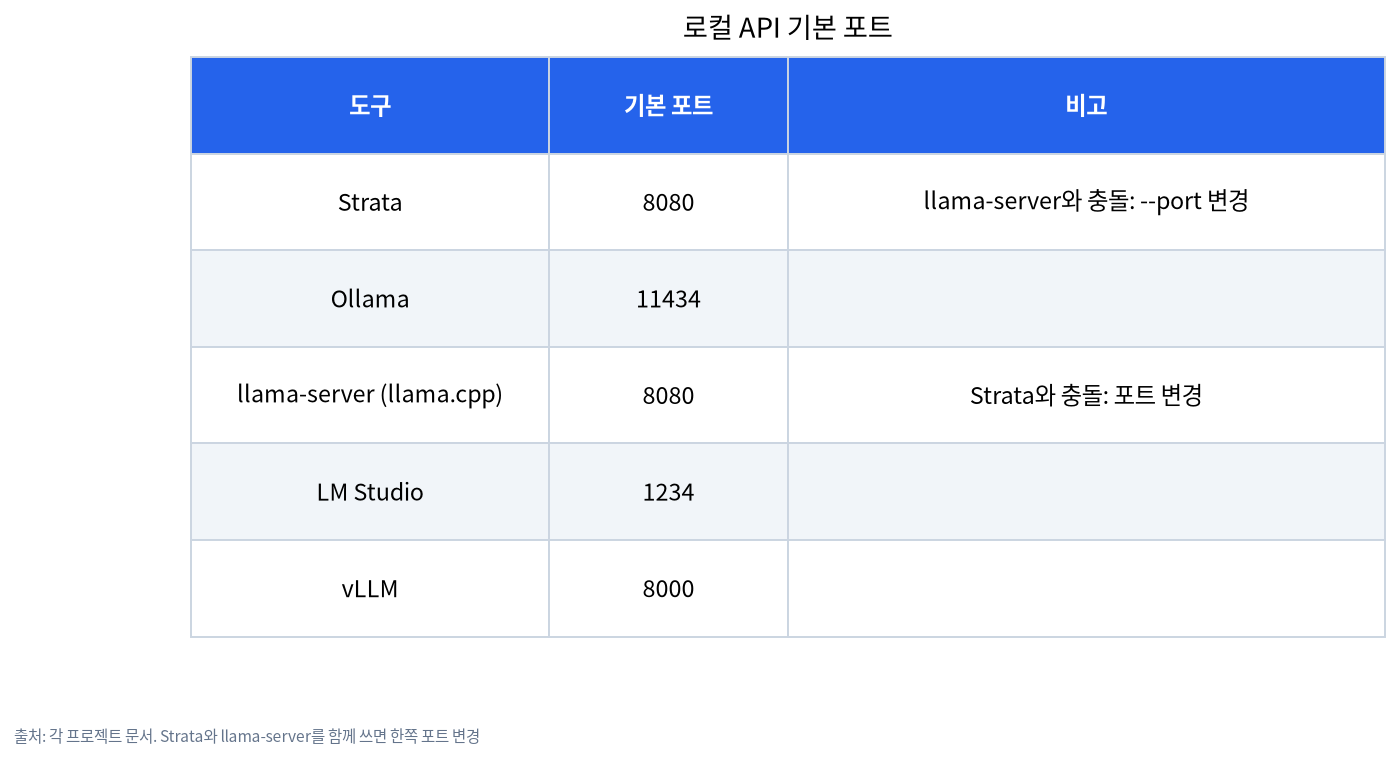
- Ollama와 Strata. 일상적인 소형 모델과 Open WebUI는 Ollama에 맡기고, Qwen3.8-Flash-Next가 필요할 때만 Strata를 켭니다. 포트는 충돌하지 않지만, Strata를 켜기 전에 Ollama의 모델을 먼저 내려야 합니다.
- LM Studio와 Strata. GUI를 좋아한다면 LM Studio로 여러 모델을 찾아 써 보고, 큰 모델만 Strata로 돌립니다. LM Studio의 기본 포트는 1234라서 이것도 Strata와 충돌하지 않습니다.
- llama.cpp와 Strata. 같은 모델로 비교해 보고 싶은 분은 번갈아 돌릴 수 있지만,
llama-server와 Strata는 둘 다 기본이 8080이라 한쪽 포트를 바꿔야 합니다. 같은 양자화, 컨텍스트, 버전에서 비교해야 의미가 있습니다.
RAM이 16 GB뿐이고 그래픽카드도 12 GB에 못 미친다면, 이 일에는 시간을 쓰지 않기를 권합니다. Strata의 장점은 큰 RAM 위에서 나오기 때문에, 더 작은 모델로 바꿔 Ollama를 계속 쓰는 편이 현실적인 경우가 많습니다.
라이선스, 데이터, 비용
엔진은 오픈소스(MIT 또는 Apache-2.0)이지만 모델 가중치에는 별도의 라이선스가 있습니다. Qwen3.8-Flash-Next는 Qwen Community License 1.0이므로 상업적으로 쓸 계획이라면 읽어 보세요. Strata 문서는 텔레메트리도 계정도 없다고 합니다. Ollama는 릴리스 노트에 따르면 로컬 모델을 로그인 없이 돌릴 수 있고, 선택형 클라우드 모델과 유료 플랜도 제공합니다. LM Studio의 약관은 가정과 업무에서의 사용은 허용하지만 재배포나 서비스로서의 호스팅은 허용하지 않습니다. 최신 약관은 항상 직접 확인하세요. 비용 면에서는 이 도구들 자체는 무료이고 실제 비용은 하드웨어에 듭니다. Strata는 큰 RAM과 12 GB 이상의 카드를, vLLM은 모델 전체가 들어갈 GPU 메모리를 요구하므로 예산을 보는 관점이 전혀 다릅니다.
저희가 한 것과 하지 않은 것
2026-11-04에 각 프로젝트의 저장소, 릴리스 노트, 문서와 위에 링크한 제3자 보고서를 읽었습니다. 이 글을 위해 다섯 도구 중 어느 것도 설치하지 않았고 속도도 하나도 측정하지 않았습니다. 한 사용자의 주장에서 나온 내용에는 그렇다고 밝혔습니다.
자주 묻는 질문 (FAQ)
Strata가 Ollama보다 빠른가요?
답할 수 없습니다. 공개된 비교는 대부분 서로 다른 모델을 써서 이 질문에 답하지 못합니다. 테스터들에 따르면 Strata는 12 GB 카드에서 125B MoE 모델을 초당 수십 토큰으로 돌릴 수 있지만, 그것은 Ollama에서 9B 모델을 돌리는 것과는 다른 일입니다.
Ollama로 Qwen3.8-Flash-Next를 돌릴 수 있나요?
2026-11-04에 Ollama 라이브러리에는 Apple Silicon용 105 GB MLX 태그가 있었습니다. NVIDIA GPU용으로 문서화된 경로는 찾지 못했고 테스트도 하지 않았으니, 쓰시는 플랫폼에 대해서는 라이브러리 페이지를 확인하세요.
초보자에게는 어느 것이 좋나요?
Ollama나 LM Studio입니다. 둘 다 몇 분이면 설치되고 가이드도 가장 많습니다. 특정한 아주 큰 모델이 필요해지면 나중에 Strata를 추가하세요.
Strata는 llama.cpp 위에 만들어졌나요?
문서는 llama.cpp의 바탕인 텐서 라이브러리 ggml을 서드파티 구성요소로 적고 있지만, Strata는 자체 스케줄링을 가진 별도의 C++ 엔진입니다. llama.cpp의 포크로 설명되어 있지 않습니다.
팀에 서비스하려면 무엇이 좋나요?
모델 전체를 올릴 GPU 메모리가 충분하다면 vLLM입니다. Strata는 기본적으로 병렬 요청 수를 카드에 맞춰 정하므로(12 GB GPU에서는 1개) 12 GB 카드는 팀이 아니라 한 사람을 위한 것입니다.
Strata를 써 보려면 Ollama를 지워야 하나요?
아닙니다. 기본 포트도, 모델 폴더도 다릅니다. 다만 같은 GPU에 큰 모델 두 개를 동시에 올리지는 마세요.
문의하기
어떤 도구가 내 GPU와 예산에 맞을지 모르겠다면 커뮤니티에 참여하시거나, GPU, RAM, 용도를 적어 admin@microaione.com으로 메일을 보내 주세요. 이 용도로 조립하고 테스트한 PC를 원하시면 머신과 솔루션 가이드를 참고하세요.