拒绝方向消融(Abliteration)原理详解:从 Arditi 论文到 OBLITERATUS
最近围绕 DeepSeek V4.1 Flash 1017 的“无审查”改版,很多讨论只停留在拒答率的数字上,却很少解释这些模型是怎么做出来的。它们背后的技术叫拒绝方向消融(refusal direction ablation),社区里常称 abliteration:先在模型内部找到一个与“拒答”相关的方向,再把这个方向从权重里去掉。本文只讲概念和证据,不提供任何针对有害用途的操作步骤。我们会依次说明原论文发现了什么、数学上怎么做、KL 散度是什么意思、有哪些副作用,以及它与微调、DPO、提示词越狱的区别。具体到一个实例,可以对照我们的DeepSeek V4.1 Flash 1017 Obliterated 解读。
要点速览(更新于 2026-11-01)
- Arditi 等人 2024 年的论文(arXiv:2406.11717)在 13 个最大 72B 的开源对话模型上发现:拒答由残差流中的一个一维方向介导,擦除它模型就不再拒答,加上它则连无害提示也会被拒答。
做法是取“有害提示”与“无害提示”激活的均值之差作为方向,再通过权重正交化让模型的各个写入矩阵再也写不出这一分量,不需要重新训练。
KL 散度衡量改动后模型与原模型的下一词分布差了多远;OBLITERATUS 这版自报 0.1305 nats,预算上限设为 0.5。KL 小不等于“质量没变”。
- 与微调、DPO 相比,它便宜且一次性,但副作用只能靠评测去测;原论文的结论同时也说明,开放权重模型的安全微调是脆弱的,部署方需要自己的护栏。
原论文发现了什么
Arditi、Obeso、Syed、Paleka、Panickssery、Gurnee 和 Nanda 在 2024 年 6 月发表的论文题为《Refusal in Language Models Is Mediated by a Single Direction》。按摘要,对话模型经过指令和安全微调后,会服从无害请求而拒绝有害请求;作者在 13 个最大 72B 参数的主流开源对话模型上都发现,拒答是由一个一维子空间介导的。对每个模型,都能找到这样一个方向:从残差流激活中把它擦除,模型就不再拒绝有害指令;反过来把它加进去,连无害指令也会被拒绝。基于此,作者提出一种白盒“越狱”方法,在对其他能力影响很小的前提下关闭拒答,并分析了对抗后缀为什么能抑制该方向的传播。他们的结论是:这一发现凸显了当前安全微调的脆弱性,也展示了借助对模型内部的理解来控制行为的可能。
这里要分清两件事。论文本身是机制可解释性研究,目的是理解安全行为为什么这样脆弱;把它做成现成工具,则是社区后来的工程化。FailSpy 的 abliterator 库基于 TransformerLens,提供缓存激活、计算拒绝方向等功能;Maxime Labonne 的博客文章《Uncensor any LLM with abliteration》把流程讲给了更广的读者。OBLITERATUS 则是又一个把这套流程自动化、并附带评测元数据的开源工具。
拒绝方向消融怎么工作:概念层面
整个思路可以用三步来理解。
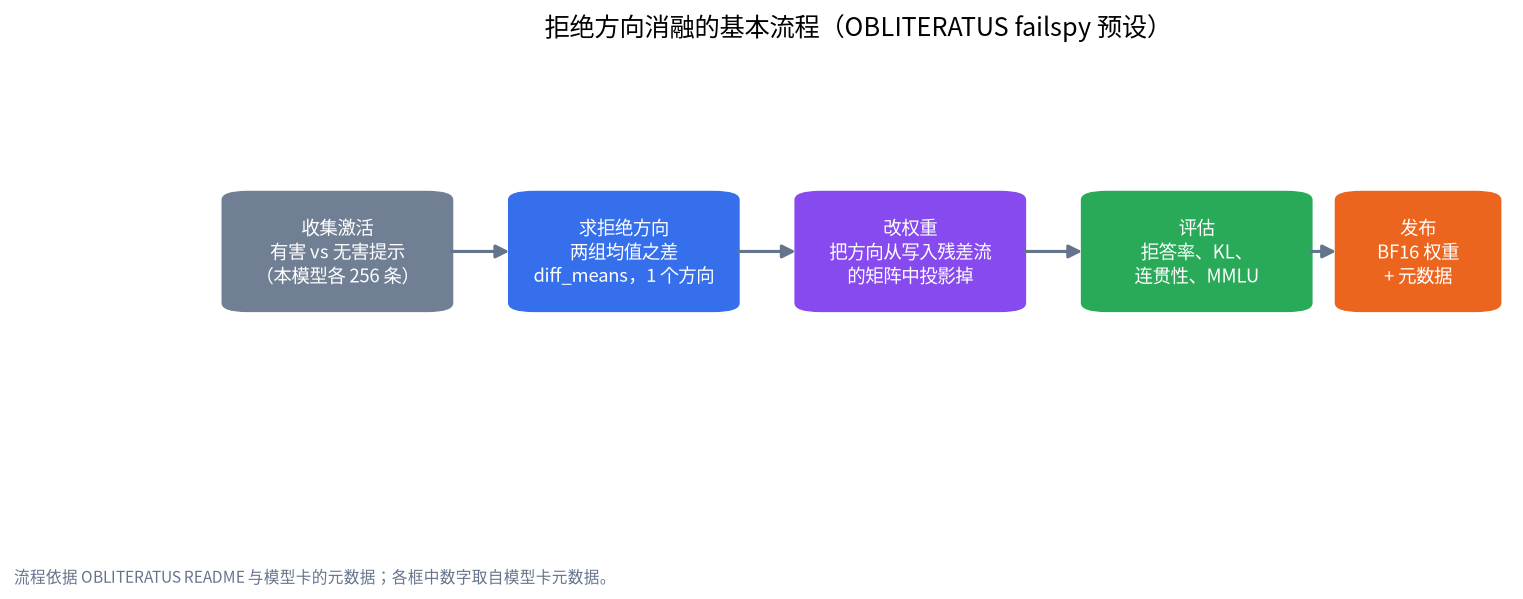
第一步:收集激活。 准备两组提示,一组会让模型拒答,一组是普通请求。让模型处理它们,在某一层、某个 token 位置读取残差流的激活向量。这一版 DeepSeek 改版用了有害、无害各 256 条提示来求方向,另有各 50 条用于评测,数字来自模型库中的元数据。
第二步:求方向。 最简单的做法是“均值之差”(diff in means):把有害组的平均激活减去无害组的平均激活,再归一化得到单位向量 r̂。直观上,r̂ 指向“这条请求像是该拒绝的”这一方向。OBLITERATUS 的其他预设可以用 SVD 提取多个方向,而这个版本使用的 failspy 预设只取 1 个方向。
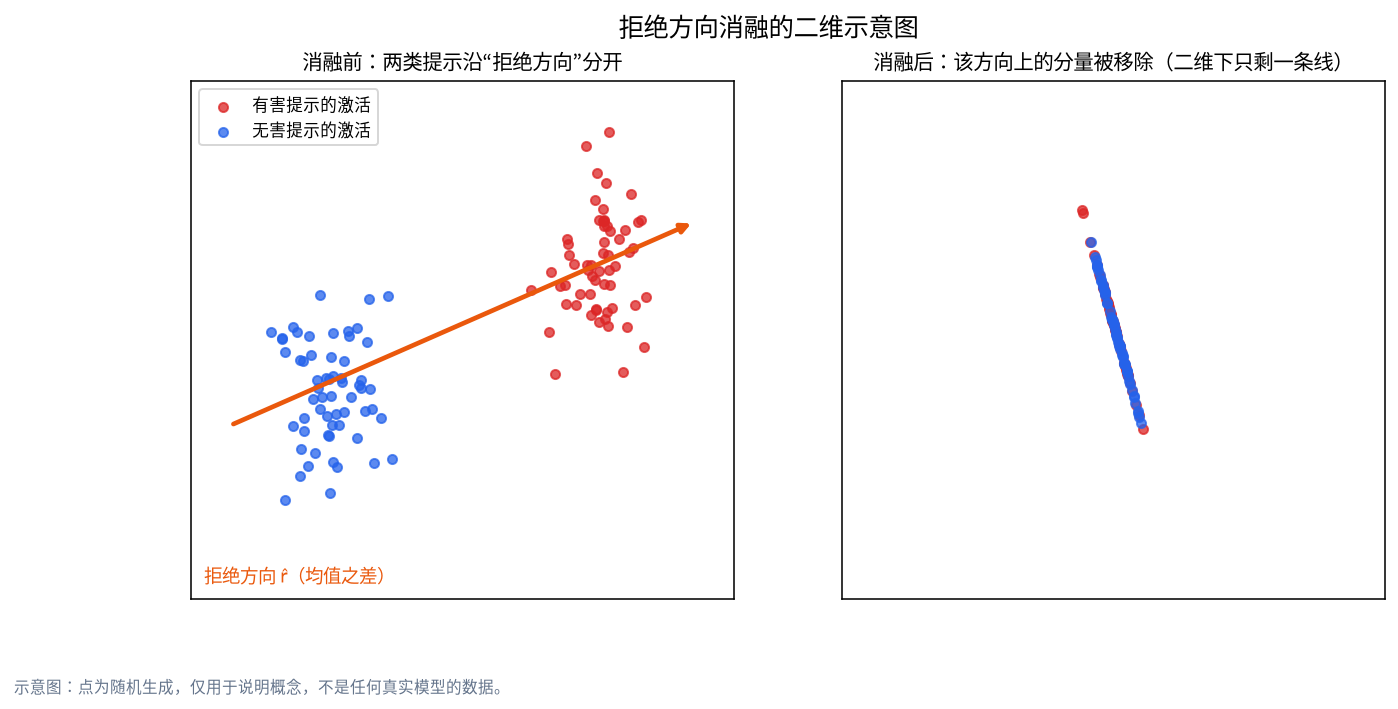
第三步:消融。 有两种等价的实现。推理时消融,是在每一层、每个位置把激活 x 变成 x′ = x − r̂r̂ᵀx,也就是去掉它在 r̂ 上的投影。权重正交化,则是对每一个把结果写进残差流的矩阵 W(例如注意力输出投影、前馈层输出投影、嵌入矩阵)做 W′ = W − r̂r̂ᵀW,让它此后输出的内容天然与 r̂ 正交。这样改完后,模型的结构与推理方式都不变,也不需要任何额外运行时支持,只是权重变了。
对于混合专家模型(MoE),需要处理的矩阵更多,因为每个专家都有自己的输出投影。按元数据,这版的投影目标是“all”,层选择为“除第一层外所有层”,路由器没有被投影(project_router 为 false),也没有做范数保持。想了解 MoE 为什么体积大,可以读我们的 MoE 模型本地运行指南。
OBLITERATUS 的流程与这一版的设置
OBLITERATUS 的 README 把流程分成 SUMMON、PROBE、DISTILL、EXCISE、VERIFY、REBIRTH 六个阶段,大意是加载模型、收集激活、提取方向、修改权重、验证困惑度与连贯性、保存带完整元数据的模型。把它压缩成我们的五步图,如下。
| 设置 | 这一版的取值 | 含义 |
|---|---|---|
| 方法预设 | failspy | 沿用 FailSpy 风格的“均值之差、单方向” |
| 方向提取 | diff_means,1 个方向 | 最简单也最容易解释 |
| 层选择 | 除第一层外所有层 | 不是只改一两层 |
| 范数保持 | 关闭 | 不额外约束权重范数 |
| KL 预算 | 0.5,实际 0.1305 nats | 超出预算会回滚或修正 |
| 提示数量 | 有害、无害各 256 | 用于求方向 |
README 的默认预设(advanced)则使用 4 个 SVD 方向、范数保持、偏置投影和两轮处理,比 failspy 预设更重。这里的重点是:同一个工具里有不同强度的预设,模型卡写明用了哪一个,比“某某工具做的”更有信息量。
KL 散度:量化“改了多少”
KL 散度(Kullback–Leibler divergence)衡量两个概率分布的差距。放到这里,就是拿同一段文本分别交给原模型和改版模型,比较它们对“下一个词”的概率分布相差多少。为 0 表示完全一致,越大说明分布改变越多,单位是 nats。模型卡写明这是“序列 token 的前向 KL”,数值 0.1305;元数据里首个 token 的 KL 为 0.3767,预算 0.5,状态是“在预算内”。
读 KL 时有三个提醒。第一,KL 衡量的是“与原模型的距离”,不是“质量好坏”:两个模型可以彼此接近但都不好,也可以差得较远而更好。第二,它依赖测试文本的分布,不同数据上的数值不能直接比较。第三,任何对原模型的改动都会让 KL 大于 0;去掉拒答恰恰会改变一部分回答的概率,所以我们要看的是它改变了什么,需要同时看拒答率、危害分布和能力评测。这几个指标的具体数字,见我们对这个模型的评测解读。
副作用有哪些
按模型卡和论文,可以较有把握地说的有这些:
- 能力基本保持,但并非零变化。 这一版在 2,500 题 MMLU 上差异为 +0.12 个百分点,不显著;论文的说法是“对其他能力影响很小”。
- 拒答不是二值的。 同一张表里,完全拒答大幅下降,部分拒答却上升,说明模型的行为变成了新的混合。
- 危害相关的回复显著增多。 这是预期结果,不是副作用;但使用者必须承担它。
- 方向可能不止一个,也可能重新出现。 OBLITERATUS 的 README 提到一种“Ouroboros 效应”,即拒答行为可能在相邻层重新聚合,因此提供了额外的修补轮次。是否在每个模型上都成立,我们没有验证。
- 后续量化会再次改动权重。 对消融后的模型再做低位量化,行为是否保持,需要重新评测,已有结果不能直接沿用。
与其他“去拒答”方法的对比
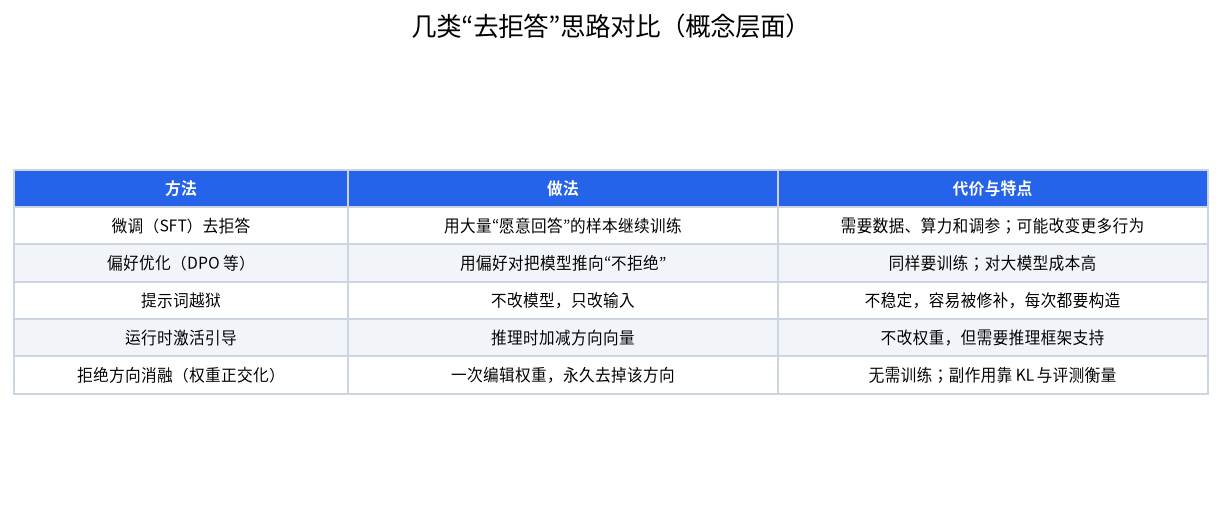
| 方法 | 是否需要训练 | 是否改权重 | 稳定性 | 主要代价 |
|---|---|---|---|---|
| 微调(SFT) | 需要,且需要数据 | 是 | 较稳定 | 数据、算力、调参;可能改变更多行为 |
| 偏好优化(DPO 等) | 需要偏好对 | 是 | 较稳定 | 同样需要训练,大模型成本高 |
| 提示词越狱 | 不需要 | 否 | 不稳定 | 每次都要构造,容易被修补 |
| 运行时激活引导 | 不需要 | 否 | 取决于框架 | 需要推理框架支持,推理时多一步 |
| 拒绝方向消融 | 不需要 | 是(一次性) | 效果较直接 | 副作用只能靠评测去测 |
它最大的吸引力是便宜:不需要标注数据、不需要几百块 GPU 训练,只需要能把模型跑起来并读到激活。代价在于它是一种针对单一行为的粗略手术,我们无法保证其他行为一点没变。另外,它是“改权重”的方法,意味着分发出去的是一份新的权重,来源与完整性都要使用者自己核对。
和其他工具、其他模型比较
| 工具 | 形态 | README 的重点 | 我们的看法 |
|---|---|---|---|
| FailSpy abliterator | 基于 TransformerLens 的 Python 库 | 缓存激活、计算拒绝方向、在 notebook 里实验 | 开创性的轻量实现,更像研究笔记 |
| Heretic(p-e-w) | 训练无关的模型改造工具 | 默认抑制拒答,也可用于减少“套话”、谄媚等,号称社区已发布数千个模型 | 自动化程度高,数量大,质量参差不齐 |
| OBLITERATUS | 带预设、分析与元数据的开源工具 | 七档预设、多方向、范数保持、验证与完整元数据 | 把评测写进元数据,更便于核对 |
至于 Hugging Face 上围绕同一基础模型的各种“abliterated”仓库,它们用的方法、数据和评测不一致,多数没有公开细节,而且我们没有逐个审计,因此不在这里横向排名。需要选择时,优先看有没有披露方法与评测、能不能核实发布者身份。
负责任地理解这项技术
这项研究的价值在于让我们看清安全微调有多脆弱:只要拿到开放权重,一个方向就可以被去掉。这对部署者的含义很直接:不要假设开放模型自带的拒答是可靠的防线,要在外面再加一层。常见做法是用 Llama Guard 这类安全分类模型分别检查输入和输出,限制工具权限,保留日志,并对高风险场景加入人工复核。
我们认为可站得住脚的用途包括:红队与安全研究、小说等创作场景中减少过度拒答、研究“过度拒答”本身。风险方面,去掉拒答后的模型更容易产出有害内容,不应直接对公众开放。合规方面,以下仅是一般性提示,不构成法律意见:在中国大陆,向公众提供生成式人工智能服务要遵守《生成式人工智能服务管理暂行办法》等规定;在欧盟要关注《人工智能法案》对通用目的模型的义务;工具与权重的协议也各不相同(模型卡写明权重为 MIT,OBLITERATUS 工具为 AGPL-3.0 并有商业授权)。如果你想了解这类模型在本机的内存需求,可以继续阅读本地部署指南,量化的基础知识见 Q4_K_M 量化解读,怎么看评测榜单见如何看懂大模型评测。
常见问题
拒绝方向消融和 abliteration 是一回事吗?
基本是。Abliteration 是社区对这类做法的称呼,核心都是找到拒绝方向并把它从激活或权重中去掉。
为什么说拒答只由“一个方向”介导?
这是 Arditi 等人在 13 个最大 72B 的开源对话模型上的实证发现:擦除该方向模型不再拒答,加入该方向则无害提示也会被拒答。它是经验结论,不代表所有行为都只靠一个方向。
KL 散度越小越好吗?
小表示改动后的模型更接近原模型,但不等于质量更好,也不等于没有副作用。需要与拒答率、能力评测和人工检查一起看。
它和微调、DPO 有什么区别?
微调和 DPO 需要数据和训练;拒绝方向消融不训练,直接对权重做一次线性代数修改,成本低,但副作用只能靠事后评测发现。
消融之后还能再量化吗?
可以做,但量化会再次改变权重,行为可能变化,需要重新评测。我们没有看到针对该模型量化后行为的公开评测。
这项技术合法吗?
技术原理本身是公开研究;是否合法取决于你的用途、地区和是否向公众提供服务。请先咨询专业人士,并为生产环境加上自己的护栏。
和我们聊聊
想讨论模型的安全、评测或本地部署?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:Arditi 等,Refusal in Language Models Is Mediated by a Single Direction、Labonne:Uncensor any LLM with abliteration、FailSpy abliterator、Heretic、OBLITERATUS。读取日期 2026-11-01。
延伸阅读:拒答率评测详解;去审查模型的合规风险