KnowLine-31B-Gen1 评测:最好的决策模型?显存、延迟与同类模型对比
KnowLine-31B-Gen1 是 PelaAI 在 2026-10-24 发布的一个”决策模型”(decision model)。它不是聊天模型:你给它一段状态描述和最多 64 个带类型的问题(是非、选择、打分),它对每个问题只做一次前向计算并直接输出概率分布,不生成文字。按 Decision Index 0.4.1 的完整榜单,它与 GLiDE 1.2 等模型并列第一;按独立的 JevBench,它在开放权重榜单上排第二。”最好的决策模型”这个说法有依据,但依据比标题窄:并列、自报、不同榜单名次不同。本文把这些数字分开讲清楚,并回答本地读者关心的三件事:它要多少显存、延迟成本如何、与同类模型怎么选。
核实说明:模型事实读取自 Hugging Face 上的模型卡(PelaAI/KnowLine-31B-Gen1)与 decisionmodels.io 的模型页;独立评测来自 Benchmark Heaven 的 JevBench(数据发布于 2026-10-31);Decision Index 来自 Hugging Face 上的 decision-index-leaderboard 数据集。模型卡中的大部分数字是作者自测,我们都标明了。我们没有自己部署或测试过这个模型。FP8 与 4 比特的显存是我们按参数量做的权重算术,不是实测,作者说他没有测试过 FP8。
要点速览(更新于 2026-11-01)
- 它是什么:31B 稠密模型,基于 google/gemma-4-31B-it 做 LoRA 微调,权重 Apache-2.0;一次前向给出概率,不做文本生成。
榜单:Decision Index 0.4.1 完整榜 71.86,与 GLiDE 1.2(71.52)等并列第一;JevBench 开放权重榜单第二,能力 85.2。
硬件:BF16 约 63GB 权重,作者在一块 96GB 的 H20 上运行;decisionmodels.io 写明服务约需 75GB 显存。
它到底是什么:决策模型不是聊天模型
模型卡的描述是:输入是一个”状态”加最多 64 个类型化问题,输出是每个问题的概率分布,每个问题一次前向,不生成文本,服务端点是 /v1/systemone。适合的任务是”某个动作该不该做””在几个选项里选哪个””给这个请求打几分”这类需要校准过的概率,而不是写文章或聊天。作者还说明了训练方式:在 gemma-4-31B-it 上做 rank 32 的 LoRA,合并后再用 0.75 的微调权重加 0.25 的基础权重做平均。语言支持英语、简体中文和繁体中文。
因此你不能拿它和 Claude Opus 5.5 这样的通用模型直接比”聪明”。它的竞争对手是同类的决策模型,而不是聊天模型。我们没有找到可靠的、同一榜单上的决策模型对通用聊天模型的直接对比,所以不在文中编造这类比较。
榜单:并列第一与第二,两件不同的事
| 榜单 | KnowLine-31B-Gen1 的位置 | 需要知道的前提 |
|---|---|---|
| Decision Index 0.4.1 完整榜 | 71.86,并列第一 | 与 GLiDE 1.2(71.52)、Sieve 31B v3(71.10)等在同一个并列区间;榜单为提交制 |
| Decision Index 公开套件 | 70.13,排第 11 | 公开套件上不是第一 |
| 同技能与新领域子项 | 同技能 66.94,新领域 79.24 | 新领域得分更高,说明在没见过的领域表现不差 |
| JevBench 开放权重榜 | 第二,能力 85.2 | 与 baselabs 的 mammoth-1 同为 85.2;能力 = 智能与校准的平均 |
另外,JevBench 页面还给出一个名为”official”的排名(第 83,综合 60.2);我们没有找到这个综合分的定义,所以不做解读,只如实记录。
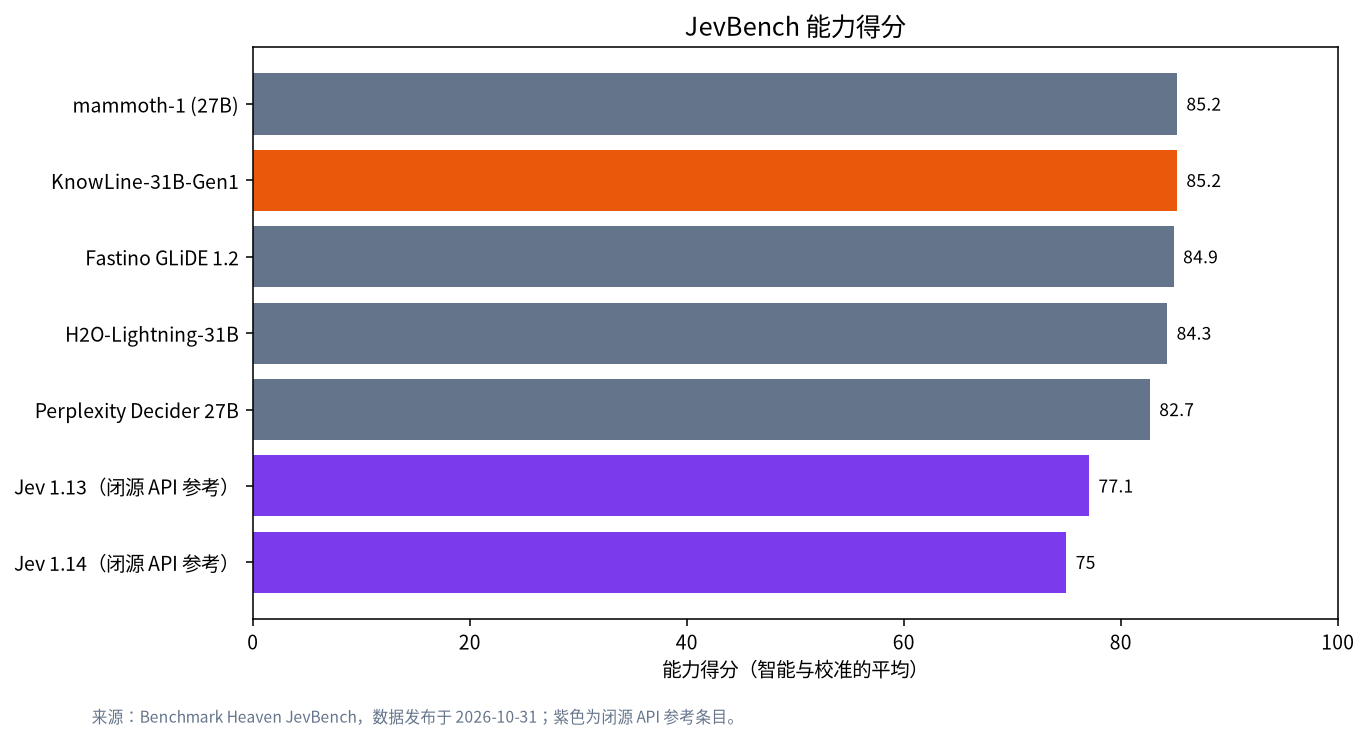
JevBench 能力榜上的几名同类模型:mammoth-1(27B,基于 Qwen3.5-27B)85.2;KnowLine-31B-Gen1 85.2;Fastino GLiDE 1.2 为 84.9;H2O-Lightning-31B 为 84.3(FP8,p50 延迟 0.065 秒,智能分 79.3 是榜上最高);Perplexity Decider 27B 为 82.7;Jev 1.13 与 1.14 两个闭源 API 参考条目为 77.1 和 75.0。简单说:KnowLine 在能力上和 mammoth-1 打平,但每 1,000 次决策的估计成本约 0.061 美元,高于 mammoth-1(0.027)和 GLiDE(0.025)。所以”最好”取决于你重视什么:能力打平时,更小更便宜的模型有时更合适。
硬件:显存、延迟与成本
| 项目 | 数据 | 来源 |
|---|---|---|
| 权重大小 | 约 62.5GB,13 个分片,BF16 约 63GB | 作者(模型卡) |
| 作者运行环境 | 一块 96GB 的 H20,SGLang 0.5.21,BF16 | 作者(模型卡) |
| 服务显存 | 约 75GB(BF16) | decisionmodels.io |
| 独立测试硬件 | 一块 96GB 的 RTX PRO 6000 | JevBench |
| FP8 | 作者未测试 | 作者(模型卡) |
| 提示词开销 | “读两遍”的服务方式使提示词 token 约为 1.54 倍 | 作者(模型卡) |
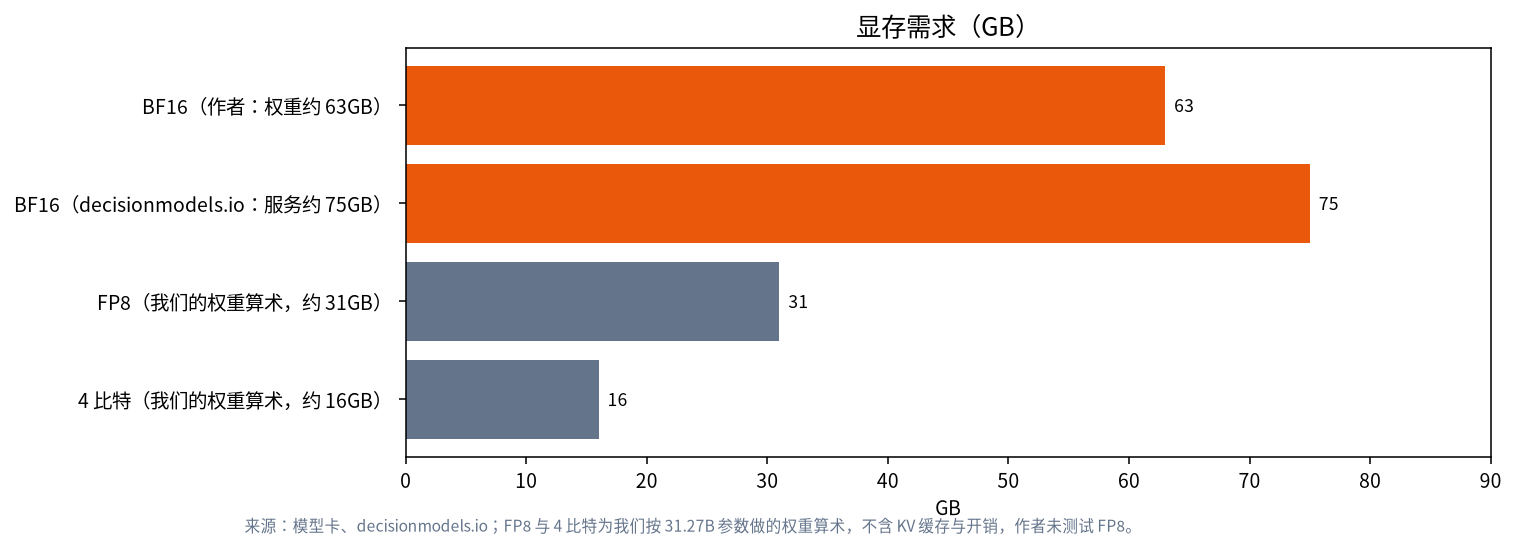
我们的权重算术(不含 KV 缓存与运行开销,不是实测):31.27B 参数在 BF16 下约 62.5GB;若 FP8 约 31GB,4 比特约 16GB。这意味着一块 24GB 的卡理论上有机会放下 4 比特的权重,但作者没有验证量化后的校准和提示注入表现,而决策模型的价值正在于校准,所以我们不建议在没有自己的评测前量化。想看量化的一般影响,请读量化格式详解;想了解 96GB 工作站卡,请读RTX PRO 6000 工作站。
延迟有三个来源的数据,硬件和负载不同:
| 来源 | 硬件 | 中位延迟 | p95 延迟 |
|---|---|---|---|
| 作者(模型卡) | 一块 96GB H20 | 340 毫秒(均值 910 毫秒) | 3,977 毫秒 |
| Decision Index 榜单 | 榜单环境 | 203.7 毫秒 | 1,822 毫秒 |
| JevBench | 一块 96GB RTX PRO 6000 | 255 毫秒 | 469 毫秒 |
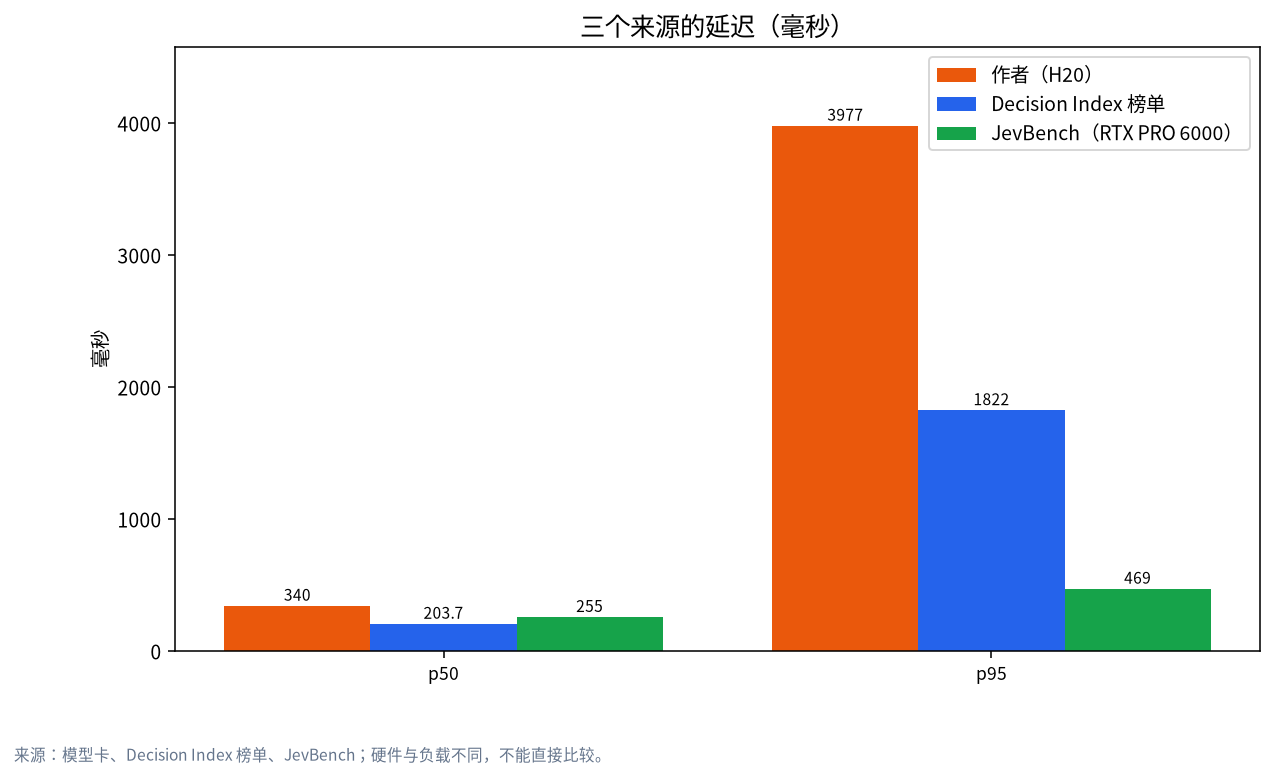
三个数字差了近一个数量级的尾延迟,原因是负载、批大小和问题数量不同。如果你要做在线决策,请用自己的请求分布测 p95,而不要采用任何一个来源的数字。JevBench 给出的成本估计是每 1,000 次决策约 0.061 美元(估计值),按这个数字,100 万次决策约 61 美元,仅作量级参考。
决策模型适合哪些任务
可以把决策模型理解为”带校准的分类器”。典型任务有:工单分流(转人工、自动处理还是拒绝)、风控打分(欺诈风险 1–5 分)、代理(agent)里的”下一步该不该执行这个工具调用”的闸门,以及网页自动化里”该点哪个元素”的选择。模型卡提到的 Mind2Web 元素选择类评测就属于这一类。它们的共同点是:答案是有限选项,需要的是可信的概率,而不是漂亮的解释。如果你需要解释,应该让一个聊天模型另行生成说明,再由决策模型给出概率。
一个好用的模式是”两段式”:先让本地小模型或规则做粗筛,把拿不准的样例交给 KnowLine 打分,再把概率落在中间区间的交给人工。这样既能控制成本,又能把校准当成真正的路由信号。想把它接进自己的服务,可以参考本地模型 API 服务器搭建。
三种获得它的方式
| 方式 | 说明 | 适合谁 |
|---|---|---|
| 自己下载权重本地跑 | 权重在 Hugging Face,Apache-2.0;作者用 SGLang 0.5.21 在一块 96GB 的 H20 上运行 | 有 96GB 级显卡、重视数据留存的团队 |
| 托管的专用端点 | decisionmodels.io 提供专用 GPU 端点、按 token 的托管 API、本地安装与预装硬件等选项 | 想先试用、没有大显存卡的人 |
| 企业内网部署 | 按 企业私有化部署 的思路规划权限与审计 | 有合规要求的公司 |
需要说明的是,decisionmodels.io 页面提到的安装器收费条款(个人和不超过 10 名员工且年收入不超过 100 万美元的公司免费,更大的公司一次性 1,000 美元加每月 100 美元)针对的是它的安装工具,而不是模型权重本身;模型权重的许可以模型卡为准。
“读两遍”对成本意味着什么
模型卡说明,服务时采用”读两遍”的方式,使提示词 token 约为原来的 1.54 倍。这一点在做成本估算时很容易被漏掉:如果你的状态描述有 1,500 个 token,按这个系数相当于约 2,310 个 token 的前向计算(这是我们的算术)。因为输出不生成文字,所以没有逐字解码的开销,成本主要由提示词前向决定。结论是:状态描述越长、问题越多,延迟和成本越接近线性增长,在设计提示词时应当把无关的上下文删掉。
它的弱点:别忽略安全性
模型卡自己披露了一个弱点:在提示注入测试中,已见模板有 0.4% 的回答被改变,未见模板为 5.3%,作者说这比同系列的其他模型差。对于要处理不可信输入的决策场景(比如用户文本里夹带指令),这一点要在上线前用你自己的对抗样例复测。校准方面,作者报告公开套件上的 ECE 为 0.012–0.021(作者自测)。
如何选:KnowLine 还是同类
| 你的情况 | 倾向 | 理由 |
|---|---|---|
| 有 96GB 级显卡,追求两个榜单都靠前 | KnowLine-31B-Gen1 | Decision Index 并列第一,JevBench 第二 |
| 在乎每次决策成本与延迟 | mammoth-1、GLiDE 1.2 或 H2O-Lightning | 同类榜单能力接近,成本估计更低,或延迟更短 |
| 只有 24GB 显卡 | 先选更小的同类,或自行验证量化 | 31B 的 BF16 超出一块 24GB 卡 |
| 需要中文决策 | KnowLine(支持简繁中文) | 其他模型的语言支持本文未核实 |
| 输入可能含恶意文本 | 先复测提示注入 | 作者披露未见模板 5.3% |
自己复现:评测方法
- 准备 200 个你领域的决策样例,每个有明确的标准答案和一个”边缘”版本。
- 用同一批样例跑 3 个模型:KnowLine、一个更小的同类模型、你现在在用的方案。
- 记录准确率与校准:把预测概率分成 10 档,画可靠性曲线,计算 ECE。
- 做注入测试:在 20 个样例里夹入指令文本,统计答案被改变的比例。
- 压测延迟:用真实的并发和问题数量,记录 p50 和 p95。
- 记录单次决策成本:GPU 租金或折旧加电费,除以决策次数。
状态:用户提交了退款申请,订单金额 89 元,已签收 3 天,历史退款 0 次。
问题 1(是非):是否应自动批准退款?
问题 2(打分 1-5):该请求的欺诈风险有多高?
问题 3(选择):应转人工、自动批准还是拒绝?
常见错误
- 把它当聊天模型:它不生成文本,用法和聊天接口完全不同。
- 把”并列第一”读成”稳赢”:71.86 与 71.52 在同一并列区间内。
- 忽略榜单是提交制:Decision Index 的数据为提交,自测数字需独立复现。
- 拿作者的延迟直接做容量规划:三个来源差异很大。
- 量化后不复测校准:决策模型靠概率质量吃饭。
相关阅读
常见问题:KnowLine-31B-Gen1
KnowLine-31B-Gen1 是什么?
一个 31B 稠密的决策模型,基于 gemma-4-31B-it,用于对带类型的问题输出概率分布,每个问题一次前向,不生成文本。
它真的是最好的决策模型吗?
在 Decision Index 0.4.1 完整榜上与 GLiDE 1.2 等并列第一(71.86),在 JevBench 开放权重榜上排第二(能力 85.2,与 mammoth-1 持平)。公开套件上排第 11。
运行需要多少显存?
作者在一块 96GB 的 H20 上运行 BF16,权重约 63GB;decisionmodels.io 写明服务约需 75GB。FP8 作者未测试。
能在 24GB 显卡上运行吗?
BF16 不行。按我们的算术 4 比特权重约 16GB,但没有验证量化后的质量,不建议直接采用。
许可证是什么?
模型页写明权重为 Apache-2.0,代码为 MIT(以模型卡为准)。
它能替代聊天模型吗?
不能。它只做带类型问题的概率输出,不生成文本。
和我们聊聊
在评估决策模型的本地部署?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:Hugging Face:PelaAI/KnowLine-31B-Gen1、decisionmodels.io 模型页、Benchmark Heaven:JevBench 页面、Decision Index 榜单数据集。