Llama Guard 本地部署教程:用 Llama Guard、Qwen3Guard 与 ShieldGemma 给本地大模型加护栏
本地部署一个大模型很容易,但一旦把它开放给别人使用,就需要一道独立于模型的“护栏”:在请求进入模型之前审核输入,在回答返回之前审核输出,把违规内容拦下来并留下记录。这类专门做内容安全判断的小模型叫护栏模型(guard model)。这篇文章是一份面向实操的 Llama Guard 本地部署教程:先对比 Llama Guard、ShieldGemma、Qwen3Guard 和 gpt-oss-safeguard 的体积与特点,再用 Ollama 把护栏跑起来,给出输入输出审核的代码结构,最后算清显存预算,并说明怎么评估误判。需要先声明:护栏是防守工具,本文不涉及任何绕过方法;它的判断也不等于法律意义上的“合规”,仅作为技术层的一道防线。整体设计思路见 越狱防御怎么做。
要点速览(更新于 2026-11-04)
- 最容易上手的是 Ollama 上的
llama-guard3:1b(约 1.6GB)和llama-guard3:8b(约 4.9GB),上下文 128K;ShieldGemma 有 2B(1.7GB)、9B(5.8GB)、27B(17GB),上下文 8K。Qwen3Guard(2025 年 9 月发布)有 0.6B、4B、8B 三个规格,分 Gen 与 Stream 两个变体,标签是“安全、有争议、不安全”三级,覆盖 119 种语言,对中文更友好。
gpt-oss-safeguard(2025 年 10 月发布)有 20b 与 120b 两个规格,Apache 2.0 许可,特点是可以在推理时传入你自己的政策。
在 24GB 显存上,27B 主模型加 1B 护栏权重合计约 20GB,可行;32B 主模型加 8B 护栏约 25GB,放不下,需要把护栏放到 CPU 或换小一点的组合。
护栏不是万能:一定要用你自己的数据评估误拦和漏拦,并持续回归。
为什么本地模型需要一道独立的护栏
本地模型只有权重里的对齐训练,没有在线产品那样的外层过滤。对自己用,这没问题;但如果你把它做成团队内部助手、对外的聊天机器人,或者接入客服流程,就需要一个独立的审核层,原因有三:
- 对齐训练会失效,在新的表达方式面前尤其如此(见 大模型越狱是什么)。
- 审核策略需要可控:你的业务想拦哪些内容、放过哪些内容,应该由你定义,而不是只靠模型自己判断。
- 需要留痕:被拦截的请求需要记录下来,便于复盘和改进。
护栏模型体积小、速度快,可以和主模型一起部署。更多关于“要不要破甲”的讨论见 Qwen 本地部署需要破甲吗。
四类护栏模型怎么选
| 模型 | 规格与体积 | 上下文 | 特点 | 适合 |
|---|---|---|---|---|
| Llama Guard 3(Meta) | 1B(Ollama 约 1.6GB)、8B(约 4.9GB) | 128K | 输出 safe 或 unsafe 加类别编码,类别采用 MLCommons 风险分类(以官方模型卡为准) | 英文为主、需要稳定的开源方案 |
| Llama Guard 4(Meta) | 12B 稠密多模态,单张 24GB 显卡可运行 | 以模型卡为准 | 支持图文输入 | 需要图像审核 |
| ShieldGemma(Google) | 2B(约 1.7GB)、9B(约 5.8GB)、27B(约 17GB) | 8K | 按你给定的政策逐条判断 | 想灵活指定政策、短文本 |
| Qwen3Guard(阿里) | 0.6B、4B、8B;Gen 与 Stream 两个变体 | 以模型卡为准 | 三级标签:安全、有争议、不安全;119 种语言;Stream 变体可边生成边检查 | 中文、多语言、需要流式 |
| gpt-oss-safeguard(OpenAI) | 20b(约 21B 参数,激活约 3.6B)、120b(约 117B 参数,激活约 5.1B) | 以模型卡为准 | Apache 2.0;推理时传入自定义政策并带推理过程 | 政策经常变、可接受较大开销 |
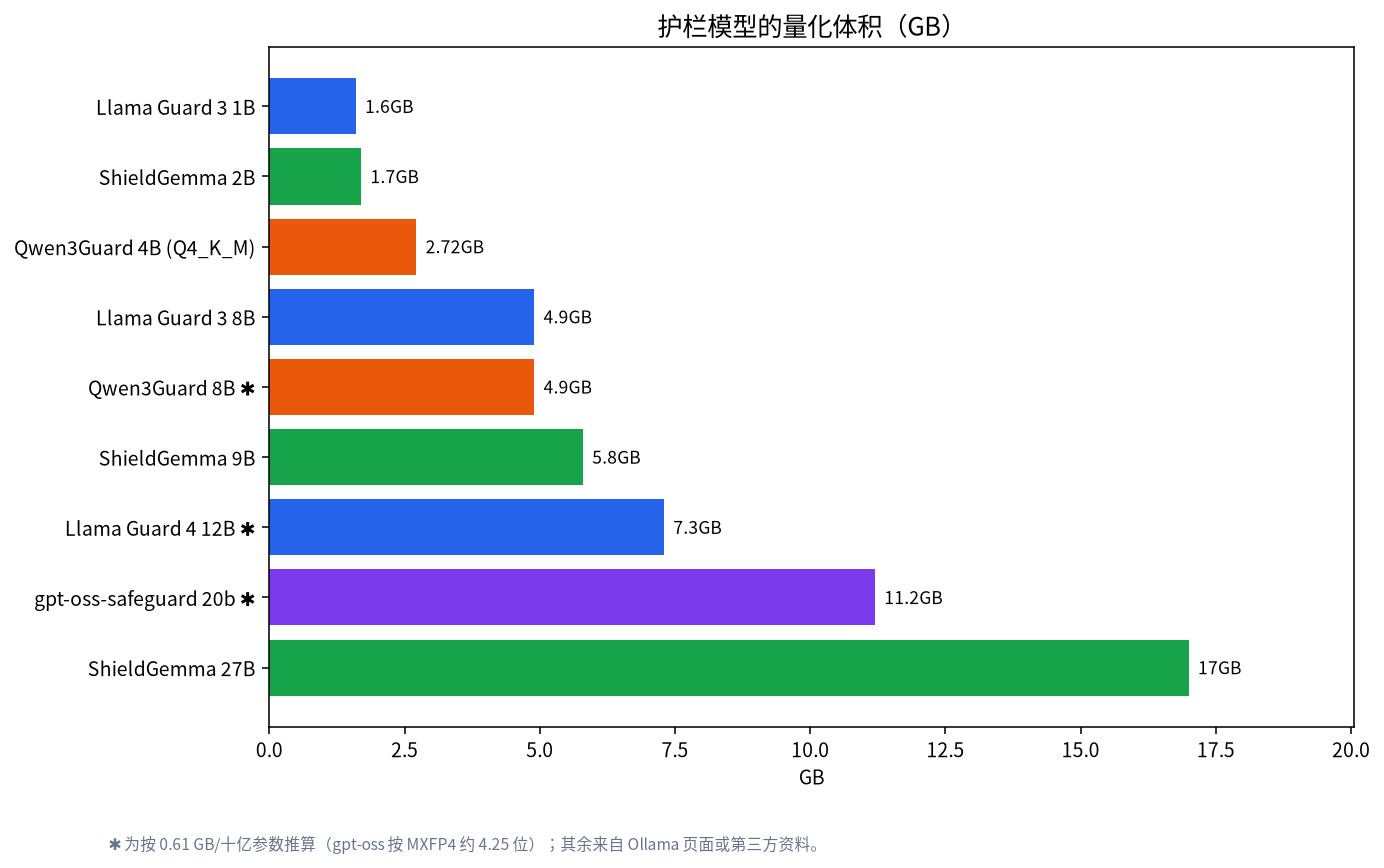
几点说明。第一,我们没有对这些模型的准确率做过测试,上表的信息来自官方发布页面和 Ollama 页面,部分体积为按 0.61 GB 每十亿参数推算;选型时请以模型卡和你自己的评估为准。第二,Qwen3Guard 的 Stream 变体需要在加载时允许自定义代码(trust_remote_code),这意味着你要信任模型仓库的作者,并固定版本和校验文件;我们在 如何识别可疑模型仓库里讲过这类风险。第三,三级标签的好处是你可以让“有争议”的内容走人工复核,而不是一刀切。
Llama Guard 本地部署实操:用 Ollama 跑起来
先按 Ollama 安装指南装好 Ollama,然后拉取护栏:
ollama pull llama-guard3:1b     # 约 1.6GB,适合 CPU 或小显存
ollama pull llama-guard3:8b     # 约 4.9GB,判断更细
Llama Guard 3 的使用方式是:把一段对话交给它,它返回第一行 safe 或 unsafe,如果是 unsafe,第二行给出违规类别编码。只审核用户输入时,对话里只放用户消息;审核模型回答时,对话里放用户消息加模型回答。下面是一个调用本地 Ollama 接口的最小示例(仅用于审核,不含任何攻击内容):
import requests

OLLAMA = "http://127.0.0.1:11434/api/chat"

def guard(model, messages):
    r = requests.post(OLLAMA, json={
        "model": model, "messages": messages,
        "stream": False, "options": {"temperature": 0}}, timeout=60)
    r.raise_for_status()
    return r.json()["message"]["content"].strip()

def parse_llama_guard(text):
    lines = [l.strip() for l in text.splitlines() if l.strip()]
    safe = bool(lines) and lines[0].lower() == "safe"
    cats = lines[1].split(",") if (not safe and len(lines) > 1) else []
    return safe, [c.strip() for c in cats]
把它们串成“三明治”流程(对应图 1):
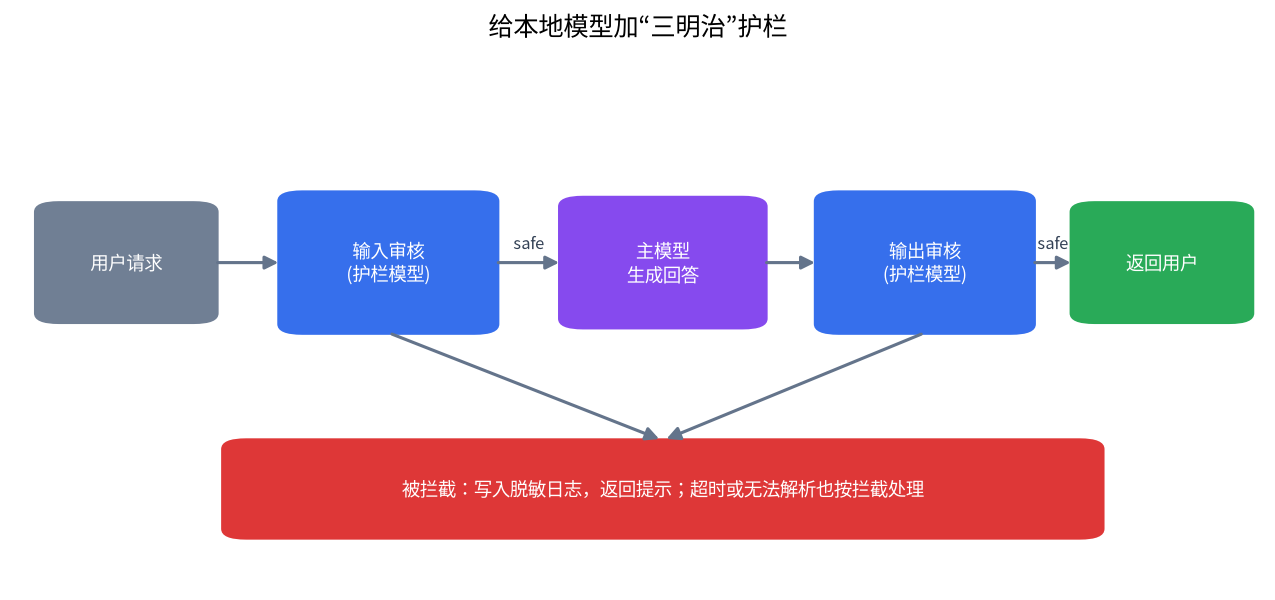
def chat_with_guard(user_text, main_model, guard_model="llama-guard3:1b"):
    # 1. 输入审核
    safe, cats = parse_llama_guard(
        guard(guard_model, [{"role": "user", "content": user_text}]))
    if not safe:
        log_blocked("input", user_text, cats)      # 留痕,注意隐私合规
        return "这个请求无法处理。"
    # 2. 主模型生成
    answer = guard(main_model, [{"role": "user", "content": user_text}])
    # 3. 输出审核
    safe, cats = parse_llama_guard(guard(guard_model, [
        {"role": "user", "content": user_text},
        {"role": "assistant", "content": answer}]))
    if not safe:
        log_blocked("output", answer, cats)
        return "回答被安全策略拦截。"
    return answer
有三点工程细节:
- 失败时默认拦截(fail closed): 如果护栏接口超时或返回无法解析,应当拦下,而不是放行。
- 温度设为 0: 审核要尽量确定。
- 日志要脱敏并限定保留时间: 记录被拦截的内容有隐私风险,见 本地大模型与隐私。
如果你的服务通过接口对外提供,可以把这段逻辑放在网关里,参考 本地 API 服务器指南。
Qwen3Guard 和 ShieldGemma 的输出怎么处理
Qwen3Guard 的 Gen 变体输出是几行文本,大意是“Safety: 级别”“Categories: 类别”,对回答还可能有“Refusal”字段,格式以模型卡为准。处理方式同样是解析第一行的级别:
import re
def parse_qwen3guard(text):
    m = re.search(r"Safety:\s*(Safe|Controversial|Unsafe)", text, re.I)
    level = m.group(1).lower() if m else "unknown"
    return level      # unknown 也按拦截处理
对 controversial,建议转人工或降级处理,而不是直接放行。ShieldGemma 则需要把你的政策文本放进提示里,让它判断“是否违反该政策”,以官方示例格式为准。gpt-oss-safeguard 与之类似,政策作为输入,更适合政策复杂、经常变动的场景,但它的体积和延迟更大。
显存与延迟预算
护栏通常和主模型放在同一台机器上,所以要把它们的权重加起来,再留出缓存和运行时开销。
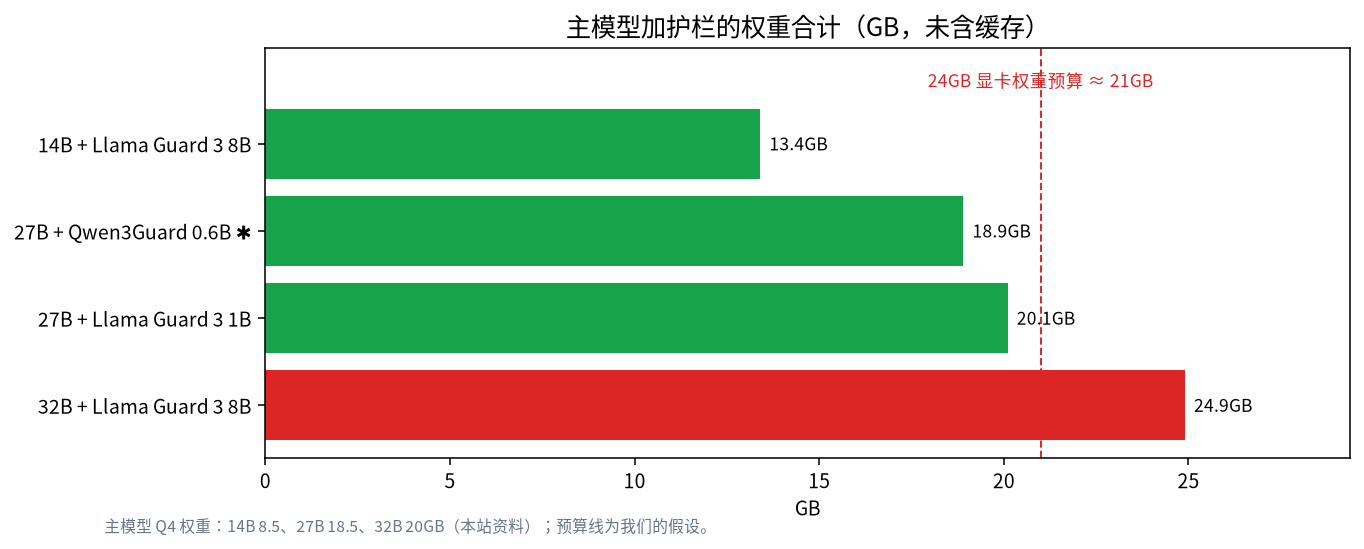
| 组合 | 主模型 Q4 权重 | 护栏权重 | 合计 | 能否放进 24GB(权重预算约 21GB) |
|---|---|---|---|---|
| 14B 主模型 + Llama Guard 3 8B | 约 8.5GB | 约 4.9GB | 约 13.4GB | 可以,还有余量给长上下文 |
| 27B 主模型 + Llama Guard 3 1B | 约 18.5GB | 约 1.6GB | 约 20.1GB | 可以,但上下文要克制 |
| 27B 主模型 + Qwen3Guard 0.6B | 约 18.5GB | 约 0.4GB ✱ | 约 18.9GB | 可以 |
| 32B 主模型 + Llama Guard 3 8B | 约 20GB | 约 4.9GB | 约 24.9GB | 放不下,护栏改放 CPU 或换小模型 |
算式示例:27B Q4 约 18.5GB,加 Llama Guard 3 1B 的 1.6GB,权重合计 20.1GB,低于 21GB 的预算(预算的来由见 24GB 显存能跑什么);但这还没算 KV 缓存,所以上下文长度需要控制。如果显存不够,可以把护栏放在 CPU 上运行:1B 到 4B 的护栏在 CPU 上通常也可用,代价是延迟增加。
延迟方面,护栏主要是“预填充”:把输入读一遍再输出几个 token。预填充的计算量约为 2 × 参数量 × 输入 token 数:8B 护栏处理 500 个 token 约 2 × 8×10^9 × 500 = 8×10^12 次浮点运算,如果我们假设有效算力约 30 TFLOPS,大约需要 0.27 秒(假设值,请实测)。输入和输出各审核一次,就是两次这样的开销。把护栏放在 1B 规格上,开销约降到八分之一。
评估:误拦与漏拦
部署之后必须评估,不要直接相信模型自己宣称的准确率:
- 准备两组数据:一组是你的业务里正常会出现的请求(用于测误拦),一组是你的政策要求拦截的类别的公开评测样本(用于测漏拦,使用 HarmBench 等公开基准,在隔离环境进行);
- 记录误拦率与漏拦率,并按类别拆分;
- 调整阈值或换规格,再对比;
- 每次更新护栏或主模型后重跑。
注意:护栏对中文、对行业黑话、对长文本的表现可能和英文基准差别很大;一个在英文测试里表现很好的护栏,到你的业务里可能误拦很多。具体的红队方法见 本地模型红队测试入门。
按场景给出的选型建议
| 场景 | 建议组合 | 理由 |
|---|---|---|
| 个人或家庭使用,只想多一道提醒 | Llama Guard 3 1B,放 CPU | 体积小,不占显卡 |
| 团队内部中文助手 | Qwen3Guard 4B,评估后再定 | 多语言覆盖,三级标签便于人工复核 |
| 对外聊天机器人,政策明确 | ShieldGemma 9B 或 Llama Guard 3 8B,输入输出各审一次 | 判断更细,延迟可接受 |
| 政策常变、合规要求高 | gpt-oss-safeguard,预算允许时使用 | 政策可随请求传入,并带推理说明 |
| 需要审核图片 | Llama Guard 4 | 支持图文输入 |
选型时记住三个原则:第一,先小后大,先用 1B 到 4B 规格上线,拿到误拦数据后再决定要不要升级;第二,输入和输出分开评估,两者的误判特点不同;第三,留出人工通道,护栏判不准的请求要有地方申诉和复核,否则误拦会直接影响用户体验。部署之后,每次更换护栏或主模型都要重跑评估,并把版本号和评估结果记录下来,方便出问题时回溯。
护栏的边界:它不能做什么
- 不能替代权限控制: 对带工具的应用,护栏拦不住所有注入,必须配合最小权限。
- 不能保证合规: 分类结果是技术判断,不是法律结论;涉及合规请咨询专业人员。
- 不是零成本: 它会增加延迟、占用显存,还可能误拦正常请求。
- 自己也会被攻击: 护栏本身也是模型,也有被绕过的可能,因此要分层、要持续测试,见 越狱防御怎么做。
常见问题 FAQ
Llama Guard 本地部署最少要多少显存?
llama-guard3:1b 约 1.6GB,可以在小显存甚至 CPU 上运行;8B 版本约 4.9GB。
Qwen3Guard 和 Llama Guard 哪个更适合中文?
Qwen3Guard 官方说明覆盖 119 种语言,中文是重点之一,我们没有对比测试;建议在你自己的中文数据上同时评估。
护栏能防住所有越狱吗?
不能。护栏是其中一层,要配合对齐训练、权限控制、监控和红队测试。
护栏会拖慢速度吗?
会。输入和输出各审核一次,开销取决于护栏规格和文本长度;1B 到 4B 规格通常比 8B 以上更适合在线服务。
护栏输出“有争议”怎么办?
Qwen3Guard 的三级标签允许你把“有争议”转人工复核或降级处理,而不是直接放行或拦截。
护栏可以自定义政策吗?
ShieldGemma 和 gpt-oss-safeguard 支持在输入中给出政策文本;Llama Guard 3 的类别以官方分类为主,是否能自定义请看模型卡。
和我们聊聊
如果你想给自己的本地模型加护栏,欢迎把部署方式、预算和语言场景发到社区,或邮件 admin@microaione.com,我们帮你选规格并估算显存。更多相关文章见大模型越狱与安全专题。
参考资料:Llama Guard 论文(arXiv 2312.06674)、Ollama Llama Guard 3 页面、Ollama ShieldGemma 页面、Qwen3Guard 官方仓库、OpenAI gpt-oss-safeguard 发布页。数据读取于 2026-11-04,北京时间。