Qwen 本地部署需要破甲吗?先判断你遇到的是哪种“拒答”,再决定怎么办
在本地用 Ollama 或 llama.cpp 跑起 Qwen 之后,很多人会冒出同一个问题:Qwen 本地部署需要破甲吗?这个问题背后其实是三个不同的问题:模型为什么拒绝回答我?是我部署错了,还是它真的不想回答?我的需求是正当的,应该怎么办?这篇文章的结论先放在前面:对绝大多数本地部署的正当用途,答案是“不需要”,你该做的是先排查模板、量化、上下文和系统提示,再评估是否需要换模型或加护栏。需要先说明本站的做法:我们不提供越狱提示词,也不提供规避安全限制的步骤,只讲判断方法、合规的解决办法和风险。如果你想先了解越狱、破甲、无审查版这些词的区别,请先读大模型越狱、破甲、破解是什么。
要点速览(更新于 2026-11-04)
- 本地跑 Qwen 时,限制只来自权重里的对齐训练和你自己设置的系统提示;没有在线产品常有的输入输出过滤层。
看起来像“拒答”的现象,不少其实是聊天模板不对、量化过狠、上下文被截断或思考模式设置不当,先排查这些,不需要破甲。
真正的“过度拒答”(无害任务被拒)有合规的处理办法:换更合适的型号、交代清楚任务背景、调整你自己产品里的系统提示。
社区的“无审查版”要自己承担质量下降和供应链风险,并且去掉的是保护层,不会替你判断合法性。
想判断自己的模型到底拒了多少,就做一个 50 条的小评测,下文给出方法。
先回答:Qwen 本地部署需要破甲吗
分三种情况:
| 你的情况 | 需要破甲吗 | 更合适的做法 |
|---|---|---|
| 模型回答很短、答非所问、突然中断,像“拒答”但没有任何拒绝措辞 | 不需要 | 先查聊天模板、量化、上下文长度、采样参数 |
| 模型把无害任务当成危险任务拒绝,例如安全教育、医疗常识、虚构写作的普通情节 | 不需要 | 交代任务背景,换型号,调整你自己产品的系统提示,必要时加评测 |
| 请求本身涉及违法或可能伤害他人的内容 | 不应该 | 这是模型应该拒绝的场景,本站不提供绕过办法 |
也就是说,“需不需要破甲”这个问法本身常常问错了对象。你真正要问的是:这次拒答是哪一层造成的?
本地部署里,限制来自哪里
回看上一篇讲过的五层结构:预训练数据、指令微调、对齐训练、系统提示、输入输出过滤。本地部署 Qwen 时,你得到的是前三层(写进权重里了),第四层由你自己决定,第五层默认不存在,除非你自己加。这有两个后果:
第一,本地的 Qwen 并不是“没有任何限制”,它仍然是经过对齐训练的聊天模型,面对明显有害的请求会拒绝,对一些话题的回答也可能偏保守。我们没有系统测试 Qwen 的拒答边界,所以不给具体比例;你可以用后文的方法在自己的任务上测一遍。
第二,本地的 Qwen 也没有在线产品那样的外层过滤,所以你要自己决定要不要加护栏,例如 Llama Guard 与 Qwen3Guard。如果你把模型提供给别人使用,这一步尤其重要。
先排查:这真的是“拒答”吗?
下面这张图是我们建议的排查顺序。
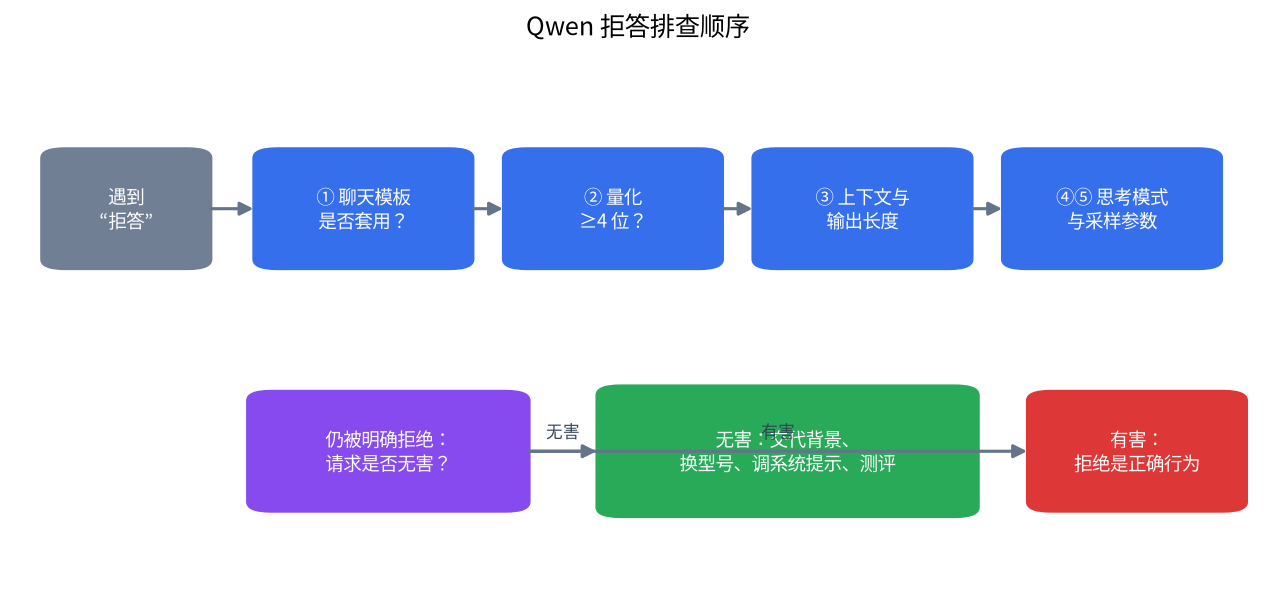
1. 聊天模板。 用 llama.cpp 或某些前端手工拼提示词时,如果没有套用模型自带的聊天模板,模型可能表现得很奇怪:答非所问、反复输出特殊标记、过早结束。用 Ollama 拉取的模型通常自带模板,一般不会出这个问题;自己转换 GGUF 时要检查模板是否一并写入。具体安装步骤见 Ollama 安装指南。
2. 量化。 过低的量化位数会让模型变“笨”,表现为答非所问或胡乱重复。Q4_K_M 通常是体积与质量的折中,详见 量化 Q4_K_M 解读。如果你为了塞进显存用了 2 到 3 位的量化,先换回 4 位再下结论。
3. 上下文和输出长度。 如果上下文设得太小,提示被截断,模型可能没看到你的任务描述;如果最大输出 tokens 设得太小,回答会在一半处结束。
4. 思考模式。 新一代 Qwen 常带有思考模式的开关,打开后模型会先输出一大段推理,关闭后直接回答。不同版本的开关方式不同,请以模型卡为准;设置不当时,输出可能被推理内容占满。
5. 采样参数。 温度过高或过低、重复惩罚设置不当,也会让输出看上去“不对劲”。优先使用官方模型卡推荐的参数。
排查完这五项再看:如果模型确实用明确的措辞拒绝了你的无害请求,才算是“过度拒答”。
真正的过度拒答,怎么合规地处理
交代背景。 对齐训练让模型对“看起来危险”的请求很敏感。把真实用途写清楚(例如“我在为企业安全培训写一份识别钓鱼邮件的讲义”)通常比一句话指令更容易得到有用回答。这并不是绕过限制,而是提供模型做判断所需的信息;如果请求确实超出安全边界,模型依然会拒绝,这是正确的行为。
换型号。 不同规模、不同代的 Qwen 在拒答倾向上可能不同。我们在 Qwen 本地部署教程里列过各型号的体积;这里把本站读取的几个量化版体积放在下面,方便你在显存范围内试几个型号。
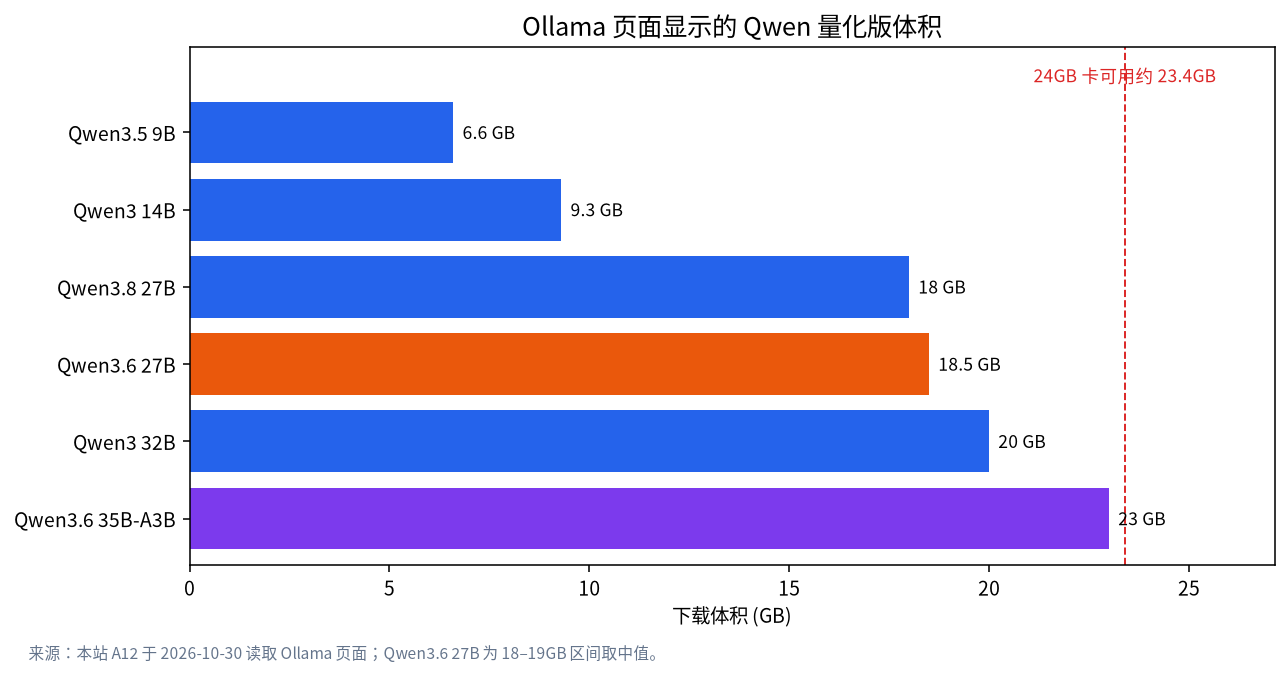
这些体积来自我们 2026-10-30 读取的 Ollama 页面,是量化版文件大小,实际占用还要加上上下文缓存;怎么估算见 模型大小怎么选。
调整你自己产品里的系统提示。 如果你在为自己的合法产品部署 Qwen,可以在系统提示里定义明确的角色和任务范围(例如“你是企业内部的网络安全培训助手”)。这是正当的产品设计,而不是越狱,它的作用是让模型更好地理解任务。
在上层加护栏,而不是拆掉模型的护栏。 如果你担心的是“模型回答得不够开放”,更稳妥的方向是保持模型自带对齐,同时用外部分类器来按你自己的政策做审核,让规则可控、可记录。
五种做法对比
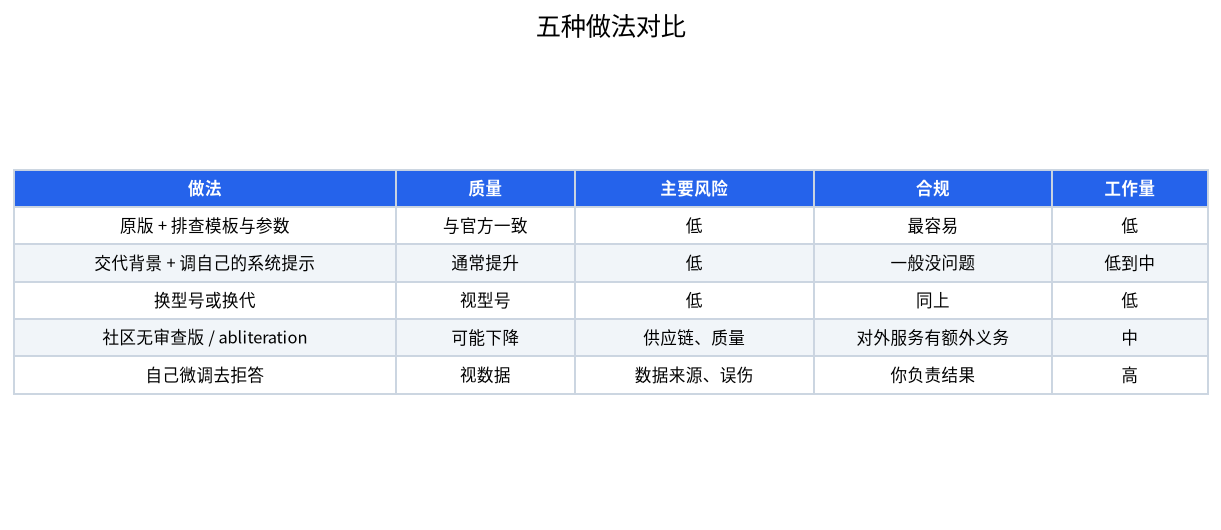
| 做法 | 回答质量 | 主要风险 | 合规 | 工作量 |
|---|---|---|---|---|
| 原版 Instruct 模型 + 排查模板与参数 | 与官方一致 | 低 | 最容易 | 低 |
| 交代背景 + 调整自己产品的系统提示 | 通常提升 | 低 | 取决于用途,一般没问题 | 低到中 |
| 换型号或换代 | 取决于型号 | 低 | 同上 | 低 |
| 社区“无审查版”或 abliteration 版 | 可能下降,需自测 | 供应链、质量、幻觉 | 把它做成对外服务有额外义务 | 中,需要审查来源 |
| 自己微调去掉拒答 | 取决于数据与方法 | 数据来源、误伤 | 同上,且你要为结果负责 | 高 |
最后两行是“改权重”的路线。我们在 拒绝方向消融原理详解里讲过它的原理:它是一种研究上成立的做法,但并不会让模型“更聪明”,也不替你判断合规。
一个 50 条的小评测:量化你的“过度拒答”
与其凭感觉,不如测一下。步骤如下:
- 写 50 条你的业务真实会遇到的、无害的任务提示,覆盖你担心被误拒的类型。
- 用同一套参数各跑一遍:原版配置、加了背景说明的配置、换了型号的配置。
- 人工判断每条是否被拒,记录拒答条数。
- 比较拒答率,例如原版 12 条被拒,拒答率是 12 ÷ 50 = 24%;调整系统提示后降到 4 条,就是 8%。
注意:50 条是很小的样本,两次结果相差几个百分点可能只是波动,不要过度解读。如果你想要更严谨的比较,把样本加到 200 条以上,并像我们在 本地模型红队测试里讲的那样给出置信区间。另外,这个评测只测“无害任务的误拒”,不应该用来测试如何诱导模型输出有害内容。
求助之前先记录这五件事
无法复现的拒答也就无法诊断。只要你怀疑是过度拒答,就先记下五项:模型的确切标签和量化版本、运行时及其版本、实际使用的完整聊天模板或系统提示、采样参数、回答的前 200 个字符。有了这五项,多数“拒答”几分钟内就能定位为配置问题,真正的拒答也可以在不同型号之间公平比较。把无害的测试提示存成一个纯文本文件,每次调整后重跑;无法重跑的回归,只会变成争论而不是修复。
风险提醒:社区“破甲版”别乱下
- 供应链风险: pickle 格式权重可以在加载时执行代码,Hugging Face 对此有专门说明;优先使用 safetensors 或 GGUF,并检查发布者与哈希。
- 质量风险: 改权重可能连带损失能力,上线前必须自测。
- 合规风险: 在中国大陆,把模型作为服务提供给公众需要遵守《生成式人工智能服务管理暂行办法》等规定,办法第四条要求不得生成法律禁止的内容。以上是一般信息,不是法律意见。
- 隐私: 本地部署的好处是数据不出本机,这一点在 本地大模型与隐私里讲过;不要因为想要“更开放”而把数据交给来路不明的在线“破解服务”。
关于 Qwen 本身的许可与最新型号,请以 QwenLM 官方 GitHub 和模型卡为准;我们在官方 README 里看到 Qwen3.8 标注为 Apache 2.0,其他型号请逐个核对。
常见问题 FAQ
千问本地部署怎么解除限制模式?
「千问本地部署怎么解除限制模式」这类问题,多数时候把对齐训练、错误的聊天模板和真正的安全过滤混在一起了。正当用途请先排查模板、量化与系统提示;本站不提供越狱提示词,也不提供绕过安全限制的步骤。完整判断流程见正文。
Qwen 本地部署需要破甲吗?
对绝大多数正当用途不需要。先排查聊天模板、量化、上下文和思考模式设置;如果确实是对无害任务的过度拒答,可以交代背景、换型号或调整自己产品的系统提示。
Qwen 本地部署后为什么有时不回答我的问题?
可能原因包括模板错误、量化过低、上下文被截断、输出长度限制,也可能是模型认为请求有风险。先逐项排查,再判断是不是真的被拒。
有没有现成的 Qwen 无审查版?
社区确实有人发布改版,但质量和来源参差不齐,需要自己审查并承担风险;本站不提供下载链接,也不推荐具体版本。
我想让 Qwen 更“开放”,有什么稳妥的做法?
保留模型自带对齐,在你自己的合法产品里设置清晰的角色,再用外部审核模型按你自己的政策把关。这样既可控,也方便记录。
本地部署的 Qwen 需要加安全护栏吗?
如果只给自己用,可以不加;如果提供给其他人或接入业务,建议加上输入输出审核,见我们的 本地护栏教程。
怎么判断我的 Qwen 被误拒得多不多?
做一个 50 条以上的小评测,记录无害任务的拒答率,对比不同配置。注意样本小时差异可能只是波动。
和我们聊聊
如果你在部署 Qwen 时遇到了拒答或输出异常,欢迎把型号、量化版本和运行命令(不含密钥)发到社区,或邮件 admin@microaione.com,我们帮你判断问题出在哪一层。想系统了解这个主题,可以看我们的大模型越狱与安全专题。
参考资料:QwenLM GitHub、Ollama Qwen3 页面、Hugging Face pickle 安全说明、生成式人工智能服务管理暂行办法。数据读取于 2026-10-30 至 2026-11-04,北京时间。