14T 参数 MoE 要什么硬件?从 numbat 拆解 GDN+MLA、NVFP4 与 MTP,以及如何识别“泄露模型”骗局与法律风险
上一篇我们核查了 Hugging Face 上的 burner22/numbat 仓库(Anthropic Mythos 权重泄露核查),结论是多项证据指向伪造。但这个仓库还有一个很好的教学价值:它的配置文件完整描述了一个 14T 参数 MoE 的结构,把“万亿级模型到底长什么样、要多少硬件”摆在了桌面上。这篇文章不讨论它是不是真的,而是借它回答三个问题:一个 14T 参数 MoE 的各个部件(GDN+MLA 混合注意力、1,224 专家路由、MTP、NVFP4)分别是什么;装下它需要多少设备,为什么个人电脑不可能运行;以及面对下一个“泄露模型”时,怎么识别假货、避开恶意代码和法律风险。我们没有下载任何权重,也没有运行任何代码;数字来自仓库的 config.json、Hugging Face 的元数据、厂商公开规格,以及我们自己的算术,并逐条标明。
要点速览(更新于 2026-11-02)
- 按 numbat 的配置,总参数约 13.7T,每个 token 激活约 0.6T(我们的粗估),占总量约 4.4%,和 DeepSeek-V3(37B/671B)、Kimi K2(32B/约 1.04T)的稀疏程度在同一量级。
NVFP4 下每个权重约 4.5 位,7.72TB 仅仅是“把权重放下”:需要 55 张 H200 或 42 张 GB200 NVL72 里的 GPU,用 RTX 4090 则要 322 张。
就算把专家放在 NVMe 固态硬盘上,按我们的下限估算,生成一个 token 也要读取约 337GB,单盘 14GB/s 时每个 token 约 24 秒;而更小的 DeepSeek V4.1 Flash 能做到每秒几个 token,是因为它每个 token 只激活很少的专家。
识别假“泄露模型”:看来历、看体积是否自洽但不能只看体积、看权重统计、看自述是否矛盾、看是否要求 trust_remote_code、看文件格式是 safetensors 还是 pickle。
风险有两层:技术上,pickle 与远程代码可以在加载时执行任意代码;法律上,真泄露可能涉及商业秘密与版权。以上是一般信息,不是法律意见。
14T 参数 MoE 到底有多大:和已知模型对比
“混合专家”(MoE)模型把前馈层拆成许多个“专家”,每个 token 只路由到其中几个,所以总参数很大但每个 token 的计算量只相当于较小的模型。如果你对 MoE 的基本概念还不熟,可以先看我们的 MoE 模型本地部署。下面把 numbat 配置里的数字和几个公开模型放在一起(numbat 一栏是仓库配置的声称,不代表它是真模型):
| 模型 | 总参数 | 每 token 激活 | 路由专家数 | 每 token 激活专家 | 激活占比 |
|---|---|---|---|---|---|
| DeepSeek-V3 | 671B | 37B | 256 + 1 共享 | 8 | 约 5.5% |
| Kimi K2 | 约 1.04T | 32B | 384 + 1 共享 | 8 | 约 3.1% |
| Qwen3-Next-80B-A3B | 80B | 约 3B | 512 + 1 共享 | 10 | 约 3.75% |
| DeepSeek V4.1 Flash(本站先前文章) | 约 763B | 本站未核实 | 每层 384 | 6 | 未列 |
| numbat(仓库声称) | 约 13.7T | 约 0.6T(我们按配置粗估) | 1,224 + 1 共享 | 48 | 约 4.4% |
DeepSeek-V3、Kimi K2 的数字来自它们的技术报告(DeepSeek-V3、Kimi K2),Qwen3-Next 的数字来自 NVIDIA 技术博客。可以看到,numbat 的稀疏程度并不异常:激活占比在已知模型的范围内。真正惊人的是绝对规模,每个 token 激活的参数(约 0.6T)已经接近 DeepSeek-V3 的总参数(671B)。你可以对照我们对 DeepSeek V4.1 Flash 本地部署的计算:那个模型的 BF16 权重约 1.5TB 就已经需要多卡服务器,而 numbat 的参数量约是它的 18 倍。
架构拆解:GDN+MLA、MoE 路由、MTP 与 NVFP4
下表把 config.json 中的字段与公开的先例对应起来。“公开先例”一栏的意思是:这些技术都已经在公开论文或开源模型里出现过,所以仅凭“配置合理”不能证明模型的来历。
| 部件 | numbat 配置的值 | 公开先例 | 作用 |
|---|---|---|---|
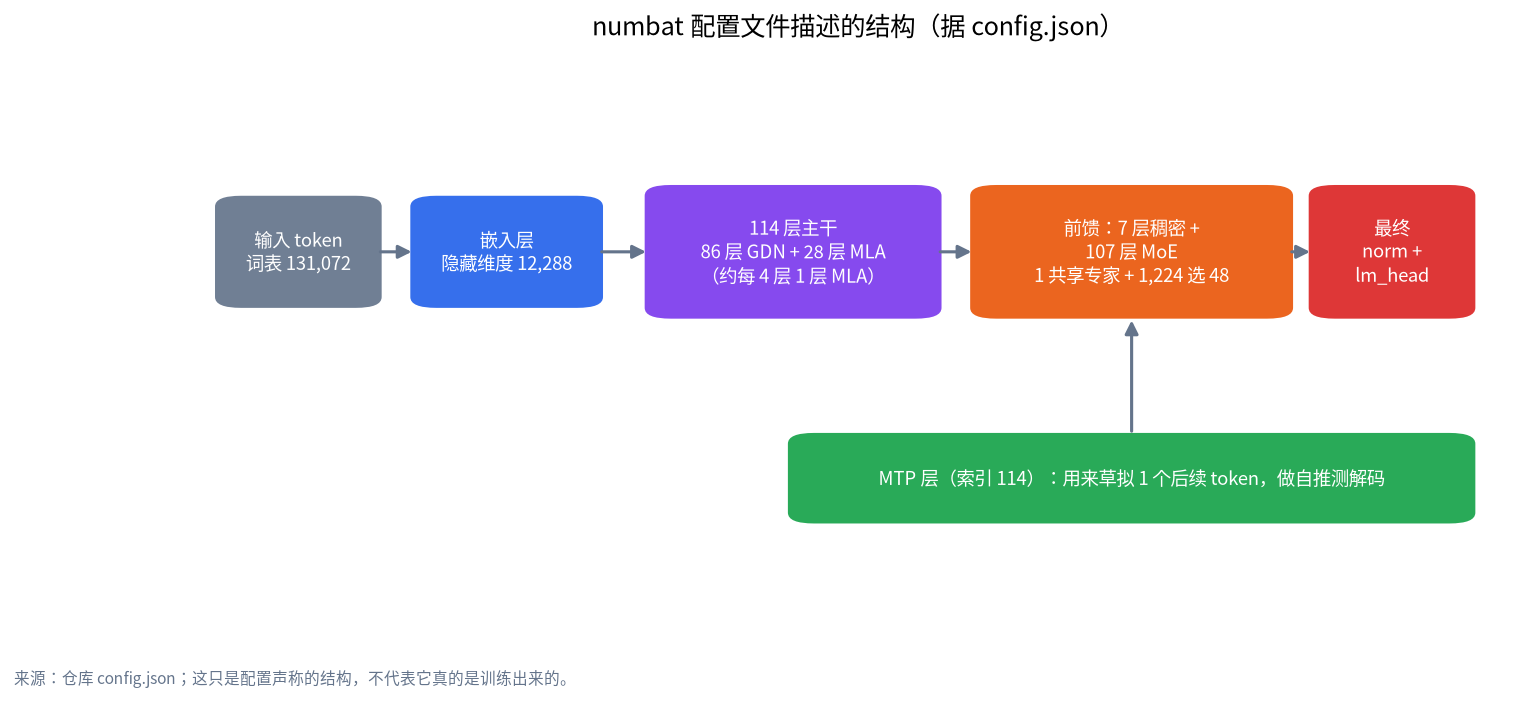
| 混合注意力 | 114 层中 86 层 GDN、28 层 MLA(第 3、7、11… 层,每 4 层 1 层) | Gated DeltaNet 论文;Qwen3-Next 采用 3:1 的 GDN 与完整注意力 | 用线性注意力降低长上下文成本,再靠少量完整注意力保精度 |
| MLA | 96 头,KV 压缩秩 512,RoPE 维度 64 | DeepSeek-V2 提出的多头潜在注意力 | 把 KV 缓存压成低维潜向量 |
| MoE 路由 | 1,224 个路由专家 + 1 个共享,选 48;72 组、每次限 8 组;sigmoid 打分;带校正偏置 | DeepSeek-V3 的分组限制路由与无辅助损失均衡 | 控制通信,保证专家负载均衡 |
| MTP | 深度 1,训练损失权重 0.1,推理时作自推测草稿 | DeepSeek-V3 的多 token 预测 | 一次多草拟一个 token,加速解码 |
| 量化 | NVFP4:4 位 E2M1 数值,每 16 个共用 FP8 缩放,外加 FP32 全局缩放 | NVIDIA Blackwell 的 NVFP4 格式 | 把权重压到约 4.5 位 |
GDN 与 MLA:长上下文为什么变便宜
Gated DeltaNet(论文)是一种带门控的线性注意力:它不像标准注意力那样让缓存随上下文变长,而是维护一个固定大小的状态。numbat 的 GDN 层配置为 48 个头、键维度 128、值维度 256,状态用 FP32 保存。按我们的算术,每层状态约 6.3MB,86 层约 541MB,且不随上下文增长。MLA 层则把每个 token 的键值压成 512 + 64 个数值,28 层共 16,128 个数值;若用 BF16 保存,每个 token 约 32KB,131,072 的上下文约 4.2GB。这是“每条序列”的开销,所以长上下文在这个结构下比传统注意力便宜得多,但这些数字是我们在 BF16 缓存和 FP32 状态的假设下从配置推算的,未计入卷积状态和 MTP 层的开销。想了解上下文和缓存如何占显存,可以看 上下文长度与 KV 缓存显存。
MoE 路由、MTP 与 NVFP4
配置里的路由细节几乎是 DeepSeek-V3 方案的放大版:分组限制路由(1,224 个专家分成 72 组,每组 17 个,每次只在 8 个组里选 48 个)、sigmoid 打分、用校正偏置而不是辅助损失来均衡负载,配置还写明在训练到 98% 的 token 时冻结校正偏置。MTP 在 DeepSeek-V3 中既是训练目标也能做推测解码;numbat 的配置里只有一层,深度为 1。NVFP4 则是 NVIDIA 为 Blackwell 设计的 4 位浮点格式(NVIDIA 介绍):每个权重 4 位,每 16 个权重共享一个 8 位缩放,所以实际约 4.5 位。量化配置还把嵌入层、输出层、路由门、归一化层、前 2 层、末尾 5 个稠密层和 MTP 层排除在 NVFP4 之外(保持高精度),这是量化时常见的做法。
硬件账:7.72TB 到底要多少设备
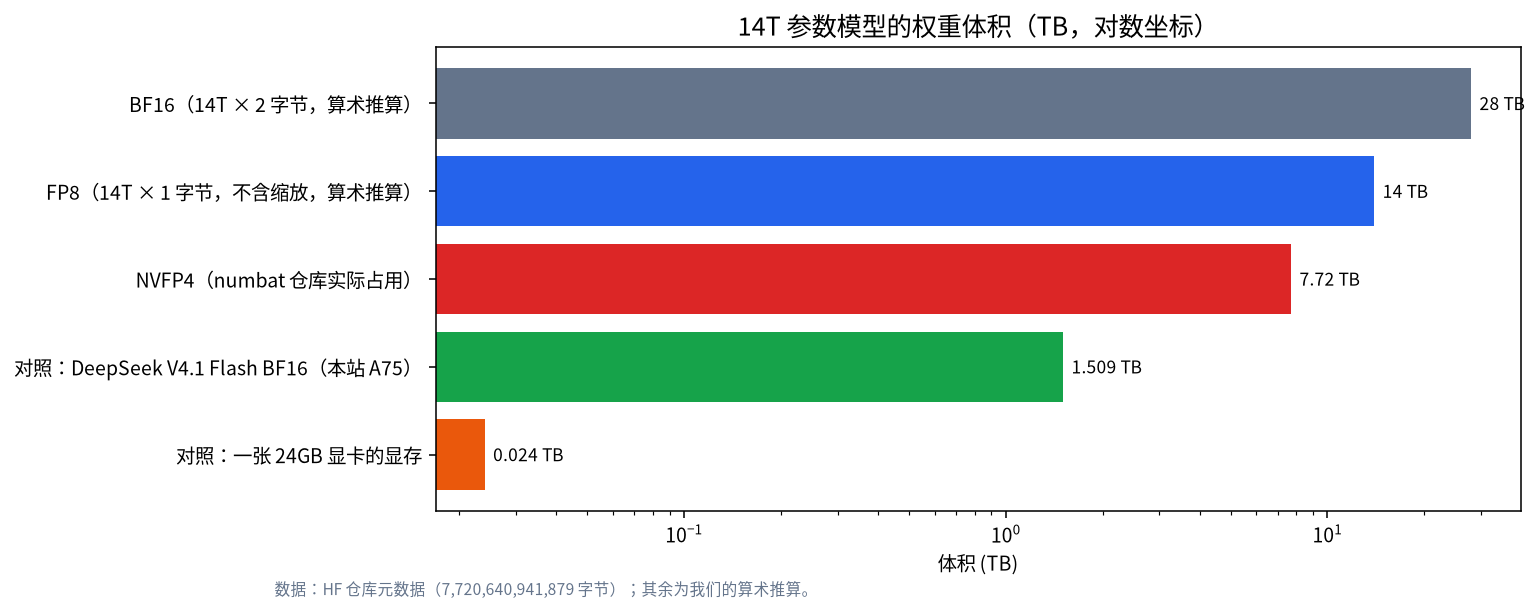
权重体积是第一堵墙。14T 参数在 BF16 下约 28TB,FP8 下约 14TB,NVFP4 下仓库实际占用约 7.72TB。下面是仅仅把权重装下需要的卡数,不含 KV 缓存、激活和运行时开销:
| 设备 | 单卡内存 | 仅装下 7.72TB 所需数量 | 备注 |
|---|---|---|---|
| RTX 4090 | 24GB | 322 张 | 消费卡,无高速互联 |
| RTX 5090 | 32GB | 242 张 | 同上 |
| H100 | 80GB | 97 张 | 约 12 个 8 卡节点 |
| AWS Trainium2 | 96GiB | 75 块 | AWS 文档 |
| H200 | 141GB | 55 张 | 约 7 个 8 卡节点 |
| GB200 NVL72 | 每 GPU 186GB | 42 张 | 一个机架共 72 个 GPU,约 13.4TB HBM3e |
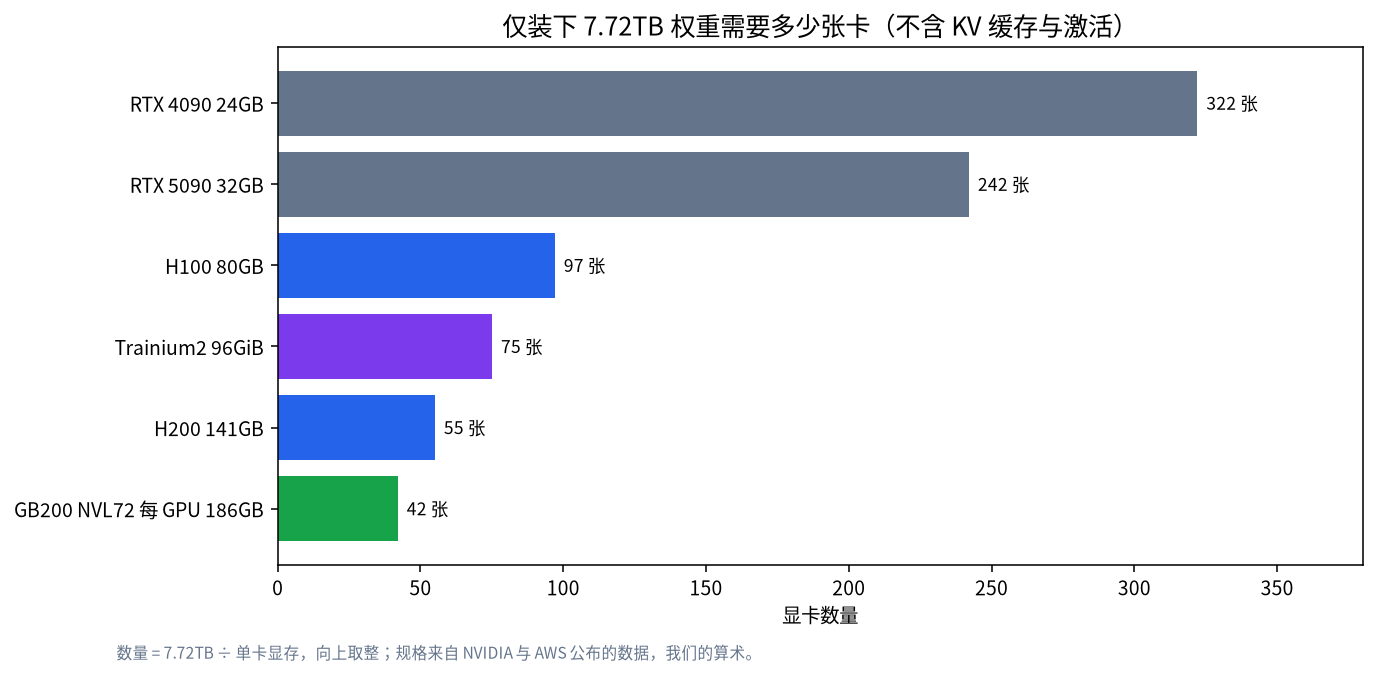
数据来自 NVIDIA 对 GB200 NVL72 的公开规格与 AWS Neuron 文档,数量是我们的算术。可以看到,要想让这个模型“跑起来”,现实的单位是一整个 GB200 NVL72 机架:约 13.4TB 的 HBM3e 装下 7.72TB 权重后,只剩约 5.7TB 给缓存与激活。这不是个人或小团队能碰的规模。
那么能不能像小模型那样把专家放在 SSD 上流式读取?我们在12GB 显存跑 DeepSeek V4.1 Flash 的 SSD 流式加载分析里讲过,这种方法有效是因为那个模型每个 token 只激活 6 个专家。numbat 每个 token 要激活 48 个专家,我们估算每个 token 需要读取的权重约为 0.6T × 0.5625 字节 ≈ 337GB。在批大小为 1、每个 token 都完整读一遍激活权重、不考虑缓存和预取重叠的下限假设下:
| 存储层 | 假设带宽 | 每 token 读取时间(下限) |
|---|---|---|
| NVMe Gen4 固态硬盘 | 约 7GB/s | 约 48 秒 |
| NVMe Gen5 固态硬盘 | 约 14GB/s | 约 24 秒 |
| 双通道 DDR5 内存(需要 7.7TB 内存) | 约 90GB/s | 约 3.7 秒 |
| GB200 NVL72 机架聚合显存带宽 | 576TB/s(NVIDIA 规格) | 约 0.6 毫秒(理论值) |
前三行的带宽是我们设定的典型值,不是实测,仅用来说明数量级;最后一行是 NVIDIA 公布的聚合带宽,实际受互联和批大小影响。结论很直接:在任何个人设备上,这个模型生成一句话要几十分钟甚至更久。想系统理解内存和显存的取舍,参考 内存与显存、CPU 卸载 和 GPU 显存选购指南。
为什么它不可能在本地运行
除了体积,还有两层原因。第一是运行时:numbat 不是任何主流推理框架内置的架构,仓库要求用 trust_remote_code=True 加载它自带的实现;讨论 #11 的作者评论说这份参考实现没有 KV 缓存、按 token 和专家循环、每次调用都反量化全部权重、默认单设备,所以不能用于真实推理(这是评论者的说法,我们没有运行它)。第二是格式:NVFP4 的高速路径依赖 Blackwell 硬件上的原生支持,消费级旧显卡无法获得同样的速度。把这几条合起来,即使有人真的拥有这 7.72TB,也没有现成的、可在个人设备上运行的路径。
识别“泄露模型”:八个检查点
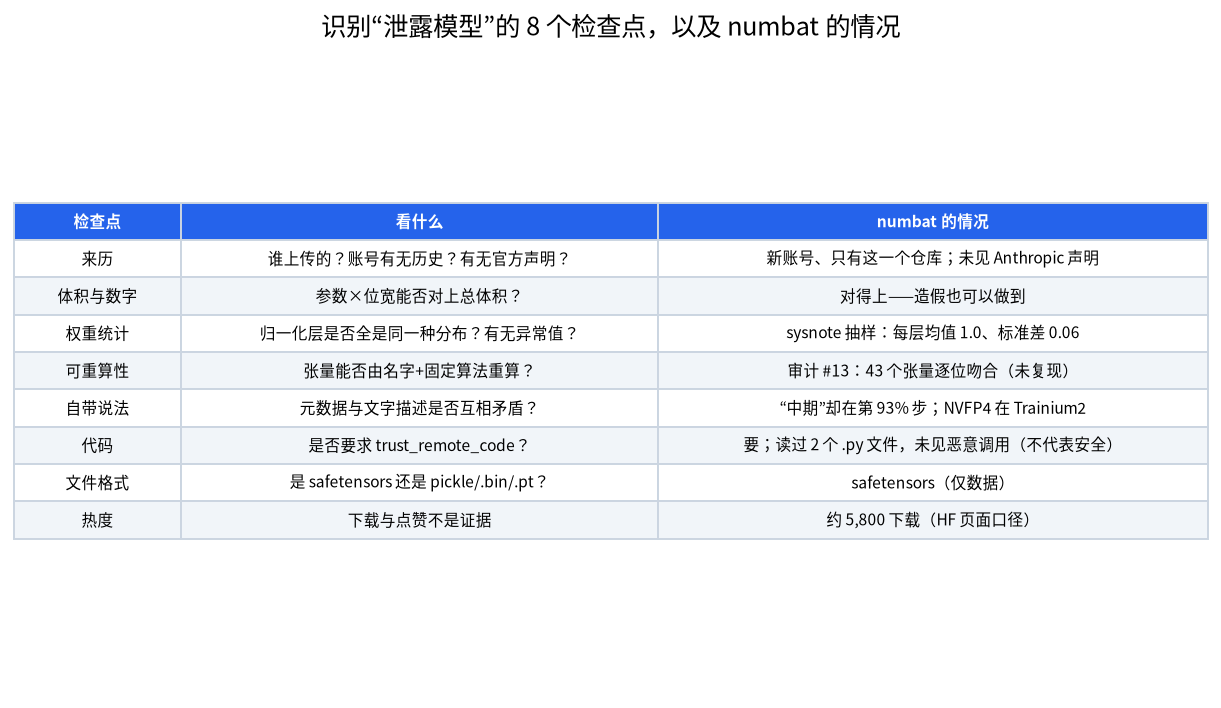
下一次再看到“某大厂权重泄露”,可以按下面的清单核对。清单里的 numbat 一栏来自我们上一篇的核查。
| 检查点 | 看什么 | 经验法则 |
|---|---|---|
| 来历 | 上传者是谁、账号有无历史、有无官方声明 | 新账号加“不要私信我问来源”是警示信号 |
| 体积与数字 | 参数 × 位宽能否对上总体积 | 对得上是必要条件,不是充分条件 |
| 权重统计 | 归一化层是否各层完全一样、有无异常值 | 真实训练出的网络不会各层都像同一个钟形曲线 |
| 可重算性 | 张量能否由名字等简单规则重新生成 | 能重算就是生成的,不是训练的 |
| 自述矛盾 | 元数据与文字是否自相矛盾 | “中期”却在 93% 步,是典型例子 |
| 代码 | 是否强制 trust_remote_code | 强制就要先读代码,在隔离环境里处理 |
| 文件格式 | safetensors 还是 pickle/.bin/.pt | pickle 加载时可能执行代码 |
| 热度 | 下载量、点赞数 | 不是证据,下载数可以被刷或被好奇者推高 |
安全风险:恶意 pickle、远程代码与其他
模型文件的格式决定了加载时会发生什么。
| 机制 | 风险 | 缓解办法 |
|---|---|---|
| pickle 系格式(.bin、.pt、.pkl) | Python 的 pickle 在加载时可以执行任意代码,Hugging Face 的安全文档专门提醒了这一点 | 只用 safetensors;如必须加载 .pt,在新版 PyTorch 中使用 weights_only=True,并在隔离环境中进行 |
| trust_remote_code=True | 仓库自带的 Python 文件会被导入并执行,等价于运行陌生脚本,见 Transformers 文档 | 先用浏览器读代码;用锁定的提交哈希;放进无网络无凭证的虚拟机 |
| README 里的“安装脚本” | 让你执行 curl | bash 或安装来路不明的包 |
| 假“驱动”“加速器”下载链接 | 木马、窃取浏览器登录信息 | 不从模型仓库以外下载可执行文件 |
| 让 AI 代理自动拉取并运行 | 代理会以你的权限执行加载代码 | 不要让代理处理未经审查的仓库 |
safetensors 格式本身只含数据和一个文本头,不会执行代码,这也是它成为主流的原因。需要说明的是:我们读过 numbat 的两个 Python 文件,没有发现恶意调用,但“没发现”不等于“安全”,我们没有审计其它所有文件,仓库也可能随时改动。一个稳妥的检查流程是:第一步,在浏览器里读 README 与 config,不下载任何东西;第二步,用 HTTP 范围请求只读取 safetensors 的文件头和少量张量;第三步,只有在需要时才在一台断网、无凭证、可销毁的虚拟机里加载;第四步,永远不要把这类仓库交给自动化脚本或 AI 代理。关于本地部署中的隐私与数据安全,可以延伸阅读 本地大模型与隐私。
法律与版权风险
如果某个仓库真的是闭源模型的泄露权重,下载、保存和再分发可能带来法律问题。下表只是一般性概览,不是法律意见:
| 地区 | 可能涉及的规则 | 说明 |
|---|---|---|
| 美国 | 《保护商业秘密法》(18 U.S.C. § 1836 提供民事诉讼途径) | 取得或使用明知是被不当获取的商业秘密可能被追责 |
| 中国 | 《反不正当竞争法》第九条;《刑法》第二百一十九条 | 侵犯商业秘密可能承担民事、行政甚至刑事责任 |
| 欧盟 | 商业秘密指令(2016/943) | 成员国据此立法 |
| 版权 | 权重是否受版权保护各地尚不统一 | 配套的代码、文档则明确受版权保护 |
先例方面,BleepingComputer 报道 Anthropic 曾对泄露的 Claude Code 源码镜像发出 DMCA 通知,说明厂商会主动维权。即使仓库最终被证明是伪造,传播所谓“泄露”的链接仍可能让你卷入风险,也可能把别人引向带恶意代码的仓库。我们的做法是不提供任何下载链接或磁力链接,也建议你不要转发。
我们做了什么、没做什么
我们读取了仓库的 config.json 与自定义代码,用公开规格和我们的算术估算了体积、卡数与读取时间,查阅了论文与厂商文档。我们没有下载权重、没有运行代码、没有测试任何硬件。表格里标明“假设”的数字都是数量级估算,不是实测。
常见问题 FAQ
14T 参数的 MoE 模型真的存在吗?
公开资料里我们能引用的最大开源 MoE 是约 1T 的 Kimi K2;numbat 声称的 14T 没有可靠来源证实。我们不能说这个规模在闭源实验室里不存在,只能说我们没有证据。
NVFP4 是什么,为什么能把体积压得这么小?
它是 NVIDIA 为 Blackwell 设计的 4 位浮点格式:每个权重 4 位,每 16 个权重共用一个 8 位缩放,所以约 4.5 位,体积约为 BF16 的 28% 左右。代价是需要对应的硬件与软件支持。
GDN 和 MLA 混合有什么好处?
GDN 用固定大小的状态处理大部分层,MLA 把键值压缩成低维向量,两者结合能显著降低长上下文的缓存开销。这些技术都有公开论文。
我能用 SSD 加内存在个人电脑上跑它吗?
按我们的下限估算,每个 token 要读约 337GB,在 14GB/s 的固态硬盘上约 24 秒一个 token,还没算别的开销,而且你需要先拥有 7.72TB 数据。实际没有意义。
加载陌生模型最大的风险是什么?
执行代码:pickle 格式和 trust_remote_code=True 都会在加载时运行不受信任的代码。只用 safetensors,并在隔离环境里处理。
下载“泄露”的模型违法吗?
取决于它是否真的是被不当获取的商业秘密,以及你所在的地区。这是一般信息,不是法律意见;有需要请咨询律师。我们不提供任何下载链接。
和我们聊聊
想知道你的显卡和内存能跑多大的模型,或者想让我们帮你判断一个新出现的“热门模型”值不值得折腾?欢迎到社区留言,或发邮件到 admin@microaione.com,附上你的配置和用途。
参考资料:DeepSeek-V3 技术报告、Kimi K2 技术报告、Gated DeltaNet、NVIDIA NVFP4 介绍、GB200 NVL72、Hugging Face:pickle 安全。数据读取于 2026-11-02,北京时间。
延伸阅读:模型泄露与破解传闻的核查方法