英特尔显卡跑大模型:Arc B580、B60 与酷睿 Ultra NPU 能做什么(用带宽算速度)
过去本地大模型几乎是英伟达的天下,但 12GB 显存只要 249 美元的 Arc B580、24GB 显存的 Arc Pro B60,以及内置 NPU 的酷睿 Ultra 笔记本,让不少人开始问:英特尔显卡跑大模型到底靠不靠谱?这篇文章只用官方规格页和文档,把英特尔平台拆成三件事来看:显卡能装下什么、软件走哪条路线、NPU 适合干什么。速度部分我们用“带宽 ÷ 模型大小”算出理论上限,告诉你什么情况下值得买、什么情况下别踩坑。
核对说明:规格来自英特尔官方规格页和 Arc Pro B60 数据手册,软件说明来自 Ollama、llama.cpp 和 OpenVINO 的官方文档,读取日期 2026-11-04。速度数字是公式推算的理论上限,我们没有做过实机测试,实际速度会因驱动、后端、量化格式和上下文长度而不同。社区里个别用户的报告只作为线索,不当作结论。
要点速览(更新于 2026-11-04)
- 英特尔官方规格:Arc B580 为 12GB 显存、456 GB/s 带宽、官方建议零售价 249 美元;Arc Pro B60 为 24GB、456 GB/s、功耗 120 到 200W;B50 为 16GB、224 GB/s、349 美元。
按带宽÷模型大小估算,B580 和 B60 跑 8B Q4(约 4.9GB)的理论上限约 93 tokens/s,14B Q4(约 9GB)约 51 tokens/s;真实速度要打折,且我们未实测。
软件上,Ollama 官方文档说明英特尔显卡通过 Vulkan 支持;llama.cpp 另有 SYCL 后端;IPEX-LLM 仓库已归档,不建议新项目依赖。
- 酷睿 Ultra 200V 的 NPU 标称 48 TOPS(Ultra 5 为 40),OpenVINO GenAI 的 NPU 文档示例包含 8B 级模型的导出命令,但模型须转换为对称 4 位格式,且默认提示词上限仅 1024 token,更适合省电的小模型任务,不是追求高速度的首选。
英特尔显卡跑大模型:先看显存和带宽
大模型生成每个 token 都要把几乎全部权重读一遍,所以解码速度上限约等于显存带宽 ÷ 模型文件大小(原理见为什么跑大模型要 GPU 而不是 CPU)。显存容量决定装不装得下,带宽决定快不快。英特尔官方资料里的几款显卡如下:
| 显卡 | 显存 | 带宽 | 官方 AI 算力标称 | 功耗 | 价格 |
|---|---|---|---|---|---|
| Arc B580 | 12GB | 456 GB/s | 233 INT8 TOPS | 190W | 官方建议零售价 249 美元 |
| Arc B570 | 10GB | 380 GB/s | — | — | — |
| Arc Pro B60 | 24GB | 456 GB/s | 197 TOPS | 120 到 200W | 以渠道报价为准 |
| Arc Pro B50 | 16GB | 224 GB/s | — | — | 349 美元(官方资料) |
有两点值得注意。第一,B60 的带宽和 B580 一样,但显存翻倍,意味着它装得下更大的模型,速度上限并不更高。第二,24GB 显存的入门价位在今天仍然稀缺,这正是 B60 吸引人的地方,不过它是面向工作站的产品,渠道价格和货源请以实际为准。
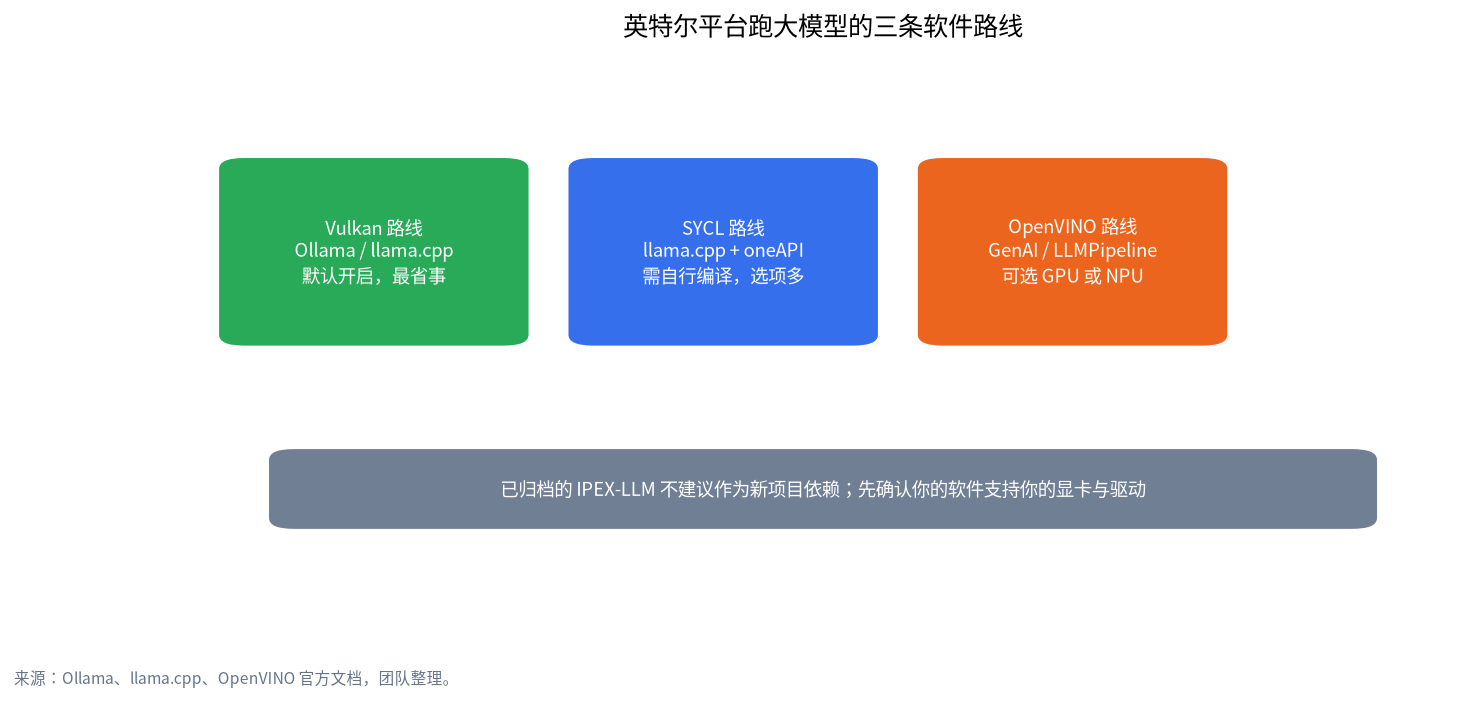
三条软件路线,成熟度不一样
| 路线 | 怎么用 | 官方说明要点 | 适合谁 |
|---|---|---|---|
| Vulkan | 通过 Ollama 或 llama.cpp 的 Vulkan 后端 | Ollama 的 GPU 文档说明英特尔显卡通过 Vulkan 支持,且默认开启 | 想要最少折腾的人 |
| SYCL | llama.cpp 的 SYCL 后端,需要装 oneAPI | llama.cpp 官方文档提供了 SYCL 后端说明;Ollama 社区议题里有人提议加入 SYCL,一位用户在 B50 上报告过 10 对 33 tokens/s 的差距(单个用户报告,我们未验证) | 愿意自己编译、追求更高速度的人 |
| OpenVINO | 英特尔自家推理栈,可用于 CPU、GPU、NPU | OpenVINO GenAI 提供 LLMPipeline,可指定 “NPU” 设备 | 需要在 NPU 上跑小模型的人 |
另外,英特尔此前的 IPEX-LLM 项目仓库已经归档(官方仓库状态),所以新项目更应该看 llama.cpp 与 OpenVINO。英特尔平台目前的现实是:能跑,但选项比英伟达多、成熟度参差,部署前最好先在你准备使用的软件上确认支持情况,常见排错见Ollama 与 GPU 排错。
用带宽算速度:理论上限表
我们用常见的 Q4_K_M 体积(8B 约 4.9GB,14B 约 9.0GB,32B 约 20GB)做估算,公式是“理论上限 = 带宽 ÷ 模型大小”。这是理想值:实际受内核效率、上下文长度、后端实现影响,通常达不到。
| 设备 | 带宽 | 8B Q4 上限 | 14B Q4 上限 | 32B Q4 上限 |
|---|---|---|---|---|
| Arc B580 / Arc Pro B60 | 456 GB/s | 约 93 | 约 51 | 约 23(B580 装不下) |
| Arc B570 | 380 GB/s | 约 78 | 约 42 | 不适用(显存不足) |
| Arc Pro B50 | 224 GB/s | 约 46 | 约 25 | 不适用(显存不足) |
| 酷睿 Ultra 200V 的 Arc 140V(理论带宽) | 约 136.5 GB/s | 约 28 | 约 15 | 约 7 |
| Arc 140V(Chips and Cheese 报告的 GPU 实际吞吐约 80 GB/s) | 约 80 GB/s | 约 16 | 约 9 | 约 4 |
说明:酷睿 Ultra 200V 使用 LPDDR5X-8533,136.5 GB/s 是我们按 8533 MT/s × 128 位总线算出来的理论值,不是官方公布的带宽;约 80 GB/s 来自 Chips and Cheese 的测试报道,仅作参考。
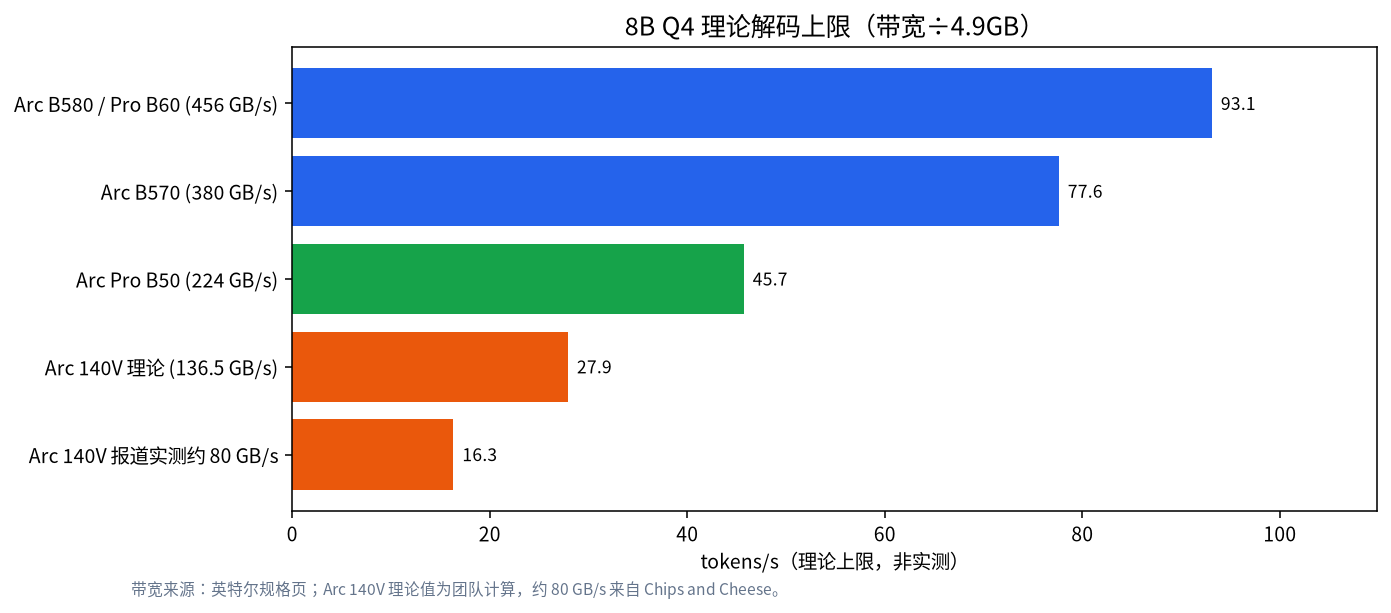
读表的方法:如果你的目标是“8B 到 14B 模型日常聊天够快”,B580 的理论上限已经远高于人类阅读速度,即使真实速度只有上限的一半或更低,也是可用的;如果你想跑 32B,就需要 24GB 的 B60,而它的上限约 23 tokens/s,仍属于可用但不算快的区间。
显存装得下什么
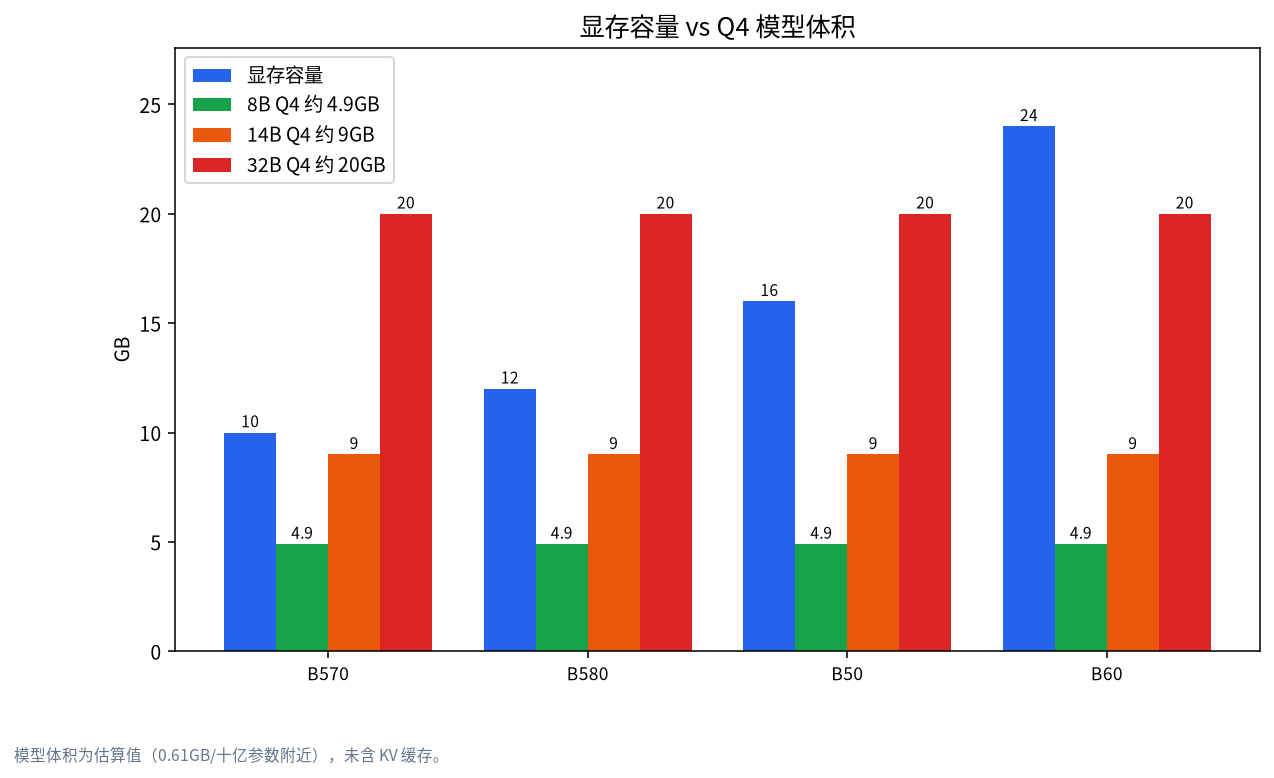
| 显卡 | 8B Q4(约 4.9GB) | 14B Q4(约 9.0GB) | 32B Q4(约 20GB) |
|---|---|---|---|
| B570 10GB | 装得下 | 余量很小,上下文受限 | 装不下 |
| B580 12GB | 装得下 | 可行,上下文不宜太长 | 装不下 |
| B50 16GB | 装得下 | 装得下 | 装不下 |
| B60 24GB | 装得下 | 装得下 | 可行,但上下文要留意 KV 缓存 |
KV 缓存随上下文增长,会占掉额外显存,估算见上下文长度与 KV 缓存。模型体积是估算值,具体文件以你下载的为准。
酷睿 Ultra 的 NPU 适合干什么
酷睿 Ultra 200V 的 NPU 标称 48 TOPS(Ultra 5 为 40),GPU 部分为 8 个 Xe 核心的 Arc 140V,内存为 LPDDR5X-8533。OpenVINO GenAI 的 NPU 文档说明:用 LLMPipeline(model, "NPU") 指定设备;LLM 必须以对称(--sym)4 位权重格式(INT4 或 NF4)导出,NF4 只在酷睿 Ultra 系列 2 及之后的 NPU 上受支持;文档的导出示例里就有 Llama-3.1-8B。同一份文档还给出几条限制:NPU 流水线采用静态形状,默认最大提示词长度为 1024 token、最小回复长度为 128 token;对于酷睿 Ultra 系列 2,处理超过 7B 的模型且提示词超过 1024 token 时可能需要超过 16GB 内存;NPU 上的 LLM 是即时编译,首次编译可能耗时较长,可以用缓存或预编译缓解;遇到执行失败时,文档建议把 NPU 驱动更新到 32.0.100.3104 或更新。
这意味着 NPU 路线的价值在于功耗低、可以和 CPU/GPU 并行,适合助手、摘要、离线小模型之类的任务;但它的带宽受限于整机内存,上表中 Arc 140V 的理论上限已经只有 8B 约 28 tokens/s,所以不要期待 NPU 带来“高速度”。关于 NPU 的更多概念,见AI PC 与 NPU 是什么。
英特尔 vs 英伟达 vs 英特尔以外的选择
| 对比项 | 英特尔 Arc | 英伟达 | AMD |
|---|---|---|---|
| 单位显存价格 | 官方价格较有竞争力(B580 12GB 249 美元) | 通常更高 | 视型号而定,见AMD 显卡指南 |
| 软件生态 | 可用但选项多、需要核对 | 最成熟 | 在改善,需核对 |
| 入门显存 | 12GB 到 24GB 有官方产品 | 视型号 | 视型号 |
| 适合 | 愿意折腾、预算敏感 | 想要最省心 | 预算敏感 |
如果你主要考虑二手卡,请同时看便宜显卡选购,对比二手英伟达与新的 Arc 哪个更划算。若想知道 12GB 到 16GB 能跑什么,见12GB 与 16GB 显存指南。
选购速查:按用途选
| 你的目标 | 倾向的选择 | 理由(基于上文规格与估算) |
|---|---|---|
| 预算有限,主要跑 7B 到 8B | Arc B580 12GB | 显存够装 8B Q4,理论上限较高,官方建议零售价 249 美元 |
| 想单卡跑 14B | B580 12GB 或 B50 16GB | 14B Q4 约 9GB,16GB 的上下文余量更大 |
| 想单卡跑 32B Q4 | Arc Pro B60 24GB | 约 20GB 的权重装得下,但要留意上下文 |
| 笔记本、省电、轻任务 | 酷睿 Ultra 200V + NPU/GPU | 功耗低,但带宽受限,速度不是卖点 |
| 软件要最少折腾 | 先确认软件支持,必要时考虑英伟达 | 英特尔路线可用,但选项更多,需要核对 |
买之前,建议用你打算使用的软件和模型,在自己的环境里跑一遍再决定,不要只看理论值。
常见误区与避坑
- 只看显存不看软件:能装下不等于跑得快,先确认你要用的软件(Ollama、llama.cpp 或 OpenVINO)支持你的显卡和驱动。
- 把 NPU TOPS 当速度:TOPS 是算力标称,生成速度由内存带宽主导。
- 拿理论上限当实际速度:本文的表格是上限,真实速度要打折,请以你自己的测试为准。
- 忽视二手与新品的保修差异:Arc 为新品,二手英伟达价格和保修不同。
- 忽略上下文长度:长上下文会占 KV 缓存,12GB 显存跑 14B 时尤其明显。
我们怎么核对,没做什么
规格来自英特尔官方规格页和数据手册;软件支持来自 Ollama、llama.cpp 和 OpenVINO 官方文档及 GitHub 仓库状态;速度上限是公式推算,Arc 140V 的实际带宽来自 Chips and Cheese 报道。我们没有在英特尔显卡或 NPU 上做过实机测试,社区个别用户的速度报告我们没有验证,所以不据此下结论。
常见问题
英特尔显卡能跑大模型吗?
能。Ollama 官方文档说明英特尔显卡通过 Vulkan 支持,llama.cpp 还有 SYCL 后端。能不能跑得好,取决于你用的软件和驱动。
Arc B580 12GB 能跑多大的模型?
按估算,8B Q4 约 4.9GB 可以轻松装下,14B Q4 约 9GB 装得下但上下文受限,32B 约 20GB 装不下。
Arc Pro B60 24GB 值得买吗?
如果你想用单卡跑 32B 级别的 Q4 模型,24GB 是门槛;它的带宽与 B580 相同,所以不会更快,只是装得下更大的模型。价格和货源以渠道为准。
酷睿 Ultra 的 NPU 能跑大模型吗?
可以,但有条件。OpenVINO GenAI 文档要求模型转换为对称 4 位格式,默认提示词上限 1024 token,并给出了 8B 级模型的导出示例;它更适合低功耗的小任务,不适合追求速度。
英特尔显卡速度比英伟达慢吗?
没有统一结论。同等带宽下理论上限相近,但实际取决于软件优化,我们没有实测,不下结论。
买英特尔显卡跑 AI 要注意什么?
先确认软件支持和驱动,再看显存与带宽,别把 NPU TOPS 当速度,并为 KV 缓存预留显存。
想让我们帮你判断配置?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们预算、想跑的模型大小和系统环境。我们的深圳团队可以帮你配置,也会如实说明哪些环节我们没有实测。
参考资料:英特尔:Arc B580 规格、英特尔:Arc Pro B60 数据手册(PDF)、Ollama:GPU 支持文档、llama.cpp:SYCL 后端文档、OpenVINO GenAI:NPU 文档、IPEX-LLM 仓库(已归档)。