Strata vs Ollama vs llama.cpp vs LM Studio vs vLLM : à quoi sert chacun et lequel choisir
Mis à jour le 2026-11-04. D’après la documentation publique, les notes de version et des rapports de tiers. Nous n’avons lancé aucun benchmark nous-mêmes.
Strata vs Ollama est la comparaison que tout le monde réclame ce mois-ci, mais ce n’est pas un duel équitable entre deux outils qui font le même travail. Strata est un moteur récent conçu pour exécuter une classe de très grands modèles à mélange d’experts (MoE) sur un PC doté d’une petite carte graphique. Ollama est un gestionnaire de modèles généraliste et mature. llama.cpp, LM Studio et vLLM occupent d’autres coins de la même carte. Cet article place les cinq côte à côte, montre à quoi sert chacun, vérifie ce que nous avons pu établir sur la prise en charge de Qwen3.8-Flash-Next et se termine par un guide de choix. Si vous ne connaissez le mot « Strata » que de nom, commencez par notre explication de ce qu’est Strata.
Strata vs Ollama : la réponse courte
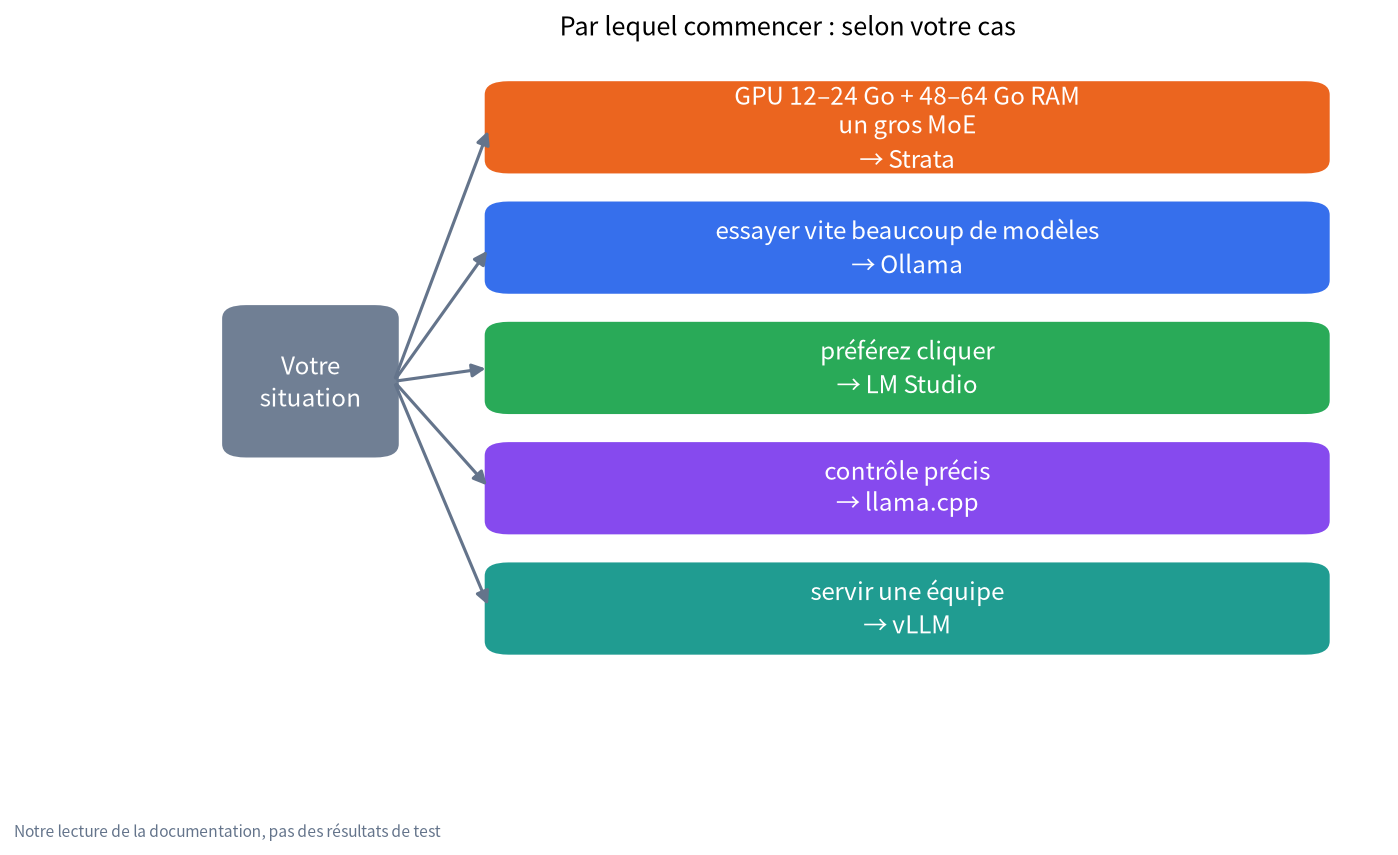
- Strata : choisissez-le si vous voulez un très grand modèle MoE, surtout Qwen3.8-Flash-Next, sur un PC avec GPU de 12 à 24 Go et 48 à 64 Go de RAM.
- Ollama : choisissez-le si vous voulez la façon la plus simple d’exécuter de nombreux modèles petits et moyens et de les relier à des applications.
- llama.cpp : choisissez-le si vous voulez un contrôle maximal sur les modèles GGUF et le matériel, ou si un outil que vous utilisez repose dessus.
- LM Studio : choisissez-le si vous voulez une application graphique pour trouver, télécharger et discuter avec des modèles.
- vLLM : choisissez-le si vous servez beaucoup d’utilisateurs à la fois depuis des GPU à mémoire suffisante.
Côte à côte
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| Fonction principale | Exécuter de très gros modèles MoE avec peu de VRAM en étageant GPU, RAM et SSD | Télécharger, exécuter et servir de nombreux modèles avec une commande | La bibliothèque d’inférence et le serveur sur lesquels reposent beaucoup d’outils | Application de bureau pour parcourir, télécharger et discuter | Moteur de service à haut débit |
| Licence | MIT (moteur) | MIT | MIT | Application propriétaire, gratuite pour un usage personnel et professionnel selon ses conditions | Apache-2.0 |
| Étoiles GitHub (2026-11-04) | 39 548 | 185 856 | 133 318 | Pas un dépôt ouvert | 96 277 |
| Interface | Application de bureau et terminal | Ligne de commande, application, API REST | Ligne de commande et llama-server |
Application graphique, CLI lms, mode sans interface |
Bibliothèque Python et serveur |
| API | Style OpenAI, Anthropic et Responses | API propre plus points d’accès compatibles OpenAI | Serveur compatible OpenAI | Serveur compatible OpenAI | Serveur compatible OpenAI |
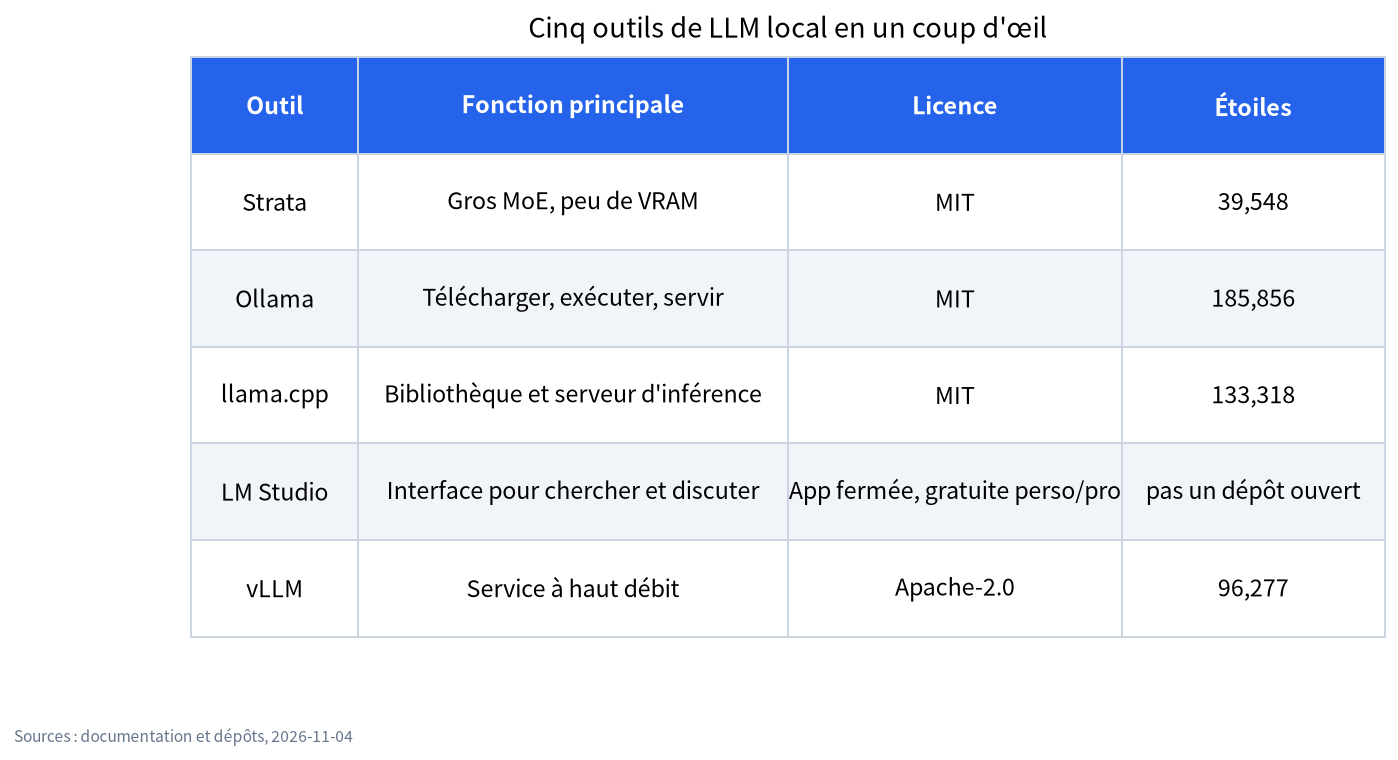
Les étoiles mesurent l’attention, pas la qualité. Le dépôt de Strata a six semaines ; celui d’Ollama a eu des années pour en accumuler. Les notes de version en disent plus sur l’élan : Strata a publié six versions entre le 25 octobre et le 2 novembre, et la v0.40.14 d’Ollama est apparue le 3 novembre.
Ce que chacun fait bien et ce qu’il faut surveiller
| Outil | Fort en | À surveiller |
|---|---|---|
| Strata | Très grands modèles MoE sur cartes de 12 à 24 Go, installation en un clic, strata connect pour les agents de programmation |
Peu de modèles pris en charge, projet jeune, les longs prompts sont lents sur cartes de 12 Go (PC Watch), pas d’audit de sécurité externe selon sa documentation |
| Ollama | Simplicité, grande bibliothèque de modèles, énorme écosystème, ollama launch pour les outils de programmation, MLX sur Apple Silicon depuis v0.40.0 |
Pas conçu pour lire un MoE de 125B depuis la RAM et le SSD ; des modèles cloud optionnels et des formules payantes existent à côté de l’usage local |
| llama.cpp | Large prise en charge matérielle, formats de quantification, contrôle fin ; il a ajouté la prise en charge de Qwen3.8-Flash-Next avec la pull request #27742, fusionnée le 2026-08-27 | Plus d’options à apprendre ; vous assemblez vous-même la configuration |
| LM Studio | Interface conviviale, moteurs llama.cpp et MLX, peut tourner sans interface avec lms |
Application à code fermé ; respectez ses conditions si vous l’intégrez à un produit |
| vLLM | Débit avec beaucoup de requêtes parallèles | Veut de la mémoire GPU pour tout le modèle ; ne vise pas une carte de 12 Go |
Le dépôt propre de vLLM se trouve sur github.com/vllm-project/vllm. Pour un examen plus long des trois outils les plus courants, voyez notre guide Ollama vs LM Studio vs llama.cpp, et pour vLLM notre introduction à vLLM et SGLang.
Prise en charge de Qwen3.8-Flash-Next, telle que nous avons pu la vérifier
C’est le modèle derrière l’essentiel du battage autour de Strata ; mieux vaut donc être précis. Tout ce qui suit est daté du 2026-11-04.
- Strata : conçu pour lui (liste des modèles). La documentation donne quatre quantifications, de 37,6 à 54,8 Go de RAM plus VRAM.
- llama.cpp : la pull request #27742, « model: add Qwen3.8-Flash-Next (qwen4exp) », a été fusionnée le 2026-08-27. Un utilisateur de Hacker News a rapporté llama.cpp à environ 21 jetons/s contre Strata à environ 60 jetons/s sur une configuration AMD. C’est une anecdote, pas un test dont nous pouvons répondre.
- Ollama : sa page de bibliothèque pour
qwen3.8-flash-nextmontrait une seule étiquette,125b-mlx(105 Go, pour Apple Silicon). Une demande de fonctionnalité a été fermée le 2026-10-17. Nous n’avons trouvé aucune étiquette pour les GPU NVIDIA et n’avons pas testé : nous ne disons donc pas qu’Ollama ne peut pas l’exécuter, seulement que nous n’avons pas trouvé de voie documentée. - LM Studio et vLLM : nous n’avons pas vérifié.
Comment chaque outil traite un modèle plus grand que votre VRAM
C’est là que les outils diffèrent vraiment. Quand un modèle ne tient pas sur la carte, Ollama et llama.cpp le découpent normalement par couches : certaines couches tournent sur le GPU et le reste sur le CPU, avec les poids en RAM. Cela marche bien pour les modèles denses et c’est la voie habituelle sur les petites cartes. Un modèle MoE est différent, car seuls quelques experts servent par jeton. llama.cpp propose des options qui gardent les experts côté CPU (la famille d’options --cpu-moe), et un utilisateur de Hacker News a rapporté 16 jetons/s avec un fichier Q8_0 sur une machine de 192 Go de RAM avec cette approche. Strata va un cran plus loin : il garde sur le GPU un cache des experts les plus utilisés, calcule les autres sur le CPU là où ils se trouvent en RAM, et peut lire le reste depuis le SSD. Le résultat est un outil qui fait bien une chose, au prix de ne prendre en charge que quelques modèles. vLLM, à l’inverse, suppose que tout le modèle vit dans la mémoire du GPU, ce qui le destine aux serveurs plutôt qu’à une carte de bureau de 12 Go.
Comment lire les affirmations de vitesse
La plupart des articles « Strata est plus rapide » comparent des modèles différents. Le blogueur japonais derrière un test sur RTX 3060 a placé les 44,49 jetons/s de Strata pour le modèle 125B à côté de résultats d’Ollama avec des modèles de 9B et 26B sur le même PC, puis a dit clairement que ce tableau ne montre pas que Strata est plus rapide ou plus lent qu’Ollama. Le test d’arm1.ru comparait Strata avec Flash-Next à llama.cpp avec un autre modèle, Qwen3.8-27B. Une comparaison équitable exige le même modèle, la même quantification, le même contexte, le même matériel et la même version logicielle ; nous n’en avons trouvé aucune qui remplisse pleinement ce critère. D’ici là, lisez les vitesses comme « ce que cet outil a obtenu avec ce modèle », pas comme « quel outil est le plus rapide ». Lisez les sources : le test de note.com, arm1.ru et le fil Hacker News.
Guide de choix
| Votre situation | Commencez par | Pourquoi |
|---|---|---|
| GPU NVIDIA ou AMD de 12 à 24 Go, 48 à 64 Go de RAM, vous voulez Qwen3.8-Flash-Next | Strata | Il est conçu pour ce modèle et cette répartition mémoire |
| Vous voulez essayer vite beaucoup de modèles ou brancher Open WebUI | Ollama | Installation la plus simple et plus grand écosystème ; voir notre guide d’installation d’Ollama |
| Vous préférez cliquer que taper | LM Studio | Navigateur de modèles graphique ; voir notre tutoriel LM Studio |
| Vous avez besoin d’un contrôle exact des options, de la quantification ou des compilations | llama.cpp | Au plus près du matériel |
| Vous servez une équipe depuis un serveur GPU | vLLM | Conçu pour les requêtes concurrentes |
| Vous avez un Mac avec beaucoup de mémoire unifiée | D’abord Ollama ou LM Studio | Les deux utilisent MLX sur Apple Silicon ; Strata prend aussi en charge macOS 15 ou plus récent |
Rien ne vous empêche d’en utiliser deux. Beaucoup garderont Ollama pour les modèles du quotidien et ajouteront Strata pour un grand modèle ; souvenez-vous seulement que les deux veulent la même VRAM et la même RAM. Les étapes pratiques sont dans notre guide d’installation pour faire tourner Strata à côté d’Ollama, et les chiffres de mémoire dans notre article sur la configuration requise.
Licences, données et coût
Les moteurs sont open source (MIT ou Apache-2.0), mais les poids des modèles ont leurs propres licences ; Qwen3.8-Flash-Next utilise la Qwen Community License 1.0, lisez-la donc si vous prévoyez un usage commercial. Les documents de Strata disent qu’il n’y a ni télémétrie ni compte ; Ollama exécute les modèles locaux sans connexion et propose aussi, selon ses notes de version, des modèles cloud optionnels et des formules payantes ; les conditions de LM Studio autorisent l’usage personnel et professionnel, mais pas la redistribution ni l’hébergement en tant que service. Vérifiez toujours vous-même les conditions en vigueur.
Ce que nous avons fait et ce que nous n’avons pas fait
Le 2026-11-04, nous avons lu le dépôt, les notes de version et la documentation de chaque projet, ainsi que les rapports de tiers liés ci-dessus. Nous n’avons installé aucun des cinq outils pour cet article ni mesuré une seule vitesse. Quand une affirmation vient d’un seul utilisateur, nous le disons.
Questions fréquentes (FAQ)
Strata est-il plus rapide qu’Ollama ?
Nous ne pouvons pas le dire. Les comparaisons publiées utilisent surtout des modèles différents et ne répondent donc pas à la question. Selon les testeurs, Strata peut exécuter un MoE de 125B à plusieurs dizaines de jetons par seconde sur une carte de 12 Go, mais c’est un autre travail que d’exécuter un modèle de 9B dans Ollama.
Ollama peut-il exécuter Qwen3.8-Flash-Next ?
Le 2026-11-04, la bibliothèque d’Ollama listait une étiquette MLX de 105 Go pour Apple Silicon. Nous n’avons trouvé aucune voie documentée pour les GPU NVIDIA et n’avons pas testé ; consultez donc la page de bibliothèque pour votre plateforme.
Quel outil est le meilleur pour un débutant ?
Ollama ou LM Studio. Les deux s’installent en quelques minutes et ont le plus de guides. Ajoutez Strata plus tard si vous voulez un très grand modèle précis.
Strata repose-t-il sur llama.cpp ?
Sa documentation cite ggml, la bibliothèque de tenseurs derrière llama.cpp, comme composant tiers, mais Strata est un moteur C++ distinct avec son propre ordonnancement. Il n’est pas décrit comme un fork de llama.cpp.
Lequel est le meilleur pour servir une équipe ?
vLLM, si vous avez assez de mémoire GPU pour tout le modèle. Le réglage par défaut de Strata ajuste les requêtes parallèles à votre carte (une sur un GPU de 12 Go) ; une carte de 12 Go est donc faite pour un seul utilisateur, pas pour une équipe.
Dois-je désinstaller Ollama pour essayer Strata ?
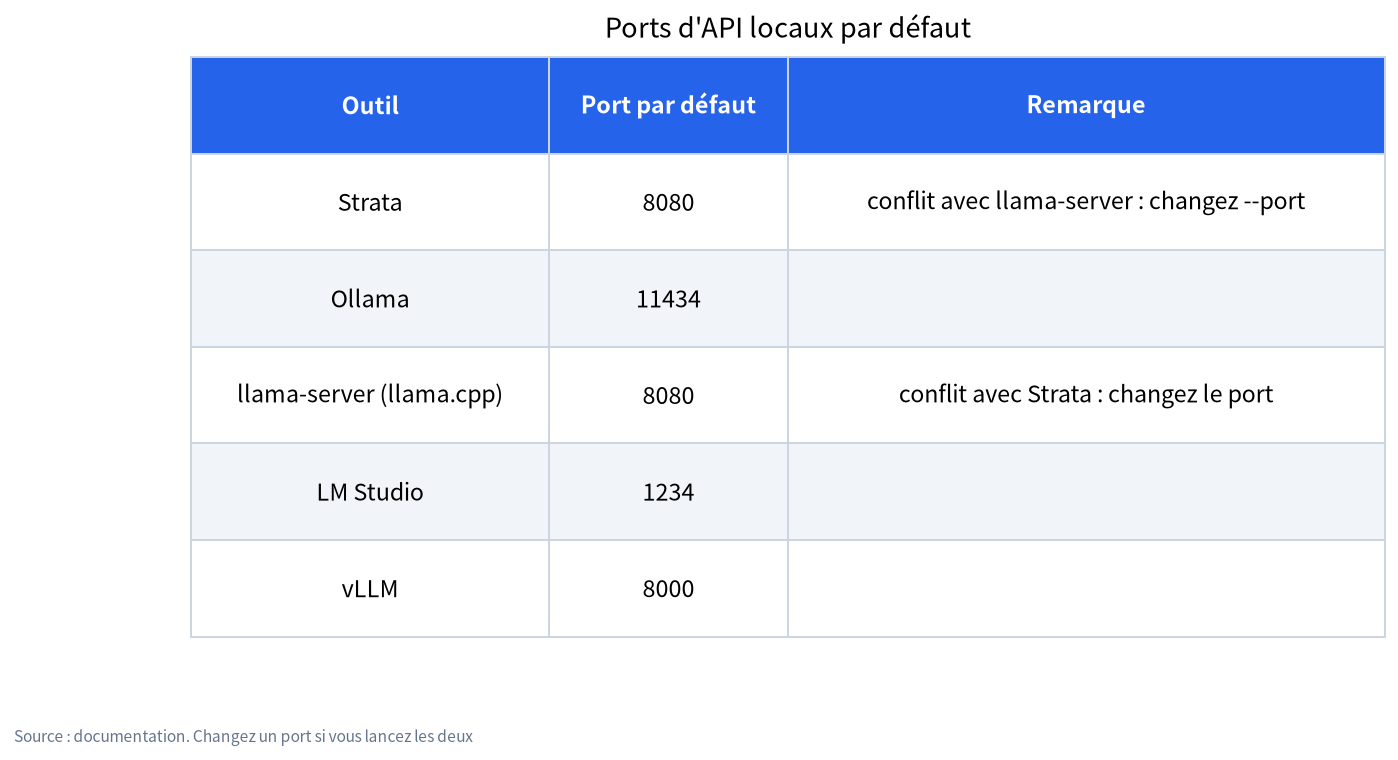
Non. Ils utilisent des ports par défaut et des dossiers de modèles différents. Ne chargez simplement pas deux gros modèles sur le même GPU en même temps.
Parlons-en
Si vous ne savez pas quel outil convient à votre GPU et à votre budget, rejoignez la communauté ou écrivez à admin@microaione.com en indiquant GPU, RAM et usage prévu. Si vous préférez une machine montée et testée pour cela, consultez le guide des machines et solutions.