Configuration requise de Strata : combien de RAM, de VRAM et de SSD, avec des paliers de PC
Mis à jour le 2026-11-04. Nous n’avons pas exécuté Strata nous-mêmes. Chaque exigence ci-dessous vient des documents du projet ou d’un testeur nommé, et chaque vitesse est la leur.
La configuration requise de Strata explique tout l’intérêt de l’outil : un modèle de 125 milliards de paramètres sur une carte graphique de 12 Go paraît impossible tant qu’on ne voit pas où se trouve réellement le poids. Le résumé honnête est que le GPU est la plus petite ligne de la facture. L’essentiel du modèle vit dans la RAM système, une part plus petite sur le SSD, et le GPU garde un cache des experts les plus utilisés. Cet article transforme la documentation et les rapports de testeurs en chiffres autour desquels planifier un PC, esquisse des paliers de configuration et dit où nous refusons de deviner. Si vous ne connaissez pas encore l’outil, lisez d’abord ce qu’est Strata.
La configuration requise de Strata en bref
| Composant | Plancher pratique | Confortable |
|---|---|---|
| GPU | NVIDIA RTX séries 20 à 50 de 12 Go (les cartes plus anciennes utilisent un moteur CUDA 12) ; AMD, Intel Arc et Apple Silicon ont leurs propres guides | 16 à 24 Go, ou deux cartes |
| RAM | Environ 48 Go pour les deux plus petites tailles | 64 Go pour toutes les tailles ; plus pour les longs contextes |
| SSD | Environ 80 Go libres, NVMe de préférence | 1 To pour garder plusieurs tailles |
| CPU | x86-64 récent ; le moteur a des chemins de code AVX2 et AVX-512 | AVX-512 aide, selon les testeurs |
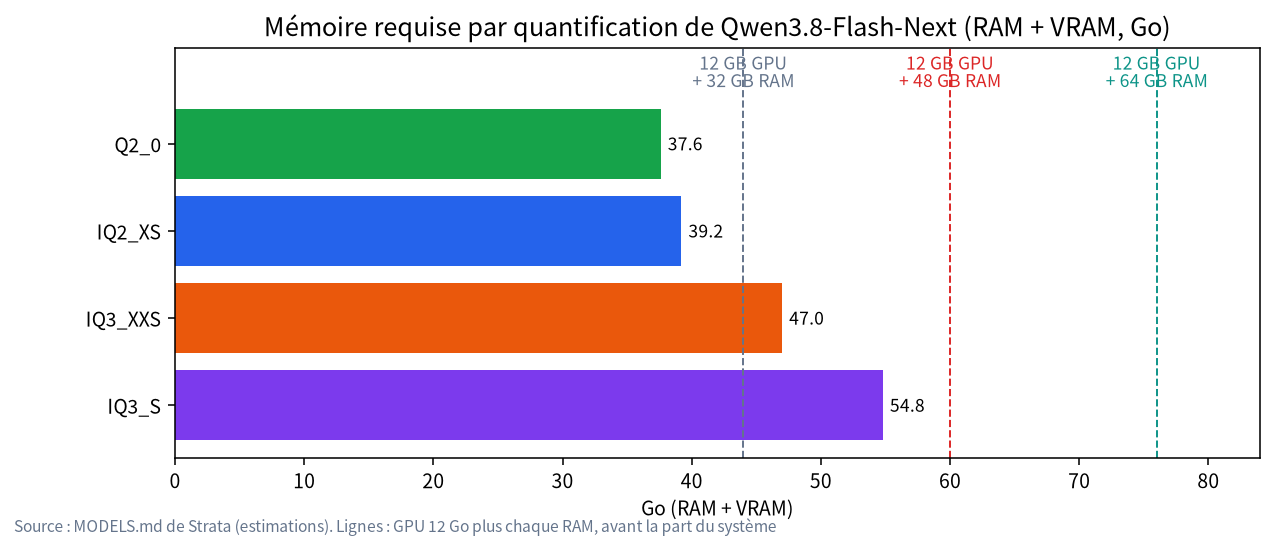
La page des modèles du projet donne les poids en RAM plus VRAM : 37,6 Go pour Q2_0, 39,2 pour IQ2_XS, 47,0 pour IQ3_XXS et 54,8 pour IQ3_S. Elle vous dit de laisser de la place au système d’exploitation et précise que ces chiffres sont des estimations. Un testeur d’AkitaOnRails a écrit que le minimum indiqué par le projet est de 32 Go de RAM et VRAM cumulées, que cela ne fait tourner que la version la plus compressée, et que l’IQ3_S qui a bien marqué dans ses tests demandait environ 64 Go de RAM.
Ce que fait chaque composant
GPU et VRAM. Selon le document HOW_IT_WORKS du projet, la carte garde les couches d’attention, les routeurs, les experts partagés, le cache KV et un cache d’experts qui remplit la VRAM restante, à raison d’environ 700 experts par gigaoctet supplémentaire. Un cache plus grand signifie que plus de jetons sont calculés sur le GPU. PC Watch a mesuré environ 3 031 experts sur une carte de 12 Go et un taux de réussite de 72 % avec IQ2_XS, contre 1 104 experts et 56 % avec IQ3_S. Le nombre de requêtes parallèles suit aussi la VRAM : 1 sur 12 Go, 2 sur 20 Go, 3 sur 24 Go et 4 à partir de 32 Go.
RAM. Les 24 576 experts sont en mémoire épinglée, et le CPU calcule ceux que le GPU n’a pas. La capacité de la RAM décide de la taille que vous pouvez exécuter, et sa vitesse comme les instructions du CPU décident de la rapidité des échecs de cache. PC Watch a pointé la bande passante de la DDR4 et l’absence d’AVX-512 sur son CPU de test comme des facteurs de ralentissement, et un autre testeur japonais a dit la même chose d’un CPU sans AVX-512.
SSD. Une table n-gram de 28,8 Go est lue à raison de quelques lignes par jeton. Si la RAM manque, un mode facultatif lit les experts depuis le disque ; la documentation dit qu’il fonctionne mais est bien plus lent. Sur un portable de 30 Go de RAM, le testeur d’arm1.ru a mesuré environ 6,9 To lus depuis le SSD pendant un essai de 1,3 heure (1,4 Go/s en moyenne).
CPU. Ce n’est pas une caractéristique vedette, mais il travaille réellement à chaque échec de cache. Le moteur a des chemins de code distincts pour les CPU avec et sans AVX-512.
Paliers de PC, avec ce que les testeurs ont rapporté
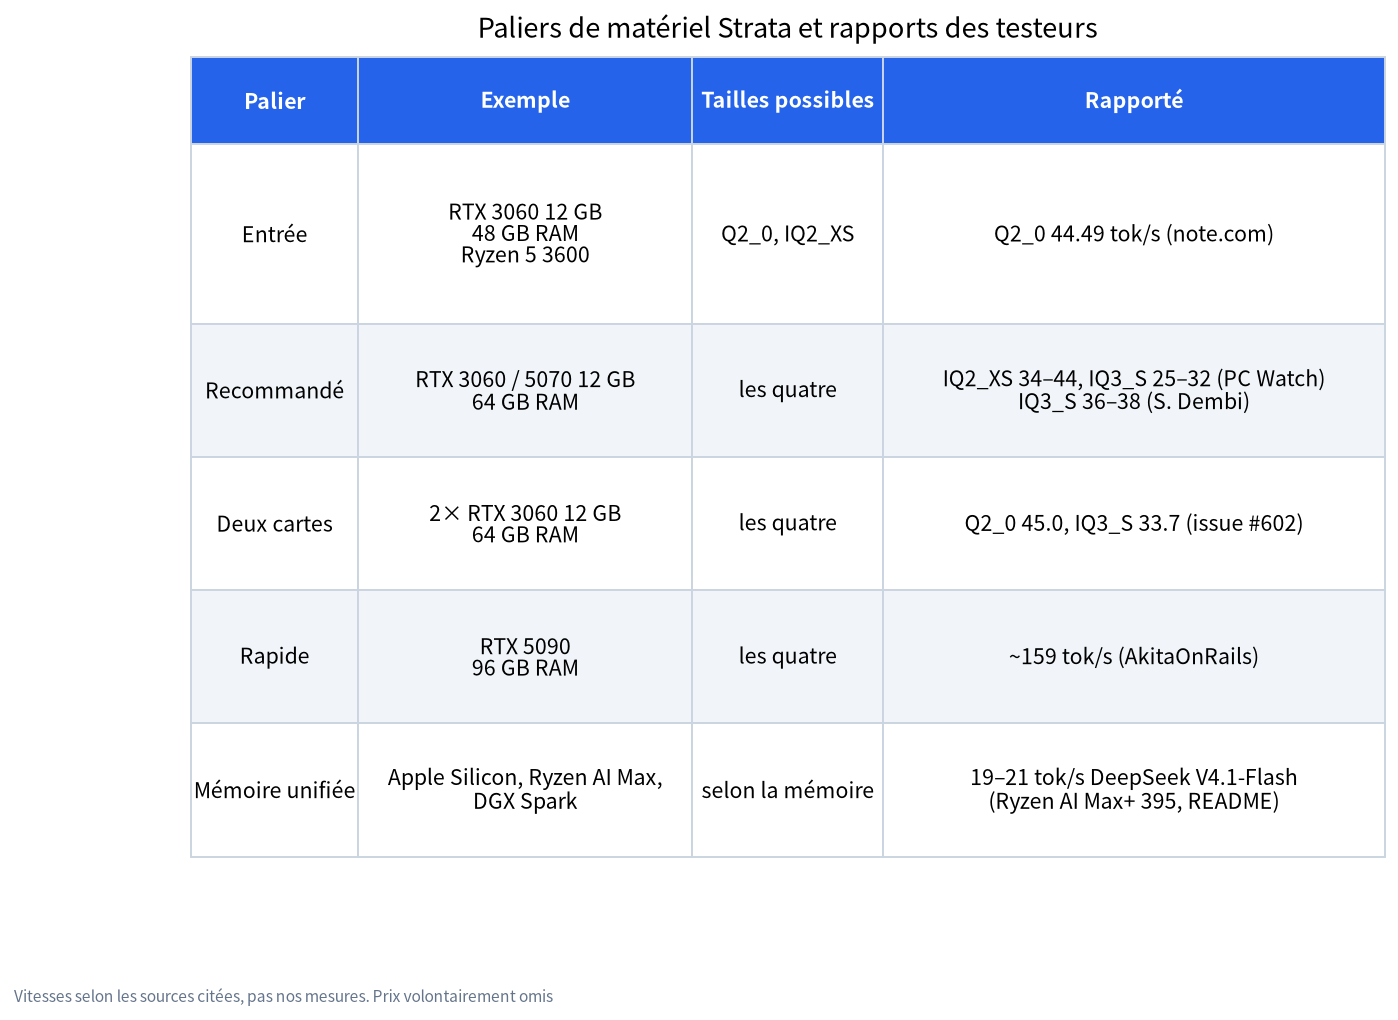
| Palier | Exemple de composants | Tailles qui tiennent | Ce que les sources ont rapporté |
|---|---|---|---|
| Entrée | RTX 3060 12 Go, 48 Go de RAM, Ryzen 5 3600 | Q2_0, IQ2_XS | Q2_0 à 44,49 jetons/s en génération, 326,68 jetons/s en préremplissage (note.com) |
| Recommandé | RTX 3060 ou RTX 5070 de 12 Go, 64 Go de RAM | Les quatre | IQ2_XS 34 à 44 et IQ3_S 25 à 32 jetons/s (PC Watch) ; IQ3_S 36 à 38 jetons/s avec environ 50 Gio de RAM (Dembi) |
| Deux cartes | 2× RTX 3060 12 Go, 64 Go de RAM | Les quatre | Q2_0 45,0 et IQ3_S 33,7 jetons/s (issue #602 du projet) ; le multi-GPU répartit par couches et n’exige pas de NVLink |
| Rapide | RTX 5090, 96 Go de RAM, CPU puissant | Les quatre | Environ 159 jetons/s et un score de 91 sur le benchmark de l’auteur (AkitaOnRails) |
| Mémoire unifiée | Apple Silicon (macOS 15+), Ryzen AI Max, DGX Spark | Selon la mémoire | Le README du projet rapporte 19 à 21 jetons/s (code) pour DeepSeek V4.1-Flash sur un Ryzen AI Max+ 395 avec 128 Go |
Nous n’avons volontairement pas mis de prix dans ce tableau. Les prix des GPU et de la mémoire bougent d’une semaine à l’autre, et les sources ci-dessus ne donnaient pas de prix datés vérifiables. Nos guides de prix datés sont de meilleurs points de départ : configuration d’entrée de gamme, configuration avec GPU de 24 Go, acheter un GPU d’occasion et GPU bon marché pour les LLM.
Disque et SSD : le plan
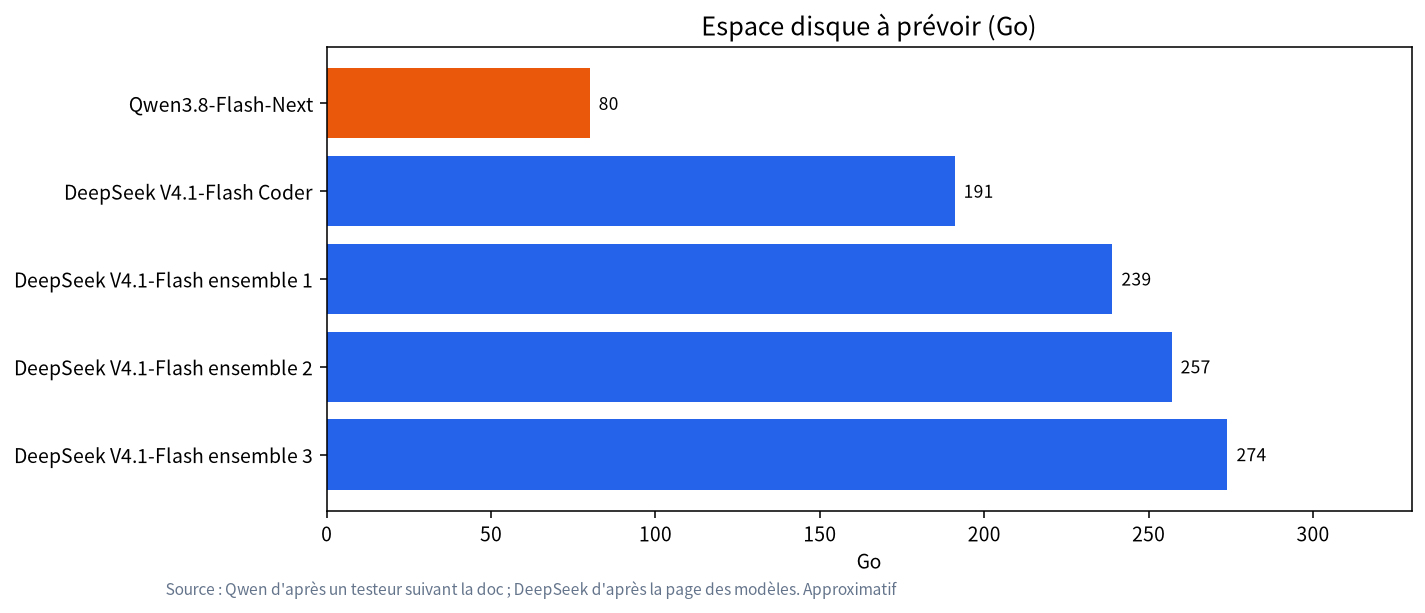
Pour Qwen3.8-Flash-Next, prévoyez environ 80 Go libres, surtout parce que le téléchargement inclut les experts quantifiés, des fichiers d’aide et la table n-gram. DeepSeek V4.1-Flash demande de 191 à 274 Go selon l’ensemble ; notre article DeepSeek V4.1 Flash sur 12 Go traite ce cas. Les lectures n’usent pas un SSD, mais un disque occupé ralentit tout le reste ; gardez donc le dossier de Strata sur un disque NVMe qui n’est pas votre disque système si possible.
Portables, WSL2 et mémoire unifiée
Les portables sont le cas délicat. Le testeur d’arm1.ru a exécuté le modèle de 125B sur un GPU de portable RTX 5080 avec 30 Go de RAM et a constaté que cela marchait, mais la mémoire était juste : Strata a utilisé environ 21 Go de RAM et 4 à 5 Go de swap, c’est pourquoi nous qualifierions 32 Go de RAM de coup d’éclat plutôt que de plan. Windows avec WSL2 fonctionne aussi, comme le montre l’index de la communauté pour une RTX 5060 Ti, même si la documentation note que sous les pilotes graphiques de Windows, seule une partie de la mémoire des experts est épinglée dans les exécutions multi-GPU. Sur des machines à mémoire unifiée comme Strix Halo, la mémoire graphique et la RAM forment un seul pool : un chiffre de 128 Go remplace donc les chiffres séparés de VRAM et de RAM des tableaux ci-dessus.
Plus de résultats de l’index de benchmarks du projet
Le dépôt tient un index de benchmarks de la communauté d’essais soumis par les utilisateurs. Ils sont déclaratifs, utilisent des versions différentes (v0.1.40 à v0.1.43) et des longueurs de prompt différentes, et nous n’en avons reproduit aucun : lisez le tableau comme un ordre de grandeur, pas comme un classement.
| Matériel (tel que soumis) | Taille | Génération, jetons/s |
|---|---|---|
| RX 9070 16 Go, Ryzen 7 5800X3D, 64 Go de RAM | IQ3_XXS | 57,9 à 58,7 |
| RTX 5060 Ti 16 Go (WSL2), Ryzen 7 3700X, 128 Go de RAM | IQ3_S | 47,7 à 48,2 |
| 2× Tesla P40 24 Go, Xeon E5-2699 v3, 125 Go de RAM | IQ3_S | 35,0 |
| Tesla V100 32 Go, Threadripper 2990WX, 96 Go de RAM | UD-IQ4_XS | environ 28 à 33 |
| Portable Strix Halo, 128 Go unifiés, 70 W | UD-IQ4_XS | 42 à 59 selon la longueur du prompt |
Deux choses ressortent. Les cartes de 16 Go de l’index rapportent des vitesses supérieures aux chiffres de 12 Go ci-dessus pour des tailles comparables, ce qui correspond à la conception à cache d’experts, bien que les CPU et les versions diffèrent. Et d’anciennes cartes de station de travail de 24 Go tournent encore à une vitesse utile si la RAM est grande. Les deux concordent avec l’ordre de mise à niveau ci-dessous, mais ce sont des soumissions isolées : ne les lisez pas comme des garanties.
Estimer votre propre machine
Additionnez VRAM et RAM, puis retranchez la taille du modèle : ce qui reste est l’espace pour le système, le navigateur, le cache KV et tout le reste. C’est de l’arithmétique simple sur les chiffres du projet, pas une mesure.
| Configuration (VRAM + RAM) | Total | Marge pour IQ2_XS (39,2 Go) | Marge pour IQ3_S (54,8 Go) |
|---|---|---|---|
| 12 Go + 32 Go | 44 Go | environ 4,8 Go, très juste | ne tient pas |
| 12 Go + 48 Go | 60 Go | environ 20,8 Go | environ 5,2 Go, très juste |
| 12 Go + 64 Go | 76 Go | environ 36,8 Go | environ 21,2 Go |
Moins il y a de marge, plus vous risquez de swapper comme le portable d’arm1.ru, et la vitesse en souffre. Notre conseil : ne courez pas après la plus grande taille sur une machine « juste assez » ; prenez une taille de moins et gardez la marge pour les longs contextes et l’usage quotidien. La même arithmétique dit quelle mémoire acheter : décidez d’abord de la taille, puis remontez, au lieu d’acheter d’abord en espérant que cela tienne.
Ordre de mise à niveau, tel que nous lisons les documents
C’est notre déduction de la façon dont le projet décrit sa conception, pas un classement mesuré.
- RAM à 64 Go. Tous les experts y vivent : elle décide des tailles possibles. C’est en général la plus grosse étape bon marché.
- Plus de VRAM. Chaque gigaoctet ajoute environ 700 experts en cache, et un meilleur taux de réussite réduit les calculs sur le CPU.
- Un CPU avec AVX-512 et une mémoire plus rapide. Cela aide pour les échecs de cache, selon deux testeurs.
- Stockage NVMe. Compte surtout si vous devez lire les experts depuis le disque.
Pour les compromis de mémoire derrière cela, voyez notre guide RAM vs VRAM et déchargement CPU et notre guide de la VRAM des GPU.
Quand une machine sur mesure a du sens
Le plus dur est le choix des pièces : associer une carte de 12 ou 24 Go, assez de slots de RAM, un disque NVMe, une alimentation et un refroidissement. Si vous préférez ne pas le faire, notre équipe de Shenzhen monte et teste des machines pour LLM local, et le guide des machines et solutions explique comment cela fonctionne. Indiquez votre modèle cible, votre budget et vos limites de bruit, et nous proposerons une liste de pièces avec des prix datés. Nous n’avons testé Strata sur aucune machine : demandez-nous donc un test sur la configuration précise que vous envisagez plutôt que de supposer les chiffres ci-dessus. L’alimentation et la chaleur sont traitées dans notre guide d’alimentation et de refroidissement.
Ce que nous avons fait et ce que nous n’avons pas fait
Le 2026-11-04, nous avons lu les documents MODELS, HOW_IT_WORKS et multi-GPU du projet ainsi que les rapports de testeurs liés ci-dessus. Nous n’avons monté aucune machine, exécuté aucun benchmark ni cité aucun prix. Quand un chiffre vient d’une seule personne, nous la nommons.
Questions fréquentes (FAQ)
Puis-je exécuter Strata avec un GPU de 8 Go ?
La voie officielle recommande 12 Go ou plus. L’index de la communauté du projet cite deux cartes Quadro RTX 4000 de 8 Go avec 96 Go de RAM exécutant IQ2_XS à 18 à 23 jetons/s en génération sur de très longs prompts, mais c’est deux cartes et beaucoup de RAM, et nous ne l’avons pas vérifié.
32 Go de RAM suffisent-ils ?
C’est juste. Les poids seuls demandent 37,6 à 54,8 Go de RAM plus VRAM : 12 Go de VRAM et 32 Go de RAM couvrent à peine la plus petite taille sur le papier, avant la part du système. La variante du projet orientée programmation est indiquée à environ 32 Go de RAM. Pour les tailles standard, 48 Go est le plancher pratique et 64 Go est confortable.
La vitesse de la RAM compte-t-elle ?
Oui, car le CPU calcule les experts qui ne sont pas sur le GPU. Les testeurs ont signalé la bande passante de la DDR4 et l’absence d’AVX-512 comme facteurs, mais nous n’avons pas de comparaison contrôlée.
Ai-je besoin d’un SSD NVMe ?
Pour la voie standard, il faut surtout de la place, environ 80 Go. Le NVMe compte davantage si la RAM manque et que Strata doit lire des experts sur le disque.
Puis-je utiliser AMD, Intel ou un Mac ?
Le projet liste des cartes AMD Radeon prises en charge, Intel Arc sous Linux, Apple Silicon sous macOS 15 ou plus récent, Ryzen AI Max et DGX Spark, chacun avec son guide. Consultez le guide d’installation pour votre carte.
Deux petits GPU valent-ils mieux qu’un gros ?
Un testeur a mesuré deux RTX 3060 à 45,0 jetons par seconde pour Q2_0, contre des chiffres dans les 40 pour des cartes seules chez d’autres testeurs ; le gain n’est donc pas évident sur cette taille. Il peut aider davantage avec de plus grandes tailles, mais nous n’avons trouvé aucune comparaison contrôlée.
Parlons-en
Vous planifiez une machine autour d’un GPU, de la RAM et d’un budget ? Rejoignez la communauté ou écrivez à admin@microaione.com en nous disant ce que vous avez.