Installer Strata : guide pas à pas pour l’utiliser à côté d’Ollama sous Windows ou Linux
Mis à jour le 2026-11-04. Ce guide pour installer Strata suit la documentation du projet (INSTALL.md et TERMINAL_LAUNCH.md) à la version v0.2.10. Nous n’avons pas exécuté l’installeur nous-mêmes : chaque étape est donc attribuée à sa source, et il vous faut lire la documentation actuelle avant de commencer.
Si vous utilisez déjà Ollama et voulez installer Strata pour essayer un très grand modèle comme Qwen3.8-Flash-Next, la bonne nouvelle est que les deux ne se disputent ni les ports ni les dossiers de modèles. La mauvaise est qu’ils se disputent la mémoire graphique et la RAM. Ce guide couvre les vérifications préalables, les deux façons d’installer, les commandes utiles, la connexion des outils de programmation, la cohabitation avec Ollama et ce qui, selon les testeurs, tourne mal. Si vous hésitez encore sur votre besoin, lisez d’abord notre comparaison Strata vs Ollama.
Avant de commencer
| Vérification | Ce que dit la documentation |
|---|---|
| Système d’exploitation | Windows 10/11 ou Linux x86-64 pour les cartes NVIDIA RTX ; macOS 15 ou plus récent sur Apple Silicon ; Linux pour Intel Arc ; guides séparés pour AMD Radeon, Ryzen AI Max et DGX Spark |
| Pilote NVIDIA | Les paquets CUDA 13 demandent le pilote 580 ou plus récent ; les cartes plus anciennes utilisent un moteur CUDA 12 |
| Mémoire GPU | 12 Go ou plus recommandés pour Qwen3.8-Flash-Next |
| RAM | Dépend de la taille choisie, d’environ 38 à 55 Go pour le seul modèle ; voir la section suivante |
| Disque | Environ 80 Go libres sur un SSD, d’après un testeur qui a suivi la documentation ; DeepSeek V4.1-Flash en demande bien plus |
| Internet | Nécessaire pour télécharger les modèles et les mises à jour du moteur |
Installez d’abord un pilote graphique ; les paquets de Strata ne le remplacent pas. Fermez ensuite les autres programmes gourmands en GPU. La planification de la mémoire est traitée dans notre article sur la configuration requise.
Installer Strata : deux méthodes
| Application de bureau | Terminal | |
|---|---|---|
| Idéal pour | Une fenêtre avec discussion et réglages | Outils de programmation, serveurs et scripts |
| Comment | Télécharger l’installeur de la dernière version : un setup Windows .exe (sans droits d’administrateur), un AppImage Linux ou un .dmg macOS |
Exécuter l’installeur d’une ligne, puis strata launch |
| Moteur | Téléchargé au premier démarrage pour votre GPU | Récupéré avec le premier modèle, signature vérifiée et démarrage d’essai |
Pour le terminal, la documentation donne une commande pour Linux et macOS qui enregistre d’abord le script puis l’exécute, et une commande PowerShell pour Windows. Ouvrez le script et lisez-le avant de l’exécuter ; il s’exécute avec vos droits d’utilisateur.
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
Dans PowerShell sous Windows, la ligne documentée est irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex ; si vous préférez, téléchargez le fichier, lisez-le puis exécutez-le. Ouvrez ensuite un nouveau terminal pour que strata soit dans le PATH. Si un AppImage ne démarre pas faute de FUSE, la documentation suggère de l’exécuter avec --appimage-extract-and-run.
Pas à pas dans le terminal
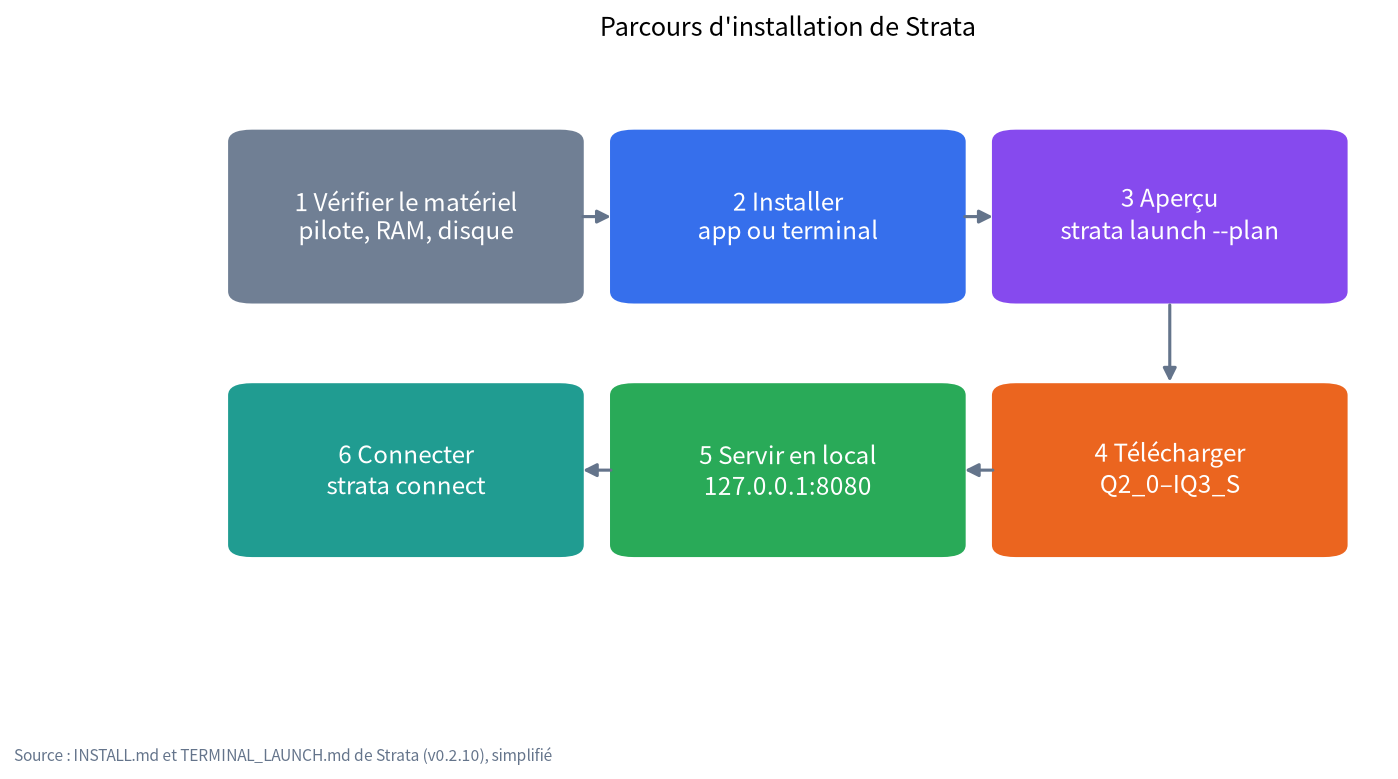
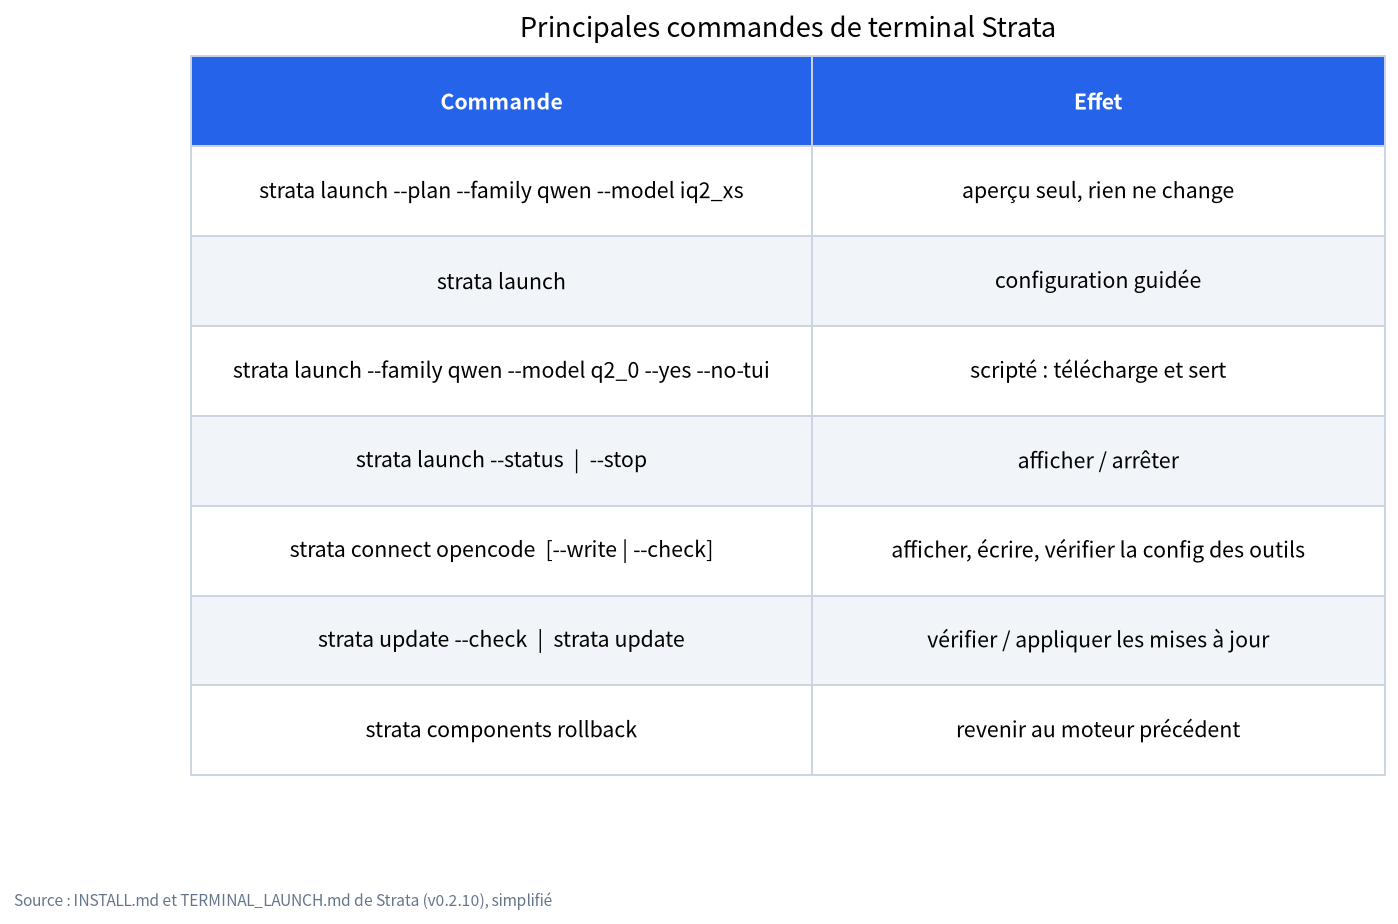
- D’abord l’aperçu.
strata launch --plan --family qwen --model iq2_xsaffiche ce qui se passerait et ne change rien. Il vous dit aussi ce qui manque. - Configuration guidée. Lancez
strata launchet suivez les écrans : modèle, dossier, contexte (8K à 512K), images, requêtes parallèles, réglage, accès et un préréglage enregistré. Pour les requêtes parallèles, la valeur par défaut s’adapte à votre carte : 1 sur un GPU de 12 Go, 2 sur 20 Go, 3 sur 24 Go et 4 à partir de 32 Go. Le réglage rapide prend environ 20 minutes et est facultatif. - Configuration par script.
strata launch --family qwen --model q2_0 --yes --no-tuitélécharge, sert, affiche l’adresse et rend la main.strata launch --statusmontre ce qui tourne etstrata launch --stopl’arrête.
Quelle taille choisir
| Taille | RAM + VRAM pour le modèle | La description de la documentation |
|---|---|---|
| Q2_0 | 37,6 Go | La plus rapide, bonne qualité |
| IQ2_XS | 39,2 Go | Rapide, meilleure qualité |
| IQ3_XXS | 47,0 Go | Plus lente, très bonne qualité |
| IQ3_S | 54,8 Go | La plus lente, la meilleure qualité ; la documentation dit qu’elle égale le modèle complet sur les tests publiés |
Laissez de la mémoire au système d’exploitation. Sur une carte de 12 Go avec 64 Go de RAM, les testeurs ont utilisé IQ2_XS et IQ3_S. PC Watch a trouvé les courtes discussions confortables avec IQ2_XS mais la génération de code un cran en dessous d’IQ3_S ; choisissez donc la plus grande taille si vous programmez et avez la RAM.
Vérifier que le serveur fonctionne
L’adresse par défaut est http://127.0.0.1:8080. Strata expose /health, /v1/models, le chemin OpenAI Chat Completions /v1/chat/completions, le chemin Anthropic /v1/messages et un chemin Responses.
curl http://127.0.0.1:8080/health
curl http://127.0.0.1:8080/v1/models
Utilisez dans votre client le nom de modèle renvoyé par /v1/models. Tout client compatible OpenAI, y compris Open WebUI (voir notre guide Open WebUI), peut pointer vers http://127.0.0.1:8080/v1. Le serveur n’écoute que sur votre PC. Si vous l’ouvrez à votre réseau, à un tunnel Cloudflare ou à Tailscale, définissez une clé d’API : sans elle, quiconque atteint le port peut utiliser le modèle et ses outils. Notre guide du serveur d’API de LLM local couvre les règles générales de sécurité.
Connecter des outils de programmation avec strata connect
strata connect liste OpenCode, Codex CLI, Claude Code, oh-my-pi, pi, Hermes Agent et OpenClaw. strata connect opencode affiche la configuration, --write l’écrit après confirmation (ce qui est remplacé est sauvegardé) et --check envoie un prompt et un appel d’outil comme le ferait cette application. La documentation énumère des limites connues : Claude Code a besoin du réglage CLAUDE_CODE_MAX_CONTEXT_TOKENS, OpenCode a besoin de limit.input, Hermes refuse les fenêtres de moins de 64K sauf configuration et OpenClaw exige Node 24.16 ou plus récent. Un testeur utilisant OpenCode a vu un appel d’outil émis en texte brut terminer une tâche trop tôt et l’a corrigé avec l’option tool_call_recovery de Strata ; lisez ce rapport.
Faire tourner Strata à côté d’Ollama
| Sujet | Strata | Ollama | Que faire |
|---|---|---|---|
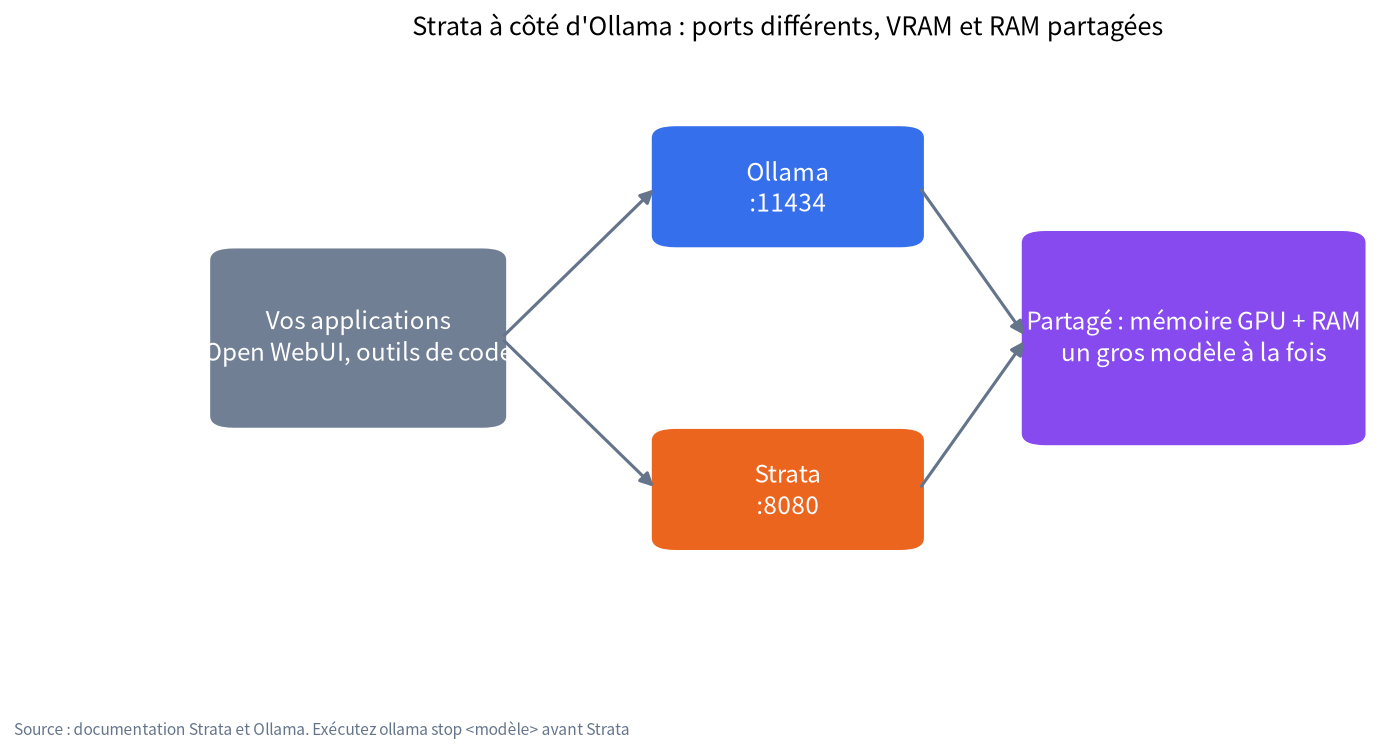
| Port par défaut | 8080 | 11434 | Pas de conflit. Changez --port de Strata si un autre outil utilise déjà 8080 |
| Fichiers de modèles | Son propre dossier d’installation (~/.local/share/strata/install sous Linux, %LOCALAPPDATA%\Strata\install sous Windows) |
Le dossier de modèles d’Ollama ; voir notre guide du chemin des modèles Ollama | Gardez-les séparés ; la documentation de Strata ne décrit aucun import depuis Ollama |
| Mémoire GPU | Remplit la VRAM avec un cache d’experts | Charge un modèle à la demande et le décharge après un temps d’inactivité | Exécutez ollama stop <modèle> avant de démarrer Strata |
| RAM | Épingle tous les experts en RAM | Charge par modèle | N’exécutez pas deux gros modèles à la fois |
strata models import PATH --plan de Strata reconnaît des ensembles de fichiers précis qu’installe Strata lui-même ; rien n’est copié ni déplacé. Nous n’avons rien trouvé dans la documentation sur la réutilisation des fichiers de modèles téléchargés par Ollama : supposez donc que vous téléchargerez les paquets de Strata séparément. Pour Ollama lui-même, voir notre guide d’installation d’Ollama.
Dépannage d’après des rapports publics
| Symptôme | Cause probable | Ce qu’ont fait les testeurs |
|---|---|---|
| Première minute très lente | Moteur et paquets en cours de téléchargement ou de chargement | Attendre, puis vérifier strata launch --status |
| Le système rame, le swap grossit | Pas assez de RAM pour la taille | Choisir une taille plus petite ou fermer des applications ; un portable de 30 Go de RAM a swappé 4 à 5 Go |
| Longue réflexion sans réponse | Le raisonnement s’emballe | Un testeur sous Proxmox a fixé un budget de raisonnement de 4 096 jetons et gardé IQ3_S |
| Premier jeton lent sur de longs fichiers | Préremplissage sur une carte de 12 Go | Contexte plus court ou prompts plus petits ; PC Watch a vu environ 25 s pour 23k jetons |
| Des réglages semblent cachés | Certaines options sont dans settings.json |
Un utilisateur japonais sur note.com les a trouvées non documentées à l’époque ; consultez la documentation actuelle |
| Port déjà utilisé | Un autre serveur sur 8080, comme llama-server |
Passer un autre --port |
Une liste de contrôle sûre pour le premier lancement
Strata étant récent et changeant vite, quelques habitudes évitent des ennuis.
- Utilisez d’abord une machine de test ou un compte utilisateur propre. L’installeur est pratique, mais vous exécutez le script de quelqu’un d’autre, et le projet dit lui-même n’avoir pas eu d’audit de sécurité externe.
- Lancez le plan avant le téléchargement.
strata launch --planmontre quels fichiers seront récupérés et leur taille, pour ne pas découvrir un disque plein après 30 Go de téléchargement. - Commencez par la plus petite taille. Q2_0 ou IQ2_XS montre si votre RAM, votre pilote et votre refroidissement tiennent avant de vous engager sur les gros paquets.
- Restez sur localhost. Laissez l’accès sur « cet ordinateur uniquement » jusqu’à ce que le modèle fonctionne. Si vous partagez plus tard, activez la clé d’API.
- Notez ce qui marche. Enregistrez un préréglage nommé pour redémarrer avec les mêmes réglages après une mise à jour.
- Surveillez températures et mémoire. Le SSD d’un testeur a lu environ 6,9 To en 1,3 heure et le portable d’un autre a swappé ; une fenêtre de moniteur ou l’onglet de surveillance de Strata montrera les problèmes tôt.
Mise à jour
Dans le terminal, strata update --check et strata update gèrent les mises à jour du moteur ; avec un modèle chargé, la commande demande confirmation avant de l’arrêter. strata components rollback revient au moteur précédent. Dans l’application, utilisez les commandes de mise à jour des Réglages. Les versions arrivant tous les deux jours environ, lisez les notes de version avant de mettre à jour une configuration qui fonctionne.
Ce que nous avons fait et ce que nous n’avons pas fait
Le 2026-11-04, nous avons lu les documents INSTALL, de terminal et de modèles du projet ainsi que les rapports de tiers liés ci-dessus. Nous n’avons pas installé Strata : aucune commande d’ici n’a donc été exécutée par nous. Les numéros de version et les options changent vite ; fiez-vous à strata launch --help plus qu’à cette page.
Questions fréquentes (FAQ)
Strata et Ollama peuvent-ils tourner en même temps ?
Oui, sur des ports différents, mais ils partagent la mémoire GPU et la RAM. Arrêtez le modèle d’Ollama avant de charger un gros modèle dans Strata.
Dois-je d’abord désinstaller Ollama ?
Non. Ils utilisent des ports et des dossiers de modèles différents.
Strata peut-il réutiliser les modèles que j’ai déjà téléchargés avec Ollama ?
Nous n’avons trouvé aucun import documenté depuis Ollama. Strata télécharge ses propres paquets : prévoyez donc de l’espace disque supplémentaire.
De combien d’espace disque ai-je besoin ?
Environ 80 Go libres pour Qwen3.8-Flash-Next selon un testeur qui a suivi la documentation, et 239 à 274 Go pour DeepSeek V4.1-Flash selon le projet.
Est-il sûr d’exécuter l’installeur d’une ligne ?
C’est un script qui s’exécute avec vos droits d’utilisateur. Enregistrez-le, lisez-le et ne téléchargez que depuis le dépôt officiel. Le projet dit n’envoyer aucune télémétrie, mais aussi n’avoir pas eu d’audit de sécurité externe.
Quelle adresse mes applications utilisent-elles ?
http://127.0.0.1:8080/v1 pour les clients compatibles OpenAI. Utilisez le nom de modèle affiché par /v1/models.
Parlons-en
Bloqué sur un pilote, une limite de mémoire ou une connexion ? Rejoignez la communauté ou écrivez à admin@microaione.com avec votre GPU, votre RAM et le texte de l’erreur. Si vous préférez une machine testée, consultez notre guide des machines et solutions.