本地大模型推荐(2026 年 10 月):按显存和用途选,不按榜单选
时效说明:模型每个月都在更新,本文是 2026-10-30 的快照。文件大小和上下文窗口来自 Ollama 模型库页面,显存估算来自第三方的 CanRun 估算表,二者都不是我们自己的实测。本文不引用任何跑分榜单的数字,也没有我们自己的基准测试,选型建议是基于体积、官方描述和显存估算的“能不能放下、适不适合”的判断。下载前请务必阅读模型卡和许可证。
“有什么好用的开源模型”是社区里被问得最多的问题。但没有脱离硬件的最好模型,只有最适合你显存和用途的模型。所以这篇 本地大模型推荐 采取另一种思路:先看你的显存,再看你要做什么,最后才决定模型。选好之后,再按《Ollama 安装教程》装好工具。还不熟悉基本概念的话,可以先读《本地大模型是什么》。
先问三个问题,再选模型
- 你的可用显存(或统一内存)是多少? 这决定了模型体量的上限,见《大模型显存需求怎么算》。
- 你主要做什么? 日常问答、写作、编程、长文档、看图、多步推理,对模型类型的要求不同。
- 你需要多长的上下文? 上下文越长,KV 缓存越大,同一个模型需要更多显存。
本地大模型推荐:按显存档位对号入座
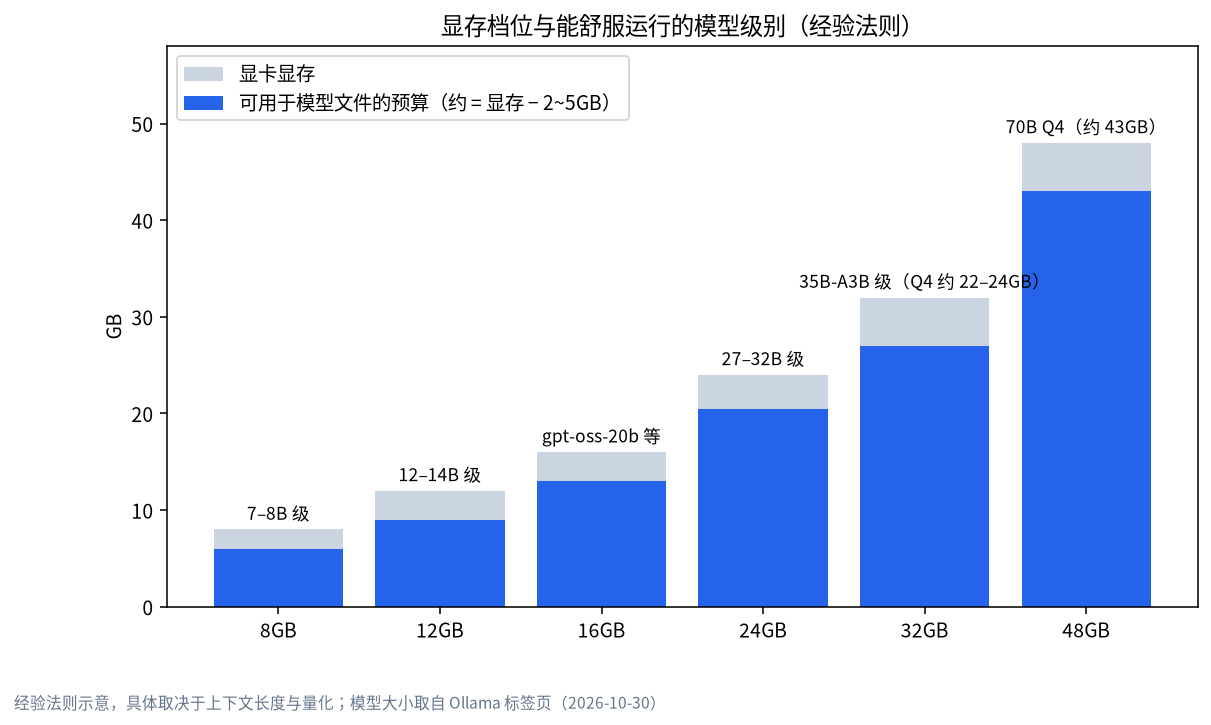
下表使用 CanRun 的估算(Q4_K_M 量化、8K 上下文、f16 KV 缓存,权重加缓存的总量)。这是第三方估算,真实占用会因运行时和设置有差异;同一站点还提示可用显存低于标称,8GB 卡约 7.4GB,12GB 约 11.4GB,24GB 约 23.4GB,32GB 的 RTX 5090 约 31.4GB。
| 显存档位(可用约) | 可以考虑的模型 | CanRun 估算总量 | 说明 |
|---|---|---|---|
| 8GB(约 7.4GB) | Llama 3.1 8B | 6.3GB | 8K 上下文下勉强放下,留的余量不多 |
| 8GB | Gemma 4 12B | 7.8GB | 略超可用显存,会部分放到内存,速度下降 |
| 12GB(约 11.4GB) | Gemma 3 12B | 8.4GB | 余量较大,可适当加长上下文 |
| 12GB | Qwen3 14B | 10.5GB | 接近上限,别开太长上下文 |
| 16GB(按同样规律推算约 15.4GB) | gpt-oss-20b | 12.3GB | 12GB 卡放不下,16GB 卡较舒适 |
| 24GB(约 23.4GB) | Qwen3.6 27B | 17.2GB | 留出约 6GB 给更长上下文 |
| 24GB | Gemma 4 26B-A4B | 17.7GB | 混合专家结构,总参数大但每次激活较少 |
| 24GB | Gemma 4 31B | 19.5GB | 比 27B 档更大,余量紧一些 |
| 24GB | Qwen3 30B-A3B | 19.8GB | 混合专家结构 |
| 24GB | Qwen3.6 35B-A3B | 21.8GB | 接近上限,只适合短上下文 |
| 24GB | Qwen3 32B | 22.0GB | 几乎占满,上下文要克制 |
| 64GB 以上统一内存或多卡 | Llama 3.3 70B | 45.2GB | 单张 24GB 或 32GB 显卡放不下 |
| 96GB 以上统一内存或多卡 | gpt-oss-120b | 63.6GB | 估算总量已超 64GB,需要更大的内存空间 |
注意:16GB 一行的“可用约 15.4GB”是我们按 8GB、12GB、24GB 三档的规律推算的,不是 CanRun 给出的数字,请当作估计。
按用途推荐:从官方描述出发
下面的用途分类依据 Ollama 模型库和官方模型卡的描述,我们没有做对比评测,所以只讲“适合什么场景”,不给分数。
| 用途 | 可以先试的模型系列 | 为什么 | 注意点 |
|---|---|---|---|
| 日常问答、写作 | Qwen3.6、Gemma 4、Llama 3.1 8B(小显存) | 体量选择多,覆盖 8GB 到 24GB 以上 | 先从你显存能放下的最大一档开始试 |
| 编程与智能体 | Qwen3-Coder(30b,Ollama 文件约 19GB)、gpt-oss | Qwen3-Coder 是面向编程的系列;gpt-oss 官方描述面向推理和智能体任务 | 编程和智能体建议上下文至少 64000 token,显存要多留 |
| 多步推理 | gpt-oss、DeepSeek-R1 蒸馏版、Qwen 系列的思考模式 | 官方描述强调推理能力 | 会输出很长的思考过程,速度和成本要有预期 |
| 看图、识别截图 | Gemma 4、Qwen3.5/3.6/3.8、Qwen3-VL | Ollama 页面标注这些系列支持图像输入 | 图像输入同样占显存,需要比较新的 Ollama 版本 |
| 小显存、低配机器 | Llama 3.1 8B、Qwen3 4B/8B、Gemma 4 的 e2b/e4b | 文件在 2.5GB 到 9.5GB 之间 | 能力有限,别指望完成复杂任务 |
| 大内存的 Mac 或工作站 | Llama 3.3 70B、gpt-oss-120b、Qwen3.5 122b | 体量大 | 单卡放不下,需要大容量统一内存,见《Mac 跑大模型怎么选》 |
几个主要系列的要点
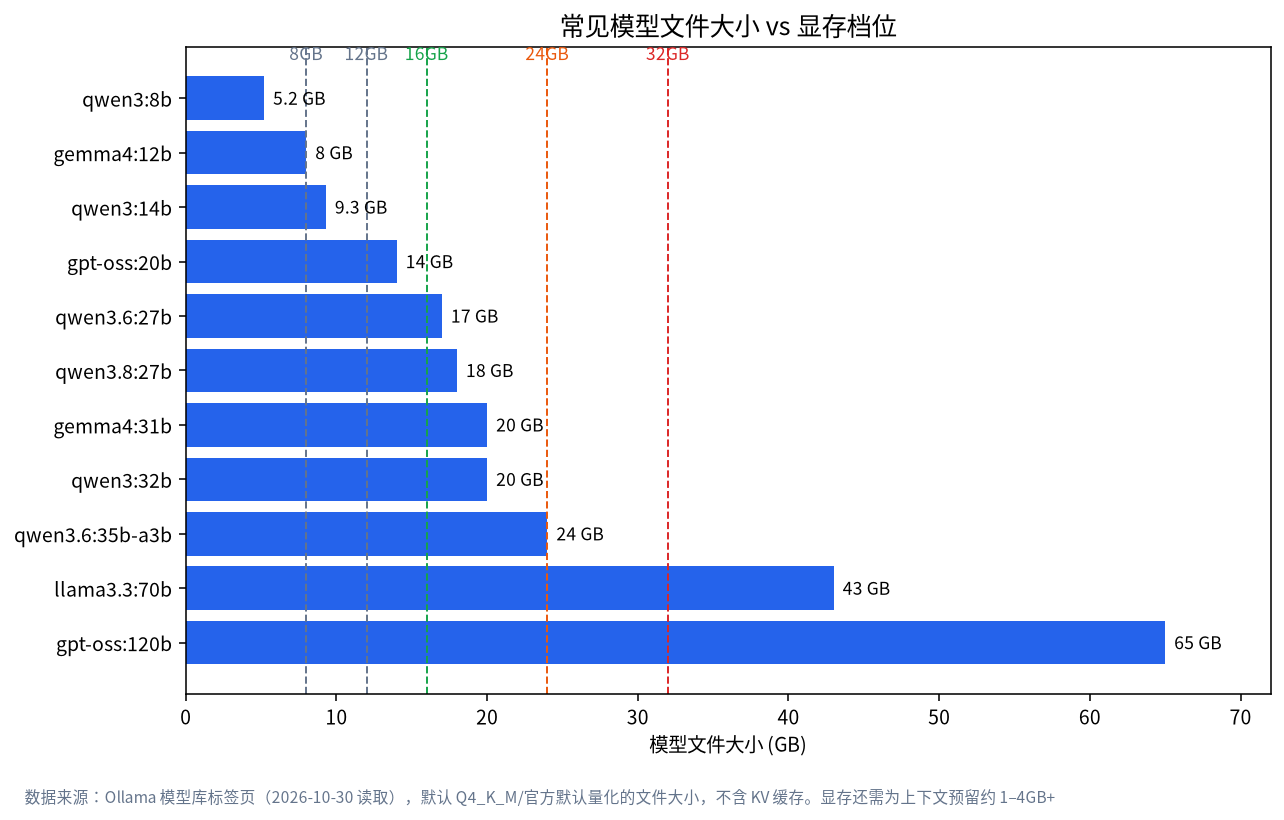
下面的文件大小是 Ollama 模型库页面 2026-10-30 读取的默认或主要标签的大小,仅文件本身,不含上下文缓存。
Qwen(通义千问)系列
| 系列 | 主要体量与文件大小 | 上下文 | 输入 |
|---|---|---|---|
| Qwen3 | 0.6b 523MB、8b 5.2GB、14b 9.3GB、30b 19GB、32b 20GB | 多数 40K,部分 256K | 文本 |
| Qwen3.5 | 4b 约 3.3GB、9b 6.6–7.6GB、27b 17–20GB、35b 22GB | 256K | 文本与图像 |
| Qwen3.6 | 27b 18–19GB、35b 23GB | 256K | 文本与图像 |
| Qwen3.8 | 27b 18GB | 256K | 文本与图像 |
Qwen3、Qwen3.6、Qwen3.8 在各自模型卡上标注的是 Apache-2.0 许可(Qwen3.6-27B 的 Hugging Face 页面我们专门复核过),Qwen3.5 的许可我们没有单独核对。Qwen3.8 默认开启思考模式,可以按请求关闭。具体部署方法见《Qwen 本地部署》。
Gemma 4 系列
Ollama 页面上的 gemma4 标签包括 e2b(4.6–7.5GB)、e4b(6.6–9.5GB,也是默认标签)、12b(7.7–8.0GB)、26b(16–19GB)和 31b(19–20GB),能力标注为文本和图像输入,e 系列上下文 128K,12b 以上是 256K。我们读到的信息是 Gemma 4 采用 Apache-2.0 许可,请以模型卡为准。
gpt-oss 系列
gpt-oss 有 20b(14GB)和 120b(65GB)两个体量,上下文 128K,仅文本输入,页面标注支持工具调用和思考。官方页面写明采用宽松的 Apache 2.0 许可。20b 是 16GB 显存档的有趣选择。
DeepSeek 与 Llama
DeepSeek-R1 的权重采用 MIT 许可,Ollama 上提供的 1.5b 到 70b 是蒸馏版,671b 才是原版体量,和我们在《DeepSeek 本地部署》里解释的一样:别把小蒸馏版当成满血版。Llama 3.3 70B 使用的是 Llama 3.3 社区许可,不是常见的 Apache 或 MIT,商业使用前请读条款,另外 Ollama 上它的文件约 43GB,需要大内存。
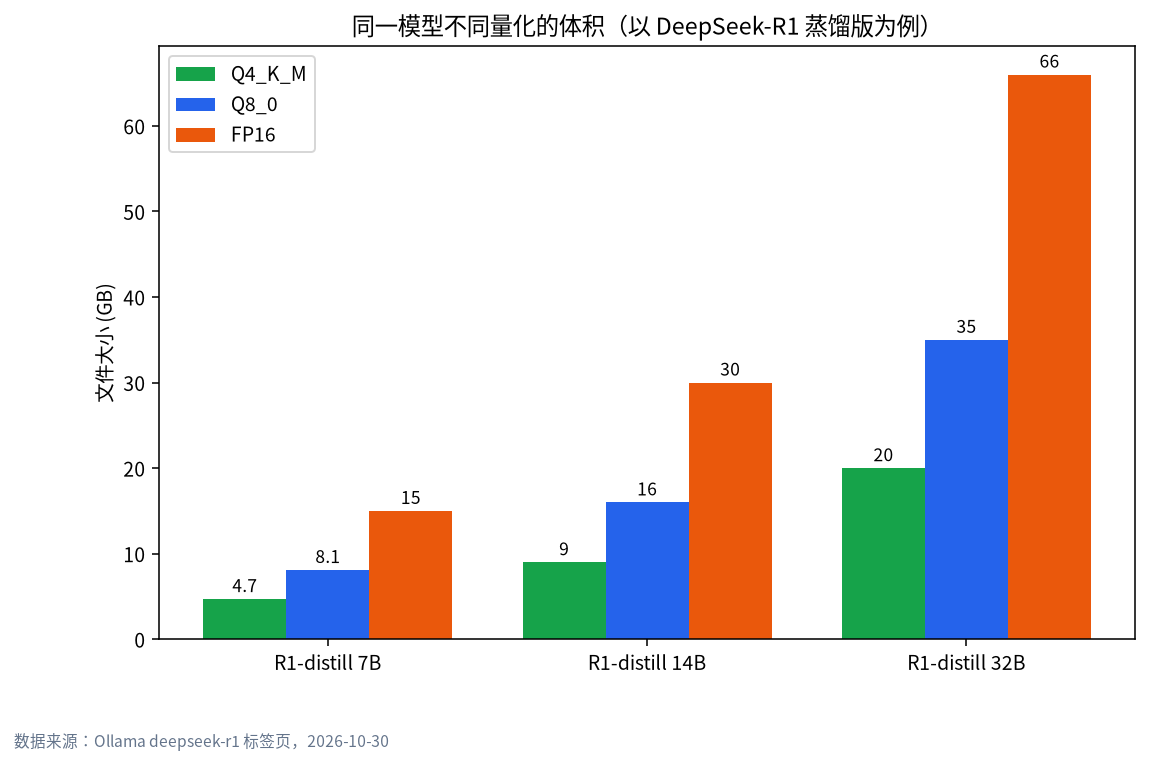
量化会改变“能不能放下”的结论
同一个模型,不同量化档位的体积差别很大。以 Ollama 上的标签为例,qwen3.6:27b 的 Q4_K_M 约 17GB,Q8_0 约 30GB,BF16 约 56GB。所以 24GB 显存可以放 27B 的 Q4_K_M,却放不下 Q8_0。Q4_K_M 是多数人的起点,具体怎么读这个名字、怎么选档位,见《大模型量化与 Q4_K_M》。
许可证速查表
| 模型系列 | 许可(以模型卡为准) | 备注 |
|---|---|---|
| Qwen3、Qwen3.6、Qwen3.8 | Apache-2.0 | Qwen3.5 的许可我们没有单独核对 |
| Gemma 4 | Apache-2.0(我们读到的信息) | 请以模型卡为准 |
| gpt-oss | Apache 2.0 | Ollama 页面明确标注 |
| DeepSeek-R1 | MIT | 蒸馏版另有其基座模型的许可,Ollama 页面有说明 |
| Llama 3.3 | Llama 3.3 社区许可 | 非 Apache/MIT,商用请读条款 |
许可是做产品或商用时最容易被忽略的一环,请读模型卡原文,而不是只看我们这张表。
选型时最常见的三个误区
误区一:参数越大越好。 放不下显存的大模型会有一部分跑在内存里,速度大幅下降,体验往往不如能完整放进显存的小一档模型。误区二:只看模型文件大小。 文件大小只是权重,运行时还要加上上下文缓存和运行时开销,24GB 卡放 20GB 的文件并不稳。误区三:把混合专家模型当成小模型。 名字里带 A3B、A4B 的模型每次只激活一部分参数,但全部权重仍然要放进显存,所以体积看总参数,不看激活参数。
如何自己做一次公平的对比
我们不提供跑分,因为你的任务才是最重要的评判标准。你可以用一个简单的方法:
- 准备 10 个真实任务,比如你平时会问的问题、一段想总结的文档、一个想改的函数。
- 对每个候选模型使用同样的提示词和同样的上下文长度。
- 记录三件事:答案是否可用、第一个 token 出来要多久、生成速度。
- 用
ollama ps确认模型是否完整放在 GPU 上,避免混入 CPU 的干扰。 - 把结果记在表格里,下次出新版本时用同样的 10 个任务再跑一遍。
怎样跟上新模型而不被“信息轰炸”
模型更新太快,追着每个新名字跑没有意义。我们建议一个节奏:每个月最多挑一个你显存档位里新出的候选,用上面的 10 个任务比一次,不如现有模型就删掉,更好才替换。多留意 Ollama 模型库的更新日期和模型卡里的说明,不要被社交媒体上的单一截图左右。如果你的显存不够新模型的最低体量,与其折腾量化,不如考虑升级硬件,见《本地大模型显卡推荐》和《本地大模型装机配置》。
常见问题(FAQ)
现在最好的本地大模型是哪个?
没有脱离硬件的最好。8GB 档可以先试 8B 左右的模型,24GB 档可以试 Qwen3.6 27B、Gemma 4 26B/31B 这一类,选哪个取决于你的任务和上下文长度。
8GB 显存推荐什么模型?
8GB 卡实际可用约 7.4GB,Llama 3.1 8B(CanRun 估算约 6.3GB)是比较稳的选择,详细见《8GB 显存跑大模型》。
24GB 显存推荐什么模型?
27B 到 35B 之间的 Q4_K_M 模型是甜蜜点,估算总量在 17GB 到 22GB 之间,具体取舍见《24GB 显存跑大模型》。
中文用哪个模型?
中文的效果因任务而异,我们没有自己的评测数据。建议用上面的 10 个任务法,用你自己的中文任务比较 Qwen 系列和 Gemma 4 等候选。
开源模型可以商用吗?
要看许可。上面表格里的 Apache-2.0 和 MIT 对商用较友好,但 Llama 3.3 使用社区许可,另有使用政策。请以模型卡为准,必要时咨询法务。
新模型出来了,要马上换吗?
不必。先用自己的任务对比,不比现有的好就不换。新版本往往体积也变了,要先确认你的显存放得下。
下一步与社区
把你的显卡型号或内存大小,以及你主要的使用场景(写作、编程、看图等)发到社区(加入社区),我们和其他成员会帮你缩小候选范围。我们在深圳做本地大模型机器的选型、采购、组装与实测,想按这些模型反推整机配置,也可以来聊;先聊需求,不强制购买。