
大模型量化是什么:Q4_K_M 怎么读、不同量化档位怎么选
核对说明:量化档位的大小与速度数据取自 llama.cpp 官方 quantize 文档里的表格(以 Llama-3.1-8B 为例;文档摘录未写明测试硬件,速度只用于看趋势);Ollama 文件大小读自官方页面(2026-10-30)。我们没有自己跑质量评测,不给“Q4 掉多少分”这类没有来源的数字。
如果你下载过本地模型,一定见过 Q4_K_M、Q8_0、Q5_K_S 这些后缀,却不知道它们是什么、该怎么选。这篇文章专门讲 大模型量化:它是什么、为什么本地部署几乎都用它、Q4_K_M 这个名字怎么读、各档位在大小和速度上有什么差别,以及你的显卡该选哪一档。想知道显存怎么算,可以配合《大模型显存需求怎么算》一起看。
大模型量化是什么:用更少的位数存权重
模型的权重本来是高精度的浮点数(常见的是 16 位)。量化就是把它们压缩成更少的位数,例如 8 位、4 位。llama.cpp 官方文档对量化的说明是:它能缩小模型体积,并且可能加快推理;代价是可能引入一些精度损失,通常用困惑度(perplexity)和 KL 散度来衡量,而好的重要性矩阵(imatrix)可以把损失降到最低。
对本地部署来说,量化的意义很直接:显存有限,量化让更大的模型能放进去。以 llama.cpp 文档里的 Llama 3.1 为例:
| 模型 | 原始大小 | 量化后(Q4_K_M) | 压缩倍数 |
|---|---|---|---|
| 8B | 32.1GB | 4.9GB | 约 6.6 倍 |
| 70B | 280.9GB | 43.1GB | 约 6.5 倍 |
| 405B | 1,625.1GB | 249.1GB | 约 6.5 倍 |
(原始大小为 F32 级别的未量化文件,所以与 FP16 的对比倍数会小一些;压缩倍数是我们用文档数字做的除法。)
大模型量化的命名:Q4_K_M 怎么读
量化名称是几个部分拼起来的,社区通行的读法是:
| 片段 | 含义 | 例子 |
|---|---|---|
| Q 后面的数字 | 大约每个权重用多少位 | Q4 约 4 位,Q8 约 8 位 |
| K | 采用 k-quant(分块的混合量化方案) | Q4_K 比老的 Q4_0 更精细 |
| S / M / L | 同一档位里的小、中、大(Small/Medium/Large) | Q4_K_S 更小,Q4_K_M 居中 |
| IQ 开头 | i-quant,更适合低位数的量化 | IQ4_XS、IQ3_M |
_0 |
较老的简单方案 | Q8_0、Q4_0 |
所以 Q4_K_M 的意思是“约 4 位、k-quant、中等版本”。注意“约 4 位”是平均值:llama.cpp 文档里 Llama-3.1-8B 的 Q4_K_M 实测是 4.89 位每权重,而不是整整 4 位,因为不同层会混合使用不同精度。
量化档位对照:大小与速度
下表来自 llama.cpp 官方 quantize 文档,模型是 Llama-3.1-8B,大小的单位是 GiB,速度是“文本生成 token/秒”(文档摘录未注明测试硬件,请只看趋势):
| 量化档位 | 每权重位数 | 文件大小(GiB) | 生成速度(t/s) | 与 F16 大小之比 |
|---|---|---|---|---|
| F16(未量化) | 16.00 | 14.96 | 29.17 | 100% |
| Q8_0 | 8.50 | 7.95 | 50.93 | 约 53% |
| Q6_K | 6.56 | 6.14 | 58.67 | 约 41% |
| Q5_K_M | 5.70 | 5.33 | 67.23 | 约 36% |
| Q4_K_M | 4.89 | 4.58 | 71.93 | 约 31% |
| IQ4_XS | 4.46 | 4.17 | 77.51 | 约 28% |
| Q3_K_M | 4.00 | 3.74 | 71.68 | 约 25% |
| Q2_K | 3.16 | 2.95 | 79.85 | 约 20% |
| IQ2_M | 2.93 | 2.74 | 74.44 | 约 18% |
| IQ1_S | 2.00 | 1.87 | 79.73 | 约 13% |
从表里能看到两个规律:第一,文件大小基本与位数成正比;第二,生成速度大体随文件变小而变快(因为生成时主要受内存带宽限制,要读的数据少了就更快),但低位数档位并不总是更快。需要强调的是,表里没有质量数据:位数越低质量损失越大,但损失多少取决于模型和任务,我们不编造数字。
大小也可以自己算:权重大小约等于“参数量 × 每权重位数 ÷ 8”。例如 Llama-3.1-8B 有约 80.3 亿参数,Q4_K_M 约 4.89 位,80.3 亿 × 4.89 ÷ 8 约等于 49.1 亿字节,约 4.58 GiB,与表里一致。
为什么大多数人选 Q4_K_M
三个原因:它把大小压到约三分之一,而多数使用场景里质量仍然够用;Ollama 默认采用的就是这一档;Hugging Face 的文档也说明,用 Ollama 运行 GGUF 时,仓库里有 Q4_K_M 就默认选它,没有才会挑一个合适的档位。也就是说它是整个生态的“默认值”,遇到的资料、教程和问题最多。
但“够用”不是“最好”。如果你的显存有富余,可以考虑 Q5_K_M 或 Q6_K 换取更高的精度;如果你的显存不够,才往 Q3、Q2 甚至 IQ 系列退。具体怎么在显存紧张时取舍,见下一节。
按显存选择量化档位
| 你的情况 | 建议档位 | 理由 |
|---|---|---|
| 显存刚好放得下 Q4_K_M,上下文也要长 | Q4_K_M,再量化 KV 缓存 | 把空间留给上下文 |
| Q4_K_M 放得下,还有 2GB 以上余量 | Q5_K_M 或 Q6_K | 用空间换精度 |
| 放得下 Q8_0(如小模型) | Q8_0 | 接近未量化的精度 |
| Q4_K_M 放不下,差一点 | 先换更小的模型,再考虑 IQ4_XS、Q3_K_M | 优先换模型,而不是硬压 |
| 需要极限压缩 | Q2_K 或 IQ2 系列 | 质量下降明显,只在实在放不下时使用 |
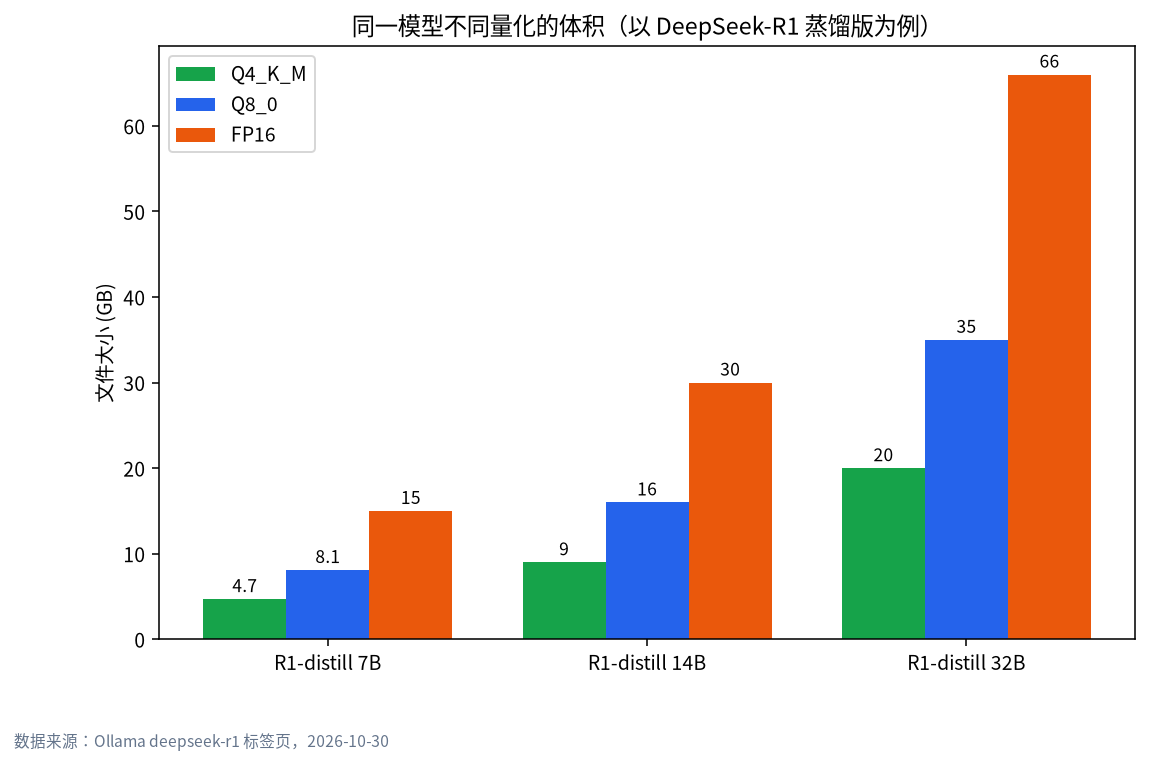
Ollama 页面上的几个真实例子(2026-10-30):
| 模型 | Q4_K_M | Q8_0 | BF16/FP16 |
|---|---|---|---|
qwen3.6:27b |
17GB | 30GB | 56GB |
qwen3:32b |
20GB | 35GB | 66GB |
qwen3:30b-a3b |
19GB | 33GB | 61GB |
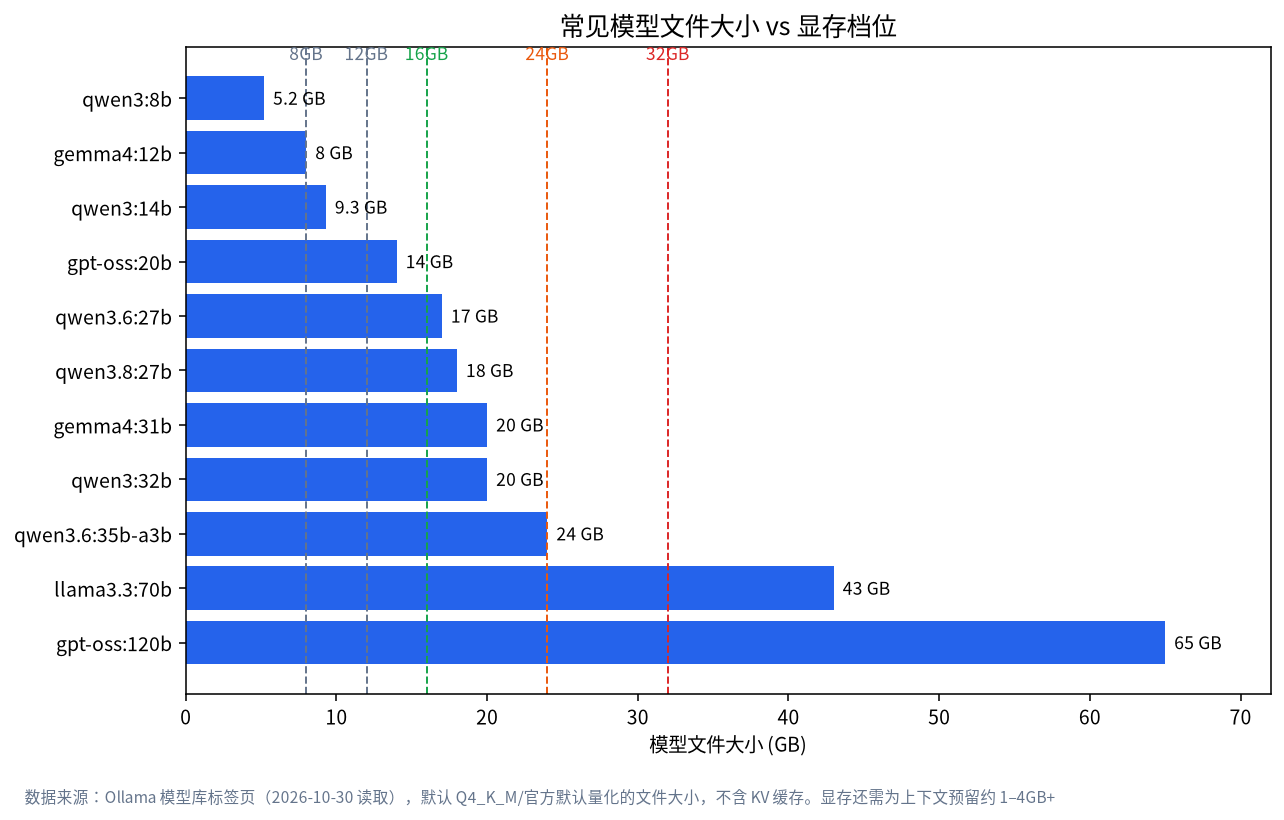
可见在 24GB 显卡上,这些模型只有 Q4_K_M 放得下,Q8_0 需要 32GB 以上的显卡,详细分析见《24GB 显存跑大模型》。而 8GB 显卡则要从更小的模型入手,见《8GB 显存跑大模型》。
除了权重,还可以量化 KV 缓存
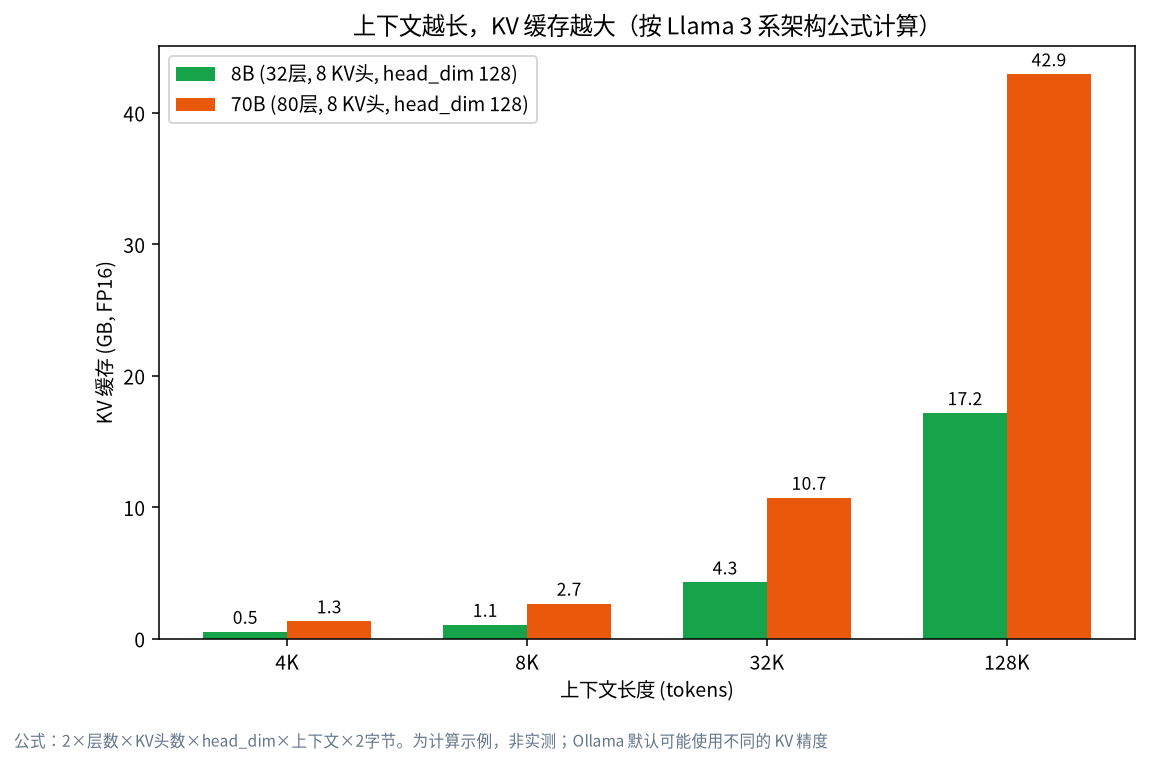
模型权重之外,上下文会产生 KV 缓存,长上下文时它能吃掉大量显存。Ollama 官方 FAQ 说明:在开启 Flash Attention(OLLAMA_FLASH_ATTENTION=1)的前提下,可以用 OLLAMA_KV_CACHE_TYPE 量化缓存:
| 类型 | 内存占用 | 精度影响(官方说明) |
|---|---|---|
f16 |
基准(默认) | 精度最高 |
q8_0 |
约为 f16 的 1/2 | 精度损失很小,通常不会有明显影响(官方推荐的折中) |
q4_0 |
约为 f16 的 1/4 | 小到中等的精度损失,在更长上下文下可能更明显 |
官方还提醒:这是全局设置,所有模型都会使用;GQA 数量高的模型(如 Qwen2)受量化影响可能更大,需要自己试。
实际怎么选到想要的量化档位
在 Ollama 官方模型库里,默认标签就是 Ollama 选的默认量化;想指定档位,可以在标签页里找到带 q4_K_M、q8_0 等后缀的标签。
如果模型只在 Hugging Face 上有 GGUF 文件,Ollama 可以直接运行:
ollama run hf.co/用户名/仓库名
ollama run hf.co/用户名/仓库名:Q8_0
第一条使用默认量化(有 Q4_K_M 就用它),第二条在冒号后指定量化档位,名称不区分大小写;也可以直接使用文件全名作为标签。LM Studio 的用法见《LM Studio 教程》,它的官方文档建议选择 4 位或更高的量化。
如果你想自己做量化,llama.cpp 提供了 llama-quantize 工具,先把原始模型转成 GGUF(建议从 16 位或 32 位的文件量化),再执行:
./llama-quantize input-model-bf16.gguf output-model-Q4_K_M.gguf Q4_K_M
文档还特别提醒:对已经量化的模型再次量化(--allow-requantize)可能严重降低质量,应该始终从高精度文件出发;多模态模型的视觉部分(mmproj)通常建议保持在 bf16 或 q8,因为小幅量化对速度和内存的帮助有限,却可能影响质量。
自己动手验证:怎么判断量化够不够用
因为没有适合所有人的质量数字,最可靠的办法是用你自己的任务做对比。一个简单的做法:
- 准备 10 个你日常真正会问的问题,覆盖写作、代码、中文理解、数学等类型。
- 分别用 Q4_K_M 和更高一档(例如 Q6_K 或 Q8_0)运行同一批问题,温度设成较低的固定值。
- 对比答案的准确性、格式遵循和胡编乱造的频率,记录下来。
- 如果差别你感觉不到,就用小的那一档,把省下的显存留给上下文。
- 如果在你最看重的任务上差别明显,就用大的那一档,或者换更小的模型。
这个方法不需要任何专业评测工具,比看别人的跑分更贴近你的需求。
常见误区
| 误区 | 实际情况 |
|---|---|
| 位数越低一定越快 | 生成速度大体随文件变小而提升,但并不是每个低位档位都更快,见上表 Q3_K_M 与 Q4_K_M 的对比 |
| 量化后质量只会变差,没法补救 | 好的 imatrix 可以降低损失,社区也有针对低位数优化的 IQ 系列 |
| Q8_0 一定比 Q4_K_M 好用 | Q8_0 更接近原始精度,但体积是两倍左右,放不下就没有意义 |
| 量化只能量化权重 | KV 缓存也可以量化,两者可以同时使用 |
| 所有模型量化后表现一样 | 影响因模型和任务而异,需要自己试 |
常见问题(FAQ)
Q4_K_M 和 Q4_K_S 有什么区别?
同样是约 4 位的 k-quant,S 是较小的版本,M 是中等版本。以 Llama-3.1-8B 为例,Q4_K_S 为 4.36GiB、Q4_K_M 为 4.58GiB,M 稍大,通常精度略好。
量化会让模型变笨多少?
没有统一答案,取决于模型、任务和档位。官方文档只说“可能引入一些精度损失”,建议用困惑度或 KL 散度衡量;我们不编造具体数字。
8GB 显卡应该选哪个量化?
先选更小的模型(7B–9B)配 Q4_K_M,而不是用更低的量化硬塞大模型,详见《8GB 显存跑大模型》。
Q5 和 Q6 值得吗?
如果显存有富余,值得;如果显存很紧,把空间留给上下文通常更有价值。
GGUF 是什么?
GGUF 是 llama.cpp 生态使用的模型文件格式,Hugging Face 上有大量社区制作的 GGUF 量化文件,Ollama 与 LM Studio 都能直接使用。
KV 缓存量化会影响答案质量吗?
官方说明 q8_0 精度损失很小,q4_0 可能在更长上下文下更明显,需要按你的模型和任务实测。
下一步与社区
量化选得好,同一张显卡能多跑一个档位的模型。欢迎把你的显卡型号和想跑的模型发到社区(加入社区),大家一起算一算。我们在深圳做本地大模型机器的选型、采购、组装与实测,也可以帮你判断哪种配置更合适;先聊需求,不强制购买。