
Mac 跑大模型:统一内存怎么选、能跑多大的模型
核对说明:Mac 规格取自 Apple 官网(2026-10-30 读取);“GPU 可用约 70% 内存”和各模型 8k 上下文需求来自 CanRun 的公开估算,我们没有在每种 Mac 上实测。苹果机型和配置更新较快,购买前请以官网为准;国行价格见下文“国行官方标价”,下单前以官网为准。
Mac 跑大模型有一个其他电脑难以比拟的优势:CPU 和 GPU 共用一块统一内存,没有“显存不够”的硬门槛,内存多大,能装的模型就多大。同时也有明确的短板:带宽通常低于高端独立显卡。这篇文章回答三个问题:不同内存的 Mac 能跑多大的模型?该怎么选配置?Mac 和 PC 显卡到底谁更合适?
先说结论:16GB 能入门,24GB 是更实用的起点,32GB 以上才能舒服地用 30B 级模型,64GB 以上才轮到 70B 级。 不要把总内存当成可用显存,GPU 能用到的大约是 70% 上下。
Mac 跑大模型:统一内存和显存有什么不同
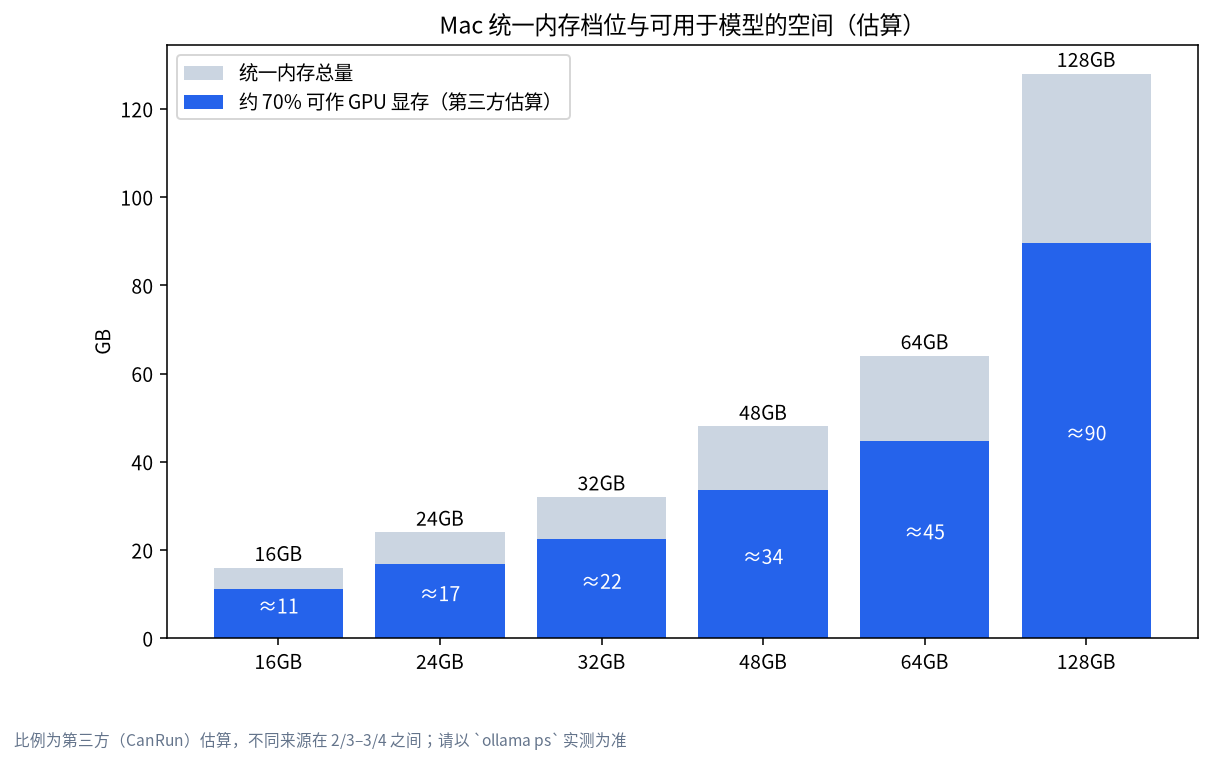
传统电脑有独立显存,模型必须放得下显存,否则就要落到内存、速度骤降。Mac 没有独立显存,CPU 和 GPU 共享一个内存池,但 macOS 会限制 GPU 能占用的比例。CanRun 的指南用一个简化数字:GPU 约能使用 70% 的统一内存。该指南也指出,据 llama.cpp 社区讨论中引用的代码,macOS 默认大约保留三分之一(不超过 32GB 的 Mac)或四分之一(更大内存的 Mac),所以 70% 偏保守;不同来源的估计在三分之二到四分之三之间。
| 统一内存 | GPU 可用(按 70% 估算) | 能装下的典型模型(8k 上下文) |
|---|---|---|
| 16GB | 约 11.2GB | Llama 3.1 8B、Gemma 3 12B、Qwen3 14B(很紧) |
| 24GB | 约 16.8GB | 以上全部,加 gpt-oss-20b |
| 32GB | 约 22.4GB | 以上全部,加 Qwen3 30B-A3B(2507) |
| 48GB | 约 33.6GB | 30B 级有大量余量 |
| 64GB | 约 44.8GB | 70B Q4(43GB)勉强,余量很小 |
| 128GB | 约 89.6GB | gpt-oss-120b 等超大模型 |
上表“典型模型”对应 CanRun 估算的 8k 上下文总需求:Llama 3.1 8B 为 6.6GB,Gemma 3 12B 为 8.4GB,Qwen3 14B 为 10.9GB,gpt-oss-20b 为 12.9GB,Qwen3 30B-A3B 为 19.9GB,gpt-oss-120b 为 64.3GB。64GB 的 Mac 放不下 gpt-oss-120b,128GB 才行(CanRun 的结论)。70B 一栏是我们用 Ollama 上 llama3.3:70b 文件 43GB 对照 44.8GB 可用值得出的判断,余量非常小,不建议当作舒适方案。
如果想知道某个模型需要多少,可以按《大模型显存需求怎么算》先估算,再对照上表。
当前 Mac 机型与带宽
下面是 Apple 官网 2026-10-30 的相关规格(只列和大模型相关的部分):
| 机型 / 芯片 | 统一内存配置 | 内存带宽 | 备注 |
|---|---|---|---|
| Mac mini(M6) | 16GB,可选 24GB、32GB | 153GB/s(基础),24/32GB 配置为 170GB/s | 体积小、静音 |
| Mac mini(M5 Pro) | 24GB,可选 48GB、64GB | 307GB/s | 比 M6 带宽高近一倍 |
| MacBook Pro(M6) | 官网页面标注最高带宽 170GB/s | 约 170GB/s | 便携 |
| MacBook Pro(M5 Pro) | 24GB、48GB、64GB | 307GB/s | |
| MacBook Pro(M5 Max,32 核 GPU) | 36GB | 460GB/s | |
| MacBook Pro(M5 Max,40 核 GPU) | 48GB、64GB、128GB | 614GB/s | 要装 70B 级模型的选择 |
国行官方标价(Apple 中国官网价,经第三方转载,2026-10):Mac mini(M6)24GB/512GB 为 9,999 元,32GB/1TB 为 13,749 元;Mac mini(M5 Pro)24GB/512GB 为 12,999 元,64GB/1TB 为 24,249 元(48GB 档约比 24GB 档加 4,500 元);Mac Studio(M5 Max)64GB/1TB 为 29,749 元,128GB/1TB 为 41,749 元。以上是官方标价,不是市场中位价,苹果近期因内存涨价多次调整配置和价格,下单前请以 Apple 中国官网为准;市场渠道价另见我们的参考报价。
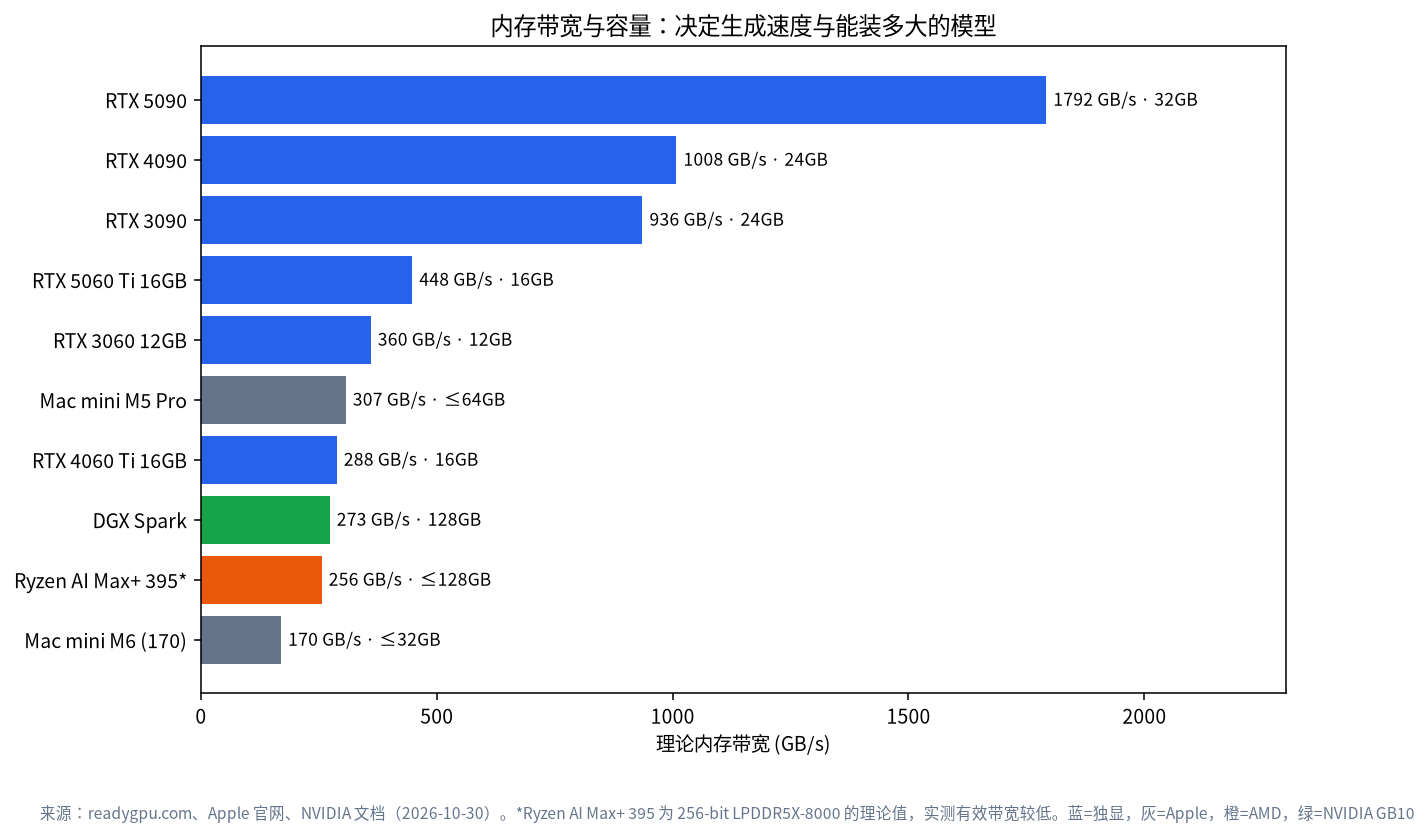
带宽很重要:同样放得下的模型,带宽越高,生成越快。对比之下,RTX 4090 为 1008GB/s,RTX 5090 为 1792GB/s,DGX Spark 为 273GB/s(NVIDIA 文档)。所以 Mac 的特点是“容量大、带宽中等”,而不是“又大又快”。
CanRun 还公布了各芯片的速度估算(带 ±20% 误差带),但属于第三方估算,我们不在这里转载具体数字,选购时可以去它的页面查看。
怎么选内存:按用途给建议
| 你的用途 | 建议内存 | 理由 |
|---|---|---|
| 先体验、跑 7B–8B 模型 | 16GB | 勉强够用,同时开浏览器、IDE 会吃紧 |
| 日常主力、跑 14B–20B 模型 | 24GB | 可放下 gpt-oss-20b(CanRun 估算需 12.9GB) |
| 编程助手、30B 级 MoE | 32GB–48GB | Qwen3 30B-A3B(19.9GB)等有余量 |
| 想放下 70B 级模型 | 64GB 起,最好 128GB | 70B Q4 为 43GB,64GB 机型余量极小 |
| 超大 MoE(如 gpt-oss-120b) | 128GB | CanRun:64GB 机型放不下 |
两个提醒:第一,统一内存在购买时就已定死,之后无法加装,所以宁可买大一档;第二,别忘了系统和浏览器、其他应用也要占用同一块内存,真正给模型的会更少。
按内存档位的模型清单
下表把 Ollama 上的文件大小(2026-10-30 读取)与上文按 70% 估算的 GPU 可用空间放在一起。“余量”是粗算:可用空间减去文件大小,还没算上下文缓存,请按《大模型显存需求怎么算》再留 1–4GB:
| 统一内存(GPU 可用) | 模型标签 | 文件大小 | 粗算余量 | 评价 |
|---|---|---|---|---|
| 16GB(约 11.2GB) | qwen3:8b |
5.2GB | 约 6GB | 宽裕 |
| 16GB(约 11.2GB) | qwen3:14b |
9.3GB | 约 1.9GB | 很紧,上下文别开大 |
| 24GB(约 16.8GB) | gpt-oss:20b |
14GB | 约 2.8GB | 可用 |
| 24GB(约 16.8GB) | qwen3.6:27b |
17GB | 约 -0.2GB | 放不下,别选 |
| 32GB(约 22.4GB) | qwen3.6:27b |
17GB | 约 5.4GB | 宽裕 |
| 32GB(约 22.4GB) | qwen3:30b-a3b |
19GB | 约 3.4GB | 可用,MoE 速度快 |
| 48GB(约 33.6GB) | gemma4:31b |
20GB | 约 13.6GB | 可开较长上下文 |
| 64GB(约 44.8GB) | llama3.3:70b |
43GB | 约 1.8GB | 极紧,不建议 |
| 128GB(约 89.6GB) | gpt-oss:120b |
65GB | 约 24.6GB | 宽裕 |
这张表的结论是我们的粗算,不是实测。真正放不放得下,还是看 ollama ps。更多模型比较见《本地大模型推荐》。
Mac 上怎么部署:软件选择
- Ollama:官方文档说明 macOS 需要 Sonoma(v14)或更新版本,Apple M 系列支持 CPU 和 GPU,Intel Mac 仅支持 CPU。安装过程见《Ollama 安装教程》。
- LM Studio:图形界面更友好,官方文档写明支持 Apple 芯片、macOS 14.0 及以上,建议 16GB 以上内存;Intel Mac 暂不支持。使用方法见《LM Studio 使用教程》。
- MLX:Apple 机器学习团队的开源数组框架,面向 Apple 芯片,有兴趣的开发者可以研究。
用 ollama ps 核对
在 Mac 上跑 ollama run qwen3:14b 之后,另开终端输入 ollama ps,PROCESSOR 列应显示 100% GPU。若出现 CPU 比例,说明模型超出了 GPU 可用空间,应换小一档的模型或缩短上下文。
用活动监视器看内存压力
打开“活动监视器”的内存标签页,内存压力图保持绿色说明正常;变黄或变红说明系统在大量交换内存,应关闭其他应用或换更小的模型。
想多用一点内存?
CanRun 引述的 llama.cpp 社区讨论里提到,可以用 sudo sysctl iogpu.wired_limit_mb=<数值> 提高 GPU 可占用的上限,重启后会还原,而且若给系统留得太少会导致大量交换。这是社区做法,不是苹果官方推荐,我们没有逐项验证,如果要尝试,请先备份并从小幅调整开始。
在 Mac 上要特别留意的上下文设置
Ollama 的默认上下文长度随可用内存而定:按官方文档,小于 24GiB 为 4k,24–48GiB 为 32k,48GiB 及以上为 256k(具体以文档为准)。这意味着 16GB 的 Mac 默认只有 4k 上下文,处理长文档或写代码时很容易被截断;而把它拉到 32k 又会大幅增加缓存占用。建议按需逐步调大:先 8k,再 16k,每次调整后用 ollama ps 检查是否仍然是 100% GPU,并留意活动监视器里的内存压力。需要智能体或编程工具时,官方建议至少 64000 tokens,这对小内存的 Mac 不现实,应选择更小的模型,把内存留给上下文。
用 Mac mini 做家里的“模型服务器”
Mac mini 体积小、功耗低、几乎无声,很适合放在家里 24 小时开着,让手机、笔记本通过局域网访问。Ollama 官方 FAQ 说明了在 macOS 应用里设置环境变量的方法:
launchctl setenv OLLAMA_HOST "0.0.0.0:11434"
然后重启 Ollama 应用。这会让 Ollama 监听所有网卡,只应在可信的局域网里使用,不要直接暴露到公网。如果想让模型常驻内存、省去每次加载,可以设置 OLLAMA_KEEP_ALIVE(默认 5 分钟),官方 FAQ 说明了取值方式。搭配 Open WebUI 可以得到一个多人可用的网页界面,见《Open WebUI + Ollama 搭建教程》。
购买 Mac 前的避坑清单
- 别把总内存当显存:按约 70% 估算 GPU 可用,16GB 的 Mac 实际只有约 11GB。
- 内存无法后加:现在预算紧,也宁可少配硬盘(可外接),不要少配内存。
- 看带宽,不只看内存:同样 24GB,M6 与 M5 Pro 的带宽差近一倍,生成速度体验会不同。
- 别和独显的速度比:Mac 的优势是容量与安静,不是原始速度。
- 留足磁盘:模型动辄 5–40GB,几个模型就占掉几百 GB,建议至少 1TB。
- 价格自己核对:国内外价格、教育优惠和配置组合经常变化,不要依赖二手信息。
Mac 与独显:怎么选
| 对比项 | Mac(Apple 芯片) | NVIDIA 独显 PC |
|---|---|---|
| 可用内存 | 统一内存,最大可达 128GB 档(M5 Max) | 单卡 8–32GB 显存 |
| 带宽 | 153–614GB/s | 如 4090 的 1008GB/s、5090 的 1792GB/s |
| 功耗与噪音 | 低、静音 | 高,旗舰卡 450–575W |
| 软件生态 | Ollama、LM Studio、MLX 都能用 | 兼容性最广,CUDA 生态成熟 |
| 升级 | 内存不能后加 | 可换卡 |
| 适合 | 想放大模型、静音、省电、兼顾日常使用 | 想要速度、愿意折腾、预算够 |
结论:如果你想放进比较大的模型(30B 以上),或者想要一台安静的办公机顺便跑大模型,Mac 是很合理的选择;如果你更看重生成速度、想做微调或多卡扩展,独显 PC 更合适。更多独显方案见《本地大模型显卡推荐》,还可以考虑《大模型一体机怎么选》。
常见问题(FAQ)
Mac 跑大模型,16GB 够吗?
能入门。16GB 的 GPU 可用空间约 11.2GB,可以放下 Llama 3.1 8B、Gemma 3 12B 和(很紧的)Qwen3 14B。想长期使用,建议 24GB 起步。
M6 和 M5 Pro 差别大吗?
按 Apple 官网,Mac mini 的 M6 带宽为 153–170GB/s,M5 Pro 为 307GB/s。带宽影响生成速度,容量影响能不能放下,两者要一起看。
Mac 能用 70B 模型吗?
要看内存。70B Q4 文件约 43GB,64GB 的 Mac(约 44.8GB 可用)余量极小,128GB 的 Mac 才舒适。
为什么我的模型很慢?
先用 ollama ps 确认是否 100% GPU,其次看内存压力是否变黄。如果落到 CPU,会明显变慢。
Intel Mac 能跑吗?
Ollama 在 Intel Mac 上只能用 CPU,LM Studio 暂不支持 Intel Mac,所以体验不佳,不建议。
内存可以后续加装吗?
不能。Mac 的统一内存在购买时确定,所以需要一次买够。
下一步与社区
不确定该买 24GB 还是 48GB?欢迎把你的预算和想跑的模型发到社区(加入社区)一起看。我们在深圳做本地大模型机器的选型、组装与实测,也可以按你的需求对比 Mac 与独显方案;先聊需求,不强制购买。