AI PC NPU 是什么?它能做什么、TOPS 代表什么,对本地大模型有用吗(2026)
现在的笔记本和迷你主机常常打着“AI PC”的旗号,带一个 NPU,包装盒上还有一个以 TOPS 为单位的大数字。如果你想在本地运行语言模型,可能会想:这个数字重要吗,值得为它多花钱吗?这篇文章用通俗的话回答 AI PC NPU 是什么:这块芯片是什么,TOPS 衡量什么,微软对 Copilot+ PC 有什么要求,NPU 与 GPU 在大语言模型上有什么不同,软件支持现在到了什么程度,以及怎么决定。如果你在选笔记本,请连同《本地大模型笔记本选购指南》一起看。
核对说明:微软对 Copilot+ PC 的要求(NPU 能达到 40+ TOPS)及其对 NPU 的描述来自 Microsoft Learn;Ryzen AI Max+ 395 的数据(NPU 最高 50 TOPS、整体最高 126 TOPS、最高 128GB 的 256 位 LPDDR5x-8000)来自 AMD 产品页;OpenVINO 对 NPU 上语言模型的支持来自 Intel 的 OpenVINO 文档;Ollama 的加速器列表来自其 GPU 页面。均于 2026-10-30 核对。我们没有测试任何 NPU,所以不给出速度。
要点速览(更新于 2026-10-30)
- NPU 是处理器里一块低功耗、专为 AI 运算设计的单元;微软要求 Copilot+ PC 达到 40+ TOPS,但 TOPS 是峰值数字,不能说明语言模型生成文字有多快。
对大多数本地大模型工具,决定速度的仍是 GPU 及其内存带宽;Ollama 文档列出的是 CUDA、ROCm、Metal 和 Vulkan 加速,没有 NPU。
把 NPU 当作省电的后台 AI 功能的加分项;如果目标是本地大模型,先为内存和 GPU 花钱。
AI PC NPU 是什么:简短的回答
NPU,即神经网络处理单元,是处理器内部专门为高效运行神经网络运算而做的单元,做同类工作比 CPU 或 GPU 耗电更少。微软把它描述为用于实时翻译、图像生成等 AI 密集型处理的专用芯片。“AI PC”只是指带有这种单元的电脑,而 Copilot+ PC 是要求更严格的 Windows 版本。对本地语言模型来说情况更复杂,因为主要瓶颈是内存带宽,而今天大多数工具跑在 GPU 或 CPU 上。
CPU、GPU、NPU:三种不同的工作
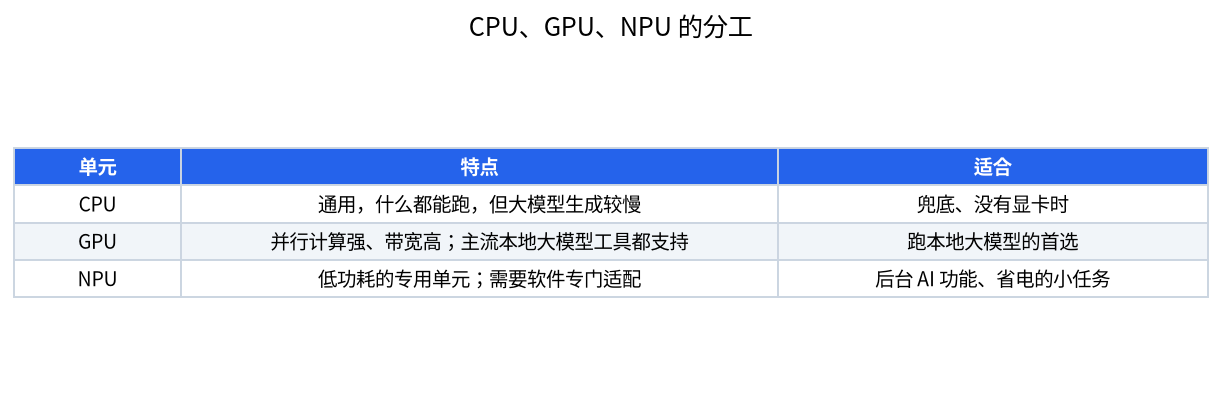
| 单元 | 优势 | 劣势 | 在本地大模型中的典型角色 |
|---|---|---|---|
| CPU | 什么都能跑,一定存在 | 大模型上很慢 | 兜底和卸载 |
| GPU | 大规模并行计算和高内存带宽 | 耗电,小显卡显存有限 | Ollama、llama.cpp 和 LM Studio 的主力 |
| NPU | 对受支持的负载非常高效 | 需要专门为它编写的软件,工具支持较少 | 后台 AI 功能和一些优化过的模型 |
CPU 是通用的工人。GPU 是带有自己高速内存或高速共享内存的大规模并行处理器,这就是它在本地大模型工作中占主导的原因,见《显存指南》。NPU 更加专门:它为神经网络里反复出现的矩阵运算而设计,追求能效,所以任务可以长时间运行而不耗尽电池。
TOPS 代表什么,不代表什么
TOPS 是每秒万亿次运算。它是峰值吞吐数字,通常按低精度整数运算来标注。微软说 Copilot+ PC 的 NPU 每秒能执行超过 40 万亿次运算,并且很多新的 Windows AI 功能需要 40+ TOPS 的 NPU。这个数字适合当作门槛,比如“这台电脑是否符合 Copilot+ 功能的条件”。它不是语言模型的速度评级,原因有三。第一,峰值数字假设理想条件。第二,语言模型生成时,大部分时间花在为每个 token 从内存读取权重上,所以内存带宽比算力更重要。第三,不同厂商统计运算的方式可能不同,“整体 TOPS”可能把 CPU、GPU 和 NPU 加在一起。
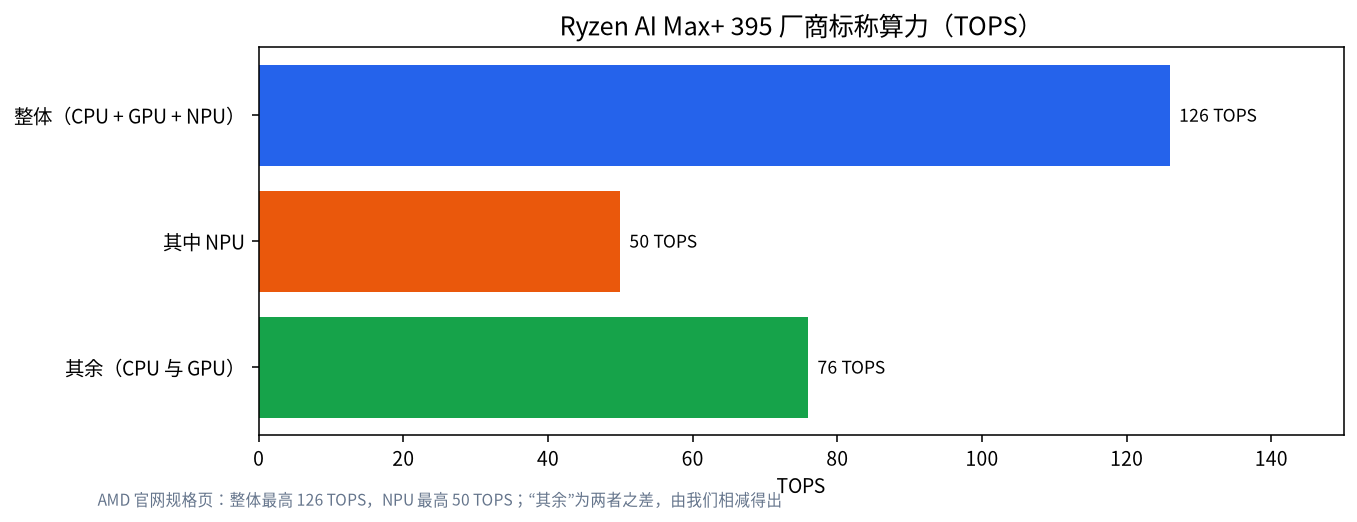
AMD 的 Ryzen AI Max+ 395 产品页就是个好例子。它标注 NPU 最高 50 TOPS,整体最高 126 TOPS,也就是说总量的很大一部分来自 CPU 和 GPU,而不是 NPU。它还列出最高 128GB 内存、256 位 LPDDR5x-8000 和带 40 个图形核心的 Radeon 8060S 集成显卡。这颗芯片对本地大模型的价值主要来自 GPU 可以使用的大内存池,见《大内存迷你主机指南》,而不只是 NPU。
为什么生成文字时带宽比 TOPS 重要
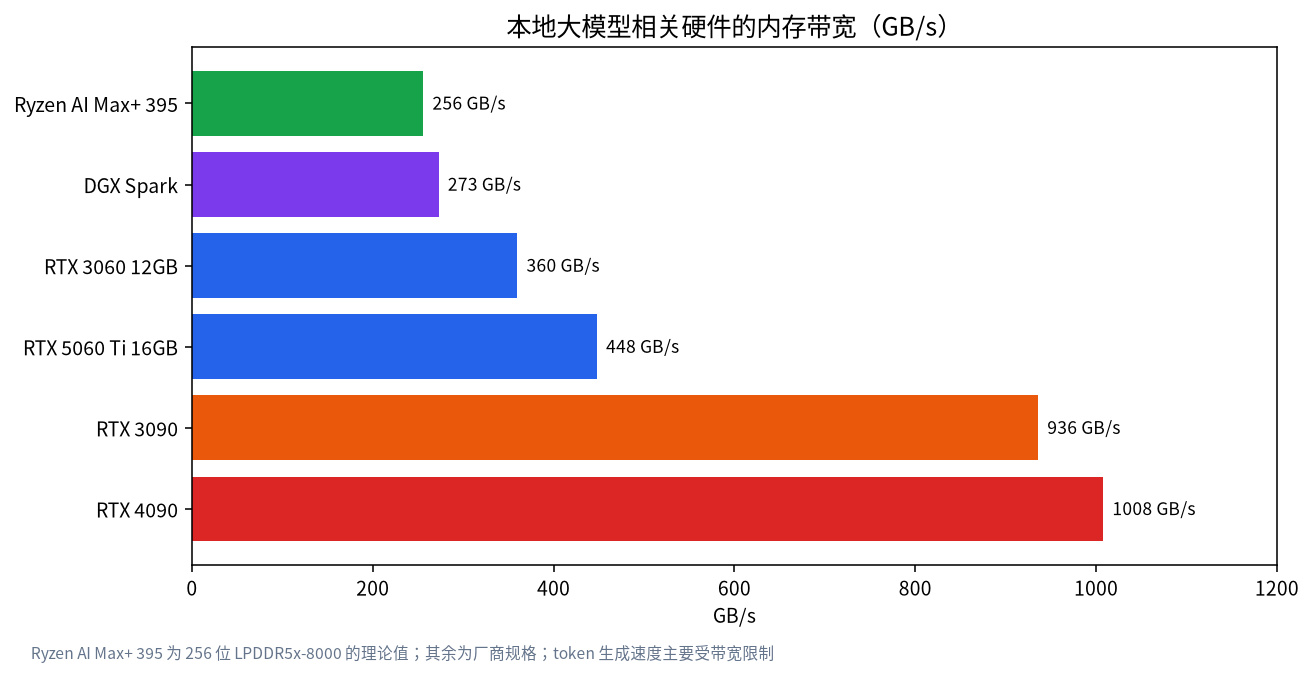
模型生成一个 token 时,必须把它活跃的权重基本读取一遍。所以速度受限于内存传输数据的快慢。256 位 LPDDR5x-8000 接口的内存带宽折算约为 256 GB/s,NVIDIA 给出 DGX Spark 为 273 GB/s,而 GeForce RTX 3090 为 936 GB/s,RTX 4090 为 1008 GB/s。笔记本芯片里的 NPU 通常与 CPU 和 GPU 共享系统内存,所以加一个 NPU 并不会增加带宽。这就是为什么一台带 40 TOPS NPU 的普通笔记本不会突然擅长运行 14B 模型:模型仍然要在内存里流过。
软件支持现状
本地大模型工具对 NPU 的支持是真实存在的,但比 GPU 窄。微软的指导说 NPU 需要专门编写的软件才能使用,并推荐用 Windows ML 在 NPU 上运行 AI 任务;Windows ML 会选择执行提供程序,比如高通的 QNN 或英特尔的 OpenVINO,并在需要时回退到 GPU 或 CPU。微软还指出,很多 NPU 只支持较低位数的整数运算,所以模型必须经过转换或量化才能在上面运行。Intel 的 OpenVINO GenAI 记录了在 NPU 上运行语言模型的方法,文档说明支持 Intel Core Ultra Series 2 的 NPU 及之后的产品,并指出为 NPU 编译语言模型是即时进行的,除非使用缓存,否则可能花很长时间。相比之下,Ollama 的 GPU 文档描述的是通过 CUDA、ROCm、Metal 和 Vulkan 的加速,没有描述 NPU 支持。所以如果你打算用 Ollama、LM Studio 或 llama.cpp 搭配标准 GGUF 模型,预计干活的是 GPU 或 CPU。
| 问题 | 目前的实际答案 |
|---|---|
| Ollama 会用我的 NPU 吗? | 它的文档描述的是 GPU 后端,不是 NPU |
| NPU 能运行大模型吗? | 能,用 NPU 专用的工具链,比如受支持的 Intel 芯片上的 OpenVINO GenAI |
| 需要转换模型吗? | 通常需要;NPU 一般需要受支持格式的低位整数模型 |
| 比 GPU 快吗? | 对大模型一般不是;优势在于省电 |
NPU 现在适合做什么
NPU 最有力的用途是 Windows 和应用提供的常驻功能,比如实时字幕、翻译、背景虚化和本地图像工具,它们设计成在 NPU 上运行以延长电池续航。对开发者来说,NPU 可以高效运行小型的优化模型,适合不能耗尽电池的设备端助手和应用。对想与 14B 或 32B 模型聊天的人来说,实用的硬件仍是显存足够的 GPU 或统一内存的机器,见《笔记本选购指南》和《显存计算器指南》。
现实地看待 NPU
可以拿 NPU 与熟悉的东西比较,比如电脑里的视频解码器。你很少想到解码器,却可以用很少的电量看几个小时的视频,因为专用单元做这件事比 CPU 高效得多。NPU 想对一直在后台运行的 AI 任务做同样的事。而你与之聊天的语言模型不同:你希望它在几分钟内尽可能快,想要大模型,并且乐意给笔记本插上电。这有利于带宽和内存最多的处理器,也就是 GPU。随着 NPU 软件成熟,这种平衡可能改变,厂商显然也在努力,所以把 NPU 当作对未来的一种对冲是合理的。但今天指望笔记本 NPU 追上台式显卡的速度,或者拯救内存太少的机器,是不合理的。
如果你好奇,可以打开 Windows 任务管理器,在性能页里找 NPU 条目,来检查自己的电脑有没有 NPU,微软说带 NPU 的设备可以这样查看。使用 Windows AI 功能时观察它,可以看出这个功能是否真的在 NPU 上运行;运行 Ollama 时观察它,可以看出 NPU 是否被用到。
值得为 NPU 多花钱吗
- 想要 Copilot+ 功能或长续航:NPU 电脑合理,购买时请核对确切的要求清单。
- 目标是本地大模型:先把钱花在内存容量和 GPU 上;NPU 是加分项。
- 你是针对 NPU 的开发者:买你的工具链支持的芯片系列,比如 OpenVINO 对应 Intel。
- 已经有不错的 GPU:跑本地大模型不需要 NPU。
价格因型号而异,作为参考,我们 2026 年 10 月的调研发现,128GB 内存的 Ryzen AI Max+ 395 迷你主机中位价约 24,566 元;这个价格反映的更多是内存池和 GPU,而不是 NPU。
常见错误
- 跨厂商比较 TOPS:定义和精度不同;应比较内存和软件支持。
- 以为 NPU 会加速 Ollama:先查工具的文档。
- 忽视内存:内存很少的 AI PC 仍然放不下大模型。
- 把宣传数字当速度:TOPS 是峰值,不是每秒 token 数。
- 忽视驱动和软件版本:NPU 支持取决于驱动和运行时版本。
选购清单
- 先确定你的目标是 Windows AI 功能、续航还是本地大模型。
- 对本地大模型,列出想要的模型大小和它们需要的内存。
- 看机器的内存容量和带宽,而不只是 TOPS。
- 查你想用的工具是否支持 NPU,以及需要哪个芯片系列。
- 看具体这款笔记本的散热和功耗限制。
- 保持适度的期望,尽可能用自己的任务测试。
常见问题
NPU 是什么的缩写?
神经网络处理单元,是处理器里专为神经网络运算设计的专用单元。
什么是 Copilot+ PC?
根据微软,它是带有能执行超过 40 TOPS 的 NPU 的 Windows 11 电脑,可启用一组设备端 AI 功能。
NPU 会让本地大模型更快吗?
它本身不会。文字生成主要受内存带宽限制,而 Ollama 等主流工具记录的是 GPU 加速,不是 NPU 加速。
我能在 NPU 上运行本地大模型吗?
能,用 NPU 专用的工具链。Intel 的 OpenVINO GenAI 记录了在受支持的 Intel 芯片的 NPU 上运行语言模型,但编译可能耗时。
TOPS 数字越高一定越好吗?
不一定。它是峰值数字,可能统计了不同的单元和精度。内存、软件和散热同样重要。
我应该为本地大模型买 AI PC 吗?
先为内存和 GPU 买单。NPU 是有用的额外功能,但它不能代替足够的内存或有能力的 GPU。
告诉我们你的发现
如果你试过在 NPU 上运行模型,欢迎告诉我们你的芯片、工具和结果。可以发到社区,或发邮件到 admin@microaione.com。
参考:Microsoft Learn:为 Copilot+ PC 开发 AI 应用、AMD Ryzen AI Max+ 395 规格、OpenVINO GenAI on NPU、Ollama GPU 支持。