gpt-oss 本地部署教程:用 Ollama 与 llama.cpp 运行 gpt-oss-20b 和 gpt-oss-120b
gpt-oss 是 OpenAI 发布的开放权重推理模型,有 20b 和 120b 两个规格,采用宽松的 Apache 2.0 许可,因此既可以个人使用,也可以商用。它特别适合本地部署:模型使用 MXFP4 格式发布,体积远比同参数量的普通模型小。这篇 gpt-oss 本地部署 教程讲清楚两条路线:最简单的 Ollama,以及更灵活的 llama.cpp,包括每个规格实际需要多少内存、显存不够时怎么把部分专家层放到 CPU,以及推理强度怎么调。Ollama 的安装见《Ollama 安装教程》,GGUF 格式见《GGUF 与 llama.cpp 入门》。
核对说明:模型规格、体积和特性来自 Ollama 的 gpt-oss 页面(2026-10-30 读取);内存需求表、命令行参数和硬件速度数据来自 llama.cpp 官方的 gpt-oss 运行指南(GitHub 讨论 #15396,其中的速度数据是 2025 年 8 月前后的早期构建,仅供参考,并非我们的实测)。我们没有自己做速度测试。
要点速览(更新于 2026-10-30)
- Ollama 页面列出的体积:gpt-oss:20b 约 14GB,gpt-oss:120b 约 65GB,上下文均为 128K;官方说明 20b 可在 16GB 内存的系统上运行,120b 可放进单张 80GB 显卡。
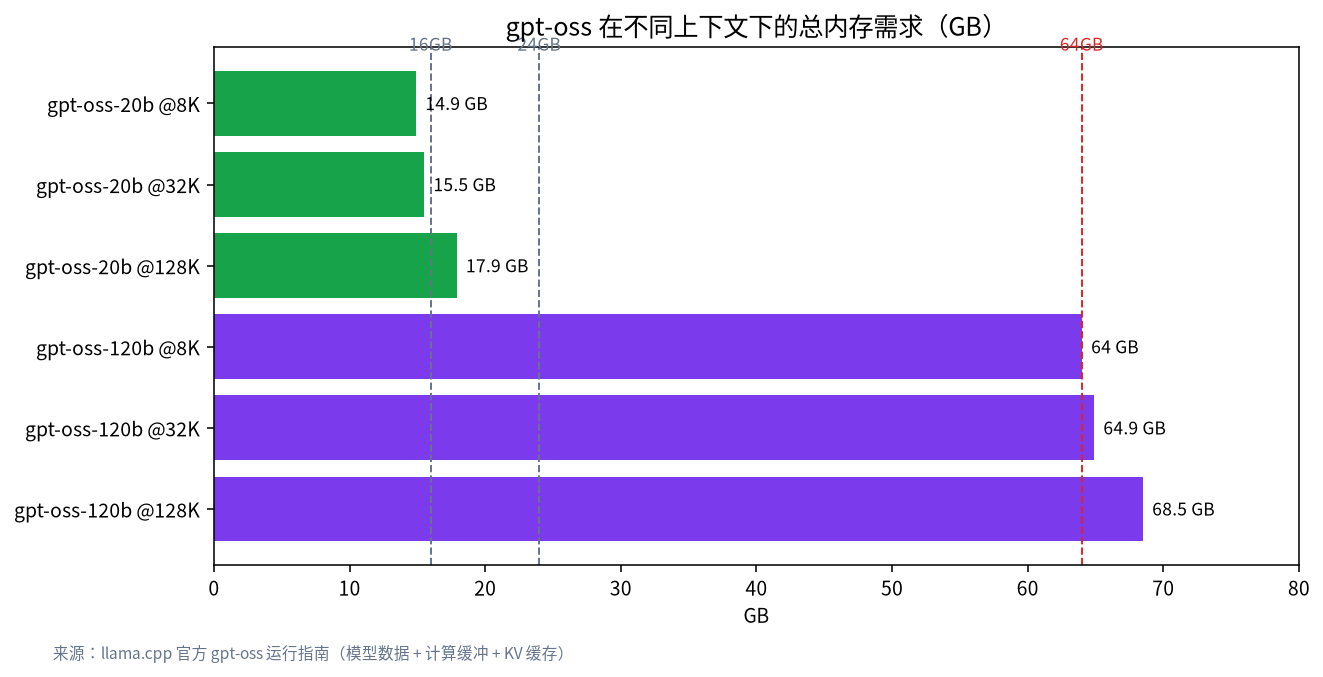
llama.cpp 官方指南的总内存估算:20b 在 8K 上下文约 14.9GB、128K 约 17.9GB;120b 约 64.0GB 到 68.5GB。
显存放不下时,可以用
--n-cpu-moe把部分 MoE 层留在 CPU,性能仍然可以接受;运行时别忘了加--jinja。
gpt-oss 本地部署:先看规格和内存
| 项目 | gpt-oss-20b | gpt-oss-120b |
|---|---|---|
| Ollama 标签与体积 | gpt-oss:20b,约 14GB | gpt-oss:120b,约 65GB |
| 上下文 | 128K | 128K |
| 量化 | MoE 权重为 MXFP4(约 4.25 比特每参数) | 同左 |
| 官方说明的运行条件 | 16GB 内存的系统 | 单张 80GB 显卡 |
| llama.cpp 官方指南:8K 上下文总需求 | 约 14.9GB | 约 64.0GB |
| 32K 上下文 | 约 15.5GB | 约 64.9GB |
| 128K 上下文 | 约 17.9GB | 约 68.5GB |
这里的总需求包括模型数据、计算缓冲和 KV 缓存。可以看出,gpt-oss 的上下文缓存增长很缓慢:20b 从 8K 增加到 128K,只多出约 3GB。这是它的结构特点,不能套用到其他模型上。20b 对 16GB 显存很紧,24GB 显存则很从容,见《24GB 显存跑大模型》;120b 则需要 64GB 以上的内存,例如大内存的迷你主机或 Mac,见《大内存迷你主机跑大模型》和《Mac 跑本地大模型》。
方式一:用 Ollama 运行
- 先升级到最新版 Ollama。
- 运行
ollama run gpt-oss:20b,或者ollama run gpt-oss:120b;第一次会自动下载。 - 用
ollama ps确认处理器占比。
按 Ollama 页面的说明,gpt-oss 原生支持函数调用、网页浏览(Ollama 提供可选的内置网页搜索)、Python 工具调用和结构化输出,并且可以看到完整的思维链。推理强度可以设为低、中、高三档,按任务的延迟需求选择:简单问答用低,复杂问题用高。Ollama 原生支持 MXFP4,无需额外量化或转换,所以不要再去找别的量化版本。
方式二:用 llama.cpp 的 llama-server
llama.cpp 官方提供了预转换的 GGUF:ggml-org/gpt-oss-20b-GGUF 和 ggml-org/gpt-oss-120b-GGUF。官方指南给出的启动命令是:
llama-server -hf ggml-org/gpt-oss-20b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048
运行后,会自动下载模型,并在本机提供网页聊天界面和兼容 OpenAI 的 API。主要参数的含义如下:
| 参数 | 作用 |
|---|---|
-hf |
指定 Hugging Face 上的模型 ID,自动下载 |
--ctx-size(-c) |
上下文长度,越大越占内存;两个模型最大 128K,0 表示用模型默认值 |
-ub、-b |
批大小,越大计算缓冲越大,某些情况下更快 |
-fa |
开启 Flash Attention,在支持的后端上提升性能 |
--n-cpu-moe N |
把 N 层 MoE 留在 CPU,用于显存放不下的配置 |
--jinja |
使用 GGUF 内嵌的 Jinja 聊天模板,必须加上 |
官方指南特别提到,不需要把整个模型放进显存也能获得不错的性能:只把注意力张量和 KV 缓存放在显存,其余放在 CPU 内存,也能取得可观的速度。这对显存只有 12GB 到 16GB 的用户很有价值:可以用 --n-cpu-moe 调整放在 CPU 的层数,通过实验找到最优值。
不同硬件的参考
| 硬件 | 建议 | 说明 |
|---|---|---|
| 8GB 显存或内存 | 不建议 | 官方指南说明,8GB 内存的 Mac 无法运行 gpt-oss |
| 16GB 内存的 Mac | 20b,需要把部分层留在 CPU | 官方示例用了 --n-cpu-moe 12 -c 32768 --no-mmap |
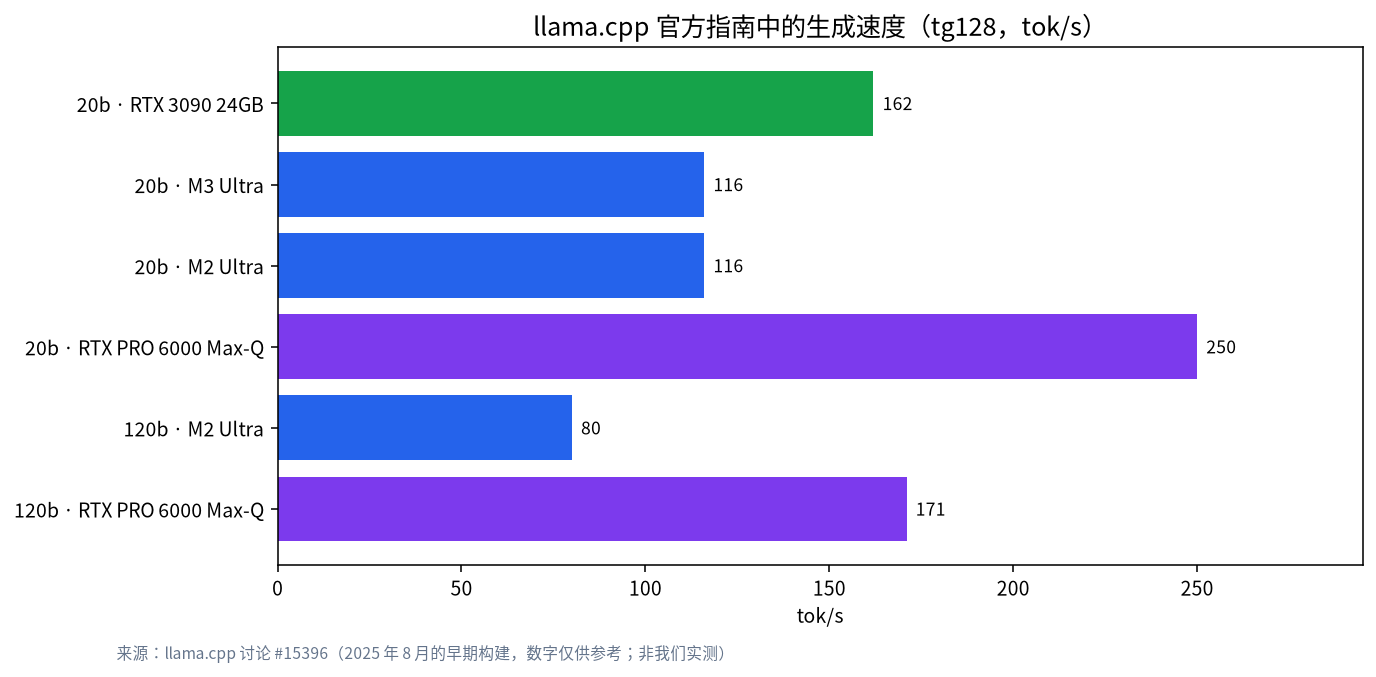
| 24GB 显存 | 20b 完全放进显存 | 官方指南中 RTX 3090 上 tg128 约 162 tok/s(早期构建) |
| 64GB 以上显存或内存 | 120b | 总需求约 64GB 起 |
| Apple 芯片 | 不要超过总内存的约 70% | 官方指南的建议 |
图 2 中的数据全部来自官方指南,属于 2025 年 8 月前后的早期构建结果,并不能代表今天的速度,所以只能说明数量级:20b 在高端显卡和 Mac 上都能达到每秒一百多个字,120b 在大内存的 Mac 和工作站显卡上也能到几十到近两百。你自己的机器请用 llama-bench 实际测一下。
报错与速度排查表
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 输出里出现原始的标记,或者只有分析没有正文 | 没加 --jinja,或者用了不合适的推理格式参数 |
加上 --jinja,使用最新版 llama.cpp |
| 加载失败或内存不足 | 上下文太大,或者显存不够 | 降低 --ctx-size,用 --n-cpu-moe 把部分层留在 CPU |
| 速度比预期慢 | 部分层在 CPU,或批大小不合适 | 调整 --n-cpu-moe、-ub、-b,并确认开启了 -fa |
| 想再量化一次 | 不推荐 | 官方建议直接使用原生的 MXFP4 版本,不要再额外量化 |
| Ollama 报找不到模型 | Ollama 版本太旧 | 升级 Ollama |
上下文长度与内存的取舍
表格里的数据说明,gpt-oss 的上下文缓存增长很缓慢,所以如果你的内存刚好够用,可以放心把上下文开到 32K 左右,而不必像其他模型那样担心缓存一下子占满显存。不过计算缓冲是固定开销,约 2.7GB,这部分无论上下文多长都要预留。所以在 16GB 的机器上,20b 的 14.9GB 总需求几乎没有余量,一旦系统自身还要占用内存,就应该使用 --n-cpu-moe 把部分层放到 CPU,或者换一台 24GB 的机器。
实际操作时,建议先用较小的上下文启动,例如 -c 8192,用 nvidia-smi 或系统监视器确认占用,再逐步增加。每次只改一个参数,才能知道速度和内存的变化来自哪里。记录下每次的命令和结果,就能很快找到适合你机器的配置。
用 llama-bench 测自己的机器
官方指南里的速度数据来自作者自己的机器和早期构建,不能直接套用到你的硬件上。llama.cpp 自带的 llama-bench 工具可以在你的机器上测出提示处理速度(pp)和生成速度(tg)。测试时固定使用同一个模型文件、同样的批大小参数,换一个变量再测一次,就能对比不同设置的差别。测完把结果和命令一起保存,之后升级软件或硬件时可以重新对照。
常见误区
- 以为 120b 需要 80GB 显卡才能跑:80GB 单卡是官方给出的理想条件,使用 CPU 内存配合
--n-cpu-moe,64GB 以上的内存配置也可以运行,只是速度取决于带宽。 - 以为上下文越长内存越大得离谱:gpt-oss 的缓存增长较慢,但这是它自己的结构特点。
- 再次量化 MXFP4 模型:官方建议直接用原生版本。
- 用旧版本软件:这类新模型对软件版本要求高,建议使用最新的 Ollama 和 llama.cpp。
- 把早期的速度数据当成今天的速度:数据来自早期构建,仅供参考。
怎么选 20b 还是 120b
如果你的机器只有 16GB 到 24GB 的显存,选 20b:它体积小、速度快,适合日常问答、写作辅助和代码补全,还可以配合工具调用做简单的智能体任务。如果你有 64GB 以上的统一内存或大内存主机,并且处理的问题更复杂,再试 120b,它的推理能力更强,但生成速度和资源占用都更大。无论选哪个,建议都先用自己的任务做对比测试,再决定是否投入更多硬件预算。
对于大多数个人用户,20b 已经是一个足够好的起点。120b 更像是给工作站、大内存主机和小团队共享服务准备的选择。如果你想先判断自己的预算,可以参考《显存与本地大模型:怎么选 GPU》和《大模型显存需求怎么算》。
部署后的使用建议
建议把推理强度当作一个可以随时调整的旋钮:日常问答用低档,节省时间和算力;遇到复杂的数学、代码和多步骤问题时再切到高档。因为模型会输出完整的思维链,在需要展示给用户的场景里,要决定是否隐藏这部分内容。如果你准备把它接入其他应用,llama-server 提供的兼容 OpenAI 的接口会很方便,但同样要注意只在可信的网络里开放。
常见问题
gpt-oss 20b 需要多少显存?
Ollama 页面列出的体积约 14GB,llama.cpp 官方指南估算 8K 上下文总需求约 14.9GB;官方说明 20b 可在 16GB 内存的系统上运行,24GB 显存会更从容。
gpt-oss 120b 一定要 80GB 显卡吗?
官方说明它可放进单张 80GB 显卡。显存不够时,可以把部分 MoE 层留在 CPU 内存,总内存需求约 64GB 起。
为什么要加 --jinja?
它让 llama.cpp 使用 GGUF 内嵌的聊天模板,官方指南要求加上,否则输出格式可能不正常。
gpt-oss 可以商用吗?
Ollama 页面说明采用 Apache 2.0 许可,没有 copyleft 限制,适合实验、定制和商业部署。商用前请自己确认完整的许可文本。
Ollama 和 llama.cpp 选哪个?
想要最省事选 Ollama;想要更细的参数控制,比如 --n-cpu-moe,选 llama.cpp。
推理强度怎么设置?
模型支持低、中、高三档,按任务的复杂度和延迟需求选择。
需要帮你部署
如果你想在自己的机器上跑 gpt-oss,却不确定该选哪个规格,欢迎到社区告诉我们你的硬件,也可以发邮件到 admin@microaione.com。更多模型的比较见《2026 本地大模型推荐》。
参考与延伸阅读:Ollama:gpt-oss 模型页、llama.cpp:运行 gpt-oss 的官方指南、Hugging Face:ggml-org/gpt-oss-20b-GGUF。