ComfyUI 硬件要求:跑 AI 绘图需要多少显存和内存
玩本地语言模型的人,下一步往往是加上图像生成,而 ComfyUI 是其中最灵活的方式。它的节点图很强大,但第一个实际问题总是一样的:我需要什么硬件?ComfyUI 硬件要求几乎完全取决于你想运行的图像模型,而模型文件本身就告诉了你大部分答案。这篇指南列出各模型的大小,解释显存和系统内存如何分担工作,用参考价比较显卡方案,并说明怎样不靠猜来做决定。如果你已经为语言模型选好了显卡,我们的显存指南在这里同样适用,只是有几处不同。
核对说明:关于 ComfyUI 的说法(支持的操作系统和 GPU、Python 与 PyTorch 版本、智能显存管理、异步权重流式加载、Flux 示例配置)来自 ComfyUI 文档和 README,于 2026-10-30 核对。文件大小来自同一天的 Hugging Face 模型页面。Flux fp8 的大小是我们按 120 亿参数、每个参数一字节推算的。显卡价格是我们自己价格表的参考价中位数,不是报价。写这篇文章时我们没有跑图像基准测试,所以不提供每分钟出图数量。
要点速览(更新于 2026-10-30)
- 先把主模型文件和显存比一比:SD 1.5 约 4GB,SDXL 约 7GB,SD 3.5 Large 约 16GB,完整的 FLUX.1 dev 约 24GB,这还不包括文本编码器和工作内存。
ComfyUI 可以卸载并流式加载权重,让大模型在小显卡上运行,其 README 提到最低 4GB 显存加 8GB 内存,但这是用速度换内存。
要舒适地使用当前的大模型,16GB 是实用的下限,24GB 则很宽裕;NVIDIA 仍是支持最好的路径,AMD、英特尔和苹果芯片也受支持。
ComfyUI 对机器的要求
ComfyUI 可在 Windows、Linux 和 macOS 上运行。文档列出的支持包括:配合当前 PyTorch 与 CUDA 的英伟达 GPU,通过 ROCm 的 AMD GPU,通过 PyTorch XPU 的英特尔 Arc,通过 Metal 的苹果芯片,以及较慢的纯 CPU 模式。它推荐较新的 Python 版本,Windows 便携版自带 Python,所以你很少需要自己管理。对大多数用英伟达或 AMD 显卡的 Windows 用户来说,桌面版是最容易的起点。
与语言模型由内存带宽决定速度不同,图像扩散模型的计算量很大,所以 GPU 算力和显存都重要。模型工作时必须在显存里,所以显存决定了能顺畅运行什么,而 GPU 算力决定每张图要花多久。这里没有我们自己的测试,所以请把模型文件大小作为内存的参考,把厂商和社区的速度数字仅当作参考。
模型大小:第一个要查的数字
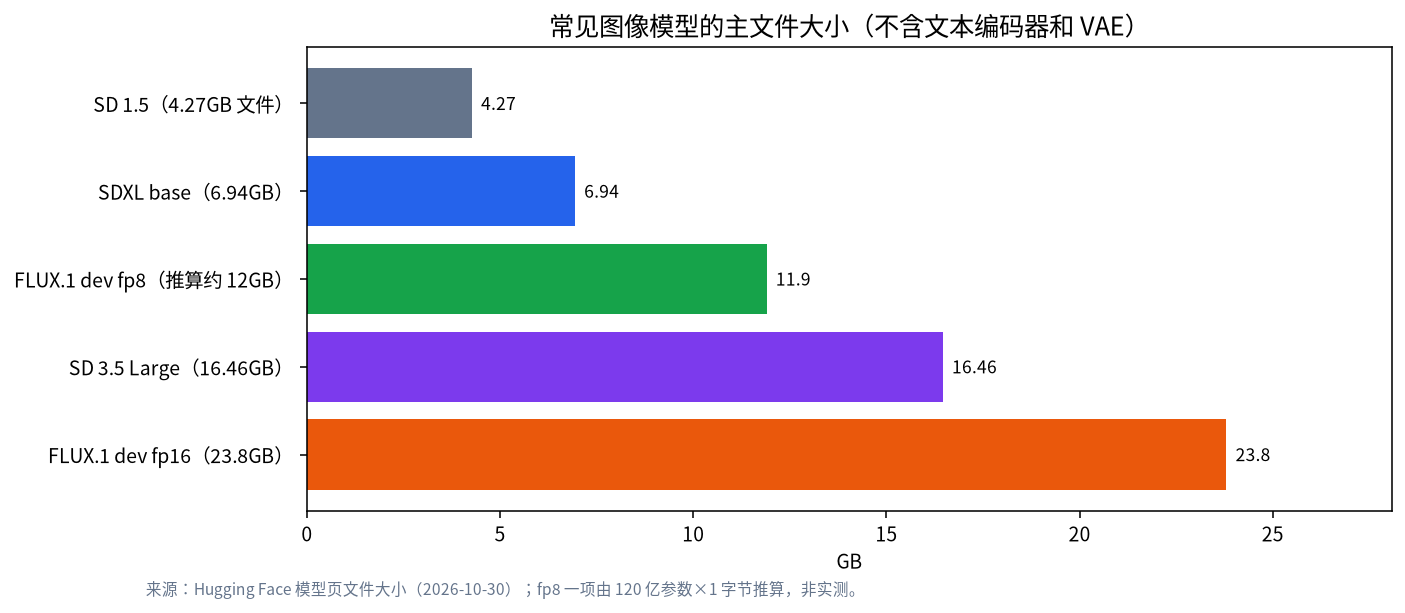
上图比较了 Hugging Face 上的主文件。Stable Diffusion 1.5 是 4.27GB 的文件,SDXL base 是 6.94GB,SD 3.5 Large 是 16.46GB,FLUX.1 dev 是 23.8GB。ComfyUI 文档把 Flux 描述为 120 亿参数、原始文件约 23GB 的模型,并提供一个所需内存更少、画质略有损失的 fp8 量化版本;按每个参数一字节计算约为 12GB,这是我们推算的估计值,不是实测数字。
这些大小只是主扩散模型。Flux 工作流还要加载文本编码器和 VAE。ComfyUI 的 Flux 教程里有 CLIP-L 编码器、fp16 或 fp8 的 T5-XXL 编码器和一个自编码器,它建议在显存超过 32GB 时使用 fp16 的 T5 编码器,显存紧张时使用 fp8 的。图像本身的工作内存也会随分辨率增长。请在图表的每个数字上再加几个 GB。
| 模型 | 主文件 | 实用内存参考 |
|---|---|---|
| SD 1.5 | 4.27GB | 6GB 到 8GB 显卡没问题 |
| SDXL base | 6.94GB | 8GB 可用,12GB 更轻松 |
| FLUX.1 dev fp8 | 约 12GB(推算) | 12GB 很紧,16GB 比较舒适 |
| SD 3.5 Large | 16.46GB | 16GB 需要卸载,24GB 舒适 |
| FLUX.1 dev fp16 | 23.8GB | 24GB 显卡,或卸载到系统内存 |
最后一列是我们的规划建议,不是厂商规格:它假设你还要给编码器、VAE 和正常尺寸的图像留空间,并且在较紧的情况下接受一些卸载。
显存、系统内存与卸载
ComfyUI 的 README 描述了智能显存和内存管理以及模型卸载,并声称利用异步权重流式加载,即使最大的开源模型也能在最低 4GB 显存加 8GB 内存上运行。这是我们没有测试过的厂商说法,它与卸载的工作方式一致:模型的一部分放在系统内存里,需要时再搬到 GPU。代价是时间,因为通过 PCIe 总线搬运数据比直接读显存慢。所以实用的结论是:显存小也能慢慢运行大模型,显存足够才能以 GPU 算力允许的速度运行。
因此系统内存比纯 GPU 负载更重要。如果使用大模型,或在工作流里同时加载多个模型,请准备 32GB,并使用快速 SSD,因为检查点文件很大,而且经常被加载。我们关于 RAM 与 VRAM 和 CPU 卸载的指南,对语言模型解释了同样的取舍。
ComfyUI 硬件要求下的显卡选择与参考价
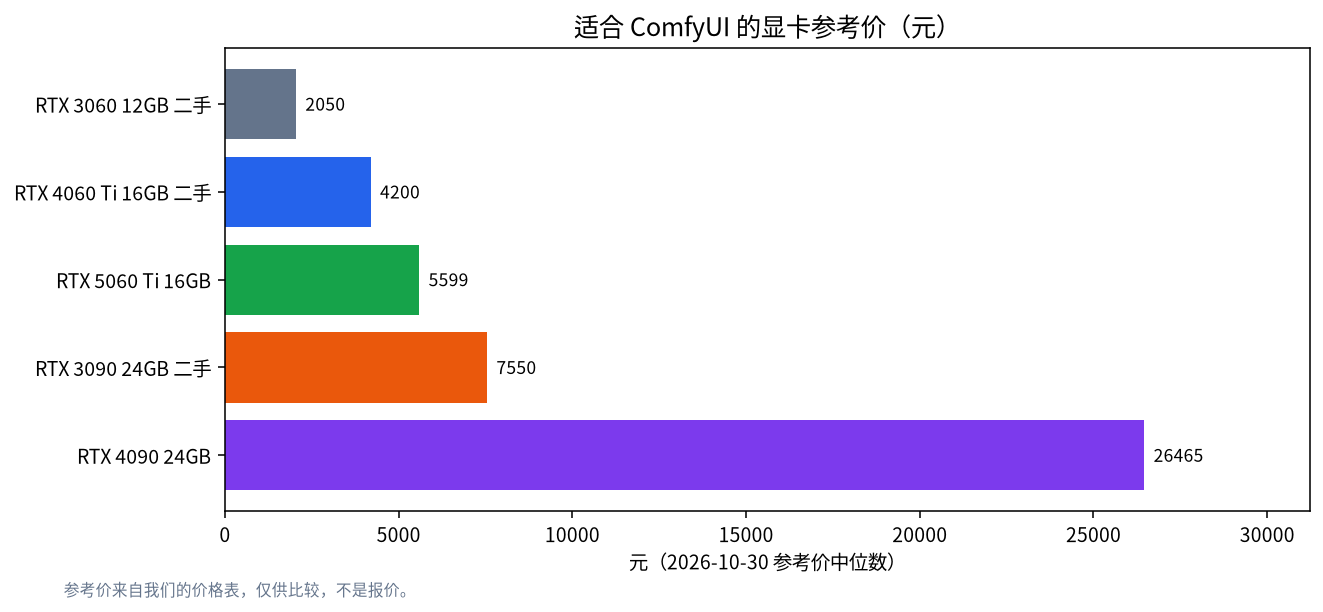
下表是我们 2026-10-30 价格表中的参考价中位数,仅供参考,二手卡有风险,购买前请先看我们的二手显卡购买指南。
| 显卡 | 显存 | 参考价(元) | 适合 |
|---|---|---|---|
| RTX 3060 12GB 二手 | 12GB | 2050 | SD 1.5、SDXL,谨慎使用 fp8 Flux |
| RTX 4060 Ti 16GB 二手 | 16GB | 4200 | SDXL、SD 3.5、fp8 Flux |
| RTX 5060 Ti 16GB | 16GB | 5599 | 同级别,新卡有保修 |
| RTX 3090 24GB 二手 | 24GB | 7550 | 完整大小的模型、长工作流 |
| RTX 4090 24GB | 24GB | 26465 | 显存相同,算力强很多 |
对语言模型来说,RTX 3090 和 4090 显存相近,便宜的那张通常更划算。而对图像生成,算力更重要,所以 4090 每张图明显比 3090 快,值不值得多花那份差价,取决于你出多少图。如果你还把这台机器用于语言模型,我们的 24GB 装机指南和 12GB 与 16GB 指南能帮你选一张两种用途都合适的卡。
英伟达、AMD、英特尔与苹果芯片
英伟达是最稳妥的路线,因为大多数教程、自定义节点和优化都针对 CUDA。ComfyUI 文档确实列出了 Linux 上通过 ROCm 的 AMD、Windows 上通过 AMD PyTorch 包支持 RDNA 2 到 RDNA 4、英特尔 Arc,以及带 Metal 的苹果芯片,桌面版支持使用英伟达或 AMD 的 Windows 和使用苹果芯片的 macOS。实际使用中,离英伟达越远,自定义节点或新模型需要额外步骤的情况就越多,所以请查看你依赖的节点的 issue 页面。我们的 AMD 指南讨论了同样的取舍。在 Mac 上,ComfyUI 使用 PyTorch 的 MPS 后端,而不是苹果的 MLX;统一内存让大模型能加载,但生成通常比较新的英伟达显卡慢。
超出模型本身的内存开销
有三个习惯会让内存用量超出人们的预期。第一是分辨率。图像的宽和高各翻一倍,模型要处理的像素就变成四倍,所以在 1024×1024 下很轻松的工作流,到 2048×2048 可能就内存不足。常见的补救办法是先用中等尺寸生成,之后用单独的步骤放大,这样内存是依次使用,而不是同时使用。第二是批量大小:一次生成四张图比四次各生成一张需要更多工作内存,在显存紧张的卡上,依次生成更稳妥。第三是叠加附加模型。ControlNet 模型、LoRA 文件、放大器以及视频或局部重绘模型都有各自的权重,复杂的图可能同时装着好几个。
ComfyUI 的设计是只重新运行图中改变的部分,并卸载不需要的模型,这有帮助,但峰值仍然重要。遇到内存不足的错误时,对画质损失最小的处理顺序是:先减小图像尺寸或批量,再改用 fp8 或其他量化版本,然后启用更积极的卸载,最后才更换模型。我们的内存不足排错文章对语言模型讲了同样的思路。
硬盘、电源与散热
图像工作流很快会积累文件。一套 Flux 配置需要主模型、两个文本编码器和一个 VAE;再加上几个 SDXL 检查点和 LoRA,模型文件夹很容易超过几百 GB。1TB 的 SSD 是合理的最低配置,再用第二块硬盘存档,可以让快速盘保持空闲。电源和散热值得重视,因为图像生成会让 GPU 在整个运行期间都接近功耗上限,而聊天只是短时间的负载。请确认电源比显卡额定功耗有余量,机箱风道良好,长时间批量任务时房间不会变得难受。如果这台机器还要与语言模型服务器共用,我们的家用服务器指南讲了让两者都稳定的配置。
不靠猜的决策步骤
- 先确定想用的模型。如果是 SDXL 级别,8GB 到 12GB 就够;如果是 Flux 或 SD 3.5 级别,请规划 16GB 或更多。
- 在此基础上给编码器、VAE 和图像尺寸再加四到八个 GB。
- 决定是否接受卸载。不接受就买更多显存;接受就增加系统内存并配快速 SSD。
- 检查散热和电源,因为长时间运行时图像生成会让 GPU 满载。
- 如果可以,购买前先在云端或借来的机器上测试。
常见错误
- 只比较主文件:编码器、VAE 和图像尺寸还会增加几个 GB。
- 为 Flux 买 8GB 显卡:加上大量卸载可以运行,但会很慢。
- 忽视系统内存:卸载会把权重搬进去,16GB 可能很紧。
- 以为语言模型和图像的选择一模一样:图像生成更依赖算力,所以更快的 GPU 更重要。
- 使用旧版 PyTorch:ComfyUI 建议新显卡使用当前的 PyTorch 和 CUDA 版本。
常见问题
ComfyUI 需要多少显存?
取决于模型。SD 1.5 和 SDXL 可在 6GB 到 12GB 的显卡上运行;Flux 和 SD 3.5 Large 在 16GB 到 24GB 时更舒适。
ComfyUI 能在 8GB 显存上运行吗?
SDXL 级别的模型可以,更大的模型借助卸载也可以,但较大模型的生成速度会变慢。
16GB 内存够吗?
小模型可以,但对大模型和卸载来说,32GB 更舒适。
ComfyUI 能用在 AMD 或 Mac 上吗?
可以。文档列出了对 AMD、英特尔 Arc 和苹果芯片的支持,不过英伟达仍是支持最好的路径。
ComfyUI 用 RTX 3090 还是 4090 更好?
两者都是 24GB。4090 更快,二手 3090 便宜得多,按你的出图量来选。
一块 GPU 能同时做语言模型和图像生成吗?
可以,但在小显存的卡上通常不能同时进行,因为两者都需要显存。启动一个前先关掉另一个。
和我们聊聊
在为 ComfyUI 和语言模型一起选显卡?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:ComfyUI 系统要求、ComfyUI Flux 教程、ComfyUI README、SDXL base 模型页面。