小团队共享本地大模型:3 到 10 人的容量、权限与成本
一个人用一块显卡很简单。当三到十个人的团队想共用一个模型时,问题就变了:每多一个用户要多少内存?怎样防止外人使用?两个人同时提问会怎样?这一切要花多少钱?这篇关于 小团队共享本地大模型 的文章,用可以核对的算术、我们的参考价格,以及 Ollama 和 Open WebUI 文档里写明的行为,逐个回答这些问题。它不是案例研究:我们没有可以报告的客户部署,也不会编造。
核对说明:并发行为来自 Ollama 的 FAQ,基于角色的访问控制来自 Open WebUI 项目页面,均在 2026-10-30 读取。内存数字由前文各指南里的模型大小和 KV 缓存大小推算,是估计值,实际使用还会有运行开销。价格是 2026-10-30 的参考价。本文没有对团队服务器做压力测试,所以不提供速度数据,文中内容也不构成法律意见。
要点速览(更新于 2026-10-30)
- 每个并行用户都要有自己的上下文内存:Ollama 文档说明并行请求会让上下文大小按并行请求数增加,所以四个人以 8K 上下文使用,KV 缓存大约是一个人的四倍。
按我们的推算,14B 的 Q4_K_M 模型四人各 8K 约需 14.6GB,24GB 显卡比较宽裕;32B 模型四人约需 27.7GB,要用 32GB 或更大的显卡。
在模型前面加账号和角色(Open WebUI 提供基于角色的访问控制和用户组),不要把推理端口暴露到网络,并为团队长大后换专用服务软件或云服务预留退路。
小团队共享本地大模型:服务器要做什么
共享服务器有四件事要做:把模型放进内存;同时服务多个请求,而不是让一个人卡住其他人好几分钟;知道是谁在使用;防止数据泄露给不该看的人。单用户部署只做第一件。
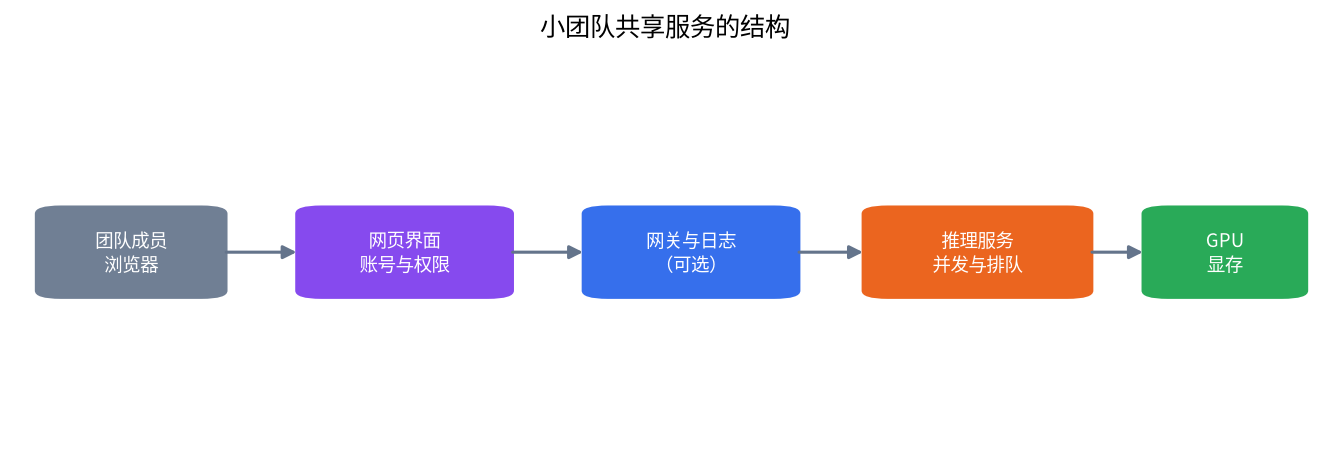
多数小团队用不上集群,只需要一台足够强的机器、一个带账号的网页界面,以及清晰的规则。图中的结构就能满足很大一部分场景:浏览器访问处理账号的网页界面,可选的网关增加日志和密钥,推理服务把请求排队交给显卡。
如果你还没搭好单用户版本,请先看 Open WebUI 教程和 API 服务教程。对需要审计、合规和服务合同的组织,企业私有部署指南是更好的起点。
内存如何随用户增长
模型权重只加载一次并共享,但每个活跃的对话都需要自己的 KV 缓存。Ollama 的 FAQ 把这个效果说得很清楚:对同一个模型的并行请求处理,会让上下文大小按并行请求数增加,它举的例子是 2K 上下文加 4 个并行请求变成 8K,并分配额外内存。所以 N 个用户的内存大约是权重加上 N 倍的单用户 KV 缓存。如何计算 KV 缓存,见上下文长度指南;下表用 f16 缓存的大小来计算:Llama 3.1 8B 每个 token 128KiB,Qwen2.5-14B 192KiB,Qwen2.5-32B 256KiB。
| 模型(Q4_K_M) | 权重 | 每人 8K 的 KV | 四人合计 | 总量(推算) | 适合的显存 |
|---|---|---|---|---|---|
| 8B 级 | 4.9GB | 约 1GB | 约 4GB | 约 8.9GB | 12GB 显卡 |
| 14B 级 | 8.6GB | 约 1.5GB | 约 6GB | 约 14.6GB | 16GB 偏紧,24GB 宽裕 |
| 32B 级 | 19.7GB | 约 2GB | 约 8GB | 约 27.7GB | 32GB 或更大 |
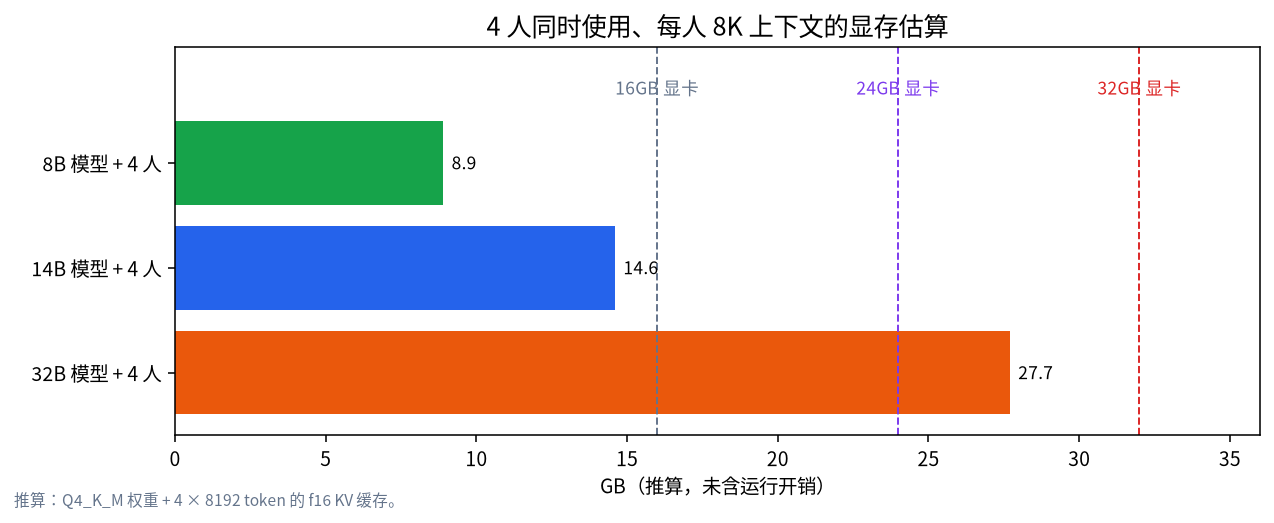
有两点要注意。估算不包括运行开销和计算缓冲,所以要留出几 GB 的余量。而且不是所有用户都在同一时刻活跃:人们要阅读回答、要思考,所以同时发生的请求通常比账号数少。如果内存放不下,请求就会排队,或者每个用户的上下文必须缩短。队列满时 Ollama 会返回 503 错误,OLLAMA_MAX_QUEUE 变量可以调整队列长度。减少内存的办法包括换小一点的模型、缩短上下文和量化缓存,详见显存计算器指南。
为 3 到 10 人选硬件
合适的机器取决于你需要的模型。写草稿、做总结和问答,8B 到 14B 的模型往往够用,16GB 或 24GB 的显卡可以服务少数几个用户。需要更强的推理或编程帮助时,32B 级模型在多人同时使用时需要 32GB 或更多。两块显卡可以分担一个模型,见双显卡指南,但会增加复杂度。
| 档位 | 参考价(元) | 内存 | 适合 |
|---|---|---|---|
| RTX 5060 Ti 16GB 整机 | 10,853 | 16GB 显存 | 8B 到 14B 模型,2 到 4 个活跃用户 |
| 二手 RTX 3090 整机 | 14,299 | 24GB 显存 | 14B 模型,多个用户 |
| RTX 4090 整机 | 33,214 | 24GB 显存 | 容量和 3090 相同,带宽更高 |
| Mac Studio M5 Max 128GB | 41,749 | 128GB 统一内存 | 大模型,同时使用的人较少 |
| DGX Spark 128GB | 42,500 | 128GB 统一内存 | 大模型,同时使用的人较少 |
| RTX 5090 工作站 | 65,737 | 32GB 显存 | 32B 模型,多个用户 |
| 企业一体机 32B 档 | 150,000 | 视厂商而定 | 需要服务合同和合规 |
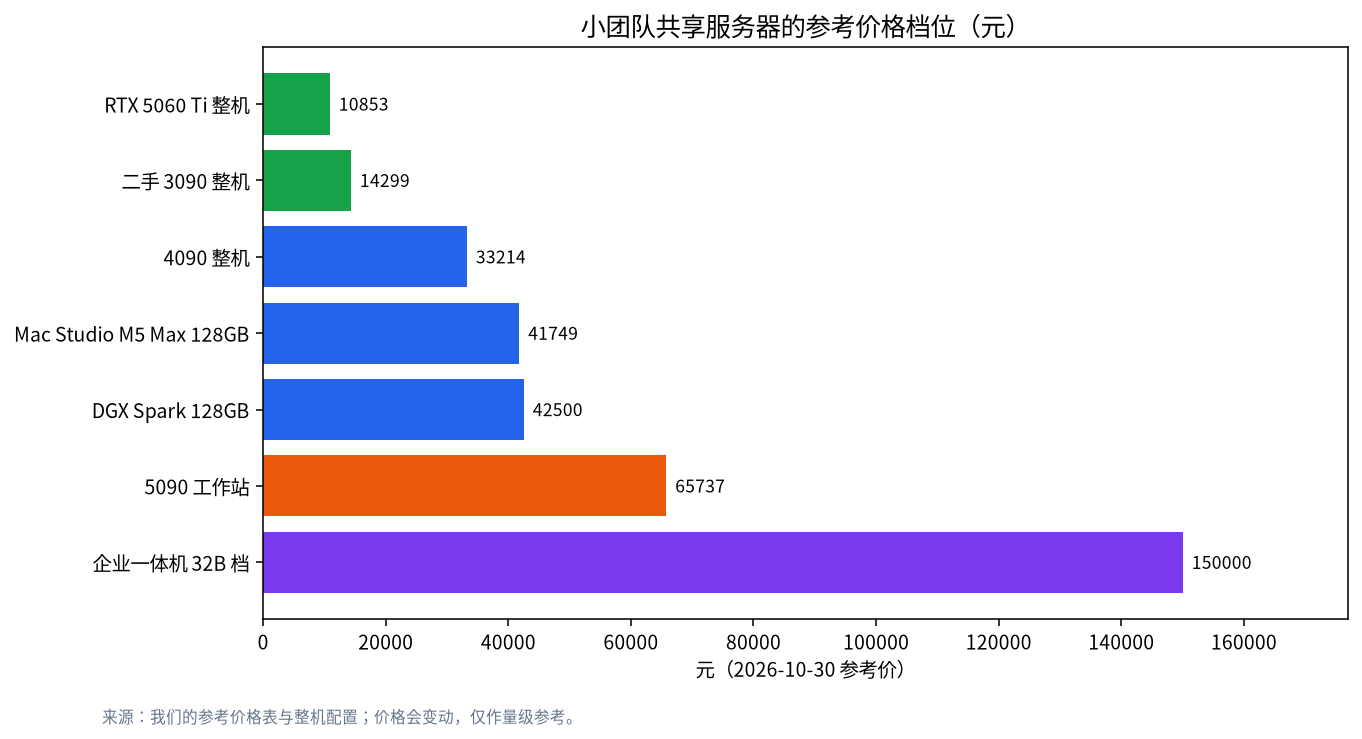
内存容量不等于速度。统一内存的机器能装下大模型,但内存带宽低于高端显卡,通常意味着每个用户的回答更慢;我们没有实测,所以不给出速度。价格是参考价,工作站和一体机这两行的来源较少,请只当作数量级。想比较整机,见一体机选购指南。
账号、角色和网络访问
推理端口绝不应该被团队直接访问。让模型服务只监听本机或私有接口,只暴露网页界面。Open WebUI 介绍了基于角色的访问控制和用户组,由管理员定义角色和权限,所以可以把管理员和普通用户分开。具体的注册和审批设置请查看它当前版本的文档,并且除非你想让陌生人创建账号,否则关闭开放注册。
再加上一些基本的做法。如果服务经过的不只是可信的有线网络,就使用 HTTPS,系统侧的做法见远程部署指南。给每个人单独的账号,绝不要共用密码,这样有人离开时才能收回权限。管理员账号只用于管理,不用于日常聊天。备份网页界面的数据,因为聊天记录和设置都在那里,并保持系统和软件更新。
数据和内容的规则
只有团队就“什么能放进去”达成一致,共享服务器才算私密。写一页纸的规定:哪些数据可以粘贴(比如公开文档和内部草稿),哪些不行(客户个人信息、凭证、有保密条款的合同),谁能看日志,聊天记录保留多久,有问题找谁。要记住,本地服务器仍然会把提示词和回答存在磁盘上,能访问这台机器就等于能看到对话。隐私指南讲了哪些内容留在本地、哪些不会。
关于个人数据和员工监控的规则因国家和合同而异,我们不能提供法律意见。如果团队处理受监管的数据或客户数据,把它放进任何 AI 系统之前,不管是本地还是云端,都请先问负责合规的人。
公平与排队
没有限制的话,一个人粘贴一份很长的文档就会拖慢所有人。设置合理的最大上下文,让并行请求数保持在内存允许的范围内,并告诉团队长任务放在不忙的时候。如果你的网关支持按用户限速,请使用;一些网页界面提供插件挂钩来实现,请查看该项目当前的功能。最初几周要观察队列,因为实际的使用模式比任何计划都更有教育意义。
一个算例(假设情景)
假设一个六人团队想要一个用于写作和总结的共享助手。这只是对算术的演示,不是真实部署的报告。六个账号不等于六个同时的请求;假设团队预计最多三个人同时等待回答。14B 的 Q4_K_M 模型权重约 8.6GB。三个并行请求、每人 8K 上下文,KV 缓存约为 3 × 1.5GB,即 4.5GB,所以在开销之前总共约 13.1GB。16GB 显卡偏紧;24GB 显卡则留有余地,可以用更长的上下文,或者再放一个小的嵌入模型。二手 3090 整机的参考价约 14,299 元,5060 Ti 16GB 整机约 10,853 元,差别是几千元换来的从容。
再假设团队以后想用 32B 模型处理更难的任务。权重约 19.7GB,加上三个用户各 8K 约 6GB,大约共 25.7GB。这就放不进 24GB 显卡了,也正是需要缩短每人上下文、换用更小的量化、或者更换硬件的地方。购买前做这个计算,可以避免团队部署里最常见的后悔:机器演示时没问题,但到了第二个、第三个用户就不行。
四周上线计划
不要第一天就向所有人宣布。第一周,只和两位志愿者一起安装和测试,设置上下文和并行参数,并在两人同时提出很长的问题时观察显存,确认负载下的内存使用。第二周,为试用小组添加账号,关闭开放注册,并写好一页纸的数据规定。第三周,扩大到全团队,观察队列并收集意见,调整最大上下文。第四周,复盘大家实际用它做什么,判断是否值得换更大的模型或再加一台机器,并定下下次复盘的日期。保留一份简单的变更记录,这样更新后出了问题能追溯。
谁来负责这台服务器
共享服务器需要一个负责人。指定一个人负责更新、备份、人员离开时的账号回收和答疑,再指定一个备份人选。没有这些,服务就会衰败:模型一直没更新,磁盘被旧模型占满,没人知道谁能重启它。提前决定维护期间怎么办,并告诉团队服务什么时候不可用。如果没有人愿意担任这个角色,这本身就是有用的信息:也许托管的云服务虽然有取舍,却更适合你的团队。
何时换成 vLLM 或云服务
Ollama 和 llama.cpp 适合几个人的团队。当更多用户同时到来,或者你需要最大限度地利用每块显卡时,专用的服务软件,比如我们vLLM 与 SGLang 入门里介绍的 vLLM,就是为批处理大量请求设计的。代价是配置更多,工作流以 Linux 优先。另一条路是敏感工作留在本地,把不敏感的重任务交给云 API,本地与云端对比讨论了这种取舍。如果一开始就基于兼容 OpenAI 的 API 搭建,迁移会容易得多,因为客户端只需要改一个基础地址。
常见错误
- 只按一个用户来估算容量。 每个并行用户都要有自己的 KV 缓存。
- 共用一个密码。 你没法单独收回某个人的权限。
- 暴露模型端口。 只有网页界面或网关应当可以访问。
- 一直开着开放注册。 找到地址的人都能创建账号。
- 只按内存容量选择。 容量不等于速度,请用自己的工作负载测试。
- 没有数据规定。 用户会把方便的东西都粘进去。
常见问题
多少人可以共用一块显卡?
取决于模型、上下文长度,以及大家实际同时发请求的频率。按我们的估算,14B 模型四个用户约 14.6GB,但我们没有对任何配置做过压力测试。
每个用户都需要单独的显卡吗?
不需要。权重是共享的,每个活跃对话只增加自己的 KV 缓存。限制来自内存,而不是账号数。
太多人同时提问会怎样?
请求会排队等待内存释放;队列满时 Ollama 返回 503 错误,可以用 OLLAMA_MAX_QUEUE 调整。
本地服务器自动就是私密的吗?
提示词留在你的硬件上,但也会存在那里,所以访问控制、备份和数据规定仍然重要。
应该用 Open WebUI 吗?
它是常见的选择,它的基于角色的访问控制和用户组适合小团队;具体设置请查看当前版本的文档。
什么时候该换成 vLLM 或云服务?
当请求经常排队、需要更好的显卡利用率,或者团队超出一台机器的能力时。
和我们聊聊
正在为团队规划共享服务器?欢迎到社区描述你的场景,或者发邮件到 admin@microaione.com。
参考资料:Ollama FAQ 中的并发说明、Open WebUI 项目、Open WebUI 文档、英伟达 GeForce RTX 5090。