MiniMax H3 本地部署:最好的开源视频生成模型?硬件、许可证与成本
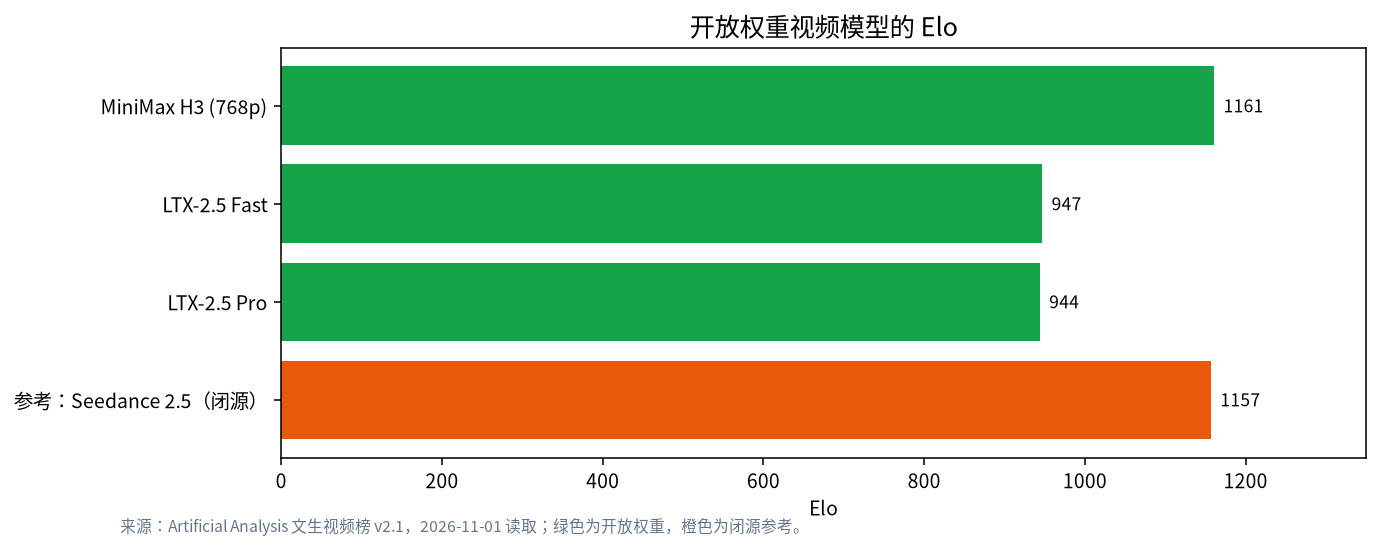
在开放权重的视频生成模型里,MiniMax H3 目前是 Artificial Analysis 文生视频榜上最强的一个:768p 版 Elo 为 1161,榜上另外两个开放权重模型 LTX-2.5 Fast 和 Pro 只有 947 和 944。但”最好的开源”有两个前提需要读清:一是它的许可证有地域限制,美国、欧盟、英国和韩国属于需要另行授权的地区;二是它对硬件的要求很高,官方文档给出的最低可用配置不是一块消费级显卡就能轻松跑完。本文对比 H3 与闭源的 Seedance 2.5 等模型,把官方公布的显存和耗时整理成表,算出自建与 API 的成本差,并给出可复现的测试方法。
核实说明:榜单数据读取自 Artificial Analysis(2026-11-01);硬件、耗时、显存和许可证信息来自 MiniMax 官方”本地部署 H3″文档(官方标注的复核日期为 2026-08-26),其中 SGLang 与 vLLM-Omni 的基准由上游项目测得,不是 MiniMax 自己的验证,官方文档也明确说明了这一点。我们没有在自己的机器上跑过 H3,文中没有自测耗时或画质评分。
要点速览(更新于 2026-11-01)
- Artificial Analysis 文生视频榜:MiniMax H3(768p)Elo 1161,价格每分钟 4.80 美元,是榜上最强的开放权重模型;Seedance 2.5 为 1157,每分钟 34.12 美元。
许可证:截至官方复核的 2026-08-26 版本,美国、欧盟、英国、韩国属于”排除地区”,需要单独授权;开放版本不含 Context-IR 与 2K 重生成组件。
硬件:官方文档公布的 2 张 RTX 5090 加分层卸载方案,生成 5 秒视频端到端约 559.67 秒;ComfyUI 路径没有公布最低显存。
先看结论:它是不是”最好的开源视频模型”
按第三方榜单,是。Artificial Analysis 文生视频榜(v2.1)上,MiniMax H3(768p)Elo 为 1161,名次范围第 2 到第 6,榜单标注为开放权重,发布于 2026 年 7 月。榜上的另外两个开放权重模型是 LTX-2.5 Fast(947)和 LTX-2.5 Pro(944),差距超过 200 分。作为参照,闭源的 Seedance 2.5 为 1157,MiniMax 自己的更高规格版 H3 Max 为 1149(榜单未标注为开放权重)。
不过要补两个限定。第一,”开放权重”不等于”开源许可”:H3 使用的是 MiniMax H3 社区许可证,下一节会讲它的地域限制。第二,开放的只是 H3-Base(FL2VA 和 Ref2VA 两个检查点),不包含 H3-Context-IR 和 H3-Regenerate-2K,所以自建服务无法复现 MiniMax 平台上完整的”上下文理解加 2K 重生成”工作流;榜单上的 Elo 对应的是哪一种配置,需要你以官方说明为准。
许可证:先查你所在的地区
官方文档在页首用警告框写明:H3 受 MiniMax H3 社区许可协议约束;按 2026-08-26 复核的版本,美国、欧盟、英国和韩国是”排除地区”,需要单独的许可。协议还包含商用、分发、署名、托管服务的安全措施和可接受使用政策等条款,并且可能随时修订,官方提醒下载、部署或提供托管服务之前要阅读最新协议。
这对读者意味着:如果你在上述地区,或者你的服务面向这些地区的用户,不能把”开放权重”理解成”可以随便用”。我们不是律师,也没有读完协议的全部条款,建议在评估之前先把协议全文交给法务确认。这也是为什么我们在文章里不把 H3 称为”开源”,而称为”开放权重”。
官方文档公布的硬件数据
官方文档给出了两条本地路径:ComfyUI 可视化工作流,以及用 SGLang 或 vLLM-Omni 部署成服务。ComfyUI 需要 0.30.0 或更高版本,内置文生视频、图生视频和参考生视频三个模板,使用 Comfy-Org 发布的剪枝与量化文件(含 INT8 和 NVFP4 部分)。官方特别提醒:这些量化文件与官方混合 BF16/FP32 检查点不是同一个数值基线,画质、显存和可复现性都可能不同,不要混用两条路径的基准结论;而且 ComfyUI 指南没有公布最低显存与性能,需要你自己在硬件上验证。
SGLang 路径给出了一些实测数据,工作负载均为 1344×768、124 帧、24 帧每秒、50 步、5 秒的文生视频加音频。
| 配置 | 耗时 | 每卡峰值显存 | 说明 |
|---|---|---|---|
| 8 张 B300,BF16,FL2VA | 19.04 秒 | 83,578 MB | 上游基准 |
| 8 张 B300,FP8,FL2VA | 18.03 秒 | 51,926 MB | FP8 为在线量化,近似 |
| 4 张 H200,Ulysses 4 | 平均 75.10 秒 | 约 94,288 MB | 上游基准 |
| 4 张 H200,TP2+Ulysses 2 | 约 78–86 秒 | 约 63,490 MB | 显存更低,延迟略高 |
| 4 张 H100,TP2+Ulysses 2 | 13.25 秒 | 66.04 GB | 上游表格未公布请求形态,只可横向对比 |
| 2 张 RTX 5090 32GB,TP2 加分层卸载 | 559.67 秒 | 约 26.3 GiB | 无损,端到端,含 33.61 秒解码 |
| 1 张 RTX 4090 24GB,分层卸载加 INT8 | 取决于主机内存与带宽 | 约 18GB | 在线 INT8,近似,未公布耗时 |
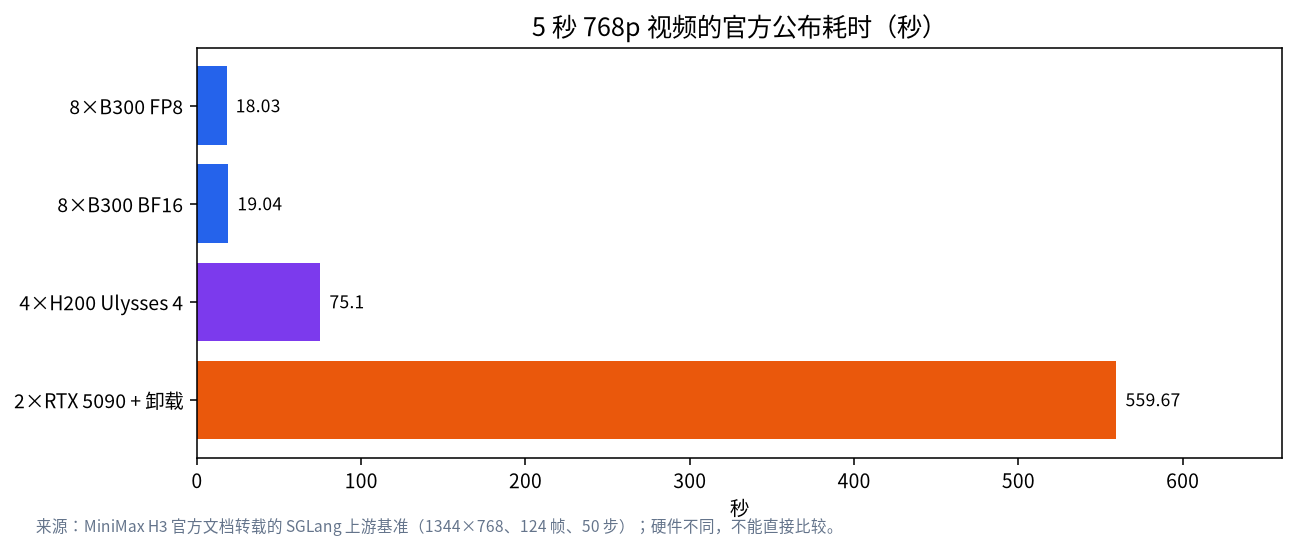
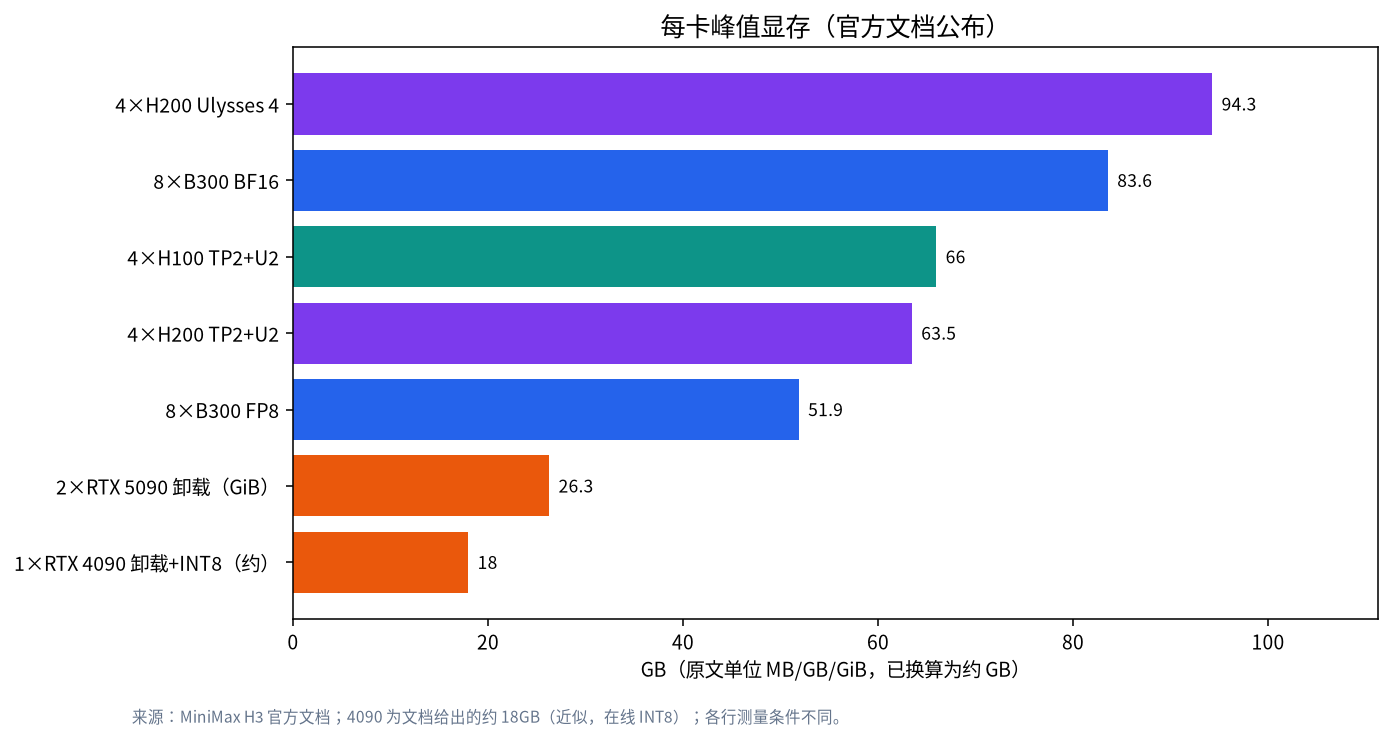
读这张表要小心三点。其一,官方明确写了 8 张 B200 是”参考配置,不是最低硬件声明”,并且当前模型卡只演示了四卡命令,未给出峰值显存、主机内存和磁盘的完整要求。其二,上面的数据来自 SGLang 上游基准,不是 MiniMax 自己验证的硬件,且测量版本不是文档固定的提交。其三,消费级显卡的路径依赖卸载,速度与主机内存和带宽强相关;vLLM-Omni 的社区方案要求双卡卸载时至少有 200 GiB 可用系统内存,推荐 384 GiB,每个检查点分区约占 135 GiB 磁盘。换句话说,消费级显卡能”跑通”,但不是轻松地跑。
成本:自建值不值
用官方公布的数据做一个算术(推算,非实测):2 张 RTX 5090 的无损卸载方案生成一段 5 秒视频要 559.67 秒,约合每秒视频 112 秒。如果这台机器满负荷连续运行 24 小时,可以生成约 154 段 5 秒视频(86,400÷559.67),也就是约 771 秒视频。同样的量在榜单价格(768p 约每分钟 4.80 美元,即每秒 0.08 美元)下,API 费用约 61.7 美元。这个数没有计入你的显卡、整机、电费和系统内存成本,也没有计入失败重试;它只想说明一件事:只有当你每天要大量生成时,自建才可能比 API 便宜,轻度使用几乎肯定不划算。
再看闭源的 Seedance 2.5:同样 5 秒视频,按榜单价格约 2.85 美元(1080p),H3 的 API 价格约 0.40 美元。换句话说,如果你的目的只是”便宜地得到 H3 级别的画质”,直接用 H3 的托管服务就已经比闭源便宜得多,而自建的理由应是数据留存、定制 LoRA 或离线要求。官方还提供了用 miles-diffusion 对 H3-Base 做 LoRA 微调的上游方案:参考硬件是单节点 8 张 H200,3 个轮次约 66 分钟(冷缓存),属于实验性方案。
与其他选项并排对照
下表把 H3 放进本地读者真正要做的选择里。”未核实”表示我们没有读到可靠的一手资料,所以不写。
| 项目 | MiniMax H3(768p) | LTX-2.5 Pro / Fast | Seedance 2.5 |
|---|---|---|---|
| Artificial Analysis Elo | 1161 | 944 / 947 | 1157 |
| 能否下载权重 | 能(H3-Base) | 榜单标注为开放权重 | 不能 |
| 榜单每分钟价格 | 4.80 美元 | 本文未核实 | 34.12 美元 |
| 许可证限制 | 社区许可证,美、欧、英、韩需另行授权 | 本文未核实,请自行查阅 | 官方渠道不在美、加、英、澳、新销售(第三方整理) |
| 本地硬件门槛 | 高,官方未公布 ComfyUI 最低显存 | 本文未核实 | 不适用 |
| 适合谁 | 有高端显卡或工作站、需要留存数据 | 想要较轻方案的人需要自己评估画质差距 | 愿意为参考素材能力付费的人 |
这张表的结论是:H3 是目前”又能下载又接近闭源水平”的唯一选项,但门槛不低;如果你没有合适的硬件,最合理的路径是先用托管服务验证题材,再决定是否值得自建。LTX-2.5 的 Elo 比 H3 低 200 多分,意味着在盲测里被选中的概率大幅下降,是否接受这个差距取决于你的用途。
一个做决定的清单
在你花钱买显卡之前,可以按下面五个问题自测。第一,你所在的地区和你的服务对象是否在排除地区内?如果是,先解决授权。第二,你每天需要生成多少秒视频?只有数百秒以上的稳定日用量,自建才可能追平 API 价格。第三,你的数据是否必须留在本地?这是自建最硬的理由。第四,你有多少系统内存?卸载方案对内存的要求,比显存更容易成为瓶颈。第五,你能否接受 ComfyUI 量化版与官方 BF16 版之间的画质差别?如果五个问题里有三个以上答案是”否”,那就继续用托管服务。
如果显存不够怎么办
官方路径并没有给单卡 24GB 的完整保证:RTX 4090 24GB 的方案依赖分层卸载与在线 INT8,峰值约 18GB,但延迟取决于主机内存与带宽,没有公布耗时。较稳妥的选择有三条:用 ComfyUI 的量化模板先在小分辨率上试,再决定是否投入硬件;用托管服务验证题材;或者看看是否值得升级到工作站级显卡,参考 RTX PRO 6000 工作站和 RTX 5090、4090、3090 对比。理解内存和显存如何互相补位,可以先读内存与显存、CPU 卸载和 ComfyUI 硬件需求。
自己复现:测试方法
我们没有跑过 H3,下面是你可以照着做的方法,用于评估是否值得本地化。
- 先核对许可证与地区,保存你读过的协议版本日期。
- 用 ComfyUI 的文生视频模板,记录 ComfyUI 版本、模板修订、每个模型文件的版本,不要悄悄替换检查点。
- 固定画布:使用 1344×768 的 16:9 原生画布,不要选 1.0 兆像素档(官方说明它会解析成 1376×768,超出 H3-Base 的像素面积上限)。
- 固定时长与帧率:24 帧每秒,时长会被对齐到 17k+5 的帧数网格,记录实际帧数。
- 每个提示词至少 3 个种子,记录耗时、峰值显存、主机内存和是否出现崩溃。
- 对照托管服务:同一提示词在 H3 托管服务或 Seedance 2.5 上各生成一次,做盲选。
- 加速模式要单独记录:8 步 Turbo LoRA 更快,但官方说明可能降低动作与音频质量,需要记录 LoRA 名称、强度、步数与种子。
镜头:夜晚的客厅,三只猫用小型铜管乐器合奏,动作与音乐同步。
时长 5 秒,16:9,1344×768,24 帧每秒,立体声。
对白:无。音效:温暖的室内混响。
常见错误
- 把”开放权重”当成”无条件可用”:美国、欧盟、英国、韩国需要另行授权,先查协议。
- 拿 ComfyUI 量化版的效果去验证官方 BF16 基线:官方明确说两者不是同一个数值基线。
- 只看显存不看主机内存:卸载方案对系统内存和带宽的要求很高。
- 选 1.0 兆像素档:会解析成 1376×768,超出 H3-Base 的像素面积上限。
- 把上游基准当成官方保证:官方文档明确说这些是上游配置,不是 MiniMax 验证的硬件。
- 启用 FSDP 推理却不校验输出:官方引用的上游问题报告称它可能悄悄产生损坏的音视频。
相关阅读
- Seedance 2.5 与 Wan 3.0、MiniMax H3 对比
- ComfyUI 硬件需求
- RTX PRO 6000 工作站
- RTX 5090、4090、3090 对比
- 内存、显存与 CPU 卸载
常见问题:MiniMax H3
MiniMax H3 是最好的开源视频生成模型吗?
在 Artificial Analysis 文生视频榜上,它是最强的开放权重模型,Elo 1161,榜上其他开放权重模型只有 947 和 944。但它的许可证有地域限制,所以称”开放权重”更准确。
MiniMax H3 能在 RTX 4090 或 5090 上运行吗?
官方文档给出的上游数据:2 张 RTX 5090 加分层卸载,5 秒视频端到端约 559.67 秒;1 张 RTX 4090 24GB 加卸载与 INT8,峰值约 18GB,耗时未公布。这些依赖大容量系统内存。
在美国或欧盟可以使用 MiniMax H3 吗?
按官方 2026-08-26 复核的许可协议,美国、欧盟、英国和韩国是排除地区,需要单独的许可。请以最新协议为准。
MiniMax H3 的 API 价格是多少?
Artificial Analysis 列出 768p 版每分钟 4.80 美元,H3 Max 为 9.60 美元。折算 5 秒视频约 0.40 美元。
自建比用 API 便宜吗?
只有大量连续生成才可能。按我们的推算,2 张 5090 满负荷 24 小时的产量,按 API 价格约值 61.7 美元,还没扣除硬件和电费。
开放版本和 MiniMax 平台上的 H3 有什么区别?
开放版本是 H3-Base,不包含 Context-IR 和 2K 重生成组件,所以无法完整复现平台上的工作流。
和我们聊聊
在评估视频生成的本地方案?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:MiniMax 官方:运行与自托管 H3、Artificial Analysis 文生视频榜单、CellCog:Seedance 2.5 定价整理(第三方)。